
Основы ИИ
Что такое кластеризация k‑means?

 Добавьте Unite.AI в избранные источники в Google
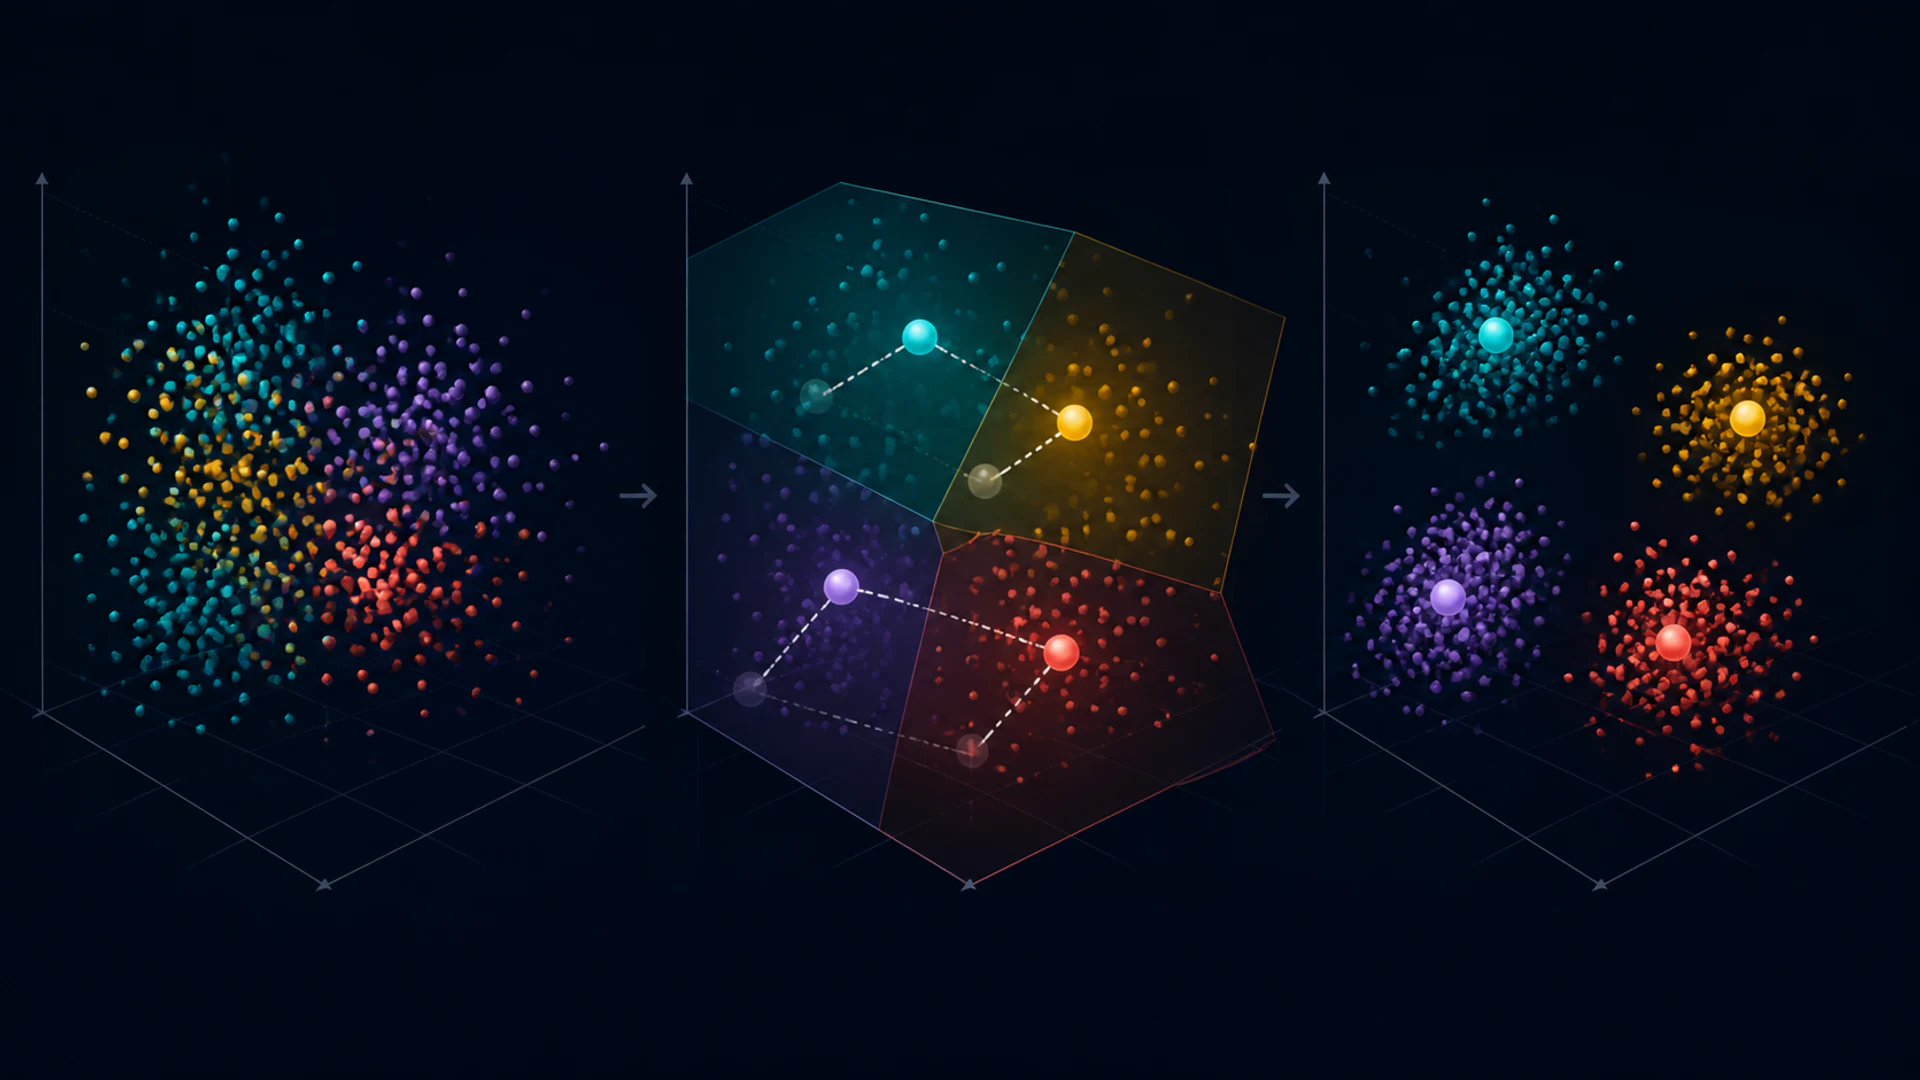
K-means — это алгоритм без учителя, который разбивает числовые наблюдения на k кластеров. Он чередует назначение каждой точки к ближайшему центроиду и пересчёт каждого центра как среднего значений назначенных точек.
Алгоритм быстрый и полезный, но его результат зависит от масштабирования, расстояния, инициализации и выбранного k. Кластер — это математическое разбиение, а не автоматически реальная категория.
Ключевые выводы
- K-means минимизирует квадратичную евклидову дистанцию внутри кластера до центроидов.
- Инициализация имеет значение; k-means++ распределяет начальные центроиды и обычно улучшает результаты.
- Стандартизируйте признаки, когда их единицы или масштабы должны вносить сопоставимый вклад.
- K-means испытывает трудности с выбросами, несферическими кластерами, неравномерной плотностью и категориальными данными.
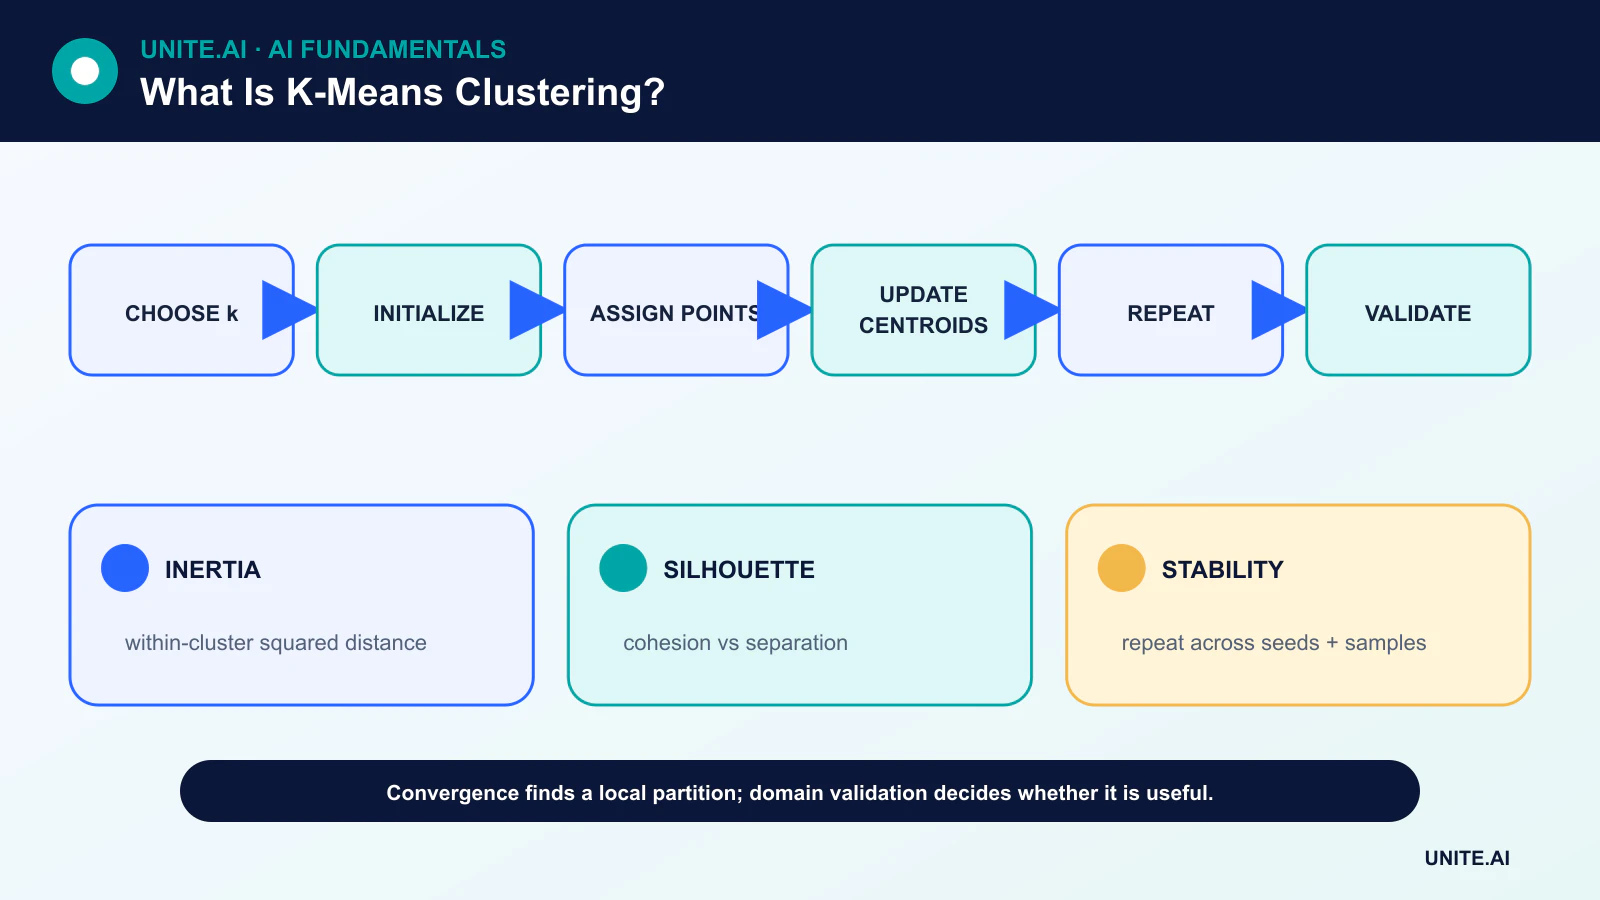
Цель и цикл обновления
При заданных k центроидах шаг назначения отправляет каждое наблюдение к ближайшему. Шаг обновления заменяет каждый центр средним значением назначенных наблюдений. Сумма квадратов внутри кластера не может увеличиваться при этих шагах, поэтому процесс сходится к локальному оптимуму.
Сходимость не гарантирует глобального оптимума. Разные начальные центроиды могут приводить к разным разбиениям, поэтому реализации запускают несколько инициализаций и сохраняют решение с наименьшей инерцией.
Инициализация и k-means++
Случайный выбор всех начальных центроидов из одной плотной области может дать плохое решение или медленную сходимость. k-means++ выбирает сеяния с вероятностью, зависящей от расстояния до уже выбранных, способствуя покрытию всего набора данных.
Несколько запусков остаются полезными. Записывайте случайное зерно и количество инициализаций, чтобы результаты можно было воспроизвести.
Масштабирование и расстояние
Квадратичное евклидово расстояние делает k-means чувствительным к единицам измерения. Признак, измеренный в тысячах, может доминировать над другим, измеряемым в диапазоне от нуля до единицы. Стандартизация распространена, но знание предметной области должно определять, отражает ли одинаковая стандартизированная дисперсия одинаковую важность.
Выбросы могут оттянуть среднее далеко от типичных точек. Робастное масштабирование, обрезка или методы, основанные на медоидных центрах, могут быть лучше. One-hot категориальные признаки создают геометрию расстояний, которая может не соответствовать сходству категорий.
Выбор k и проверка кластеров
Инерция уменьшается при увеличении k, поэтому её нельзя использовать единственно для выбора k. Эвристика «локоть» ищет убывающие улучшения. Анализ силуэта сравнивает сплочённость и разделение. Стабильность по образцам и сеянам добавляет ещё одну проверку.
Самая сильная проверка — полезность для целевого домена. Сравнивайте кластеры с известными результатами, экспертной оценкой или downstream‑задачей, не притворяясь, что пост‑хок метки обнаружены объективно.
Ограничения и альтернативы
k-means предпочитает компактные, примерно сферические группы одинакового масштаба. Модели гауссовых смесей представляют вероятностные эллипсоидальные компоненты; методы типа DBSCAN выявляют плотные области и шум; иерархическая кластеризация образует дерево объединений.
Снижение размерности может ускорить работу или очистить входные данные, но обучение на полном наборе может изменить вопрос проверки. Mini-batch k-means уменьшает вычисления для больших наборов ценой приближённого обновления.
Цель, инициализация и сходимость
K-means разбивает числовые наблюдения на k кластеров, минимизируя квадратичную евклидову дистанцию внутри кластеров до центроидов. Алгоритм Ллойда чередует назначение каждой точки к ближайшему центроиду и пересчёт центроидов, пока назначения или целевая функция не стабилизируются. Он сходится к локальному оптимуму, не обязательно к глобальному лучшему. Инициализация k-means++ распределяет начальные центры и обычно улучшает результаты, но несколько сеяний остаются важными. Стандартизируйте признаки, когда единицы измерения должны вносить сопоставимый вклад, поскольку квадратичное расстояние усиливает влияние переменных с большим масштабом и выбросов.
Метод предполагает примерно компактные, сферические, одинаково масштабированные кластеры в евклидовой геометрии. Он затруднён с вытянутыми многообразиями, неравномерной плотностью, категориальными данными, сильными выбросами и вложенной структурой. Пустые кластеры и дублированные точки требуют определённого обращения. Mini-batch k-means масштабируется до больших данных с компромиссом приближения. Для разреженного текста может лучше подойти сферический k-means, ориентированный на косинус, тогда как смеси, плотностные методы, иерархическая кластеризация или k-медоиды кодируют другие предположения.
Выбор k и проверка смысла
Кривые локтя, оценки силуэта, информационные критерии в связанных моделях и стабильность могут подсказать k, но ни один не обнаруживает единственно правильное число. Бизнес‑полезность и доменная интерпретация имеют значение. Переподгоняйте по образцам и сеянам, сравнивайте движение центроидов и согласованность назначений, и проверяйте кластеры на независимых результатах, не использованных при их формировании. Двумерная проекция может искажать разделение, поэтому изучайте расстояния и примеры в оригинальном или проверенном пространстве представления.
Кластеры — описательные группы, созданные выбранными признаками и метрикой; они не являются естественными типами или причинными сегментами. Профили, построенные на тех же переменных, что использовались для кластеризации, могут быть круговыми. Используйте отложенные атрибуты и качественный обзор, проверяйте, воспроизводят ли кластеры в основном географию, источник данных или чувствительные характеристики. Маленькие кластеры могут быть аномалиями или артефактами. Присвоение имени кластеру не делает каждого его участника соответствующим этому ярлыку.
Развёртывание и обслуживание
Храните масштабирование, порядок признаков, центроиды, определение расстояния и метки кластеров вместе. Для новых точек следите за расстоянием до назначенного центроида и долей точек, сильно выходящих за границы обучающего диапазона; предоставляйте состояние «неизвестно» вместо принудительного назначения в кластер. Отслеживайте размеры кластеров, центроиды и релевантность результатов со временем. Переподготовка меняет идентичность кластеров, поэтому сопоставляйте или версионируйте downstream‑правила, а не молча переиспользуйте старые названия. k‑means — полезный базовый метод сжатия и сегментации, когда его геометрия соответствует задаче, но не универсальный движок открытий.
Практический пример: сегментация клиентов с помощью k‑means
Компания‑подписчик стандартизирует признаки использования за фиксированный период, удаляет идентификаторы аккаунтов и тестирует k по разным сеянам. Оцениваются стабильность, силуэт и бизнес‑результаты на отложенных данных, но продуктовые команды также проверяют репрезентативные и граничные аккаунты. Они обнаруживают, что один кластер состоит просто из новых клиентов с более коротким наблюдением, поэтому срок обслуживания обрабатывается явно. k‑means сравнивают с иерархическими и плотностными альтернативами, а не принимают его как данность. Упражнение рассматривается как обучение без учителя, а не открытие меток.
Сегменты направляют исследования и эксперименты с сообщениями, а не право доступа или цены. Новые аккаунты, находящиеся далеко от всех центроидов, получают статус «неизвестно». Масштабирование, признаки, центроиды и названия версионируются, а при переподготовке новые кластеры сопоставляются со старыми только при наличии доказательств. Мониторинг отслеживает размер кластера, расстояние и релевантность результатов. Чувствительные атрибуты и их прокси проверяются, и команда избегает описания кластеров как естественных типов личности, поскольку они являются математическими разбиениями выбранного поведения.
Доказательства внедрения и готовность к эксплуатации
Производственное решение требует больше, чем успешную демонстрацию. Определите целевых пользователей, рабочую среду, входы, выходы, зависимости, владельца и последствия каждой важной ошибки. Установите воспроизводимую базу и версионированный набор оценок до настройки. Тестируйте обычные случаи, граничные условия, некорректные или отсутствующие входы, сдвиг распределения, сбой зависимости, неправильное использование и группы или среды, которые могут быть недообслужены. Измеряйте качество задачи вместе с калибровкой или неопределённостью, задержкой, пропускной способностью, стоимостью ресурсов, доступностью, конфиденциальностью и безопасностью. Записывайте каждое преобразование и порог, чтобы независимый рецензент мог воспроизвести результат и различить доказательства и привлекательный прототип.
Перед запуском назначьте ответственных за выпуск, исключения, изменения, откат и вывод из эксплуатации. Используйте поэтапный релиз, сохраняйте безопасный откат и проверяйте мониторинг с преднамеренно введёнными сбоями. Оперативная телеметрия должна показывать качество входов, поведение вывода, версию модели или правила, состояние зависимостей, человеческие переопределения и подтверждённые результаты без сбора лишних чувствительных данных. Определите пороги тревоги и ответственного, затем после развертывания проверяйте реальные доказательства, а не предполагая, что офлайн‑показатели сохранятся. Переоценивайте при изменении источников данных, пользователей, моделей, поставщиков, политик, оборудования или целей. Поддерживаемая система также нуждается в документированных процедурах восстановления, обучения на инцидентах, удаления и хранения, а также в чёткой точке, где её следует отключить или заменить.
Часто задаваемые вопросы
Является ли k‑means контролируемым или неконтролируемым?
Это неконтролируемый метод, потому что он получает признаки и выбранное число кластеров, но не целевые метки.
Классифицирует ли k‑means новые данные?
После обучения новая точка может быть отнесена к ближайшему центроиду. Это назначение к кластеру, а не обязательно предсказание класса в контролируемом смысле.
Основные ссылки












