
Основы ИИ
Что такое разговорное распознавание речи (CSR)?

 Добавьте Unite.AI в избранные источники в Google
Разговорное распознавание речи (CSR) расширяет автоматическое распознавание речи за пределы отдельной транскрипции, используя контекст диалога, сигналы очередности, информацию о говорящем и обработку с низкой задержкой. Цель — поддержать живое взаимодействие, в котором важны слова, тайминг, прерывания и предыдущие реплики.
CSR — это развивающийся продуктовый и исследовательский термин, а не единый стандартизированный класс моделей. Надёжная система сочетает потоковое ASR с определением конечных точек, обработкой говорящих, контекстуальным языковым моделированием, состоянием диалога и политикой ответов, а затем оценивает опыт от начала до конца.
Ключевые выводы
- Потоковое распознавание выдаёт предварительные гипотезы и корректирует их по мере поступления нового аудио.
- Определение конечных точек и предсказание очередности отделены от точности транскрипции.
- История разговора и горячие слова могут улучшать распознавание, но также распространять ранние ошибки.
- Оценивайте задержку, прерывания, говорящих, акценты, шум, конфиденциальность и завершение задачи — а не только уровень ошибок слов.
От ASR к живому диалогу
Традиционный ASR преобразует аудио в текст. Разговорная система должна определять, когда слушать, когда реплика завершена, направлена ли речь к системе, и как восстанавливаться, если её транскрипция или ответ неверны.
Потоковые модели обрабатывают кадры инкрементально и создают частичные транскрипты. Низкая задержка повышает отзывчивость, но преждевременное фиксирование может увеличить количество правок или ошибок. Приложению нужна политика различения стабильного и предварительного текста.
Очередность, наложение и говорящие
Продолжительность тишины сама по себе является слабым сигналом конечной точки. Завершение лексики, просодия, тайминг, взгляд и состояние диалога могут помочь предсказать, удерживает ли человек слово или уступает его. Возможность «вмешаться» позволяет пользователю прервать синтезированную речь, не теряя контекст.
Перекрывающиеся голоса и диаризация остаются сложными задачами. Системы должны сохранять неопределённость относительно говорящего, избегать приписывания высказывания не тому человеку и предоставлять путь исправления — особенно для записей, используемых в здравоохранении, финансах или юридической сфере.
Контекстуальное распознавание
Предыдущие реплики могут уточнять имена и ссылки; списки горячих слов могут смещать распознавание в сторону терминов домена. Модели речи и языка могут кодировать аудио и текстовый контекст в общей схеме подсказок или внимания.
Контекст также может усиливать ошибочную раннюю транскрипцию или утекать между сессиями. Ограничьте историю текущей задачей, отделите надёжные метаданные от речи пользователя и используйте контекст трансформера с явными правилами сохранения и доступа.
Оценка и ответственное внедрение
Отчитывайтесь о потоковом уровне ошибок слов, задержке первого токена и финализации, частоте правок, ошибках конечных точек, успешности вмешательства, атрибуции говорящего и завершении задачи. Тестируйте реальные микрофоны, шум, акценты, переключение языков, инвалидность и эмоционально нагруженную речь.
Голосовые данные могут идентифицировать или раскрывать конфиденциальную информацию. Применяйте согласие, минимизацию, шифрование, ограничения хранения и человеческую проверку. Связывайте сгенерированные ответы с механизмами безопасности чат‑бота, поскольку точная транскрипция не делает ответ правильным или уполномоченным.
От акустического ввода к разговорному состоянию
Разговорная система речи захватывает аудио, применяет условную обработку сигнала, обнаруживает речь, распознаёт слова или семантические единицы, при необходимости идентифицирует говорящих и обновляет состояние диалога. Потоковые системы генерируют частичные гипотезы до окончания реплики. Эти гипотезы могут изменяться, поэтому последующие компоненты должны различать предварительные и окончательные результаты.
Обнаружение голосовой активности и определение конечных точек решают, когда начинается речь и когда пользователь закончил. Жёсткие пороги тишины не работают с медленными говорящими, фоновым шумом и паузами размышления. Модели очередности могут использовать слова, просодию, взгляд и контекст диалога, но должны балансировать быструю реакцию и прерывание говорящего.
Диаризация отвечает на вопрос, кто говорил и когда; распознавание говорящего определяет личность; разделение источников изолирует наложенные голоса. Это разные задачи с различными рисками. На совещаниях, в здравоохранении и обслуживании клиентов правильное приписывание слов нужному человеку может быть столь же важным, как уровень ошибок слов в транскрипте.
Контекст, наложение, эмоции и восстановление взаимодействия
Контекст разговора разрешает местоимения, эллипсис, исправления, доменные термины и ссылки на предыдущие реплики. Система может сочетать акустические доказательства с историей диалога и полученными знаниями, но прежний контекст также может смещать распознавание в сторону неверного ожидания. Сохраняйте аудио‑доказательства и уверенность, чтобы контекст не стирал безмолвно неопределённость.
Естественный диалог включает обратные сигналы, прерывания, ложные начала, смех, переключение языков и одновременную речь. Отзывчивый агент нуждается в обработке вмешательства: остановить или снизить свой вывод, захватить новую речь пользователя, решить, меняет ли прерывание намерение, и восстановиться без дублирования или потери действия.
Просодия и паралингвистические сигналы могут указывать на акцент или неуверенность, но вывод эмоций, состояния здоровья или намерений из голоса подвержен ошибкам и зависит от культуры. Используйте такие оценки консервативно, раскрывайте их при необходимости и не принимайте важные решения на основе непроверенной метки эмоции.
Оценка, конфиденциальность и проектирование производства
Уровень ошибок слов остаётся полезным, но оценка разговорных систем должна также измерять атрибуцию говорящего, точность сущностей, успех семантической задачи, стабильность частичных гипотез, задержку конечных точек, успешность прерываний, восстановление и частоту исправлений пользователем. Сегментируйте по акценту, языку, устройству, шуму, наложению, стилю речи и условиям сети.
Потоковая архитектура требует ограниченных буферов, обратного давления, повторного соединения, номеров последовательностей и явной финализации. Держите бюджеты задержки модели и диалога раздельно, отслеживайте каждый этап и тестируйте ухудшённые сети. Когда система инициирует действия, подтверждайте намерения с высоким воздействием и делайте повторные попытки идемпотентными, чтобы повторяющееся аудио или переподключения не дублировали транзакции.
Речь содержит информацию об идентичности, содержимом, окружении и посторонних. Минимизируйте хранение, шифруйте передачу и хранение, контролируйте доступ, определяйте удаление и различайте аудио от полученных транскриптов и эмбеддингов. Предоставляйте видимые индикаторы записи и альтернативы, когда согласие отсутствует. Локальная модель может уменьшить передачу данных, но всё равно требует разрешения и контроля жизненного цикла.
Практический пример: голосовой агент, обрабатывающий прерывание и исправление
Звонящий говорит: «Забронировать вторник — нет, среда после обеда», пока агент начинает отвечать после слова «вторник». Потоковое распознавание выдаёт меняющиеся частичные транскрипты, определение конечных точек фиксирует продолжение речи, а вмешательство останавливает вывод. Состояние диалога помечает прежнюю дату как заменённую, а не создаёт два запроса. Подтверждение сущности сосредотачивается на исправленной дате и времени, при этом система сохраняет уверенность и доказательства для окончательной интерпретации.
Архитектура разделяет захват аудио, обнаружение речи, потоковое распознавание, обработку говорящих, политику диалога, выполнение инструмента и синтез. Номера последовательностей и финализация предотвращают поздние частичные результаты от перезаписи окончательной транскрипции. Инструмент бронирования принимает структурированный запрос, проверяет авторизацию и доступность и использует ключ идемпотентности. Последующее бронирование озвучивается и подтверждается перед выполнением; повторное соединение не может тихо повторить его.
Тестирование сочетает точность слов и сущностей с задержкой конечной точки, успешностью прерываний, обработкой исправлений, атрибуцией говорящего, завершением задачи и уровнем дублирования действий. Сценарии охватывают шум, наложение, акценты, переключение языков, медленную речь, вспомогательные устройства, слабые сети и синтетические атаки. Хранение аудио минимизируется и раскрывается, данные посторонних обрабатываются явно, а пользователи могут переключиться на текст или живого человека. Интеллект разговорного взаимодействия измеряется безопасным восстановлением и результатом, а не только точностью транскрипции.
Практический чек‑лист реализации
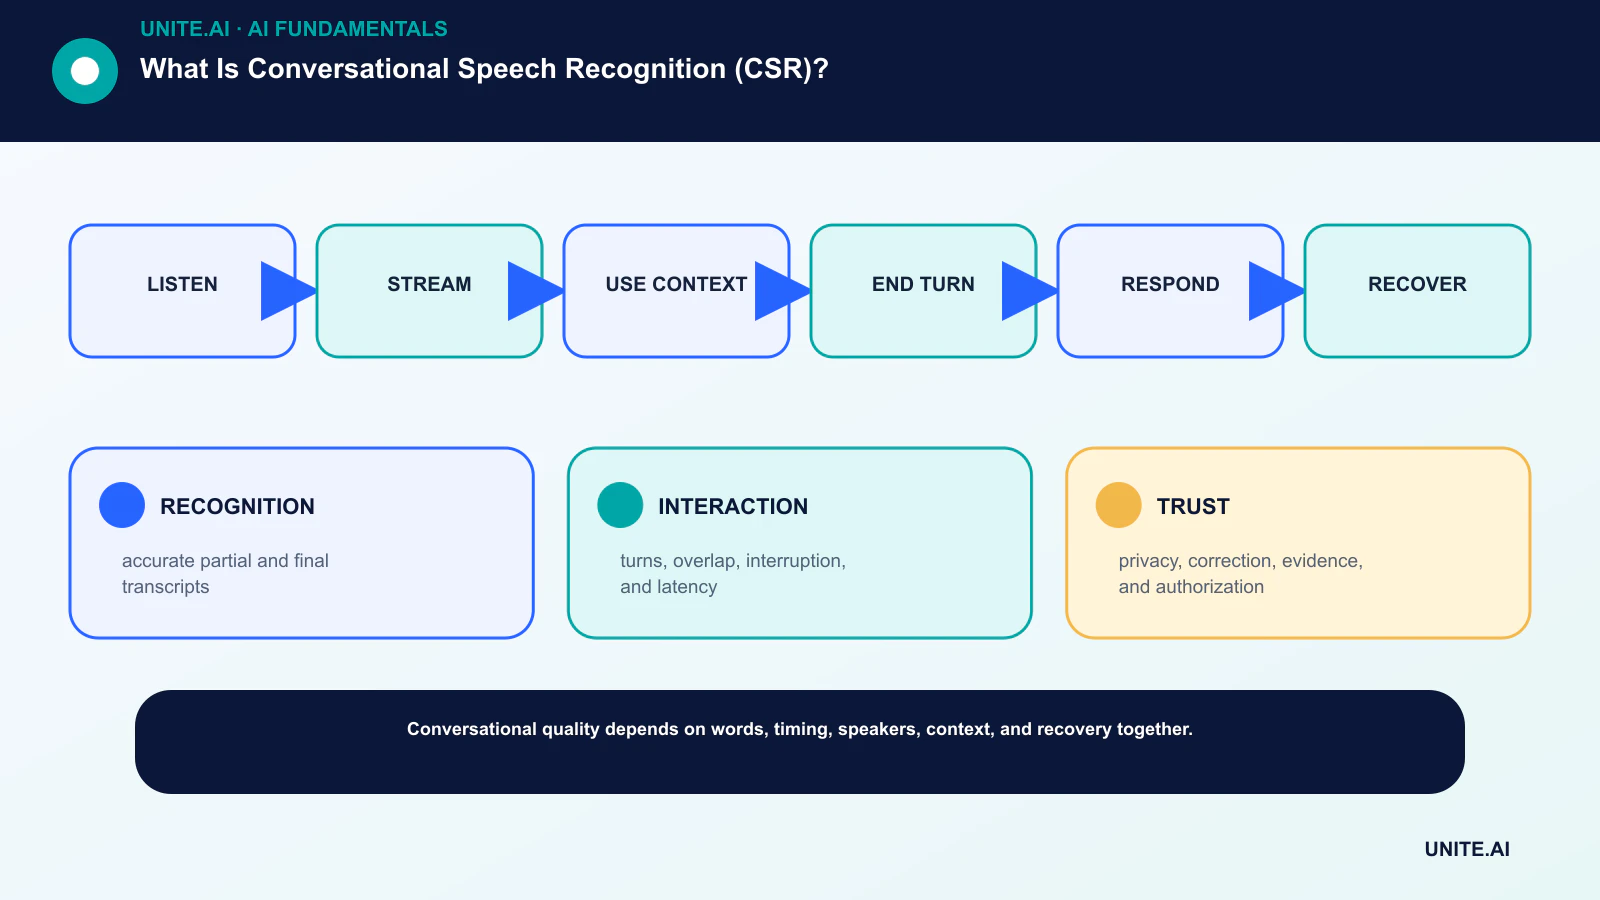
Преобразуйте концепцию в ограниченный, проверяемый рабочий процесс: слушать → поток → использовать контекст → завершать реплику → отвечать → восстанавливать. Назначьте ответственного, задокументируйте данные и зависимости, установите простую базовую линию, задайте критерии принятия и остановки, протестируйте типичные сбои и определите мониторинг, откат и обзор перед расширением области. Записывайте версии и предположения, чтобы другая команда могла воспроизвести результат и понять, что изменилось.
Перед запуском проведите документированный обзор готовности с людьми, которые разрабатывают, эксплуатируют, защищают систему и затрагиваются ею. Тестируйте обычные случаи, граничные условия, сбои зависимостей и неправильное использование; сохраняйте доказательства и нерешённые риски. Определите, кто может одобрить выпуск, изменить порог, переопределить вывод или остановить работу. Пересмотрите решение после поступления реальных данных, поскольку технически успешный пилот не гарантирует надёжную работу в более широком масштабе.
- РАСПОЗНАВАНИЕ: точные частичные и окончательные транскрипты.
- ВЗАИМОДЕЙСТВИЕ: очереди, наложения, прерывания и задержка.
- ДОВЕРИЕ: конфиденциальность, исправления, доказательства и авторизация.
Часто задаваемые вопросы
Отличается ли CSR от ASR?
ASR — это компонент преобразования речи в текст. CSR использует ASR вместе с контекстом диалога, таймингом, обработкой говорящего и конечных точек, а также политиками взаимодействия для живого разговора.
Гарантирует ли более низкий уровень ошибок слов лучший голосовой агент?
Нет. Система может точно транскрибировать, но при этом прерывать пользователей, отвечать медленно, неправильно приписывать реплики говорящим или выполнять неверное действие. Требуются сквозные метрики взаимодействия.
Основные ссылки












