
Основы ИИ
Как работает классификация текста?

 Добавьте Unite.AI в избранные источники в Google
Текстовая классификация присваивает один или несколько ярлыков документу, сообщению или отрезку текста. Примеры включают обнаружение спама, маршрутизацию по намерению, анализ тональности, маркировку тем, модерацию и приоритизацию заявок в службу поддержки.
Рабочий классификатор — это больше, чем модель. Он опирается на точную таксономию меток, репрезентативные аннотации, разделения, защищённые от утечки, калиброванное правило принятия решений и мониторинг изменяющегося языка и распространённости классов.
Ключевые выводы
- Определите метки и неоднозначные случаи до выбора архитектуры.
- Простые базовые модели «мешок слов» остаются ценными; предобученные энкодеры добавляют контекст и используют перенос обучения.
- Точность может скрывать плохую работу с миноритарными классами, поэтому используйте метрики, учитывающие классы, и анализ ошибок.
- Калибровка вероятностей, отказ от классификации и человеческий контроль превращают оценки в более надёжные решения.
Определение таксономии и политики аннотирования
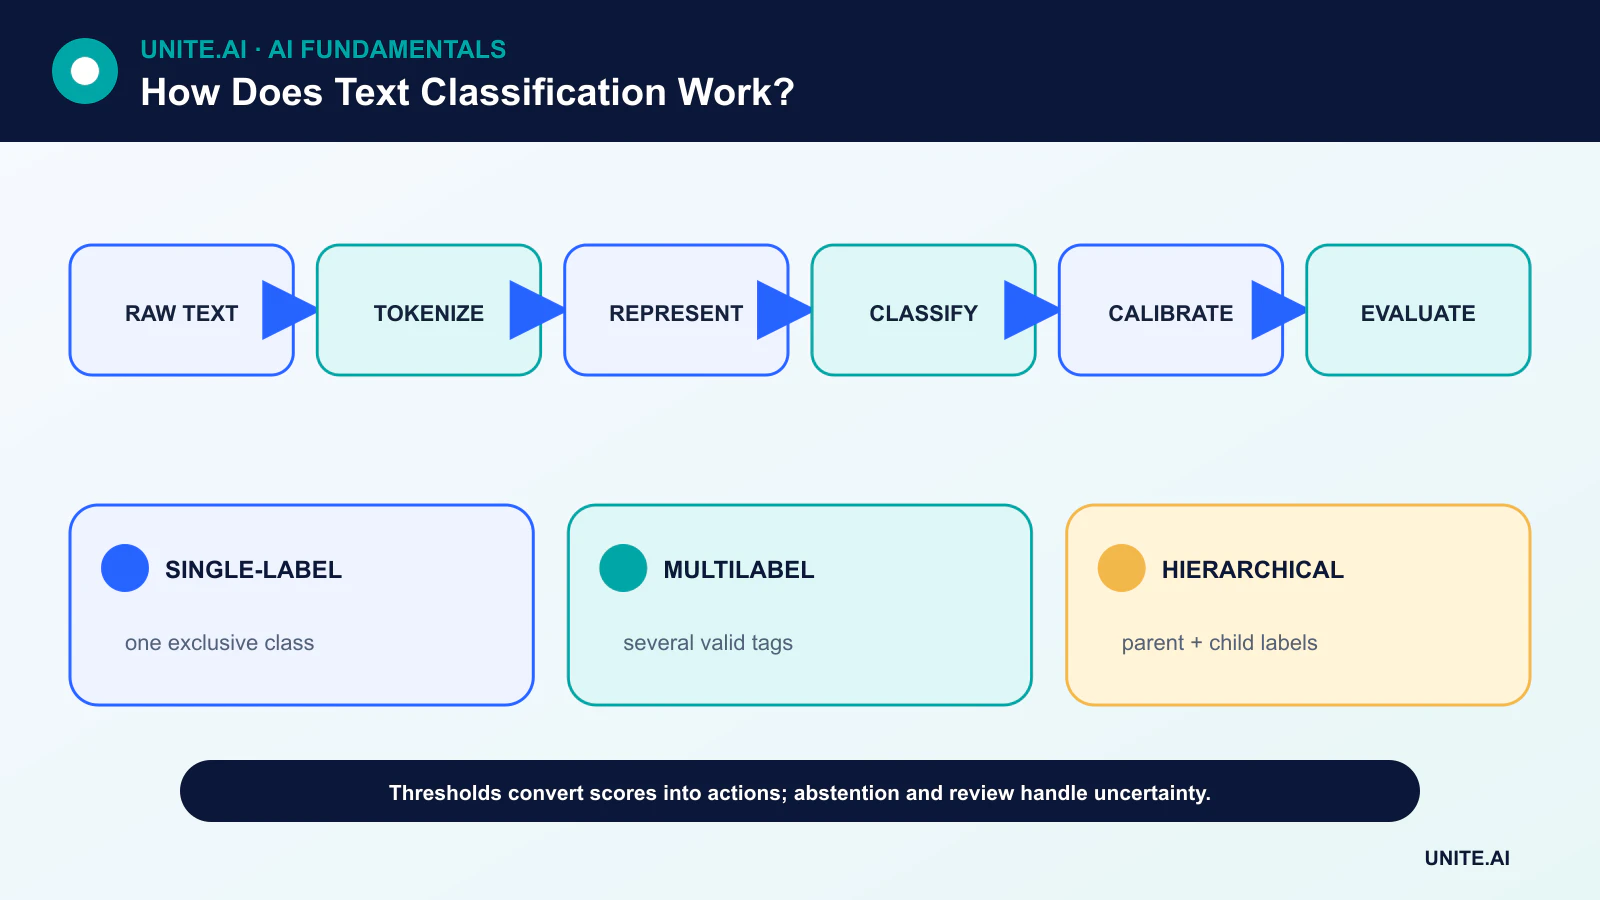
Задача с единственной меткой выбирает один взаимоисключающий класс. Задача с несколькими метками может присваивать несколько независимых тегов. Иерархические таксономии содержат родительские и дочерние метки. Это разные задачи обучения, требующие различных выходов и метрик.
Аннотаторам нужны определения, положительные и отрицательные примеры, правила для отсутствующего контекста и путь эскалации. Статистика согласия может выявить неясную задачу, но разногласия также могут отражать истинную неоднозначность, которую система должна сохранять.
Представление текста
Традиционные конвейеры используют подсчёт токенов, n‑граммы и TF‑IDF с линейными классификаторами или машинами опорных векторов. Они быстро обучаются, выявляют влиятельные термины и обеспечивают надёжную базовую линию.
Нейронные системы отображают токены в эмбеддинги. Предобученные трансформер‑энкодеры используют внимание для получения контекстных представлений и могут дообучаться на размеченных примерах. Классификаторы с подсказками или zero‑shot могут снизить объём начальной разметки, но формулировка меток, версия модели и калибровка должны оцениваться в конкретном домене.
Обучение без утечки
Набор данных делится на обучающую, валидационную и финальную тестовую части. Похожие документы, сообщения из одной беседы или шаблоны из одного источника должны оставаться в одном разрезе. Для временно‑зависимых сценариев хронологическое разделение лучше отражает условия эксплуатации.
Дисбаланс классов можно компенсировать взвешиванием, пере/недо‑семплированием, выбором порога или дополнительными данными. Синтетические примеры не должны заменять проверку реальных ошибок миноритарных классов и могут вводить артефакты, которые модель усваивает слишком легко.
Метрики и калиброванные решения
Матрица ошибок показывает, какие метки путаются. Точность измеряет, какая доля предсказанных положительных результатов верна; полнота измеряет, какая часть истинных положительных найдена. Макро‑средние взвешивают классы одинаково, а микро‑средние — отдельные примеры.
Сырая оценка softmax не является автоматически достоверной вероятностью. Калибровка сравнивает уверенность с наблюдаемой точностью. Команды могут задавать пороги для каждого класса, отказываться от классификации при низкой уверенности и направлять чувствительные случаи к проверяющему.
Развёртывание, многоязычное использование и дрейф
Текст меняется вместе с продуктами, событиями, сленгом и враждебным поведением. Мониторинг должен отслеживать язык входных данных, их длину, паттерны вне словаря, частоту классов, уверенность и отложенные результаты. Переподготовка требует версионирования данных и набора регрессионных тестов с важными примерами.
Многоязычную эффективность необходимо тестировать для каждого языка и диалекта. Перевод всего на один язык может изменить тональность или сущности; многоязычный энкодер всё равно может работать неравномерно, поскольку его предобучение и метки не одинаково репрезентативны.
Представления и семейства классификаторов
Текстовая классификация сопоставляет документ, предложение или последовательность токенов одной или нескольким меткам. Определите, являются ли метки взаимоисключающими, многометочными, иерархическими, упорядоченными или открытого набора. Традиционные конвейеры токенизируют текст, формируют признаки «мешок слов» или TF‑IDF и обучают логистическую регрессию, наивный Байес или линейный SVM. Нейронные системы обучают эмбеддинги с помощью свёрток, рекуррентных сетей или трансформеров. Языковые модели с подсказками могут классифицировать без специфической для задачи обучения, но ограничения вывода, стоимость, дрейф и доказательства всё равно требуют оценки по сравнению с более простыми базовыми моделями.
Предобработка зависит от представления. Приведение к нижнему регистру или удаление пунктуации может уничтожить сигналы для имён, тональности, кода или языка; стемминг может объединять разные значения. Токенизаторы трансформеров работают с субсловами и имеют ограничения по длине, поэтому стратегия усечения важна. Длинные документы могут требовать разбиения на части и агрегации. Сохраняйте исходный текст и версию трансформации, а также делите данные по автору, беседе, источнику или времени, чтобы избежать пересечения почти дублирующих и повторяющихся шаблонов между обучающей и тестовой выборками.
Метки, метрики и анализ ошибок
Руководство по аннотированию должно определять область применения, примеры, неоднозначные случаи и опцию «неизвестно» или «отказ». Измеряйте согласие и разрешайте разногласия, а не скрывайте их голосованием большинства. Для несбалансированных классов точность недостатна; необходимо сообщать точность, полноту, F1, матрицу ошибок, калибровку и нагрузку по порогу для каждого класса. Задачам с несколькими метками нужны микросредние, макросредние и метрики на уровне меток. Оценивайте языки, диалекты, домены, длину сообщений и время. Случайное разбиение может завышать качество при дрейфе словаря или шаблонов.
Анализ ошибок должен различать сбой представления, недостаточный контекст, неоднозначность меток, редкую лексику, отрицания, сарказм и ложные подсказки. Используйте контрфактические тесты, меняющие имена, маркеры диалекта или нерелевантные метаданные, сохраняя смысл. Исследуйте ошибки с высокой уверенностью и отклонённые случаи. Модель может выучить, что канал клиента или подпись предсказывают метку, а не интерпретируют содержание. Удаляйте утечки и пересматривайте данные, прежде чем просто увеличивать ёмкость модели.
Проектирование в продакшене
Обеспечьте работу фиксированного токенизатора и модели с проверкой схемы, ограничениями по длине, пакетной обработкой и резервным вариантом для неподдерживаемого языка или низкой уверенности. Мониторьте распределение входных данных, частоту меток, калибровку, задержку и проверенные результаты. Защищайте текст, поскольку он может содержать персональные, конфиденциальные или враждебные инструкции. Для автоматической модерации, определения правомочности или маршрутизации предоставляйте возможность обжалования и измеряйте различия в ошибках. Версионируйте метки и пороги согласно бизнес‑политике. Текстовая классификация надёжна только в рамках определённой системы меток и распределения данных; беглые объяснения модели не доказывают правильность классификации.
Практический пример: классификация входящих запросов в службу поддержки
Команда поддержки определяет взаимоисключающие метки маршрутизации, а также флаги «срочно», «многоязычно» и «неизвестно». Аннотаторы размечают деперсонифицированные сообщения с рекомендациями для смешанных проблем и измеряют согласие. Базовая модель логистической регрессии на основе TF‑IDF, дообученный энкодер и модель с подсказкой используют один и тот же тестовый набор, построенный по времени. Оценка включает точность и полноту по классам, ложные отрицательные результаты по срочным запросам, калибровку, валидность схемы, задержку и стоимость, при этом почти дублирующие шаблоны группируются, чтобы избежать утечки.
Развёрнутый классификатор проверяет язык и длину, отказывается от классификации при слабых доказательствах и позволяет агентам корректировать маршруты. Подсказки и сообщения считаются недоверенными; доступ к инструментам отсутствует. Мониторинг отслеживает распространённость меток, уверенность, исправления, время отклика и появляющиеся темы. Политика или изменение продукта обновляют таксономию и данные для переобучения через проверку. Система улучшает размещение в очереди, но не делает выводов о эмоциях или праве клиента, выходящих за пределы проверенных меток.
Доказательства реализации и готовность к эксплуатации
Решение о внедрении требует большего, чем успешная демонстрация. Определите целевых пользователей, эксплуатационную среду, входные и выходные данные, зависимости, владельца и последствия каждого важного сбоя. Установите воспроизводимую базовую линию и версионированный набор для оценки до настройки. Тестируйте обычные случаи, граничные условия, некорректные или отсутствующие входные данные, сдвиг распределения, отказ зависимостей, неправильное использование и группы или среды, которые могут быть недостаточно обслужены. Оценивайте качество задачи совместно с калибровкой или неопределённостью, задержкой, пропускной способностью, затратами ресурсов, доступностью, конфиденциальностью и безопасностью. Записывайте каждое преобразование и порог, чтобы независимый рецензент мог воспроизвести результат и отличить доказательства от привлекательного прототипа.
Перед запуском назначьте ответственных за выпуск, исключения, изменения, откат и вывод из эксплуатации. Используйте поэтапный развёртывание, сохраняйте безопасный резерв и проверяйте мониторинг с преднамеренно внесёнными сбоями. Оперативная телеметрия должна раскрывать качество входных данных, поведение вывода, версию модели или правила, состояние зависимостей, человеческие вмешательства и подтверждённые результаты без сбора ненужных конфиденциальных данных. Определите пороги оповещений и ответственного за реакцию, затем проверяйте реальные доказательства после внедрения, а не полагайтесь на сохранение офлайн‑показателей. Проводите переоценку при изменении источников данных, пользователей, моделей, поставщиков, политик, оборудования или целей. Поддерживаемая система также требует документированных процедур восстановления, обучения на инцидентах, удаления и хранения данных, а также чёткой точки, в которой её следует отключить или заменить.
Часто задаваемые вопросы
Является ли анализ тональности задачей текстовой классификации?
Обычно да, но тональность может быть многометочной, аспектной или непрерывной, а не единственной меткой позитив/нейтраль/негатив.
Когда классификатор текста должен отказываться от классификации?
Когда уверенность низка, текст выходит за пределы области, отсутствует необходимый контекст или стоимость неверного автоматического действия превышает стоимость проверки.
Основные ссылки












