
Основы ИИ
Что такое анализ тональности? Методы, применения и ограничения

 Добавьте Unite.AI в избранные источники в Google
Анализ тональности оценивает оценочный язык в тексте, расшифровках речи или другом контенте. Система может классифицировать полярность, например положительную, отрицательную или нейтральную; выявлять мнения на уровне аспектов; оценивать интенсивность; или определять позицию по отношению к конкретному утверждению.
Цель должна быть определена тщательно. Тональность не тождественна эмоциям, намерениям, токсичности, удовлетворённости или истине. Положительное предложение может саркастически описывать вредное событие, тогда как отрицательный отзыв о продукте всё равно может в целом рекомендовать его.
Ключевые выводы
- Определите единицу, цель, метки и контекст перед сбором примеров.
- Лексиконы являются прозрачными базовыми моделями; контролируемые и трансформерные модели могут захватывать больше контекста, но требуют репрезентативных данных.
- Отрицание, сарказм, специализированный словарь, многоязычный текст и границы аспектов остаются сложными.
- Оценивайте по каждому классу, подгруппе, домену и периоду времени; включайте человеческую проверку для значимых применений.
Уровни и цели
Анализ на уровне документа выдаёт одну метку для всего элемента. Анализ на уровне предложения разделяет отдельные высказывания, а анализ, основанный на аспектах, связывает тональность с сущностью или атрибутом — например, положительно относительно качества изображения, но отрицательно относительно времени работы батареи.
Позиция (stance) задаёт вопрос, поддерживает ли говорящий конкретное утверждение, что может отличаться от эмоционального тона. Эти различия следует зафиксировать в руководстве по аннотированию перед применением методов классификации текста.
Лексиконы, классические модели и трансформеры
Лексикон присваивает словам оценки и комбинирует их с правилами для отрицания или интенсивности. Он интерпретируем и недорог, но испытывает трудности с контекстом. Классические контролируемые модели используют признаки слов или n‑gram, тогда как трансформеры обучают контекстные представления и могут быть дообучены.
Запросы с небольшим числом примеров могут быть удобны, но результаты зависят от примеров и формулировок. Сравнивайте каждый сложный подход с базовой моделью и используйте обучение с небольшим количеством примеров только с отложенным, версионированным набором для оценки.
Проблемы данных и языка
Метки могут отражать точку зрения аннотатора, а не объективный факт. Сдвиг домена выражен сильно: «непредсказуемый» может быть похвалой для фильма и критикой для автомобиля. Перекодировка, диалекты, эмодзи, цитируемая речь и ирония усложняют сигналы на уровне токенов.
Сбалансируйте классы намеренно и не допускайте утечки связанных авторов, продуктов или разговоров между обучающей и тестовой выборками. Модель, запоминающая бренд или говорящего, может выглядеть точной, не изучая тональность.
Оценка и ответственное использование
Отчитывайтесь о точности (precision), полноте (recall), F1 и матрице ошибок, а не только об общей точности. Анализируйте ошибки по аспектам, длине, диалекту и времени, а также калибруйте пороги с учётом операционных затрат на каждую ошибку.
Сводные тенденции могут поддерживать исследования или триаж, но вывод о состоянии отдельного человека или принятие решений в сфере занятости, кредитования, здравоохранения или правоохранительных органов создаёт больший риск. Предоставляйте оценку неопределённости, контекст источника, средства защиты конфиденциальности и человеческую проверку.
Аннотирование и построение набора данных
Составьте руководство по аннотированию, включающее целевую сущность, единицу анализа, определения меток, обработку смешанных и нейтральных случаев, правила цитирования, политику в отношении сарказма и примеры из домена. Проведите пилот с несколькими аннотаторами, вычислите согласие, обсудите разногласия и пересмотрите задачу перед масштабированием меток.
Выборка определяет, чему обучается модель. Поток из социальных сетей может переоценивать активных аккаунтов; запросы в службу поддержки могут исключать довольных клиентов; рейтинги в звёздах могут не соответствовать тексту отзыва. Сохраняйте метаданные источника и времени, соблюдайте условия платформ и конфиденциальность, и создавайте тестовый набор из той популяции, где будут приниматься решения.
Утечка меток может происходить через оценки, эмодзи, вставленные системой сбора, шаблонные подписи или названия продуктов, коррелирующие с тональностью. Удаляйте почти идентичные посты и группируйте разговоры или авторов, чтобы их язык не появлялся по обе стороны разбиения.
Выбор моделей и калибровка
Системы на основе лексикона суммируют оценки слов и корректируют их с учётом отрицаний, усилителей, пунктуации или эмодзи. Они предоставляют полезную проверку здравого смысла и могут быть адаптированы с учётом терминов домена. Линейные модели с признаками TF–IDF остаются конкурентоспособными на некоторых наборах данных и выявляют влиятельные n‑gram.
Контекстные энкодеры представляют слова в зависимости от окружающего текста и могут быть дообучены под полярность или аспекты. Длинные документы могут требовать иерархических моделей, агрегации предложений или извлечения релевантных фрагментов. Многоязычные подходы могут обучать одну общую модель, переводить на промежуточный язык или поддерживать локальные модели; каждый вариант имеет свои охват и культурные компромиссы.
Калибровка вероятностей важна, когда оценки вызывают действия. Диаграммы надёжности и ожидаемая ошибка калибровки показывают, соответствует ли заявленная уверенность 0,8 примерно 80‑процентной точности. Пороги могут создавать диапазон отказа для человеческой проверки, а отдельные пороги могут быть обоснованы, когда стоимость ошибок различается — не для сокрытия неравного качества.
Применения и распространённые неверные толкования
Сводная тональность может помочь в приоритизации тем, сравнении реакций на кампании или маршрутизации срочных сервисных сообщений. Анализ аспектов часто более практичен, чем общая полярность, поскольку выявляет, о чём говорят люди. Анализ тенденций требует стабильной выборки и постоянных определений меток во времени.
Не приравнивайте распространённость негативных постов к мнению всей популяции. Поведение при публикации, боты, модерация, демография платформы, кампании и запросы сбора формируют выборку. Модель тональности не измеряет молчаливую часть населения, и изменение формулировки может выглядеть как изменение отношения.
Для индивидуальных решений ошибочные метки могут стигматизировать и быть трудными для оспаривания. Избегайте использования тональности как замены показателям вовлечённости сотрудников, психическому здоровью, кредитоспособности, намерениям или обману. Когда затрагиваются люди, показывайте контекст источника, позволяйте исправления и требуйте участия человека‑принимающего решения с реальной свободой.
Практический пример: анализ тональности отзывов клиентов
Компания, анализирующая комментарии поддержки, должна определить, нужен ли ей документальный уровень тональности, тональность аспектов, эмоция, срочность или классификация проблемы. «Доставка была быстрой, но продукт сломался» нельзя адекватно отразить одной меткой «положительно‑или‑отрицательно». Создайте руководство по аннотированию целей, отрицаний, сарказма, смешанных высказываний, цитируемой речи и неизвестных случаев, затем измерьте согласие перед тем, как считать метки истинными.
Сравните лексикон или линейную базовую модель с дообученным энкодером или моделью, полученной с запросом. Разделите данные по времени или клиенту, чтобы предотвратить утечку почти дублирующихся записей, и сохраняйте распределение классов. Отчитывайтесь о точности, полноте, F1, калибровке и матрице ошибок по языку, каналу, продукту и демографическим прокси только там, где это законно и оправдано. Анализируйте ошибки с высокой уверенностью, так как они более опасны в автоматической маршрутизации, чем неопределённые выводы, которые эскалируются.
Используйте тональность как один из сигналов для агрегации или приоритизации, а не как безусловную меру состояния человека. Следите за изменениями словарного запаса и продуктов, переобучайте модель на проверенных примерах и позволяйте агентам исправлять метки. Никогда не делайте выводы о защищённых характеристиках или не наказывайте работников на основе непроверенных оценок тональности. Для отчётности руководству показывайте размер выборки, степень неопределённости, недостающие данные и темы, влияющие на изменения, чтобы колеблющаяся оценка приводила к расследованию, а не к упрощённому выводу.
Многоязычное развертывание не должно предполагать, что перевод входных данных сохраняет тон, отрицание, идиому или культурные нормы. Проверяйте каждый поддерживаемый язык и смешанные языковые конструкции с помощью носителей, и предоставляйте результат «неизвестно», когда доказательства слабы. Адаптация к домену также важна: слова, звучащие негативно в обычном разговоре, могут быть нейтральными техническими описаниями. Поддерживайте отдельные пороги или модели только тогда, когда операционные доказательства оправдывают дополнительную сложность и нагрузку на управление.
Практический чек‑лист реализации
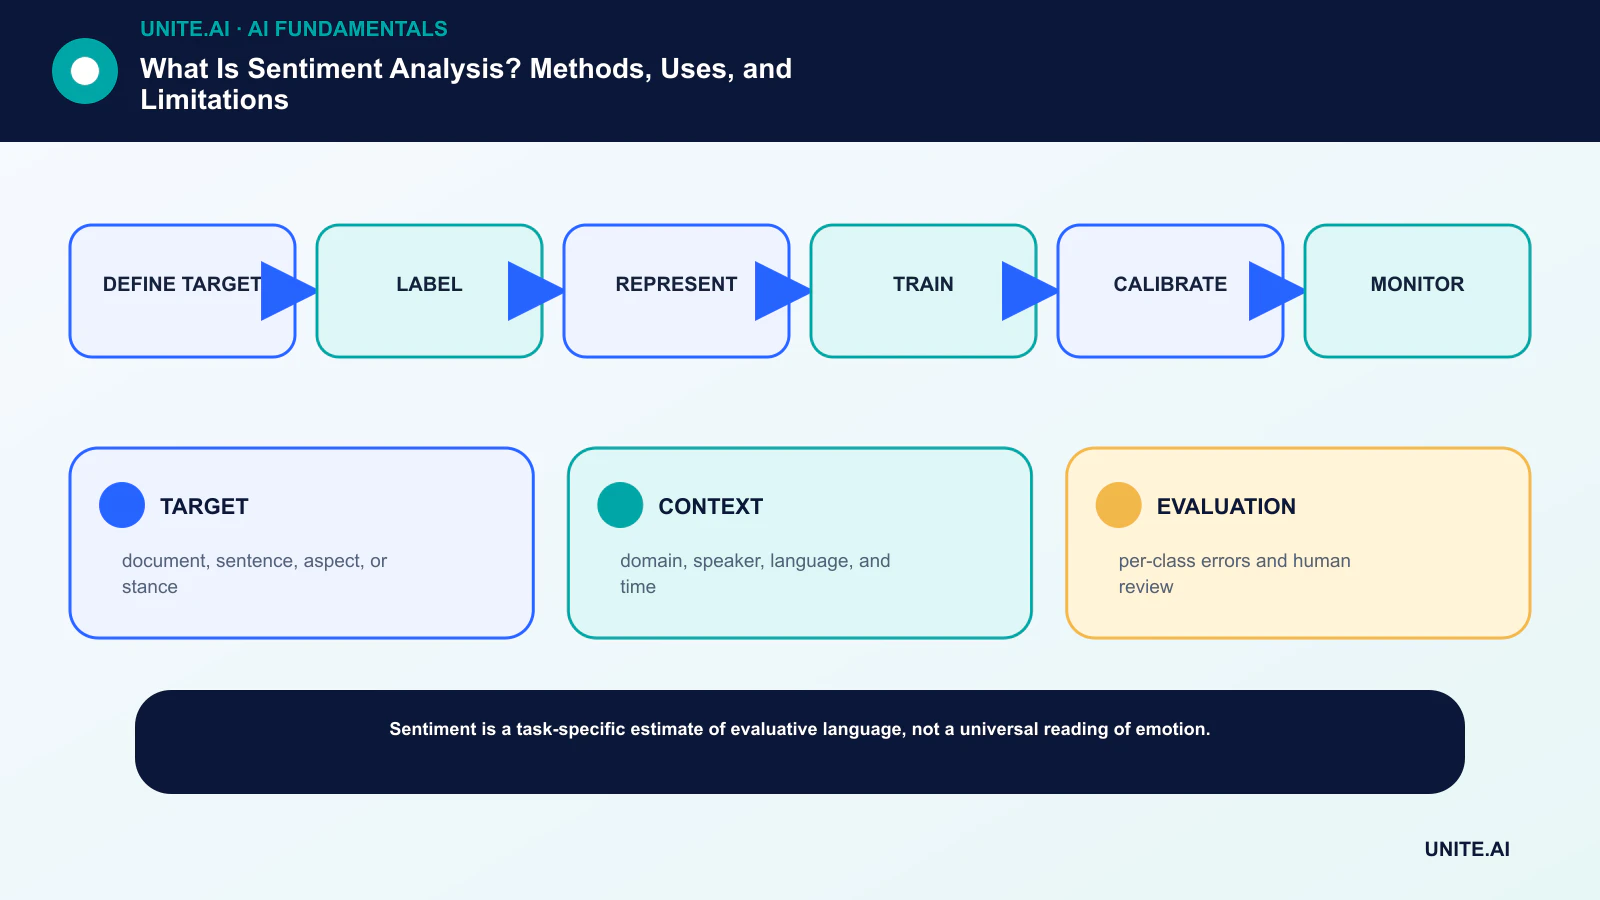
Превратите концепцию в ограниченный, проверяемый рабочий процесс: определите цель → метку → представление → обучение → калибровку → мониторинг. Назначьте ответственного владельца, задокументируйте данные и зависимости, установите простую базовую модель, задайте критерии принятия и остановки, протестируйте типичные сбои и определите мониторинг, откат и проверку перед расширением области. Записывайте версии и предположения, чтобы другая команда могла воспроизвести результат и понять, что изменилось.
Перед запуском проведите документированный обзор готовности с людьми, которые разрабатывают, эксплуатируют, защищают систему и на которых она влияет. Протестируйте обычные случаи, граничные условия, сбои зависимостей и неправильное использование; сохраняйте доказательства и нерешённые риски. Определите, кто может одобрять выпуск, менять порог, переопределять вывод или останавливать работу. Пересмотрите решение после поступления реальных данных, поскольку технически успешный пилот не гарантирует надёжную работу в более широком масштабе.
- ЦЕЛЬ: документ, предложение, аспект или позиция.
- КОНТЕКСТ: домен, говорящий, язык и время.
- ОЦЕНКА: ошибки по каждому классу и человеческая проверка.
Часто задаваемые вопросы
Является ли анализ тональности объективным?
Нет. Он оценивает метки, определённые задачей и процессом аннотирования. Некоторые тексты действительно неоднозначны, смешаны, зависят от контекста или интерпретируются по‑разному читателями.
Может ли анализ тональности обнаруживать сарказм?
Модели могут выучить некоторые шаблоны, но сарказм часто зависит от истории говорящего, общих знаний и контекста за пределами текста. Это остаётся распространённым режимом отказа.
Основные ссылки












