
Podstawy AI
Czym jest uczenie maszynowe?

 Dodaj Unite.AI do preferowanych źródeł w Google
Uczenie maszynowe (ML) to gałąź sztucznej inteligencji, w której system wyciąga wzorce z danych, aby móc dokonywać prognoz, klasyfikacji, rekomendacji lub podejmować decyzje, bez konieczności pisania przez programistę osobnych reguł dla każdego możliwego przypadku. Efektem nie jest maszyna „myśląca” jak człowiek. Jest to model statystyczny, który mapuje wejścia na użyteczne wyjścia i może być oceniany na danych, których nie widział podczas treningu.
Uczenie maszynowe mieści się w szerszej dziedzinie AI, podczas gdy głębokie uczenie jest rodziną metod uczenia maszynowego opartych na wielowarstwowych sieciach neuronowych. To rozróżnienie ma znaczenie: nie każdy system AI wykorzystuje ML, a nie każdy problem ML wymaga sieci neuronowej.
Kluczowe wnioski
- ML uczy się zależności na podstawie przykładów, zamiast polegać wyłącznie na ręcznie napisanych regułach.
- Przydatny model musi uogólniać się na nowe dane, a nie jedynie zapamiętywać swój zestaw treningowy.
- Nadzorowane, nienadzorowane, półnadzorowane, samonadzorowane i uczenie ze wzmocnieniem rozwiązują różne rodzaje problemów.
- Jakość danych, projektowanie ewaluacji i monitorowanie są tak samo ważne jak algorytm.
Jak działa uczenie maszynowe
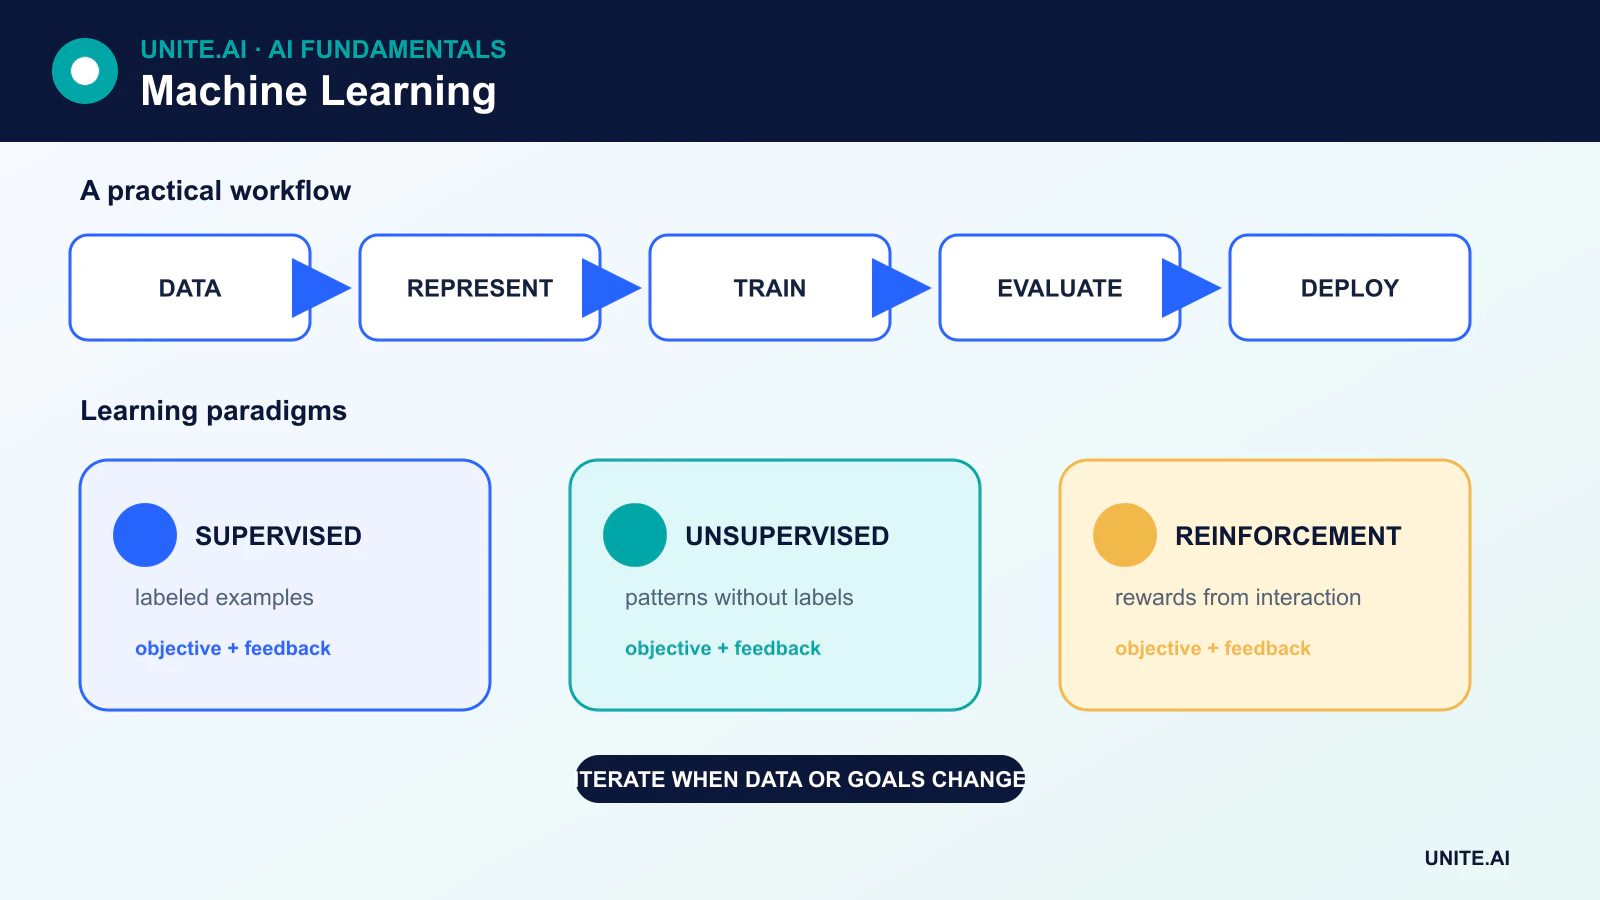
Większość projektów ML można rozumieć jako sekwencję sześciu etapów:
- Zdefiniuj zadanie. Określ, co system ma przewidywać lub odkrywać oraz co oznacza sukces w rzeczywistej aplikacji.
- Zbierz i przygotuj dane. Oczyść rekordy, obsłuż brakujące wartości, utwórz użyteczne cechy i udokumentuj, skąd pochodzą dane.
- Podziel dane. Zestaw treningowy służy do dopasowania modelu, zestaw walidacyjny pomaga wybrać ustawienia, a zestaw testowy zapewnia ostateczną ocenę na nieużywanych danych.
- Trenuj model. Algorytm dostosowuje parametry modelu, aby zmniejszyć funkcję straty lub spełnić inny cel uczenia.
- Oceń uogólnianie. Metryki muszą odzwierciedlać zadanie, równowagę klas, koszty błędów oraz populację, na której model będzie działał.
- Wdroż i monitoruj. Dane rzeczywiste mogą się zmieniać, więc zespoły obserwują dryf, pogorszenie wydajności, uprzedzenia i awarie operacyjne.
Zmienne dostarczane do modelu nazywane są zwykle cechami. W uczeniu nadzorowanym pożądana odpowiedź nazywana jest etykietą lub wartością docelową. Wyuczone parametry modelu kodują zależność między cechami a wyjściem; nie są one bazą danych wyraźnych reguł.
Główne paradygmaty uczenia
Uczenie nadzorowane
W uczeniu nadzorowanym przykłady zawierają zarówno wejścia, jak i znane cele. Model klasyfikacji przewiduje kategorie, np. czy transakcja jest oszukańcza. Model regresji przewiduje wartość ciągłą, np. przewidywany popyt na energię.
Typowe algorytmy nadzorowane obejmują drzewa decyzyjne, maszyny wektorów nośnych, K-najbliższych sąsiadów, regresję liniową i logistyczną, drzewa gradientowo-boostowane oraz sieci neuronowe. Próg klasyfikacji, taki jak 0,5, jest decyzją podjętą po tym, jak model wygeneruje wynik lub prawdopodobieństwo; nie jest to niezmienna własność regresji logistycznej.
Uczenie nienadzorowane
Uczenie nienadzorowane pracuje na danych, które nie zawierają etykiet docelowych. Celem może być znalezienie klastrów, wykrycie nietypowych obserwacji, oszacowanie rozkładu lub stworzenie reprezentacji o niższej wymiarowości. Klaster to grupa sugerowana przez regułę podobieństwa; nie jest automatycznie znaczącą klasą w rzeczywistości.
Przykłady obejmują klasteryzację K‑means, analizę głównych składowych, estymację gęstości oraz niektóre formy autoenkoderów. Autoenkoder uczy się odtwarzać swoje wejście poprzez skompresowaną reprezentację. Nie tworzy automatycznie etykiet prawdziwych danych.
Uczenie półnadzorowane i samonadzorowane
Uczenie półnadzorowane łączy mały zestaw danych z etykietami z większym zestawem nieoznaczonym. Uczenie samonadzorowane tworzy sygnał treningowy z samych danych — na przykład przewidując zamaskowane słowa lub dopasowując dwa przekształcone widoki tego samego obrazu. Samonadzorowanie jest kluczowe w wielu nowoczesnych architekturach transformer i pipeline’ach modeli bazowych, ponieważ pozwala wykorzystywać duże zbiory tekstu, obrazów, dźwięku lub wideo bez konieczności ręcznego etykietowania każdego przykładu.
Uczenie ze wzmocnieniem
W uczeniu ze wzmocnieniem agent podejmuje działania w środowisku i otrzymuje nagrody lub koszty. Celem jest nauczenie polityki, która maksymalizuje oczekiwaną skumulowaną nagrodę. Różni się to od uczenia nadzorowanego, ponieważ prawidłowa akcja nie jest podawana dla każdego stanu, a podjęta akcja może wpływać na to, jakie dane agent napotka później.
Trening, walidacja i uogólnianie
Model, który dobrze radzi sobie na przykładach treningowych, może nadal zawieść na nowych danych. Ten błąd znany jest jako przeuczenie. Zespoły ograniczają go poprzez odpowiednią pojemność modelu, regularizację, walidację krzyżową, augmentację danych, zapobieganie wyciekom oraz naprawdę niezależny zestaw testowy.
Nie istnieje jedna uniwersalna metryka dla każdego zadania ML. Klasyfikacja może wymagać precyzji, czułości, miary F1, kalibracji lub miary ważonej kosztami zamiast surowej dokładności. Regresja może używać średniego błędu bezwzględnego, pierwiastka średniego kwadratowego błędu lub straty specyficznej dla danej dziedziny. Klasteryzacja wymaga różnych form wewnętrznej lub zewnętrznie zwalidowanej oceny. Metryka powinna odzwierciedlać, co oznacza błąd dla użytkownika lub organizacji.
Algorytmy uczenia maszynowego są narzędziami, nie gwarancjami
Algorytm niesie ze sobą pewne założenia. Modele liniowe zakładają określoną formę zależności. K‑najbliższych sąsiadów zakłada, że wybrana odległość odzwierciedla znaczącą podobność. Naiwny Bayes zakłada, że cechy są warunkowo niezależne względem klasy. Drzewa decyzyjne dzielą przestrzeń cech przy użyciu wyuczonych reguł podziału; ich liście zawierają prognozy oparte na grupach obserwacji treningowych, a niekoniecznie na pojedynczych obserwacjach.
Wybór modelu zależy więc od wielkości danych, typów cech, wymagań dotyczących opóźnień, potrzeb interpretowalności oraz kosztów błędów. Prostszym modelem może przewyższyć większy model, gdy dane są ograniczone lub ograniczenia operacyjne sprzyjają szybkości i przejrzystości.
Gdzie stosowane jest uczenie maszynowe
ML wspiera ranking wyszukiwania, rekomendacje, prognozowanie, wykrywanie anomalii, tłumaczenie, rozpoznawanie mowy, widzenie komputerowe, predykcyjną konserwację, wykrywanie oszustw oraz analizę naukową. Te same techniki mogą także wzmacniać historyczne uprzedzenia, ujawniać wrażliwe informacje lub zachowywać się nieprzewidywalnie przy zmianie rozkładu. Odpowiedzialne wdrożenie wymaga dokumentacji, nadzoru ludzkiego tam, gdzie to właściwe, testów bezpieczeństwa i ciągłego monitorowania.
Od definicji problemu do ważnego eksperymentu uczenia maszynowego
Projekt uczenia maszynowego powinien zaczynać się od decyzji i mierzalnego wyniku, a nie od algorytmu. Zdefiniuj jednostkę prognozy, cel, czas obserwacji, moment podjęcia decyzji, dostępne cechy oraz koszt każdego błędu. Na przykład w modelu churn użycie zdarzeń zarejestrowanych po anulowaniu spowodowałoby wyciek odpowiedzi. Ustal prostą regułę lub statystyczną bazę, a następnie podziel dane według czasu, klienta, lokalizacji lub innej granicy odzwierciedlającej wdrożenie. Losowe podziały wierszy mogą umieścić prawie identyczne obserwacje w zestawach treningowym i testowym, co daje mylący wynik.
Inżynieria cech przekształca surowe rekordy w reprezentacje, które model może wykorzystać, ale każda cecha wymaga pochodzenia i gwarancji dostępności. Normalizację, słownik, imputację i redukcję wymiarowości dopasowuj wyłącznie na danych treningowych, a następnie zastosuj wyuczoną transformację do danych walidacyjnych i testowych. Walidacja krzyżowa szacuje zmienność pomiędzy próbkami; ostateczny nieużywany zestaw testowy wspiera decyzję o wydaniu. Wybierz metryki w zależności od konsekwencji: precyzję i czułość przy nierównych błędach klasyfikacji, kalibrację, gdy prawdopodobieństwa sterują działaniem, oraz miary ważone kosztami lub użytecznością, gdy błędy mają różne skutki operacyjne.
Wdrożenie, monitorowanie i odpowiedzialna eksploatacja
Wnioskowanie w produkcji powtarza pełną transformację z czasu treningu i zwraca prognozę w ramach ograniczeń opóźnień, przepustowości i dostępności. Zapakuj przetwarzanie wstępne razem z modelem, zwaliduj schematy wejść, wersjonuj artefakty i porównaj wyniki między implementacjami offline a serwisowymi. Wybierz próg, uwzględniając pojemność operacyjną i kompromis błędów, zamiast domyślnego 0,5. Wdrażaj poprzez ocenę w cieniu, ograniczoną kohortę lub eksperyment z metrykami ochronnymi. Zachowaj deterministyczny fallback oraz ścieżkę wycofania w przypadku awarii zależności lub nieakceptowalnego zachowania.
Monitoruj jakość danych wejściowych, dryf cech, rozkład prognoz, kalibrację, wyniki podgrup, opóźnienia, koszty oraz potwierdzone etykiety, gdy w końcu się pojawią. Dryf jest sygnałem do zbadania, a nie automatycznym dowodem, że ponowne treningi pomogą. Ponowne trenowanie wymaga przeglądu danych, powtarzalnych testów, zatwierdzenia i porównania z aktualnym modelem‑zwycięzcą. Dokumentuj zamierzone i niewłaściwe zastosowania, prawa do danych, prywatność, bezpieczeństwo, możliwość interwencji człowieka oraz odwołania, gdy osoby są dotknięte. Uczenie maszynowe jest utrzymywanym systemem decyzyjnym; plik modelu jest tylko jednym wymiennym komponentem.
Przykładowe zastosowanie: przewidywanie awarii sprzętu
Producent definiuje jedną prognozę na maszynę‑dzień: czy zweryfikowana awaria wystąpi w ciągu siedmiu dni, używając wyłącznie telemetrii dostępnej na początku tego dnia. Dzieli dane według maszyny i czasu, porównuje z regułami opartymi na wieku i progach, dopasowuje przetwarzanie wstępne na danych treningowych i ocenia przypomnienie zdarzeń, fałszywe alarmy, czas ostrzeżenia, kalibrację oraz pojemność konserwacji. Wymiana czujników i planowane wyłączenia są modelowane jako kontekst operacyjny, a nie traktowane jako zwykłe obserwacje.
Model najpierw działa w trybie cienia. Alarmy pokazują przyczyniającą się telemetrię i niepewność, ale utrzymujący decydują, czy przeprowadzić inspekcję. Wyniki i potwierdzone przyczyny stają się zarządzanymi etykietami; brak zlecenia pracy nie jest przyjmowany jako brak awarii. Etapowe wdrożenie wykorzystuje limity alarmów i ręczny fallback, podczas gdy monitorowanie śledzi stan czujników, dryf wejść, zweryfikowaną precyzję, przestoje i niepotrzebną konserwację. Ponowne trenowanie odbywa się dopiero po przeglądzie danych i progów, który wykazuje prawdopodobną poprawę względem obecnego systemu wdrożonego.
Dowody wdrożeniowe i gotowość operacyjna
Decyzja o produkcji wymaga więcej niż udanej demonstracji. Zdefiniuj docelowych użytkowników, środowisko operacyjne, wejścia, wyjścia, zależności, właściciela oraz konsekwencje każdego istotnego błędu. Ustal powtarzalną bazę odniesienia i wersjonowany zestaw ewaluacyjny przed dostrojeniem. Testuj typowe przypadki, warunki brzegowe, niepoprawne lub brakujące wejścia, zmianę rozkładu, awarię zależności, niewłaściwe użycie oraz grupy lub środowiska najprawdopodobniej niedostatecznie obsługiwane. Mierz jakość zadania wraz z kalibracją lub niepewnością, opóźnieniem, przepustowością, kosztami zasobów, dostępnością, prywatnością i bezpieczeństwem. Zarejestruj każdą transformację i próg, aby niezależny recenzent mógł odtworzyć wynik i odróżnić dowody od atrakcyjnego prototypu.
Przed uruchomieniem przydziel odpowiedzialność za wydanie, wyjątki, zmiany, wycofanie i wycofanie systemu. Użyj etapowego wdrożenia, zachowaj bezpieczny fallback i zweryfikuj monitorowanie poprzez celowo wprowadzone awarie. Telemetria operacyjna powinna ujawniać jakość wejść, zachowanie wyjść, wersję modelu lub reguły, stan zależności, interwencje ludzkie oraz potwierdzone wyniki, nie zbierając zbędnych wrażliwych danych. Zdefiniuj progi alarmów i właściciela reakcji, a następnie przeglądaj dowody z rzeczywistego świata po wdrożeniu, zamiast zakładać, że wydajność offline będzie się utrzymywać. Przeprowadzaj ponowną ocenę, gdy zmieniają się źródła danych, użytkownicy, modele, dostawcy, polityki, sprzęt lub cele. Utrzymany system wymaga także udokumentowanego odzyskiwania, nauki z incydentów, procedur usuwania i przechowywania oraz wyraźnego punktu, w którym powinien zostać wyłączony lub zastąpiony.
Podstawowe źródła












