
Podstawy AI
Czym jest uczenie się przy niewielkiej liczbie przykładów?

 Dodaj Unite.AI do preferowanych źródeł w Google
Uczenie przy niewielkiej liczbie przykładów bada, w jaki sposób model może dostosować się do nowego zadania lub klasy, mając do dyspozycji tylko niewielką liczbę oznakowanych przykładów. W klasycznych benchmarkach odcinek dostarcza zestaw wsparcia — na przykład pięć klas z jednym lub pięcioma przykładami na klasę — i prosi model o sklasyfikowanie nieznanych zapytań.
Termin ten jest także używany w kontekście uczenia w kontekście (in‑context learning), gdzie wstępnie wytrenowany model językowy otrzymuje kilka demonstracji w swoim promptcie bez aktualizacji parametrów. Te ustawienia mają wspólny cel niskiej liczby przykładów, ale wykorzystują różne mechanizmy adaptacji i wymagają odmiennych projektów ewaluacji.
Kluczowe wnioski
- „N‑way K‑shot” opisuje N klas i K oznakowanych przykładów wsparcia na klasę.
- Metody oparte na uczeniu metrycznym porównują zapytania z wyuczonymi reprezentacjami przykładów wsparcia.
- Meta‑uczenie optymalizuje w oparciu o wiele zadań, tak aby nowe zadanie można było nauczyć się szybko.
- Mała liczba przykładów potęguje błędy etykiet, wycieki, niejednoznaczność klas i niepewność, dlatego ważne są solidne baseline’y i raportowanie pewności.
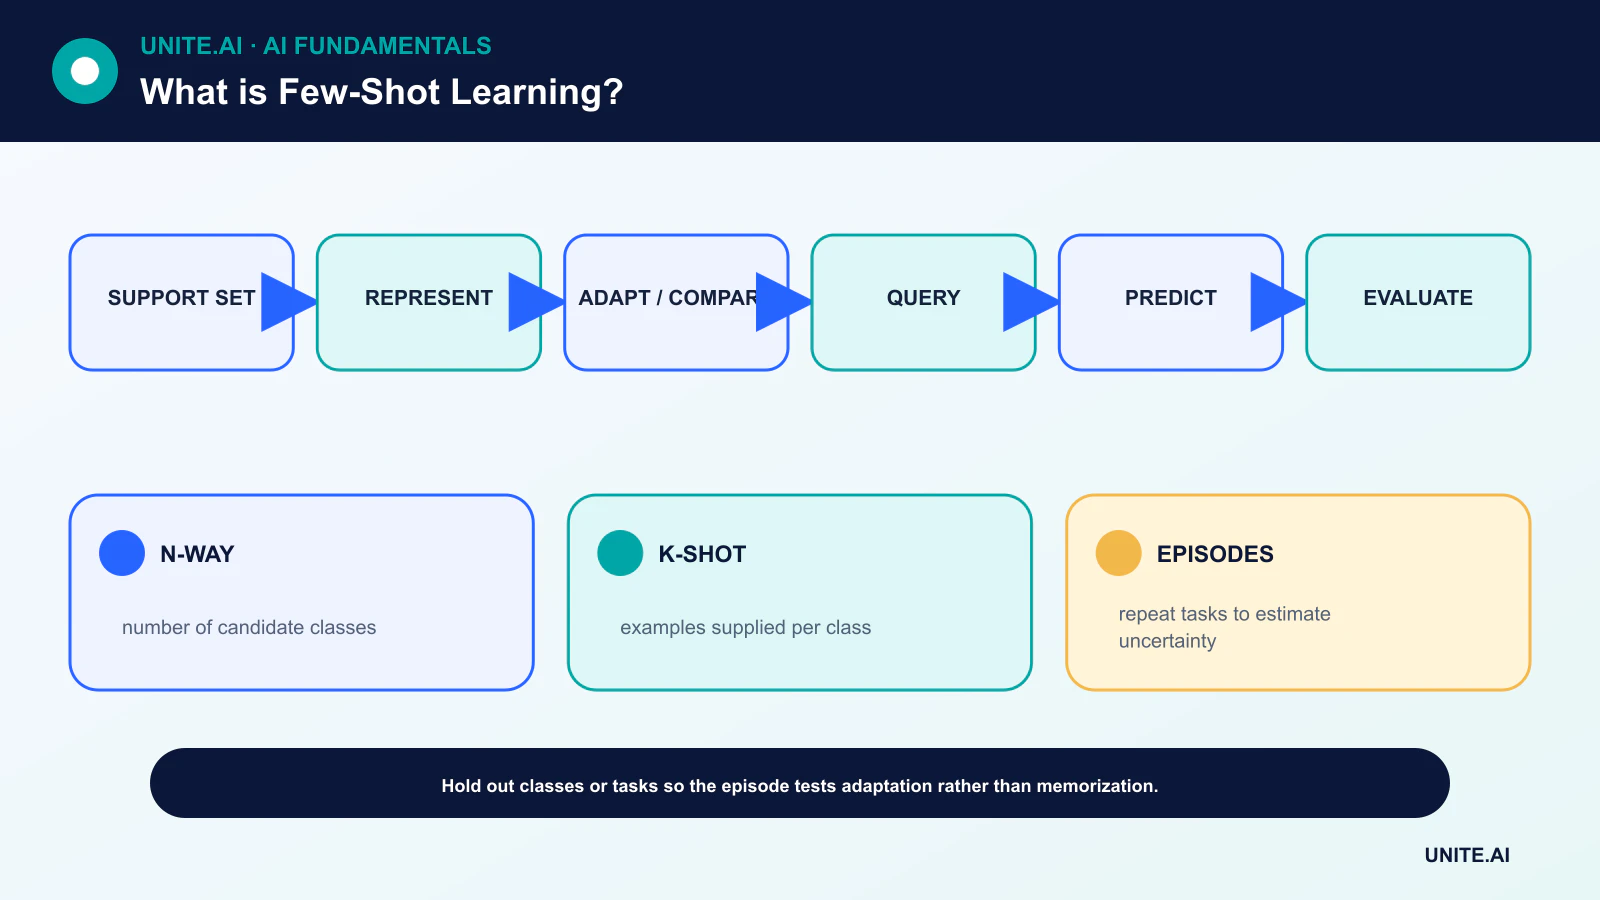
Odcinki, zestawy wsparcia i zestawy zapytań
Odcinek few‑shot oddziela mały oznakowany zestaw wsparcia od zestawu zapytań używanego do ewaluacji. Podczas meta‑treningu model widzi wiele takich odcinków. Silna ewaluacja wyłącza całe klasy, zadania lub domeny, tak aby testowy odcinek mierzył adaptację, a nie zapamiętywanie.
Raportuj rozkłady dokładności w wielu odcinkach, a nie jedynie jedną wygodną próbkę. Porównuj z prostymi baseline’ami najbliższego sąsiada i liniowymi klasyfikatorami; zaawansowana metoda, która nie przewyższa dobrze wytrenowanej reprezentacji plus podstawowego klasyfikatora, może nie uzasadniać swojej złożoności.
Uczenie metryczne i prototypy
Sieci dopasowujące (matching networks) i podobne metody osadzają przykłady wsparcia i zapytań w przestrzeni, w której pobliskie wektory powinny mieć tę samą etykietę. Sieci prototypowe (prototypical networks) średnią osadzenia wsparcia dla każdej klasy i klasyfikują zapytanie według odległości od tych prototypów klas.
Łączy to uczenie few‑shot z jakością reprezentacji. Wstępnie wytrenowany model głębokiego uczenia może już dobrze organizować istotne cechy, podczas gdy niepasująca reprezentacja może sprawić, że każda odległość będzie myląca.
Meta‑uczenie oparte na optymalizacji
Model‑Agnostic Meta‑Learning (MAML) poszukuje parametrów, które mogą się dostosować przy niewielkiej liczbie kroków gradientowych. Inne metody uczą optymalizator, inicjalizację lub regułę aktualizacji parametrów. Pętla zewnętrzna ocenia wydajność po adaptacji w różnych zadaniach.
Meta‑uczenie zakłada, że użyteczna struktura jest współdzielona między zadaniami treningowymi a docelowymi. Gdy rozkład docelowy różni się wyraźnie, szybka adaptacja może zawieść. Walidacja powinna zmieniać liczbę przykładów, klasy, domeny i trudność zadania, zamiast traktować jeden benchmark jako uniwersalny.
Transfer learning i strategie na poziomie danych
Transfer learning jest często najsilniejszym praktycznym punktem wyjścia: zamroź wstępnie wytrenowany enkoder, wytrenuj małą głowicę, a następnie dopasuj selektywnie, jeśli dostępna jest wystarczająca ilość danych. Augmentacja danych może wprowadzać niezmienniki, ale nerealistyczne przykłady syntetyczne mogą nasilać uprzedzenia lub tworzyć skróty.
Uczenie aktywne może priorytetyzować, które przykłady oznaczyć, podczas gdy uczenie półnadzorowane może wykorzystywać dodatkowe nieoznakowane dane. Są to komplementarne strategie, a nie synonimy uczenia few‑shot.
Promptowanie few‑shot różni się
Transformator może wywnioskować wzorzec z demonstracji umieszczonych w jego kontekście. Nie wymaga trwałej aktualizacji parametrów. Kolejność, sformułowanie i równowaga etykiet mogą istotnie zmienić wynik, a przykłady mogą zajmować dużą część okna kontekstowego.
Używaj reprezentatywnego zestawu ewaluacyjnego, wersjonuj każdy prompt i demonstrację oraz testuj alternatywy zero‑shot, few‑shot i fine‑tuned. Mały zestaw wsparcia nie wspiera silnych twierdzeń populacyjnych, szczególnie w przypadkach rzadkich lub krytycznych pod względem bezpieczeństwa.
Paradygmaty uczenia few‑shot i konstrukcja zadań
Uczenie few‑shot dąży do wykonania zadania przy bardzo małej liczbie oznakowanych przykładów. W metodach opartych na metryce enkoder mapuje przykłady do przestrzeni, w której najbliższe prototypy lub sąsiedzi reprezentują klasy. Meta‑uczenie oparte na optymalizacji trenuje inicjalizację lub regułę aktualizacji dla szybkiej adaptacji. Transfer learning dopasowuje wstępnie wytrenowany model na małym zestawie docelowym. Uczenie w kontekście dostarcza przykłady w promptcie bez aktualizacji wag. Mechanizmy te różnią się, więc twierdzenia powinny precyzować, czy parametry się zmieniają, jakie wcześniejsze treningi miały miejsce i jak wybierane są przykłady.
Ewaluacja powinna oddzielać klasy treningowe od testowych, zadania, podmioty lub domeny zgodnie z deklarowaną generalizacją. Odcinek N‑way K‑shot zawiera N klas i K przykładów wsparcia na klasę, plus przykłady zapytań do oceny. Powtarzane odcinki szacują wariancję wynikającą z wyboru wsparcia. W przypadku promptowania kolejność przykładów, sformułowanie etykiet, format i podobieństwo demonstracji mogą istotnie zmienić wyniki. Porównuj z baseline’ami zero‑shot, najbliższego sąsiada, liniowego sondowania i tradycyjnego fine‑tuning przy użyciu tej samej reprezentacji i budżetu danych.
Jakość danych, niepewność i negatywny transfer
Przy niewielkiej liczbie przykładów błędnie oznakowane lub nietypowe przypadki mają nieproporcjonalny wpływ. Zdefiniuj zasady anotacji, sprawdź każdy element wsparcia i zachowaj możliwość wyniku „nieznany” lub „odmowa”. Augmentacja danych i przykłady syntetyczne mogą pomóc jedynie wtedy, gdy zachowują zadanie i wprowadzają realistyczną zmienność. Wstępnie wytrenowany model może przenosić skróty lub uprzedzenia ze swojej domeny źródłowej. Testuj przypadki spoza domeny, rzadkie grupy i wrażliwość na usunięcie jednego przykładu wsparcia. Raportuj przedziały ufności w całych zadaniach i losowych seedach, a nie jedynie jedną korzystną wersję promptu.
Uczenie aktywne może prosić o etykiety w informatywnych przypadkach, podczas gdy metody półnadzorowane używają nieoznakowanych danych pod dodatkowymi założeniami. Wyszukiwanie może dynamicznie wybierać odpowiednie demonstracje, ale musi unikać wycieków etykiet testowych. Adaptacja może szybko przeuczyć się, więc ogranicz aktualizacje, stosuj regularizację i waliduj na odrębnych przykładach. W zadaniach o wysokim ryzyku kilka etykiet rzadko uzasadnia autonomiczne decyzje; używaj modelu do priorytetyzacji lub wspomagania przeglądu, dopóki nie będzie wystarczającej ilości dowodów na wynik.
Operacje produkcyjne
Wersjonuj bazowy model, osadzenia lub szablon promptu, demonstracje, schemat etykiet i parametry adaptacji. Chroń przykłady, ponieważ prompt lub gradienty mogą ujawniać wrażliwe rekordy. Monitoruj wydajność w miarę zmian klas i języka oraz odświeżaj przykłady wsparcia poprzez kontrolowany przegląd, a nie automatyczne samoodznaczanie. Uczenie few‑shot zmniejsza wymóg oznakowanych danych docelowych, wykorzystując wcześniejszą strukturę; nie eliminuje potrzeby reprezentatywnej ewaluacji, starannej definicji zadania, ekspertyzy domenowej ani bezpiecznego planu awaryjnego, gdy nowe zadanie wykracza poza tę wcześniejszą wiedzę.
Przykład praktyczny: klasyfikacja few‑shot dla nowego produktu
Zespół wsparcia potrzebuje etykiet routingu dla produktu, mając jedynie pięć zweryfikowanych przykładów na problem. Porównuje najbliższe prototypy w wstępnie wytrenowanym osadzeniu, liniową głowicę, efektywne pod względem parametrów fine‑tuning oraz promptowanie w kontekście. Rodziny produktów, klienci i późniejsze wiadomości są wyłączone z meta‑treningu i wyboru modelu. Powtarzane losowanie zestawu wsparcia raportuje przywołanie klasy, kalibrację, wariancję i wrażliwość na jedną błędnie oznakowaną demonstrację.
Wiadomości o niskiej pewności i bez wsparcia kierowane są do ogólnego wsparcia, a recenzenci korygują etykiety poprzez kontrolowaną kolejkę. Przykłady są anonimowe, wersjonowane i nigdy nie wybierane z końcowego zestawu testowego. Monitorowanie śledzi nowy słownik, wskaźniki klas, korekty i rozbieżności. Gdy zgromadzi się wystarczająca liczba etykiet, system few‑shot porównywany jest z tradycyjnym nadzorowanym treningiem. Szybka konfiguracja jest przydatna, ale nie uzasadnia automatyzacji, jeśli wydajność pozostaje niestabilna lub nowy produkt znacząco różni się od wcześniejszych rodzin zadań.
Dowody wdrożeniowe i gotowość operacyjna
Decyzja produkcyjna wymaga więcej niż udany pokaz. Zdefiniuj docelowych użytkowników, środowisko operacyjne, wejścia, wyjścia, zależności, właściciela oraz konsekwencje każdego istotnego błędu. Ustal odtwarzalny baseline i wersjonowany zestaw ewaluacyjny przed strojeniem. Testuj typowe przypadki, warunki brzegowe, niepoprawne lub brakujące wejścia, zmianę rozkładu, awarię zależności, niewłaściwe użycie oraz grupy lub środowiska najczęściej niedoszacowane. Mierz jakość zadania wraz z kalibracją lub niepewnością, opóźnieniem, przepustowością, kosztami zasobów, dostępnością, prywatnością i bezpieczeństwem. Zarejestruj każdą transformację i próg, aby niezależny recenzent mógł odtworzyć wynik i odróżnić dowody od atrakcyjnego prototypu.
Przed uruchomieniem przydziel odpowiedzialność za wydanie, wyjątki, zmiany, wycofanie i wycofanie. Stosuj stopniowe wdrażanie, zachowaj bezpieczną alternatywę i weryfikuj monitorowanie poprzez celowo wprowadzone awarie. Telemetria operacyjna powinna ujawniać jakość wejść, zachowanie wyjść, wersję modelu lub reguły, stan zależności, interwencje ludzkie oraz potwierdzone wyniki, bez gromadzenia niepotrzebnych wrażliwych danych. Określ progi alarmowe i właściciela reakcji, a następnie po wdrożeniu przeglądaj dowody z rzeczywistego świata, zamiast zakładać, że offline‑owa wydajność utrzyma się. Ponownie oceniaj, gdy zmienią się źródła danych, użytkownicy, modele, dostawcy, polityki, sprzęt lub cele. Utrzymany system wymaga także udokumentowanych procedur przywracania, uczenia się z incydentów, usuwania i przechowywania danych oraz jasnego momentu, w którym powinien zostać wyłączony lub zastąpiony.
Najczęściej zadawane pytania
Czy uczenie one‑shot jest tym samym co uczenie few‑shot?
Uczenie one‑shot to szczególny przypadek, w którym na każdą klasę lub zadanie przypada jeden oznakowany przykład wsparcia. Uczenie zero‑shot nie wykorzystuje żadnych oznakowanych przykładów docelowych.
Czy uczenie few‑shot eliminuje potrzebę danych?
Nie. Przesuwa zależność w stronę danych wstępnego treningu, powiązanych zadań, reprezentacji i założeń. Etykiety docelowe są nieliczne; historia uczenia zazwyczaj jest obszerna.
Podstawowe odniesienia












