Podstawy AI
Czym jest uczenie głębokie?

 Dodaj Unite.AI do preferowanych źródeł w Google
Uczenie głębokie jest rodziną metod uczenia maszynowego, które wykorzystują sieci neuronowe z wieloma warstwami przetwarzania do uczenia się przydatnych reprezentacji danych. Modele te napędzają wiele współczesnych systemów do przetwarzania języka, obrazów, dźwięku, rekomendacji, prognoz naukowych oraz generatywnej sztucznej inteligencji.
Słowo deep odnosi się do liczby przekształceń pomiędzy wejściem a wyjściem, a nie do maszyny posiadającej głębsze zrozumienie. Model głęboki uczy się zależności liczbowych przydatnych do realizacji swojego celu treningowego, a jego wydajność nadal musi być testowana na nowych danych.
Kluczowe wnioski
- Uczenie głębokie jest podzbiorem uczenia maszynowego.
- Warstwy przekształcają tensory przy użyciu wyuczonych parametrów, nieliniowych funkcji aktywacji, normalizacji i innych operacji.
- Propagacja wsteczna oblicza gradienty; optymalizator wykorzystuje te gradienty do aktualizacji uczonych parametrów, w tym wag i biasów.
- Sieci CNN, sieci rekurencyjne, transformatory, autoenkodery i modele dyfuzyjne mają różne struktury i zalety.
Jak uczy się głęboka sieć neuronowa
Sieć neuronowa otrzymuje dane jako tensory, czyli wielowymiarowe tablice liczb. Tensor obrazu może kodować kanały pikseli, podczas gdy model językowy używa wektorów reprezentujących tokeny. Każda warstwa wykonuje różniczkowalne przekształcenie i przekazuje wynik do kolejnej warstwy.
W podstawowej warstwie gęstej model oblicza ważoną sumę swoich wejść, dodaje uczony bias, a następnie stosuje funkcję aktywacji:
output = activation(Wx + b)
Funkcja aktywacji wprowadza nieliniowość. Bez niej, układanie zwykłych warstw liniowych nadal reprezentowałoby jedynie przekształcenie liniowe. ReLU i jego warianty są powszechne w warstwach ukrytych, podczas gdy aktywacje wyjściowe zależą od zadania.
Trening zazwyczaj obejmuje cztery kroki:
- Przejście w przód generuje prognozy.
- Funkcja straty mierzy, jak prognozy różnią się od celu.
- Propagacja wsteczna stosuje regułę łańcuchową do obliczenia gradientu funkcji straty względem każdego uczonego parametru.
- Optymalizator, taki jak stochastyczny spadek gradientu lub AdamW, aktualizuje parametry.
Powtarzanie tych kroków na wielu partiach może ulepszyć model, ale niższa strata treningowa nie gwarantuje niezawodnego zachowania w rzeczywistych warunkach. Walidacja, regularizacja, reprezentatywne dane i monitorowanie pozostają niezbędne.
Główne architektury uczenia głębokiego
Wielowarstwowe perceptrony
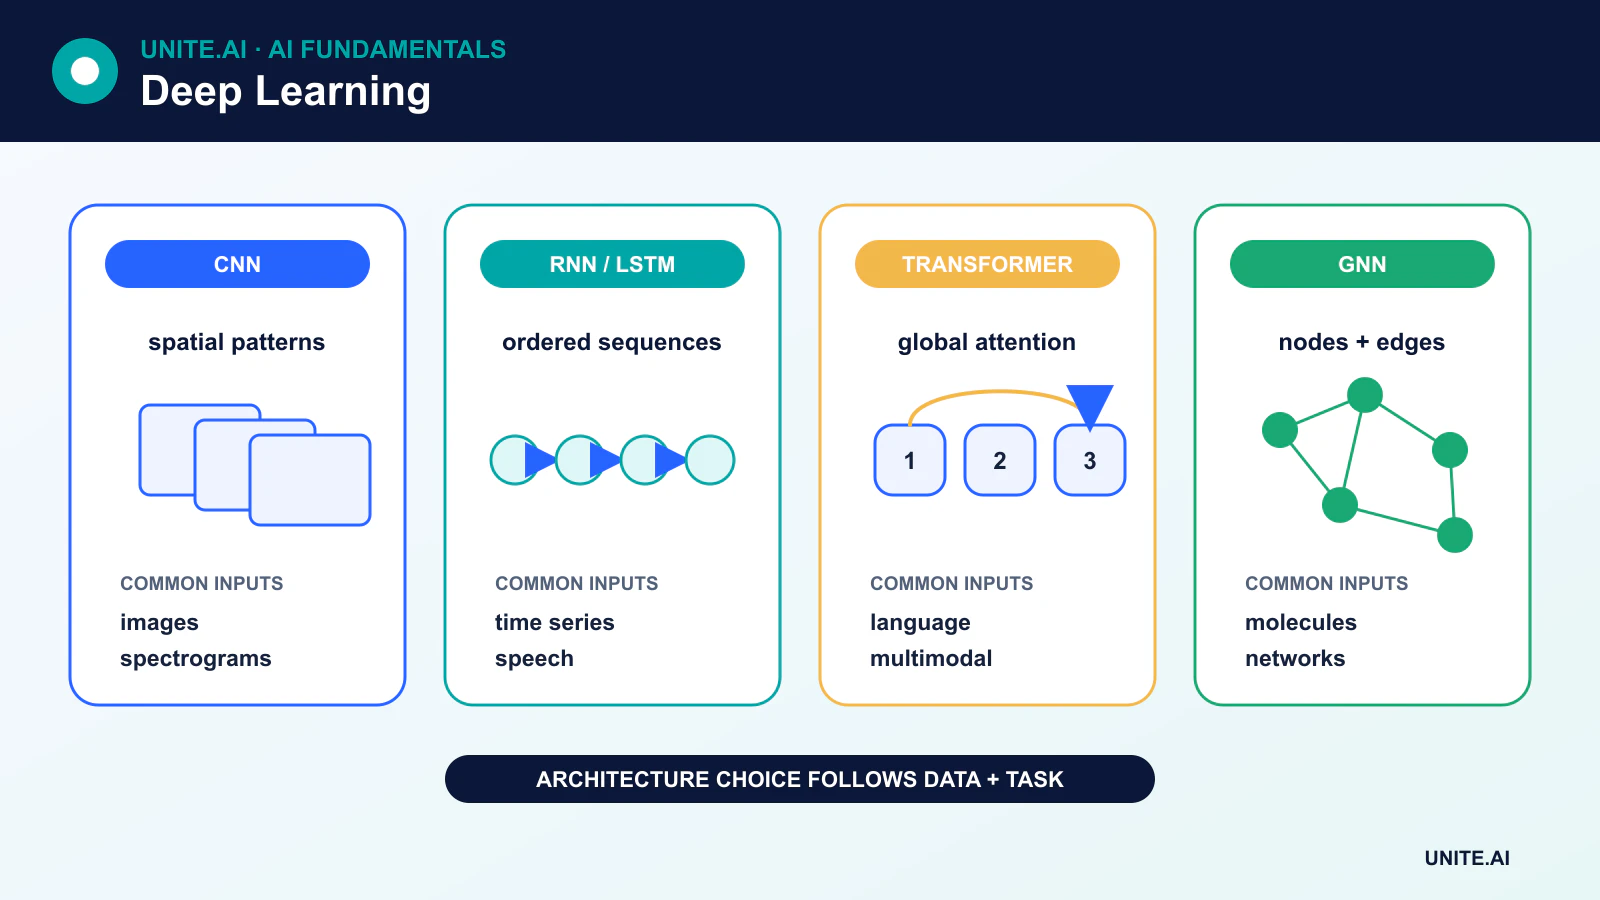
Wielowarstwowy perceptron (MLP) wykorzystuje w pełni połączone warstwy, w których każdy neuron wyjściowy zależy od wszystkich wejść z poprzedniej warstwy. MLP są przydatne do cech tabelarycznych oraz jako komponenty w większych systemach, ale nie zawierają założeń dotyczących lokalności obrazu ani kolejności sekwencji.
Splotowe sieci neuronowe
Splotowe sieci neuronowe (CNN) stosują wyuczone filtry na lokalnych obszarach. Współdzielenie wag czyni je wydajnymi dla siatek, takich jak obrazy i spektrogramy. CNN nadal są istotne w zadaniach wizji i wdrożeniach na krawędzi, chociaż transformatory wizji i modele hybrydowe są również szeroko używane.
Sieci rekurencyjne, LSTM i GRU
Rekurencyjne sieci neuronowe (RNN) aktualizują ukryty stan w trakcie przetwarzania sekwencji. LSTM i jednostki bramkowane (GRU) pomagają zachować informacje i redukują problem znikającego gradientu, który utrudnia podstawowym RNN radzenie sobie z długimi zależnościami. Nie eliminują one wszystkich ograniczeń długiego kontekstu, ale pozostają przydatne do strumieniowych sygnałów, danych szeregów czasowych i kompaktowych modeli sekwencyjnych.
Transformatory
Transformatory wykorzystują mechanizm uwagi (attention) do modelowania zależności pomiędzy elementami sekwencji lub zbioru. Ich zdolność do równoległego przetwarzania wielu pozycji pomogła im zastąpić rekurencję w większości dużych systemów językowych, a warianty transformerów teraz przetwarzają obrazy, dźwięk, wideo, białka i dane multimodalne.
Autoenkodery i modele generatywne
Autoenkoder kompresuje wejście do reprezentacji i odtwarza wejście z tej reprezentacji. Tworzy to samonadzorowany cel rekonstrukcji; nie przekształca automatycznie danych nieoznaczonych w przykłady oznaczone.
Generatywne sieci przeciwstawne (GAN) trenują generator i dyskryminator w rywalizacji. Modele dyfuzyjne uczą się odwracać stopniowy proces zaszumiania. Autoregresywne transformatory generują po jednym tokenie lub jednostce. Podejścia te mają różne dynamiki treningu, możliwości kontroli i wymagania obliczeniowe.
Dlaczego głębokość pomaga — i dlaczego architektura ma znaczenie
Wiele warstw pozwala modelowi łączyć prostsze przekształcenia w bardziej złożone. W wizji niektóre wyuczone cechy mogą przechodzić od lokalnych tekstur do wzorców specyficznych dla zadania. W języku warstwy uwagi budują reprezentacje tokenów zależne od kontekstu. Opisy te są przydatnymi intuicjami, a nie sztywnymi regułami określającymi, co każda warstwa musi się nauczyć.
Nowoczesne sieci korzystają również z połączeń rezydualnych, normalizacji, starannej inicjalizacji, regularizacji i zoptymalizowanego sprzętu. Proste dodanie warstw lub parametrów może utrudnić trening modelu, spowolnić go lub zwiększyć podatność na przeuczenie. Skala modelu pomaga tylko wtedy, gdy dane, cel, optymalizacja i warunki wdrożenia to umożliwiają.
Trening kontra wnioskowanie
Trening dostosowuje parametry i jest zazwyczaj etapem intensywnym obliczeniowo. Inference (wnioskowanie) uruchamia wytrenowany model, aby wygenerować wynik. Wnioskowanie może być nadal kosztowne w przypadku dużych modeli, dlatego zespoły stosują kwantyzację, destylację, batchowanie, buforowanie, rzadkość oraz specjalistyczny sprzęt, taki jak jednostki przetwarzania neuronowego.
Ograniczenia i odpowiedzialne użycie
Modele głębokie mogą dziedziczyć uprzedzenia, zapamiętywać wrażliwe informacje, zawodzić przy zmianie rozkładu danych oraz generować przekonujące, lecz nieprawidłowe wyniki. Mogą być także trudne do interpretacji i kosztowne w treningu. Ocena powinna obejmować więcej niż średnią benchmarku: zespoły potrzebują wyników na poziomie klasy lub podgrupy, odporności, kalibracji, bezpieczeństwa, opóźnień, zużycia energii oraz konsekwencji awarii.
Reprezentacje, optymalizacja i wybór architektury
Głębokie sieci uczą się kolejnych reprezentacji poprzez warstwy parametryzowane. Transformacje liniowe mieszają wejścia; nieliniowe aktywacje pozwalają sieci przybliżać złożone funkcje; normalizacja i połączenia rezydualne wspomagają optymalizację; uwaga, konwolucja, rekurencja lub operacje w przestrzeni stanów kodują różne założenia strukturalne. Głębokość zwiększa liczbę przekształceń, a nie gwarantowaną inteligencję. Architektura powinna odzwierciedlać modalność, objętość danych, opóźnienia, pamięć i niezmienniki zadania. Mniejszy model konwolucyjny może przewyższyć transformator, gdy dane są ograniczone, a lokalna struktura przestrzenna dominuje.
Trening oblicza stratę, różniczkuje ją przy pomocy propagacji wstecznej i aktualizuje parametry optymalizatorem, takim jak stochastyczny spadek gradientu lub Adam. Rozmiar batcha, współczynnik uczenia, harmonogram, inicjalizacja, regularizacja i precyzja numeryczna oddziałują ze sobą. Krzywe strat treningu i walidacji pomagają odróżnić niedouczenie, przeuczenie, niestabilność i wyciek, ale nie ustanawiają użyteczności w rzeczywistych warunkach. Należy używać niezależnych danych ewaluacyjnych, powtarzalnych uruchomień, w których wariancja ma znaczenie, testów ablatywnych oraz porównań z prostszymi bazowymi modelami. Duża liczba parametrów zwiększa także potrzebę zarządzania danymi, planowania mocy obliczeniowej i reprodukowalnej konfiguracji.
Serwowanie modeli głębokich bezpiecznie i wydajnie
Wdrożenie może korzystać z hostowanego punktu końcowego, dedykowanego akceleratora, przeglądarki, telefonu lub urządzenia wbudowanego. Eksport i kompilacja mogą łączyć operatory, kwantyzować wagi i aktywacje lub zmieniać zachowanie numeryczne, dlatego należy weryfikować wdrożony artefakt, a nie jedynie punkt kontrolny treningu. Należy mierzyć czas uruchomienia (cold start), stałe opóźnienie, przepustowość, pamięć, zużycie energii i jakość przy realistycznych rozmiarach batcha i sekwencji. Metody kompresji — przycinanie, destylacja, kwantyzacja i adaptacja niskiego rzędu — wymieniają rozmiar lub szybkość na dokładność i złożoność inżynieryjną i muszą być oceniane pod kątem wrażliwych klas i przypadków brzegowych.
Modele głębokie mogą pewnie zawodzić przy zmianie rozkładu danych, wrogim wejściu, fałszywych korelacjach i słabo reprezentowanych grupach. Należy monitorować rozkłady wejść i wyjść, wyniki zadań, kalibrację, zużycie zasobów i wersje zależności. Stosuj kontrolę dostępu, podpisane artefakty, chronione dane treningowe, testy red teaming oraz limity szybkości adekwatne do modelu zagrożeń. Wyjaśnienia takie jak mapy uwagi (saliency maps) czy wizualizacje uwagi są dowodami diagnostycznymi, a nie dowodem przyczynowości. Należy je łączyć z testami behawioralnymi, kontrfaktycznymi, przeglądem ludzkim, reakcją na incydenty oraz wyraźnymi ograniczeniami decyzji automatycznych.
Przykład praktyczny: trening detektora wad obrazu
Fabryka zbiera obrazy produktów z różnych kamer, zmian, materiałów i znanych klas defektów, a następnie dzieli je według partii produkcyjnych, aby podobne elementy nie mogły przechodzić pomiędzy podziałami. Mała konwolucyjna baza jest porównywana z wstępnie wytrenowaną głęboką siecią. Augmentacja odtwarza zwalidowane warunki oświetleniowe i wariacje punktu widzenia bez usuwania defektów. Ewaluacja raportuje wskaźnik przypomnienia (recall) dla każdego defektu, wskaźnik fałszywych odrzuceń, kalibrację, opóźnienie wnioskowania oraz odporność na rozmycie, odblaski, wymianę kamery i rzadkie kolory materiałów.
Eksportowany model oraz dokładny kod zmiany rozmiaru, koloru i normalizacji są testowane na sprzęcie linii produkcyjnej pod kątem utrzymanej przepustowości i zachowań termicznych. Przypadki o niskiej pewności są przekazywane inspektorom; niezależna reguła zatrzymuje linię w przypadku krytycznej awarii czujnika. Obrazy są przechowywane wyłącznie zgodnie z zezwoleniami, a artefakty modelu są podpisane. Monitorowanie łączy prognozy z późniejszymi wynikami inspekcji i partiami produkcyjnymi. Nowa kamera lub materiał wywołują kontrolowaną reewaluację, zamiast cichego uczenia online z niezweryfikowanymi etykietami.
Dowody wdrożeniowe i gotowość operacyjna
Decyzja produkcyjna wymaga więcej niż udanej demonstracji. Zdefiniuj docelowych użytkowników, środowisko operacyjne, wejścia, wyjścia, zależności, właściciela oraz konsekwencje każdego istotnego błędu. Ustal reprodukowalną bazę i wersjonowany zestaw ewaluacyjny przed dostrojeniem. Testuj typowe przypadki, warunki brzegowe, nieprawidłowe lub brakujące wejścia, zmianę rozkładu, awarie zależności, niewłaściwe użycie oraz grupy lub środowiska najprawdopodobniej niedostatecznie obsługiwane. Mierz jakość zadania wraz z kalibracją lub niepewnością, opóźnieniem, przepustowością, kosztami zasobów, dostępnością, prywatnością i bezpieczeństwem. Zarejestruj każde przekształcenie i próg, aby niezależny recenzent mógł odtworzyć wynik i odróżnić dowody od atrakcyjnego prototypu.
Przed uruchomieniem przydziel odpowiedzialność za wydanie, wyjątki, zmiany, wycofanie i wycofanie. Stosuj stopniowe wdrażanie, zachowaj bezpieczną alternatywę i weryfikuj monitorowanie poprzez celowo wprowadzane awarie. Telemetria operacyjna powinna ujawniać jakość wejść, zachowanie wyjść, wersję modelu lub reguły, stan zależności, interwencje ludzkie oraz potwierdzone wyniki, bez gromadzenia niepotrzebnych wrażliwych danych. Zdefiniuj progi alarmowe i osobę odpowiedzialną za reakcję, a następnie przeglądaj dowody z rzeczywistego świata po wdrożeniu, zamiast zakładać, że offline’owa wydajność będzie trwała. Przeprowadzaj ponowną ocenę, gdy zmienią się źródła danych, użytkownicy, modele, dostawcy, polityki, sprzęt lub cele. Utrzymany system wymaga także udokumentowanego odzyskiwania, nauki z incydentów, procedur usuwania i przechowywania oraz wyraźnego momentu, w którym powinien zostać wyłączony lub zastąpiony.
Podstawowe odniesienia