
Podstawy AI
Co to są RNN i LSTM w uczeniu głębokim?

 Dodaj Unite.AI do preferowanych źródeł w Google
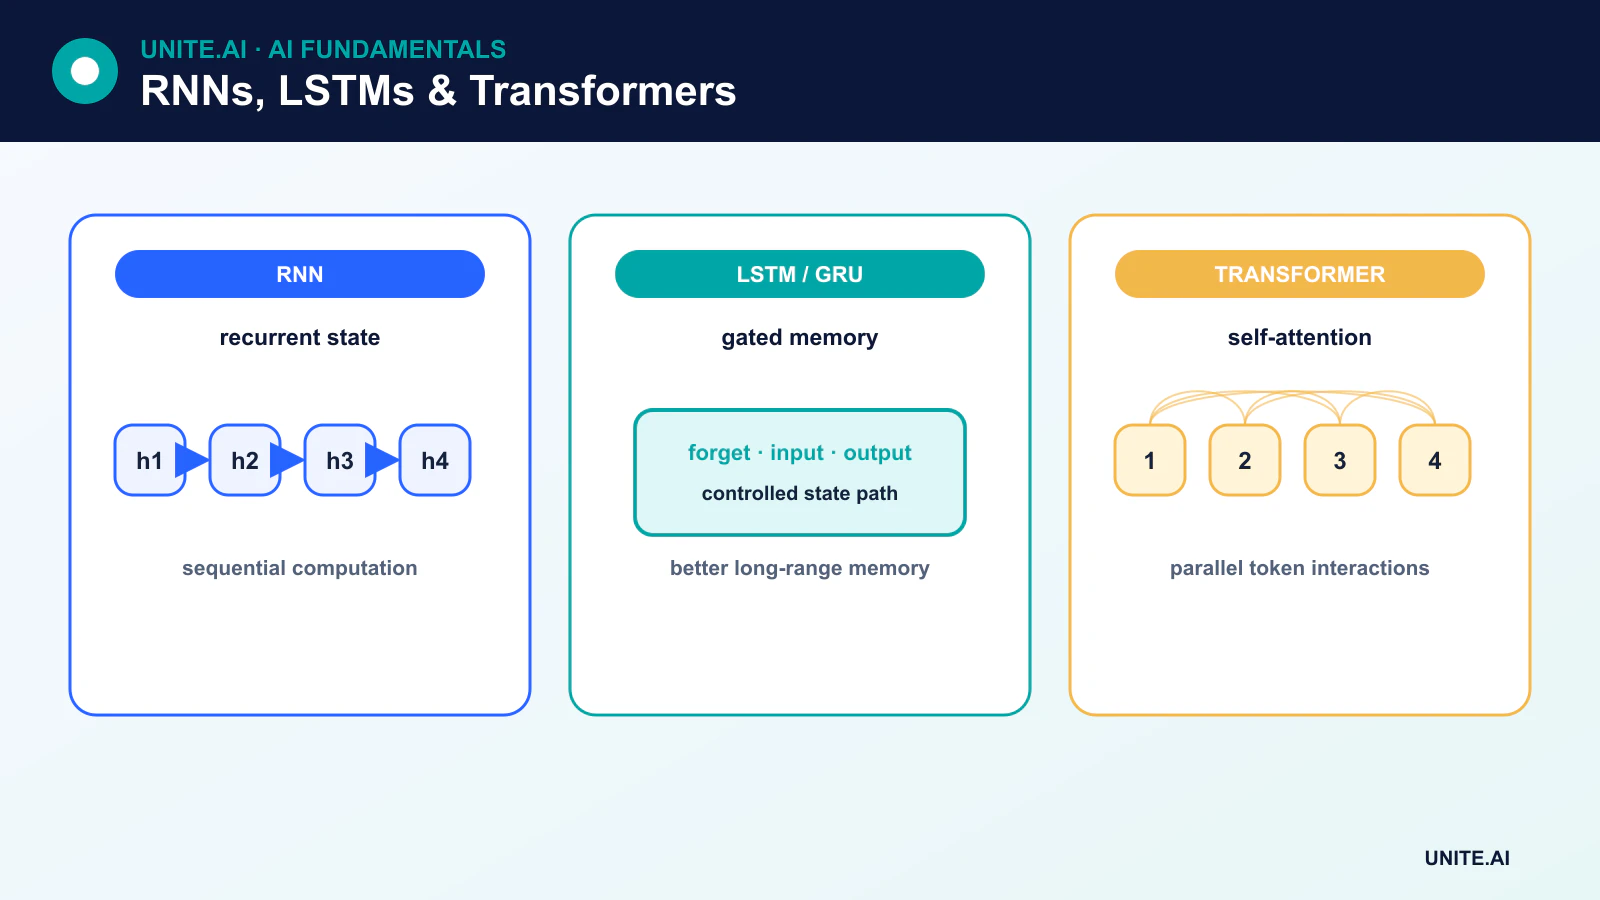
Rekurencyjne sieci neuronowe (RNN) przetwarzają sekwencje, aktualizując ukryty stan w czasie. Long short-term memory (LSTM) sieci są bramkowymi RNN zaprojektowanymi tak, aby skuteczniej zachowywać i kontrolować informacje niż podstawowa jednostka rekurencyjna.
RNN i LSTM kiedyś dominowały w wielu zadaniach językowych, ale współczesne duże chatboty opierają się głównie na transformerach. Modele rekurencyjne nadal są przydatne w strumieniowaniu, szeregach czasowych, mowie, sterowaniu i systemach o ograniczonych zasobach, gdzie istotny jest przyrostowy stan i niskie opóźnienie.
Kluczowe wnioski
- RNN ponownie używa tych samych parametrów na każdym kroku sekwencji i przenosi ukryty stan do przodu.
- Trening w czasie może powodować zanikające lub eksplodujące gradienty.
- LSTM dodaje stan komórki oraz bramki wejścia, zapomnienia i wyjścia.
- Transformatory radzą sobie z zależnościami długodystansowymi i równoległym treningiem inaczej; żadna z architektur nie jest najlepsza dla każdego wdrożenia.
Jak działa podstawowy RNN
Na kroku t prosta jednostka rekurencyjna łączy bieżące wejście xₜ z poprzednim ukrytym stanem hₜ₋₁:
hₜ = activation(Wₓxₜ + Wₕhₜ₋₁ + b)
Ukryty stan jest wyuczonym podsumowaniem używanym w następnym kroku i, w zależności od zadania, jako wyjście. Diagram „rozwinięty” rysuje jedną kopię na każdy krok czasowy, ale wszystkie kopie współdzielą parametry. Wyjście nie jest po prostu kopiowane z powrotem jako nowe surowe wejście; rekurencja przekazuje ukryty stan przez określoną transformację.
Propagacja wsteczna w czasie
RNN są trenowane przy użyciu propagacji wstecznej w czasie (BPTT). Rozwinięta sekwencja tworzy głęboki graf obliczeniowy, a propagacja wsteczna oblicza, jak strata zależy od współdzielonych parametrów rekurencyjnych.
Powtarzalne mnożenie może powodować, że gradienty maleją w kierunku zera lub rosną nieograniczenie. Zanikające gradienty uniemożliwiają uczenie długich zależności; eksplodujące gradienty powodują niestabilne aktualizacje. Przycinanie gradientów rozwiązuje problem eksplodujących gradientów, natomiast bramkowanie, inicjalizacja, normalizacja i krótsze okna treningowe mogą pomóc.
Wewnątrz komórki LSTM
LSTM utrzymuje stan komórki cₜ oprócz ukrytego stanu hₜ. Jego bramki są uczonymi, zależnymi od danych kontrolami:
- Bramka zapomnienia kontroluje, jak dużo poprzedniego stanu komórki jest zachowywane.
- Bramka wejścia kontroluje, jak dużo proponowanej informacji jest zapisywane.
- Bramka wyjścia kontroluje, jak dużo informacji z komórki przyczynia się do ukrytego stanu.
Wyjścia sigmoidalne w przedziale od zera do jednego działają jako miękkie bramki, podczas gdy kandydat przekształcony funkcją tanh dostarcza nową treść. Dodawanie ścieżki stanu komórki pomaga gradientom utrzymywać się, ale LSTM nie gwarantują nieograniczonej pamięci ani nie eliminują wszystkich problemów optymalizacyjnych.
GRU i rekurencja dwukierunkowa
Gated Recurrent Unit (GRU) łączy mechanizmy bramkowania w prostszą komórkę rekurencyjną bez oddzielnego stanu komórki w stylu LSTM. GRU mogą uczyć się szybciej i osiągać podobne wyniki w niektórych zadaniach.
Rekurencyjna sieć dwukierunkowa przetwarza pełną sekwencję w obu kierunkach i łączy stany. Może wykorzystywać kontekst przyszły przy tagowaniu lub kodowaniu, ale jest nieodpowiednia dla strumieniowania przyczynowego, gdy przyszłe wejścia nie są jeszcze dostępne.
Modele sekwencja-do-sekwencji
RNN enkoder-dekoder mapują jedną sekwencję na inną. Uwaga (attention) została wprowadzona, aby dekoder mógł odwoływać się do różnych stanów enkodera zamiast polegać na jednym stałym wektorze. Ta linia badań doprowadziła do architektury transformera, która zastąpiła rekurencję blokami opartymi na uwadze.
RNN vs transformatory
Transformatory przetwarzają pozycje treningowe równolegle i tworzą krótkie ścieżki uwagi między odległymi tokenami. RNN przetwarzają stan kolejno, ograniczając równoległość, ale oferując stałej wielkości stan rekurencyjny podczas strumieniowania. Inferencja transformera może wymagać rosnącej pamięci podręcznej klucz‑wartość, podczas gdy RNN kompresuje historię w swoim ukrytym stanie i może tracić szczegóły.
Wybór zależy od długości sekwencji, skali danych, sprzętu, opóźnienia, pamięci oraz tego, czy zadanie jest offline czy strumieniowe. Architektury hybrydowe i oparte na przestrzeni stanów oferują dodatkowe kompromisy.
Obecne zastosowania
RNN i LSTM nadal są istotne w prognozowaniu, wykrywaniu anomalii, przetwarzaniu sensorów, komponentach mowy, rozpoznawaniu pisma odręcznego, sterowaniu wbudowanym oraz modelowaniu sekwencji o niskim opóźnieniu. Nie są one domyślnym wyjaśnieniem współczesnych dużych modeli językowych ani chatbotów AI.
Rekurencja, bramki i pamięć sekwencji
Rekurencyjna sieć neuronowa przetwarza sekwencję, łącząc bieżące wejście z ukrytym stanem przenoszonym z poprzednich kroków. Wspólne wagi umożliwiają zmienną długość sekwencji, a rozwinięcie ujawnia obliczenia w czasie podczas treningu. Podstawowe RNN mogą reprezentować zależności czasowe, ale gradienty wielokrotnie mnożone w długich sekwencjach mają tendencję do zanikania lub eksplozji. Przycięta propagacja wsteczna ogranicza pamięć i obliczenia, a przycinanie gradientów kontroluje ekstremalne aktualizacje. Ukryty stan jest wyuczonym podsumowaniem, a nie wiernym przechowywaniem każdego wcześniejszego tokenu.
Sieci pamięci długotrwałej (LSTM) dodają stan komórki oraz bramki wejścia, zapomnienia i wyjścia, które regulują zapisywanie, zachowywanie i udostępnianie informacji. Bramkaowane jednostki rekurencyjne (GRU) używają prostszej struktury resetu i aktualizacji. Warianty dwukierunkowe wykorzystują kontekst przyszły i dlatego nie mogą strumieniować przyczynowo bez opóźnień. Stosowane, rezydualowe i wzbogacone o uwagę modele rekurencyjne zwiększają pojemność. Wypełnianie i maski muszą zapobiegać wpływowi sztucznych elementów sekwencji na stan lub stratę, a stan powinien być resetowany na prawdziwych granicach sekwencji, aby uniknąć wycieków między przykładami.
Trening, porównanie i obsługa stanowa
RNN i LSTM pozostają przydatne do strumieniowania, kompaktowych modeli na urządzeniach, szeregów czasowych oraz obciążeń, w których efektywny jest stan sekwencyjny. Transformatory równolegle trenują i modelują interakcje długodystansowe inaczej, ale mogą wymagać większej pamięci i pamięci podręcznej. Porównuj architektury pod kątem dokładności, opóźnienia, przepustowości, pamięci, zużycia energii i wydajności przy zmianie długości sekwencji. Ocena prognozowania przy użyciu przesuwających się podziałów czasowych, języka z metrykami uwzględniającymi sekwencję oraz wykrywania anomalii przy pomiarach na poziomie zdarzeń. Analizuj awarie po długich przerwach, zmianach reżimu, brakujących próbkach i nagłych granicach sekwencji.
Stanowiskowe wdrożenie musi powiązać ukryty stan z właściwą sesją, wygaszyć go, zaszyfrować w razie wrażliwości i zresetować po błędach lub zmianach modelu. Zdarzenia poza kolejnością lub zduplikowane mogą uszkodzić stan; należy uwzględnić znaczniki czasu, numery sekwencji i idempotencję. Monitoruj wiek stanu, długość sekwencji, brakujące dane, dryf wyjścia i opóźnienie. Kwantyzacja wymaga walidacji wrażliwej na bramki, ponieważ małe zmiany numeryczne mogą się kumulować w czasie. Pamięć RNN umożliwia kontekst, ale może także zachowywać prywatne lub przestarzałe informacje, więc retencja i kontrola użytkownika powinny być uwzględnione w projekcie.
Przykładowe zastosowanie: LSTM do strumieniowych sekwencji sensorów
Usługa wykorzystuje LSTM do prognozowania krótkoterminowego obciążenia na podstawie ostatnich pomiarów, kalendarza i pogody. Sekwencje budowane są w ścisłej kolejności czasowej; ukryty stan resetowany jest przy granicach zasilaczy, a wypełnienie maskowane. Proste sezonowe i oparte na gradientowym boostingu modele bazowe porównywane są z LSTM w przesuwających się oknach. Testy obejmują brakujące przedziały, opóźnioną pogodę, święta, awarie oraz długości sekwencji przekraczające typowy trening.
Usługa strumieniowa powiązuje stan z jednym zasilaczem, odrzuca nieuporządkowane duplikaty i wygasza stan po długich przerwach lub aktualizacjach modelu. Bezpieczna prognoza statystyczna zastępuje wyjście, gdy czujniki lub stan są nieprawidłowe. Kwantyzowana inferencja jest sprawdzana na długich sekwencjach pod kątem skumulowanego dryfu. Monitorowanie śledzi wiek stanu, brak danych, opóźnienie, bias i błąd interwału. Model jest ponownie trenowany tylko po zmianach sieci i przegląd wyników wykazuje, że wyuczone zależności czasowe nie generalizują już.
Dowody implementacyjne i gotowość operacyjna
Decyzja produkcyjna wymaga więcej niż udanej demonstracji. Zdefiniuj docelowych użytkowników, środowisko operacyjne, wejścia, wyjścia, zależności, właściciela oraz konsekwencje każdego istotnego błędu. Ustal powtarzalną bazę odniesienia i wersjonowany zestaw ewaluacyjny przed dostrojeniem. Testuj typowe przypadki, warunki brzegowe, nieprawidłowe lub brakujące wejścia, przesunięcie rozkładu, awarie zależności, niewłaściwe użycie oraz grupy lub środowiska najprawdopodobniej niedoszacowane. Mierz jakość zadania wraz z kalibracją lub niepewnością, opóźnieniem, przepustowością, kosztami zasobów, dostępnością, prywatnością i bezpieczeństwem. Zapisuj każdą transformację i próg, aby niezależny recenzent mógł odtworzyć wynik i odróżnić dowody od atrakcyjnego prototypu.
Przed uruchomieniem przydziel odpowiedzialność za wydanie, wyjątki, zmiany, przywracanie i wycofywanie. Stosuj stopniowe wdrażanie, zachowaj bezpieczną alternatywę i weryfikuj monitorowanie przy celowo wprowadzonych awariach. Telemetria operacyjna powinna ujawniać jakość wejść, zachowanie wyjść, wersję modelu lub reguły, stan zależności, interwencje ludzkie oraz potwierdzone wyniki bez gromadzenia niepotrzebnych wrażliwych danych. Zdefiniuj progi alarmowe i właściciela reakcji, a następnie przeglądaj dowody z rzeczywistego świata po wdrożeniu, zamiast zakładać, że offline wydajność będzie trwała. Przeprowadzaj ponowną ocenę przy zmianie źródeł danych, użytkowników, modeli, dostawców, polityk, sprzętu lub celów. Utrzymany system wymaga także udokumentowanego odzyskiwania, nauki z incydentów, procedur usuwania i retencji oraz jasnego momentu, w którym powinien zostać wyłączony lub zastąpiony.
Najczęściej zadawane pytania
Czy LSTM zawsze jest lepszy niż podstawowy RNN?
Nie. Bramkowanie pomaga w wielu problemach z długimi zależnościami, ale zwiększa obliczenia i liczbę parametrów. Podstawowy RNN może być wystarczający dla krótkich, prostych sekwencji, a inna architektura może być lepsza przy bardzo długim kontekście.
Czy LSTM może przetwarzać nieograniczoną historię?
Nie. Jego stan ma ograniczoną pojemność, gradienty i dane treningowe narzucają ograniczenia, a istotne szczegóły mogą zostać nadpisane. Wydajność przy długim kontekście musi być zmierzona, a nie wyciągana z nazwy architektury.
Podstawowe źródła












