
Podstawy AI
Czym są sieci CNN (Convolutional Neural Networks)?

 Dodaj Unite.AI do preferowanych źródeł w Google
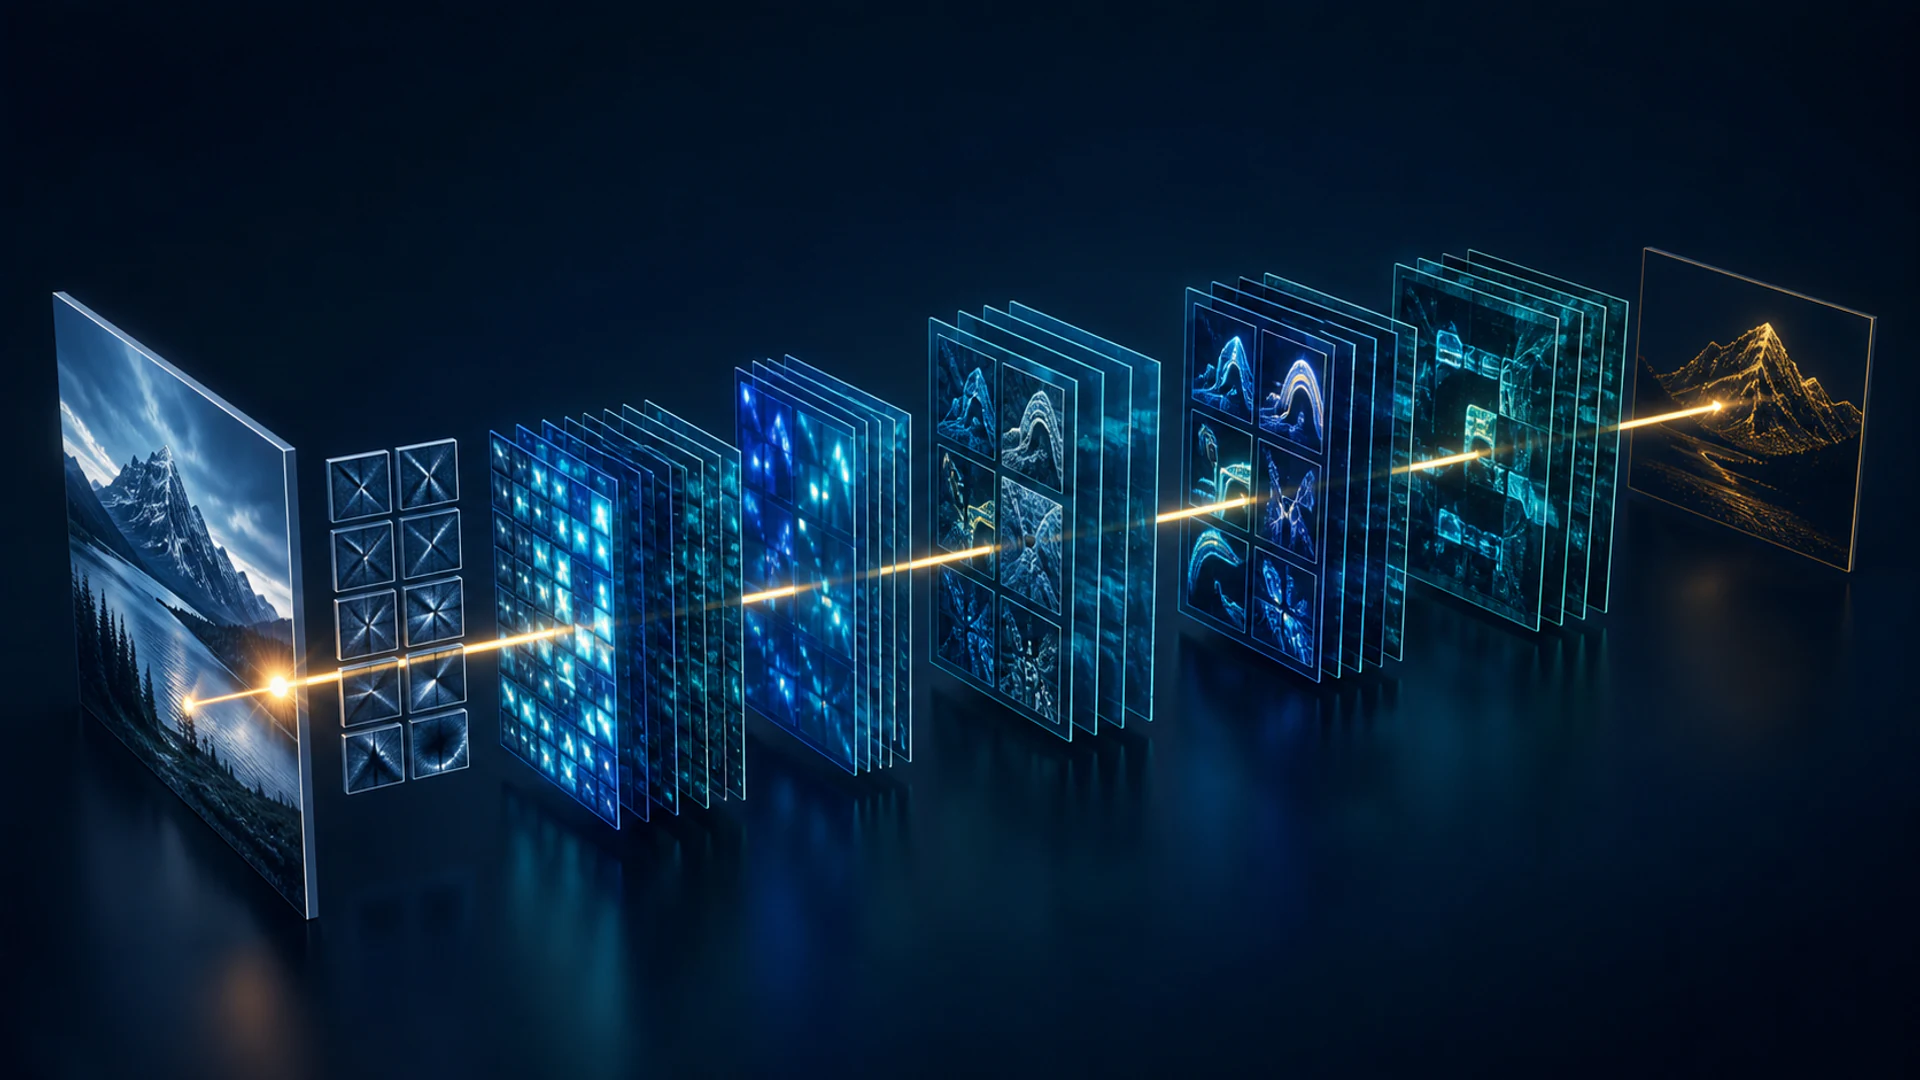
Sieć konwolucyjna sieć neuronowa (CNN) to architektura sieci neuronowej, która wykorzystuje wyuczone filtry na lokalnych obszarach danych wejściowych. CNN stały się podstawą współczesnego widzenia komputerowego, ponieważ potrafią wykrywać wzorce niezależnie od ich położenia i ponownie używać tych samych parametrów w całym obrazie.
CNN nie przetwarza obrazu z formy nienumerycznej na numeryczną — obraz już przychodzi jako tensor wartości pikseli. Jej celem jest przekształcenie tego tensora w mapy cech przydatne do klasyfikacji, wykrywania, segmentacji lub innego zadania.
Kluczowe wnioski
- Konwolucja łączy lokalne wartości wejściowe z wyuczonym jądrem, aby wygenerować mapę cech.
- Krok (stride), wypełnienie (padding), dylatacja i pooling kontrolują rozdzielczość przestrzenną oraz pole receptywne.
- Współdzielenie wag sprawia, że CNN są bardziej efektywne pod względem liczby parametrów niż w pełni połączona sieć działająca na surowych pikselach.
- Vision transformers stanowią alternatywę, ale CNN nadal są silne w systemach wymagających efektywności i ograniczonych danych.
Jak działa konwolucja
Jądro (kernel) to mała siatka uczących się wag. W każdej pozycji CNN mnoży wartości jądra przez odpowiadające im wartości wejściowe, sumuje wyniki i zazwyczaj dodaje bias. Powtarzanie tego procesu na całym wejściu tworzy mapę cech.
W przypadku obrazu kolorowego jądro obejmuje wszystkie kanały wejściowe. Warstwa używa wielu jąder, aby stworzyć wiele kanałów wyjściowych. Podczas treningu backpropagation oblicza gradienty dla tych wag jądra; operacja konwolucji nie generuje nowego, stałego zestawu wag dla każdego obrazu.
Krok, wypełnienie i dylatacja
- Stride określa, jak daleko przemieszcza się jądro. Krok większy niż jeden zmniejsza rozdzielczość przestrzenną.
- Padding dodaje wartości wokół wejścia, aby można było przetwarzać informacje o krawędziach i kontrolować rozmiar wyjścia.
- Dilation rozmieszcza elementy jądra, rozszerzając pole receptywne bez proporcjonalnego zwiększania liczby parametrów.
Pole receptywne to obszar oryginalnego wejścia, który może wpływać na jednostkę. Nakładanie kolejnych konwolucji go powiększa, umożliwiając późniejszym cechom łączenie informacji z szerszych obszarów.
Aktywacja, normalizacja i pooling
Warstwy konwolucyjne są zazwyczaj poprzedzane nieliniowymi aktywacjami i normalizacją. Pooling podsumowuje lokalne regiony przy użyciu operacji, takich jak maksimum lub średnia. Wyuczone konwolucje ze stridem mogą również zmniejszać rozdzielczość.
Pooling nie jest obowiązkowy. Wiele nowoczesnych sieci stosuje globalny pooling średniowy w pobliżu wyjścia zamiast spłaszczania dużej mapy cech do stosu w pełni połączonych warstw. Redukuje to liczbę parametrów i pozwala sieci agregować dowody przestrzenne.
Nowoczesna architektura CNN
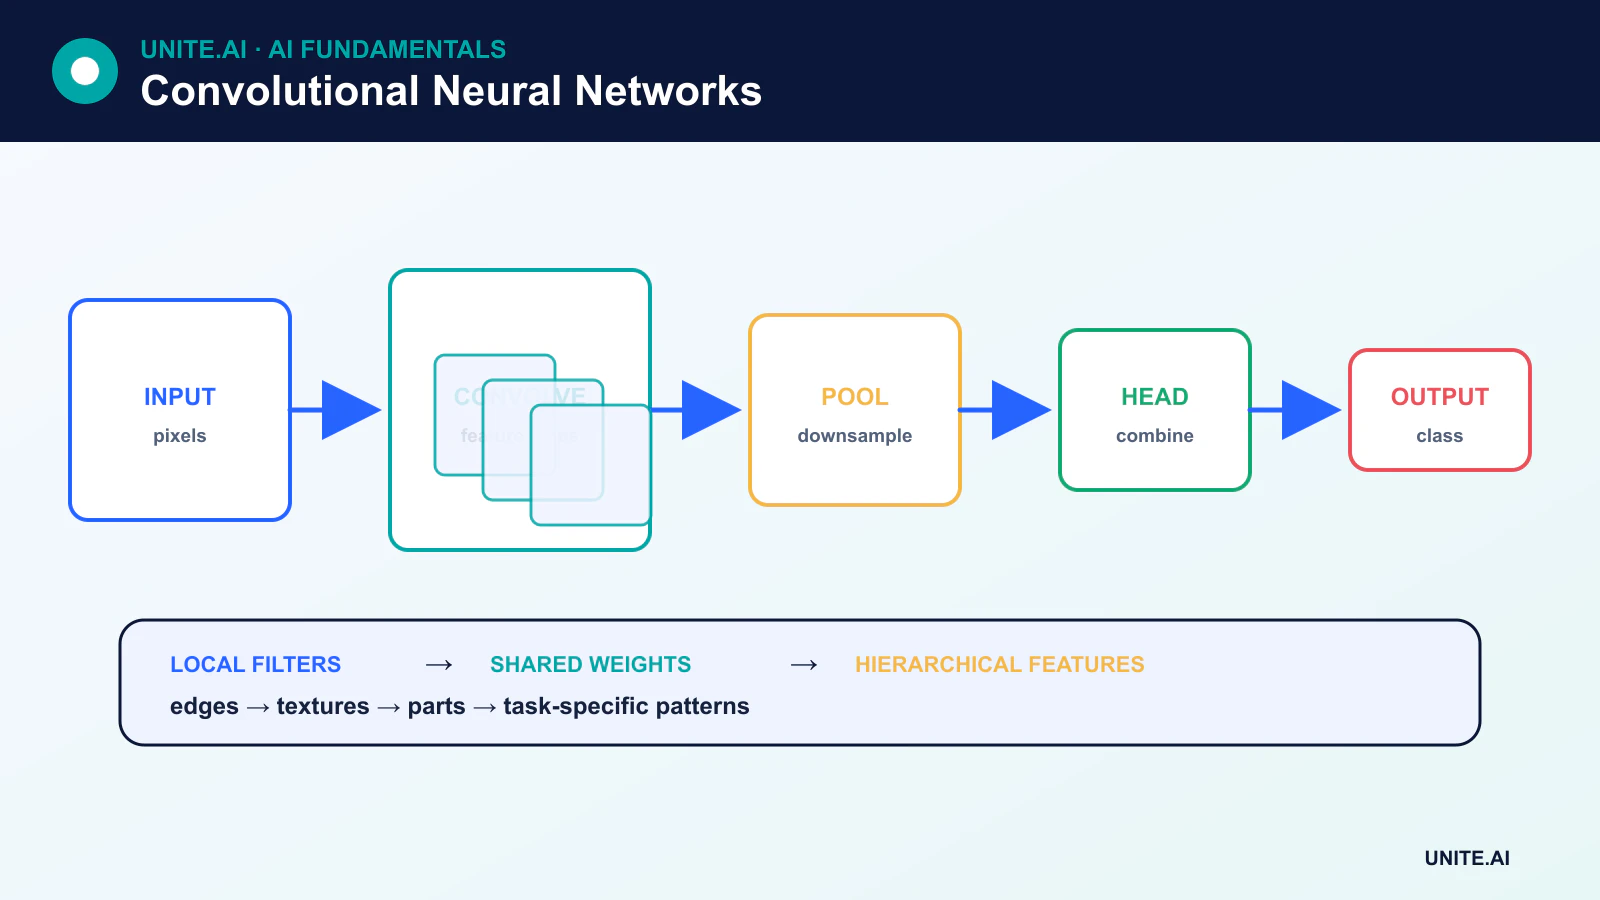
Typowy model wizji komputerowej zawiera wstęp (stem), sekwencję bloków cech, etapy zmniejszania rozdzielczości oraz głowicę zadania. Połączenia rezydualnych pozwalają blokowi nauczyć się modyfikacji swojego wejścia i zapewniają bezpośrednią drogę dla informacji i gradientów. Sukces sieci rezydualnych uczynił praktycznym trenowanie znacznie głębszych CNN.
Głowice klasyfikacyjne generują wyniki klas. Głowice detekcyjne przewidują kategorie i prostokąty. Architektury segmentacyjne dodają ścieżki dekodera, które odzyskują szczegóły przestrzenne. Ten sam szkielet CNN może być ponownie wykorzystany dzięki transfer learning.
Czego uczą się warstwy CNN
Często wizualizuje się wczesne filtry reagujące na krawędzie lub tekstury oraz późniejsze reprezentacje korelujące z częściami lub obiektami. Jest to przydatna intuicja, ale nie jest sztywną regułą. Cechy zależą od zadania, architektury, danych, celu oraz procesu treningowego, a niektóre jednostki łączą informacje, które nie odpowiadają jednoznacznie ludzkim pojęciom.
CNN a vision transformers
Vision transformers dzielą obrazy na fragmenty i wykorzystują mechanizm uwagi do modelowania zależności między nimi. Mogą skutecznie skalować się przy dużych zestawach danych wstępnie trenowanych. CNN wbudowują w architekturę założenia dotyczące lokalności i translacji, co może czynić je bardziej wydajnymi i efektywnymi pod względem danych w mniejszych warunkach.
Wiele praktycznych systemów łączy konwolucję i uwagę. Odpowiednia architektura zależy od dokładności, opóźnienia, pamięci, danych treningowych, sprzętu i wdrożenia — a nie od tego, która rodzina jest najnowsza.
Ograniczenia i praktyczne uwagi
CNN mogą być wrażliwe na zmianę rozkładu, perturbacje adwersarialne, skróty w tle oraz stronnicze dane treningowe. Nie są całkowicie niewrażliwe na pozycję, obrót, skalę ani punkt widzenia. Augmentacja i wybór architektury mogą poprawić odporność, ale nie dają jej gwarancji.
Podczas wdrażania należy mierzyć opóźnienie end-to-end, zużycie pamięci, przepustowość oraz zachowanie w podgrupach. Kwantyzacja i przycinanie mogą obniżyć koszty, szczególnie w przypadku edge AI, ale skompresowane modele muszą być ponownie zweryfikowane.
Konwolucja, pola receptywne i nowoczesne bloki CNN
Warstwa konwolucyjna przesuwa wyuczone jądra po siatce i współdzieli wagi pomiędzy pozycjami. Rozmiar jądra, krok, dylatacja i wypełnienie określają kształt wyjścia oraz pole receptywne. Wczesne warstwy często reagują na lokalne krawędzie lub tekstury; głębsze warstwy łączą informacje z większych obszarów, choć wyuczone reprezentacje nie muszą się jednoznacznie odwzorowywać na pojęcia ludzkie. Pooling lub konwolucja ze stridem zmniejsza rozdzielczość przestrzenną. Kanały przenoszą mapy cech, natomiast grupowa i głęboko separowalna konwolucja wymienia mieszanie między kanałami na mniejsze zapotrzebowanie na obliczenia. Połączenia rezydualne ułatwiają optymalizację bardzo głębokich sieci.
Dla wysokości i szerokości wejścia wypełnienie kontroluje traktowanie krawędzi, a krok kontroluje próbkowanie. Aggresywne zmniejszanie rozdzielczości może usuwać małe obiekty; wypełnienie zerami może powodować artefakty krawędziowe; dylatacja rozszerza kontekst bez proporcjonalnego wzrostu parametrów, ale może prowadzić do siatkowatego efektu. Normalizacja wsadowa (batch normalization) zależy od statystyk treningowych, podczas gdy alternatywy mogą lepiej działać przy małych rozmiarach wsadu. Nowoczesne architektury łączą wąskie gardła, cechy wieloskalowe, uwagę lub odwrócone rezydualne. Wybieraj architekturę, kierując się rozdzielczością zadania, przepustowością pamięci, opóźnieniem i docelowym sprzętem, a nie wyłącznie dokładnością klasyfikacji obrazu.
Trening, interpretacja i wdrożenie
Stosuj augmentacje, które zachowują etykiety i odzwierciedlają rzeczywiste zmiany, oraz podziel dane według podmiotu lub sceny przed augmentacją. Transfer learning jest powszechny: wymień głowicę zadania, wytrenuj ją, a następnie ostrożnie odblokuj szkielet. Oceń wydajność specyficzną dla klas, kalibrację, odporność na rozmycie, kompresję, oświetlenie, skalę, przycięcie oraz perturbacje adwersarialne. Metody wizualizacji, takie jak mapy cech i mapy uwagi (saliency), mogą ujawnić skróty, ale są wrażliwe na metodę i punkt odniesienia. Potwierdź podejrzane zależności przy użyciu obrazów kontrfaktycznych, testów zakrycia lub zmian w zestawie danych.
Eksportowane CNN mogą być łączone, kwantyzowane lub kompilowane pod GPU, NPU, przeglądarkę lub mikrokontroler. Zweryfikuj wdrożony graf, w tym przetwarzanie wstępne i końcowe, na konkretnych urządzeniach. Mierz opóźnienie end-to-end, zużycie pamięci, energię i zachowanie termiczne; dekodowanie wejścia może dominować w małych modelach. Monitoruj statystyki kamery i obrazu, rozkład wyjść oraz potwierdzone błędy. Podpisane artefakty modelu, chronione kanały aktualizacji i łagodne awarie czujników są częścią projektowania produkcji. CNN kodują przydatne uprzedzenie lokalności, ale nie rozumieją automatycznie obiektów ani scen przyczynowo-skutkowych.
Przykład praktyczny: wdrożenie CNN na kamerze inspekcyjnej
CNN klasyfikuje wady powierzchni na podstawie wysokiej rozdzielczości obrazów skanowanych liniowo. Inżynierowie dzielą obrazy na kafelki z nakładaniem, aby małe wady przetrwały zmniejszanie rozdzielczości, zachowują współrzędne do przeglądu i weryfikują augmentacje względem rzeczywistych wariacji optycznych. Porównuje się residualną sieć CNN i lżejszy model depthwise przy równym poziomie recall. Testy obejmują wady krawędzi, odblaski, kompresję, ruch, partie materiałów i wymiany kamer, przy czym niezależne partie produkcyjne są zarezerwowane do ostatecznej oceny.
Kompilacja łączy i kwantyzuje model pod akcelerator brzegowy, ale wdrożony graf jest porównywany z referencją w przypadkach wrażliwych na wady. Dekodowanie, kafelkowanie, inferencja i łączenie opóźnień są mierzone od początku do końca. System oznacza martwe piksele i dryf ekspozycji oddzielnie od wad produktów. Operatorzy mogą przeglądać źródłowe kafelki i nadpisywać wyniki. Zmiany modelu i kamery są wprowadzane stopniowo, a linia zachowuje bezpieczną procedurę ręcznej inspekcji, gdy pipeline wizyjny jest niedostępny.
Dowody wdrożeniowe i gotowość operacyjna
Decyzja produkcyjna wymaga więcej niż udanej demonstracji. Zdefiniuj docelowych użytkowników, środowisko operacyjne, dane wejściowe, wyjściowe, zależności, właściciela oraz konsekwencje każdego istotnego awarii. Ustal powtarzalną bazę i wersjonowany zestaw ewaluacyjny przed dostrojeniem. Testuj typowe przypadki, warunki brzegowe, nieprawidłowe lub brakujące dane wejściowe, zmianę rozkładu, awarię zależności, niewłaściwe użycie oraz grupy lub środowiska najprawdopodobniej niedoszacowane. Mierz jakość zadania wraz z kalibracją lub niepewnością, opóźnieniem, przepustowością, kosztami zasobów, dostępnością, prywatnością i bezpieczeństwem. Zarejestruj każdą transformację i próg, aby niezależny recenzent mógł odtworzyć wynik i odróżnić dowody od atrakcyjnego prototypu.
Przed uruchomieniem przydziel odpowiedzialność za wydanie, wyjątki, zmiany, wycofanie i wycofanie. Stosuj etapowe wdrożenie, zachowaj bezpieczną alternatywę i zweryfikuj monitorowanie przy celowo wprowadzonych awariach. Telemetria operacyjna powinna ujawniać jakość danych wejściowych, zachowanie wyjść, wersję modelu lub reguły, stan zależności, interwencje ludzkie oraz potwierdzone wyniki, nie gromadząc niepotrzebnych wrażliwych danych. Zdefiniuj progi alarmowe i właściciela reakcji, a następnie przeglądaj dowody z rzeczywistego świata po wdrożeniu, zamiast zakładać, że offline’owa wydajność będzie trwała. Przeprowadzaj ponowną ocenę przy zmianie źródeł danych, użytkowników, modeli, dostawców, polityk, sprzętu lub celów. Utrzymany system wymaga także udokumentowanego przywracania, nauki z incydentów, procedur usuwania i przechowywania oraz wyraźnego punktu, w którym powinien zostać wyłączony lub zastąpiony.
Najczęściej zadawane pytania
Czy CNN zawsze wymaga pooling?
Nie. CNN może zmniejszać rozdzielczość za pomocą konwolucji ze stridem i zachować rozdzielczość dla gęstych predykcji. Pooling jest jednym z narzędzi projektowych, a nie wymogiem definiującym.
Czy filtry w CNN są projektowane ręcznie?
W wytrenowanej sieci CNN wartości jąder są zazwyczaj uczone na podstawie danych. Różni się to od klasycznych filtrów wizji, których współczynniki są wybierane z góry do operacji takich jak wykrywanie krawędzi.
Podstawowe źródła












