Podstawy AI
Czym jest redukcja wymiarowości?

 Dodaj Unite.AI do preferowanych źródeł w Google
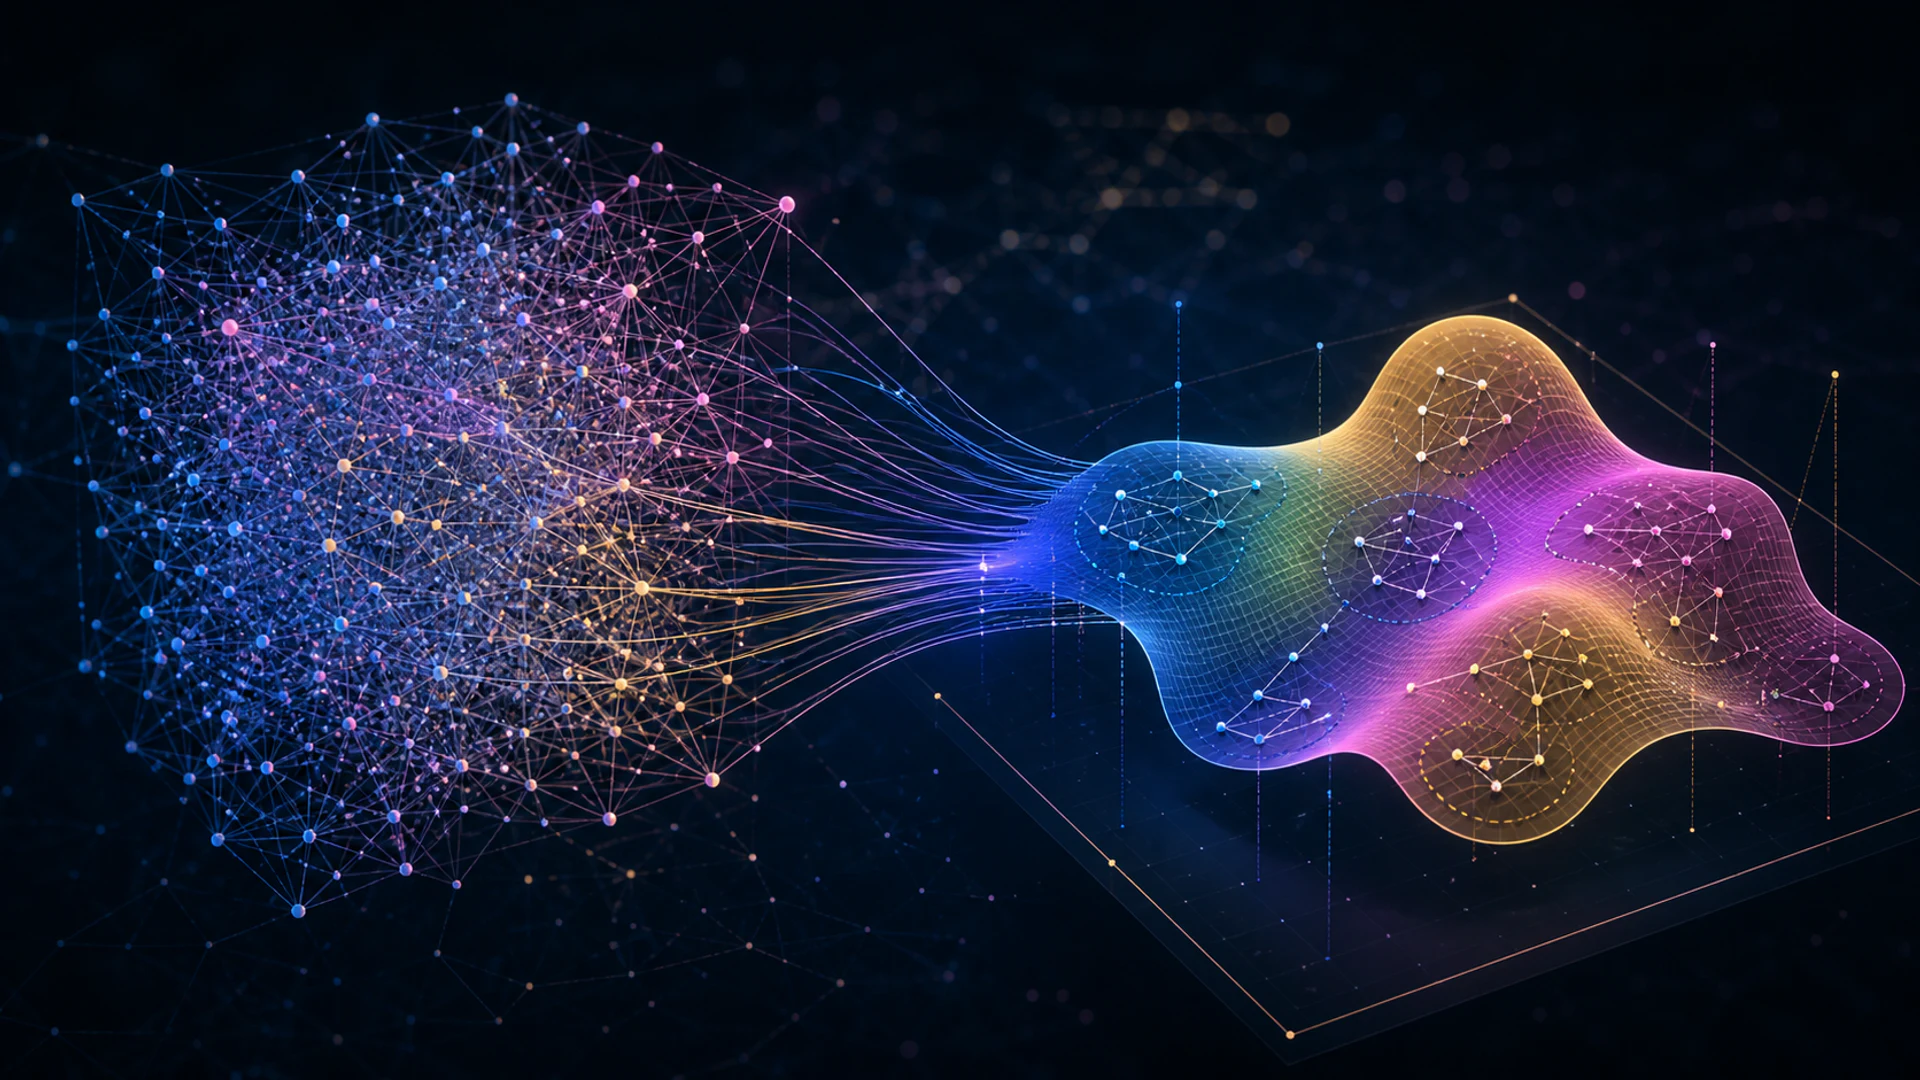
Dimensionality reduction przedstawia dane przy użyciu mniejszej liczby zmiennych, zachowując przy tym informacje przydatne do zadania. Może zmniejszyć potrzebną przestrzeń dyskową i szum, poprawić wizualizację, ograniczyć redundantne cechy oraz ułatwić trenowanie kolejnych modeli.
Żadna metoda nie zachowuje wszystkich zależności. Przydatna redukcja zaczyna się od określenia, co ma pozostać: wariancja, separacja klas, lokalne sąsiedztwa, globalna geometria, jakość rekonstrukcji lub interpretowalność.
Kluczowe wnioski
- Wybór cech zachowuje oryginalne zmienne; ekstrakcja cech tworzy nowe współrzędne o niższej wymiarowości.
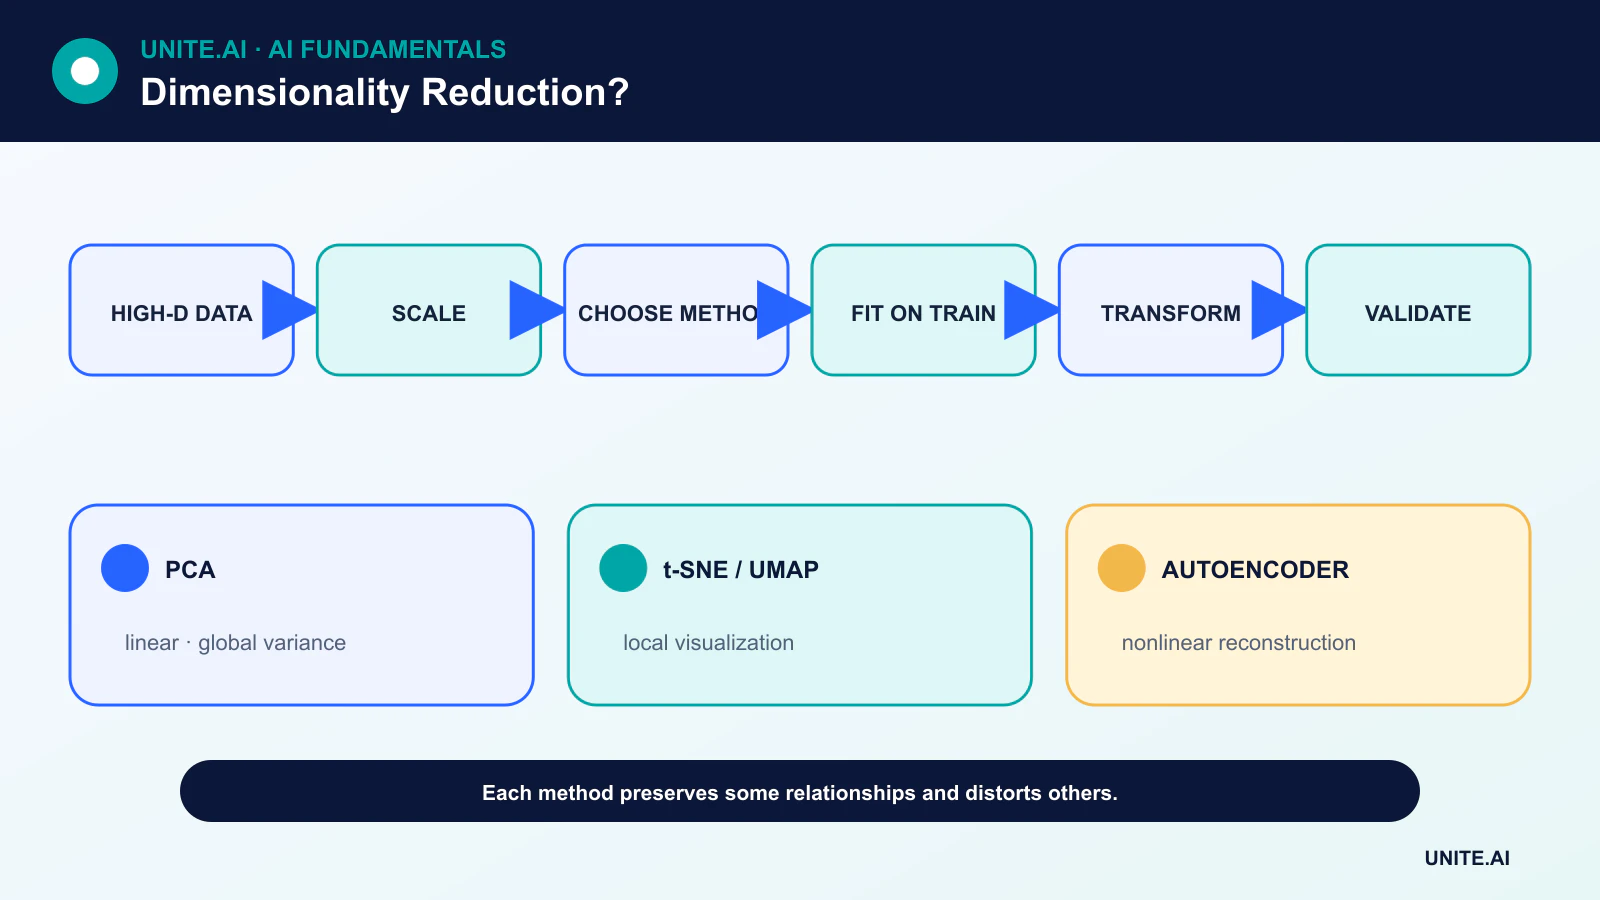
- PCA jest metodą liniową i skoncentrowaną na wariancji; t‑SNE i UMAP podkreślają strukturę sąsiedztwa w wizualizacji.
- Osadzenia wizualizacyjne mogą zniekształcać odległości, rozmiary klastrów oraz globalną separację.
- Dopasuj redukcję wyłącznie na danych treningowych, a następnie zastosuj wyuczony przekształcenie do danych walidacyjnych i testowych.
Wybór cech kontra projekcja
Wybór cech usuwa zmienne przy użyciu reguł domenowych, braków danych, redundancji, testów predykcyjnych lub regularizacji. Zachowuje pierwotne znaczenia, co może wspierać zarządzanie i wyjaśnianie.
Metody projekcji łączą zmienne w nowe współrzędne. Potrafią uchwycić rozproszoną strukturę, ale mogą utrudniać interpretację poszczególnych współrzędnych. Autoenkoder uczy się nieliniowej projekcji poprzez rekonstrukcję.
PCA i SVD
Analiza głównych składowych (PCA) identyfikuje ortogonalne kierunki o malejącej wariancji po centrowaniu danych. Rozkład wartości osobliwych (SVD) zapewnia wspólną metodę numeryczną. Skalowanie ma znaczenie: jednostka pomiarowa o wysokiej wariancji może zdominować składowe.
PCA jest deterministyczna z wyjątkiem znaku i powtarzających się wartości własnych, obsługuje transformację poza próbką oraz dostarcza podsumowania wyjaśnionej wariancji. Wysoka wariancja nie zawsze jest istotna dla zadania, a liniowe składowe nie potrafią rozwijać każdej zakrzywionej rozmaitości.
t‑SNE i UMAP
t‑SNE konstruuje rozkłady prawdopodobieństwa nad sąsiadami i optymalizuje niskowymiarową mapę podkreślającą lokalną podobność. UMAP buduje ważony graf sąsiedztwa i optymalizuje reprezentację o niższej wymiarowości z powiązanymi celami dotyczącymi lokalnej struktury.
Obie są potężnymi narzędziami eksploracyjnymi, ale są wrażliwe na wstępne przetwarzanie, metrykę odległości i hiperparametry. Pusta przestrzeń, obszar klastra i odległość między klastrami na wykresie 2‑D nie powinny automatycznie być interpretowane dosłownie.
Metody nadzorowane i reprezentacje uwzględniające zadanie
Analiza dyskryminacyjna (LDA) wykorzystuje etykiety klas w celu uzyskania separacji, co odróżnia ją od nienadzorowanej PCA. Uczenie reprezentacji neuronowych może optymalizować cele predykcyjne lub kontrastowe zamiast rekonstrukcji.
Jeśli etykiety kierują redukcją, wszystkie dopasowania i strojenia muszą pozostawać w ramach procesu treningowego. W przeciwnym razie informacje z zestawu testowego mogą wyciec do wyboru modelu i spowodować optymistyczny wynik.
Wybór i walidacja metody
Rozpocznij od wstępnego przetwarzania i prostej linii bazowej. W przypadku kompresji mierz jakość rekonstrukcji lub wydajność downstream w różnych wymiarach. W wizualizacji testuj stabilność względem losowych ziaren i hiperparametrów oraz porównuj zachowanie sąsiedztwa z wiedzą domenową.
W produkcji zapytaj, czy metoda potrafi przekształcać nowe rekordy, jak radzi sobie z brakującymi wartościami, czy zmienia się przy ponownym treningu oraz czy użytkownicy potrzebują wyjaśnień dotyczących oryginalnych cech. Przeuczenie może wystąpić w kroku redukcji tak samo jak w ostatecznym modelu.
Metody redukcji liniowej i nieliniowej
Redukcja wymiarowości mapuje dane wysokowymiarowe na mniejszą liczbę współrzędnych, zachowując wybraną strukturę. Analiza głównych składowych znajduje ortogonalne kierunki o maksymalnej wariancji po centrowaniu; skalowanie jest potrzebne, gdy jednostki powinny wnosić porównywalny wkład. Rozkład wartości osobliwych oblicza powiązaną strukturę niskiego rzędu i obsługuje macierze rzadkie. Analiza dyskryminacyjna wykorzystuje etykiety do znalezienia kierunków separujących klasy. Metody te dostarczają explicite przekształcenia, lecz wariancja lub separacja klas nie zawsze zachowują informacje niezbędne do zadania downstream.
Metody rozmaitości, takie jak t‑SNE i UMAP, konstruują sąsiedztwa i optymalizują niskowymiarowy układ. Są potężne w eksploracji, ale zniekształcają globalne odległości, gęstość, rozmiar klastrów i czasem separację. Wyniki zależą od wstępnego przetwarzania, metryki, liczby sąsiadów lub perplexity, inicjalizacji i ziarna. Atrakcyjny klaster w dwóch wymiarach może powstać nawet bez dyskretnych grup. Stosuj wiele ustawień, koloruj jedynie według metadanych nie używanych przy dopasowywaniu i weryfikuj pozorną strukturę w oryginalnej przestrzeni lub przy użyciu niezależnych etykiet.
Wybór cech, osadzenia i ocena
Wybór cech zachowuje oryginalne zmienne przy użyciu filtrów, metod wrapper lub ważności opartej na modelu; uczenie reprezentacji tworzy nowe cechy ukryte przy pomocy autoenkoderów lub modeli nadzorowanych. Losowe projekcje przybliżają odległości pod pewnymi warunkami i stanowią wydajne baseline’y. Wybierz metodę w zależności od potrzeb: kompresja, wizualizacja, redukcja szumu, szybkość, przechowywanie lub wydajność modelu. Dopasuj reduktor wyłącznie na danych treningowych, a następnie przekształć zestawy walidacyjne i testowe. Redukcja nadzorowana musi być zagnieżdżona w walidacji krzyżowej, aby uniknąć wycieku etykiet.
Oceń wyjaśnioną wariancję lub jakość rekonstrukcji przy kompresji liniowej, wiarygodność i zachowanie sąsiedztwa w wizualizacji oraz dokładność downstream, kalibrację, opóźnienie i odporność w prognozowaniu. Mierz stabilność w różnych próbkach i ziarnach. Sprawdź, czy rzadkie klasy lub wrażliwe grupy nie są scalane oraz czy możliwe jest odwrotne mapowanie. Zredukowane współrzędne mogą nadal zawierać prywatne informacje; wykres dwuwymiarowy nie jest anonimizacją. Udokumentuj przekształcenie, skalowanie, kolejność cech i ograniczenia.
Zastosowanie w produkcji
Obsługa wymaga dokładnie dopasowanego przekształcenia oraz schematu wejścia. Monitoruj brakujące cechy, przesunięcie zakresu, rozkład wyników komponentów, błąd rekonstrukcji i wyniki downstream. Jeśli pojawią się nowe kategorie lub czujniki, przeprowadź ponowny trening i wersjonowanie całego potoku zamiast cichego dodawania kolumn. Redukcja może poprawić wydajność obliczeniową i odszumieć model, ale może też odrzucić słabe sygnały istotne dla rzadkich zdarzeń. Traktuj ją jako wyuczony krok pomiarowy, którego zachowane i utracone informacje muszą być zweryfikowane względem decyzji.
Przykład praktyczny: redukcja cech zachowań klientów
Analityk standaryzuje 200 miar zachowań i dopasowuje PCA wyłącznie na klientach treningowych. Walidacja krzyżowa wybiera liczbę komponentów na podstawie wydajności churn w downstream oraz stabilności, a nie na podstawie dwuwymiarowego wykresu rozrzutu. Ładunki są analizowane pod kątem dominujących źródeł i braków danych. PCA, wybór cech, losowa projekcja oraz nieredukowany model regularizowany są porównywane pod względem kalibracji, opóźnienia i wyników dla rzadkich segmentów klientów. Powtarzane próbki testują również, czy wiodące komponenty i wnioski downstream pozostają stabilne.
Wdrożony potok ustala kolejność cech, skalowanie i komponenty oraz odrzuca brakujące wersje schematu. Monitorowanie śledzi rozkłady komponentów, błąd rekonstrukcji i wyniki downstream. Wizualizacja z pozornymi klastrami służy do generowania pytań, a nie do przypisywania person klientów. Ponieważ ukryte komponenty nadal kodują zachowanie, dostęp i retencja pozostają kontrolowane. Jeśli definicje źródłowe ulegną zmianie, pełne przekształcenie i model są odbudowywane i walidowane, zamiast projekcji niekompatybilnych danych na stare komponenty.
Dowody implementacyjne i gotowość operacyjna
Decyzja produkcyjna wymaga więcej niż udanej demonstracji. Zdefiniuj docelowych użytkowników, środowisko operacyjne, wejścia, wyjścia, zależności, właściciela oraz konsekwencje każdego istotnego błędu. Ustal odtwarzalną linię bazową i wersjonowany zestaw ewaluacyjny przed strojeniem. Testuj typowe przypadki, warunki brzegowe, niepoprawne lub brakujące dane wejściowe, przesunięcie rozkładu, awarie zależności, niewłaściwe użycie oraz grupy lub środowiska najprawdopodobniej niedoszacowane. Mierz jakość zadania wraz z kalibracją lub niepewnością, opóźnieniem, przepustowością, kosztami zasobów, dostępnością, prywatnością i bezpieczeństwem. Zarejestruj każde przekształcenie i próg, aby niezależny recenzent mógł odtworzyć wynik i odróżnić dowód od atrakcyjnego prototypu.
Przed uruchomieniem przydziel odpowiedzialność za wydanie, wyjątki, zmiany, wycofanie i wycofanie. Stosuj etapowe wdrożenie, zachowaj bezpieczną alternatywę i zweryfikuj monitorowanie poprzez celowo wprowadzane awarie. Telemetria operacyjna powinna ujawniać jakość danych wejściowych, zachowanie wyjścia, wersję modelu lub reguły, stan zależności, interwencje ludzkie oraz potwierdzone wyniki, nie gromadząc niepotrzebnych wrażliwych danych. Zdefiniuj progi alarmowe i właściciela reakcji, a następnie przeglądaj dowody z rzeczywistego środowiska po wdrożeniu, zamiast zakładać, że offline’owa wydajność się utrzyma. Przeprowadzaj ponowną ocenę przy zmianie źródeł danych, użytkowników, modeli, dostawców, polityk, sprzętu lub celów. Utrzymany system wymaga także udokumentowanego przywracania, nauki z incydentów, procedur usuwania i przechowywania oraz wyraźnego momentu, w którym powinien zostać wyłączony lub zastąpiony.
Najczęściej zadawane pytania
Czy redukcja wymiarowości zawsze poprawia model?
Nie. Może odrzucić informacje predykcyjne lub utrudnić interpretację. Porównaj z bazą bez redukcji na danych odrzuconych.
Czy oddzielone klastry t‑SNE dowodzą, że istnieją rzeczywiste klasy?
Nie. Mapa jest zoptymalizowaną wizualizacją relacji sąsiedztwa i może tworzyć pozorne rozdzielenie. Zweryfikuj klastry przy użyciu niezależnych dowodów.
Podstawowe odniesienia