
Podstawy AI
Czym jest Edge AI i Edge Computing?

 Dodaj Unite.AI do preferowanych źródeł w Google
Edge computing umieszcza obliczenia blisko urządzeń i procesów fizycznych generujących dane. Edge AI wykonuje wnioskowanie uczenia maszynowego — a czasem także trening lub adaptację — na czujniku, telefonie, pojeździe, bramce lub lokalnym serwerze, zamiast wysyłać każde wejście do odległej chmury.
Architektura zazwyczaj jest kontinuum, a nie wyborem między krawędzią a chmurą. Natychmiastowe decyzje mogą pozostać lokalne, podczas gdy chmura wspiera zarządzanie flotą, zbiorczą analizę, trening modeli i długoterminowe przechowywanie.
Kluczowe wnioski
- Edge AI może zmniejszyć opóźnienia, zużycie pasma i transfer surowych danych, ale nie gwarantuje automatycznie prywatności.
- Pamięć, moc, ograniczenia termiczne oraz wsparcie akceleratorów kształtują model, który można wdrożyć.
- Kwantyzacja, przycinanie i destylacja wymieniają rozmiar i szybkość modelu na dokładność i odporność.
- Bezpieczne aktualizacje, telemetria, przywracanie poprzednich wersji i różnorodność sprzętu są kluczowymi elementami systemu.
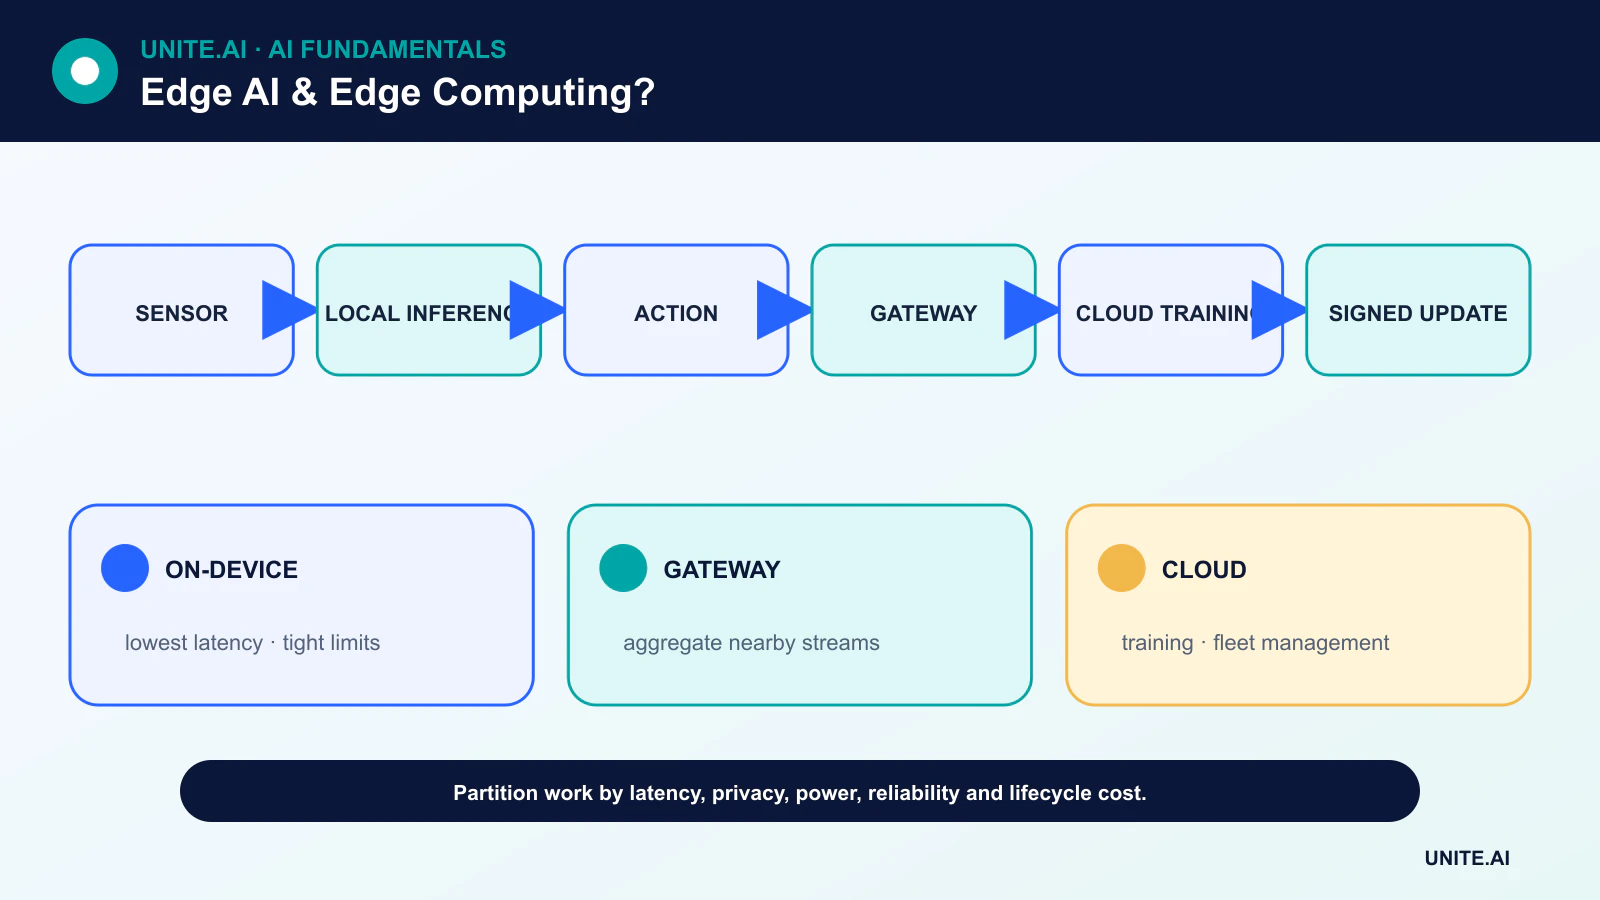
Kontinuum edge‑cloud
Czujnik może uruchamiać mały model progowy, pobliska bramka może łączyć kilka strumieni, a regionalny serwer może wykonywać bardziej złożone wnioskowanie. Chmura może trenować modele i dystrybuować podpisane aktualizacje. Podział zależy od opóźnień, łączności, energii, wrażliwości danych i utrzymania.
W sterowaniu przemysłowym, milisekundy i praca offline mogą uzasadniać lokalne wnioskowanie. W przypadku niskoczęstotliwościowych prognoz biznesowych, scentralizowane przetwarzanie może być prostsze i bardziej obserwowalne.
Ograniczenia sprzętowe i modeli
Urządzenia brzegowe obejmują od mikrokontrolerów z kilobajtami pamięci po telefony i serwery z NPU lub GPU. Model musi zmieścić się w pamięci i RAM, spełniać terminy w czasie rzeczywistym, pozostawać w granicach termicznych i korzystać z obsługiwanych operatorów.
Benchmarking powinien obejmować przetwarzanie wstępne, przemieszczanie danych i koszt wybudzenia — nie tylko przepustowość jądra. Rozmiar wsadu jest często równy jeden, a wydajność ciągła może różnić się od krótkiego testu laboratoryjnego.
Kompresja i optymalizacja
Kwantyzacja reprezentuje wagi i aktywacje z niższą precyzją. Przycinanie usuwa parametry lub struktury. Destylacja wiedzy trenuje mniejszego ucznia, aby naśladował większego nauczyciela. Fuzja operatorów i planowanie pamięci mogą dodatkowo zmniejszyć opóźnienia.
Kompresja może wpływać na dokładność, kalibrację i wydajność podgrup. Zespoły powinny weryfikować przekonwertowany artefakt na docelowym sprzęcie, zamiast zakładać, że metryki oryginalnego modelu zmiennoprzecinkowego nadal obowiązują.
Prywatność, uczenie federacyjne i bezpieczeństwo
Lokalne wnioskowanie może przechowywać surowe audio, obrazy lub zapisy czujników na urządzeniu, ale metadane, osadzenia i telemetria mogą nadal być wrażliwe. Uczenie federacyjne może koordynować rozproszone treningi, niosąc własne ryzyka prywatności i zatruwania.
Floty brzegowe zwiększają powierzchnię ataku. Bezpieczny rozruch, podpisane modele, usługi o minimalnych uprawnieniach, szyfrowana komunikacja i terminowe aktualizacje należą do projektu bezpieczeństwa cybernetycznego. Należy zakładać fizyczny dostęp oraz długowieczne, nieobsługiwane urządzenia.
Monitorowanie i operacje floty
Lokalny model nadal wymaga obserwowalności. Urządzenia mogą zgłaszać zagregowane metryki z poszanowaniem prywatności, wersję, stan zdrowia, opóźnienia i wskaźniki odrzuceń. Próbkowanie wybranych danych wejściowych do przeglądu wymaga wyraźnej zgody i kontroli retencji.
Wdrażania powinny wykorzystywać grupy kanary i automatyczne przywracanie. System musi radzić sobie z niekompatybilnym sprzętem, przerwanymi aktualizacjami i dryftem modelu. Urządzenie, które nie może otrzymać poprawek bezpieczeństwa, może wymagać wycofania z eksploatacji.
Architektura edge i rozmieszczenie obciążeń
Edge computing przetwarza dane blisko ich źródła — na czujniku, urządzeniu, bramce, pojeździe, miejscu detalicznym lub lokalnym serwerze — zamiast polegać wyłącznie na odległej chmurze. Edge AI umieszcza wnioskowanie modelu, a czasem trening, w tym środowisku. Rozmieszczenie powinno uwzględniać opóźnienia, łączność, przepustowość, prywatność, odporność, energię i potrzeby zarządzania. Projekt hybrydowy może wykonywać natychmiastowe wykrywanie lokalnie, wysyłać wybrane zdarzenia do systemu regionalnego i wykorzystywać chmurę do analizy floty oraz treningu modeli.
Sprzęt obejmuje od mikrokontrolerów i NPU po GPU i wytrzymałe serwery. Modele są eksportowane, kwantowane, przycinane, destylowane lub kompilowane pod dostępne operatory i pamięć. Przetwarzanie wstępne oraz I/O czujnika mogą dominować opóźnienia, podczas gdy ograniczenia cieplne lub baterii wpływają na utrzymaną przepustowość. Należy benchmarkować cały pipeline na dokładnym urządzeniu w realistycznych warunkach współbieżności, temperatury i trybów zasilania. Wartość TOPS w nagłówku nie ujawnia awaryjnego użycia operatorów, transferów pamięci ani rzeczywistej dokładności.
Bezpieczeństwo floty, aktualizacje i obserwowalność
Rozproszone urządzenia zwiększają powierzchnię ataku i mogą być fizycznie dostępne. Stosuj bezpieczny rozruch, podpisane oprogramowanie układowe i modele, tożsamość opartą na sprzęcie, kiedy to możliwe, szyfrowaną komunikację, minimalne uprawnienia, segmentację sieci i chronione sekrety. Aktualizacje wymagają etapowego wdrażania, sprawdzania kompatybilności, polityki anty‑rollback, odzyskiwania po przerwanych aktualizacjach oraz znanego, dobrego obrazu. Inwentaryzuj wersje urządzeń, czujników, firmware, środowiska uruchomieniowego i modeli, aby incydent można było szybko oszacować.
Łączność jest przerywana, więc buforuj dane w ograniczonej pamięci, sekwencjonuj zdarzenia, zapewnij idempotentne ponowne próby i określ zachowanie offline. Obserwowalność powinna rejestrować stan zdrowia, opóźnienia, zużycie energii, podsumowania wejść, prognozy, pewność oraz potwierdzone wyniki, bez przesyłania niepotrzebnych surowych danych. Dryft zegara, awarie czujników i wyczerpanie lokalnej pamięci mogą unieważnić wyniki. Zdalne polecenia i kanały debugowania wymagają silniejszej autoryzacji, ponieważ mogą stać się ścieżkami kontroli całej floty.
Odpowiedzialne wdrożenie
Lokalne przetwarzanie może zmniejszyć transfer, ale nie zapewnia automatycznie ochrony prywatności; surowe dane wejściowe, osadzenia i logi mogą nadal pozostawać na urządzeniu lub synchronizować się później. Minimalizuj retencję i ujawniaj możliwość przejścia do chmury. Testuj dryft modelu w różnych lokalizacjach i warunkach środowiskowych, z bezpiecznym ustawieniem domyślnym, gdy spada pewność lub stan czujnika. Edge AI jest wartościowe, gdy lokalne ograniczenia są rzeczywiste, ale przenosi odpowiedzialność za cykl życia, bezpieczeństwo i jakość na dużą, heterogeniczną flotę, którą należy projektować i utrzymywać jako jeden system.
Przykład praktyczny: Edge AI dla zdalnej kamery bezpieczeństwa
Zdalna lokalizacja wykrywa, czy zamknięta brama jest otwarta podczas pracy maszyn. Urządzenie brzegowe przetwarza wideo lokalnie, zapewniając niskie opóźnienia, i przesyła jedynie zdarzenia oraz dozwolone miniatury. Dane obejmują warunki pogodowe, nocne oświetlenie, brud, wibracje i puste sceny. Model jest kwantowany i benchmarkowany od końca do końca na docelowym urządzeniu pod kątem wykrywania, fałszywych alarmów, opóźnień, zużycia energii i utrzymania termicznego.
Bezpieczny rozruch, podpisane aktualizacje, tożsamość urządzenia i segmentowana sieć chronią flotę. Zablokowanie kamery, wyczerpanie pamięci, dryft zegara, utrata sieci i przekroczenie limitu czasu modelu generują alarmy zdrowotne oraz regułę bezpiecznego sprzętu niezależną od AI. Aktualizacje są wdrażane w małej grupie z automatycznym przywracaniem. Monitorowanie zbiera minimalne dane o stanie i wynikach, a personel na miejscu może je sprawdzić i nadpisać. Lokalna inferencja zmniejsza transfer, ale nie eliminuje obowiązków związanych z prywatnością, retencją czy bezpieczeństwem fizycznym.
Dowody wdrożeniowe i gotowość operacyjna
Decyzja produkcyjna wymaga więcej niż udanej demonstracji. Zdefiniuj docelowych użytkowników, środowisko operacyjne, dane wejściowe, wyjściowe, zależności, właściciela oraz konsekwencje każdego istotnego błędu. Ustal powtarzalną bazę i wersjonowany zestaw oceny przed dostrojeniem. Testuj typowe przypadki, warunki brzegowe, niepoprawne lub brakujące dane, zmianę rozkładu, awarię zależności, niewłaściwe użycie oraz grupy lub środowiska najprawdopodobniej niedoszacowane. Mierz jakość zadania wraz z kalibracją lub niepewnością, opóźnieniem, przepustowością, kosztami zasobów, dostępnością, prywatnością i bezpieczeństwem. Zarejestruj każdą transformację i próg, aby niezależny recenzent mógł odtworzyć wynik i odróżnić dowody od atrakcyjnego prototypu.
Przed uruchomieniem przydziel odpowiedzialność za wydanie, wyjątki, zmiany, przywracanie i wycofanie. Stosuj etapowe wdrażanie, zachowaj bezpieczną alternatywę i weryfikuj monitorowanie przy celowo wprowadzonych awariach. Telemetria operacyjna powinna ujawniać jakość danych wejściowych, zachowanie wyjść, wersję modelu lub reguły, stan zależności, interwencje ludzkie oraz potwierdzone wyniki, bez zbierania niepotrzebnych wrażliwych danych. Zdefiniuj progi alarmowe i osobę odpowiedzialną za reakcję, a następnie przeglądaj dowody z rzeczywistego świata po wdrożeniu, zamiast zakładać, że wydajność offline utrzyma się. Przeprowadzaj ponowną ocenę przy zmianie źródeł danych, użytkowników, modeli, dostawców, polityk, sprzętu lub celów. Utrzymany system wymaga również udokumentowanego odzyskiwania, nauki po incydentach, procedur usuwania i retencji oraz wyraźnego momentu, w którym powinien zostać wyłączony lub zastąpiony.
Najczęściej zadawane pytania
Czy Edge AI jest zawsze szybsze niż AI w chmurze?
Nie. Lokalna inferencja eliminuje opóźnienie sieciowe, ale może działać na słabszym sprzęcie. Pełny pipeline i wymagania niezawodności określają opóźnienie.
Czy Edge AI może działać bez dostępu do Internetu?
Tak, jeśli model, przetwarzanie wstępne i logika decyzyjna są lokalne. Aktualizacje, synchronizacja lub funkcje zależne od chmury mogą być niedostępne.
Podstawowe odniesienia












