
Podstawy AI
Co to jest Generatywna Sieć Przeciwnikowa (GAN)?

 Dodaj Unite.AI do preferowanych źródeł w Google
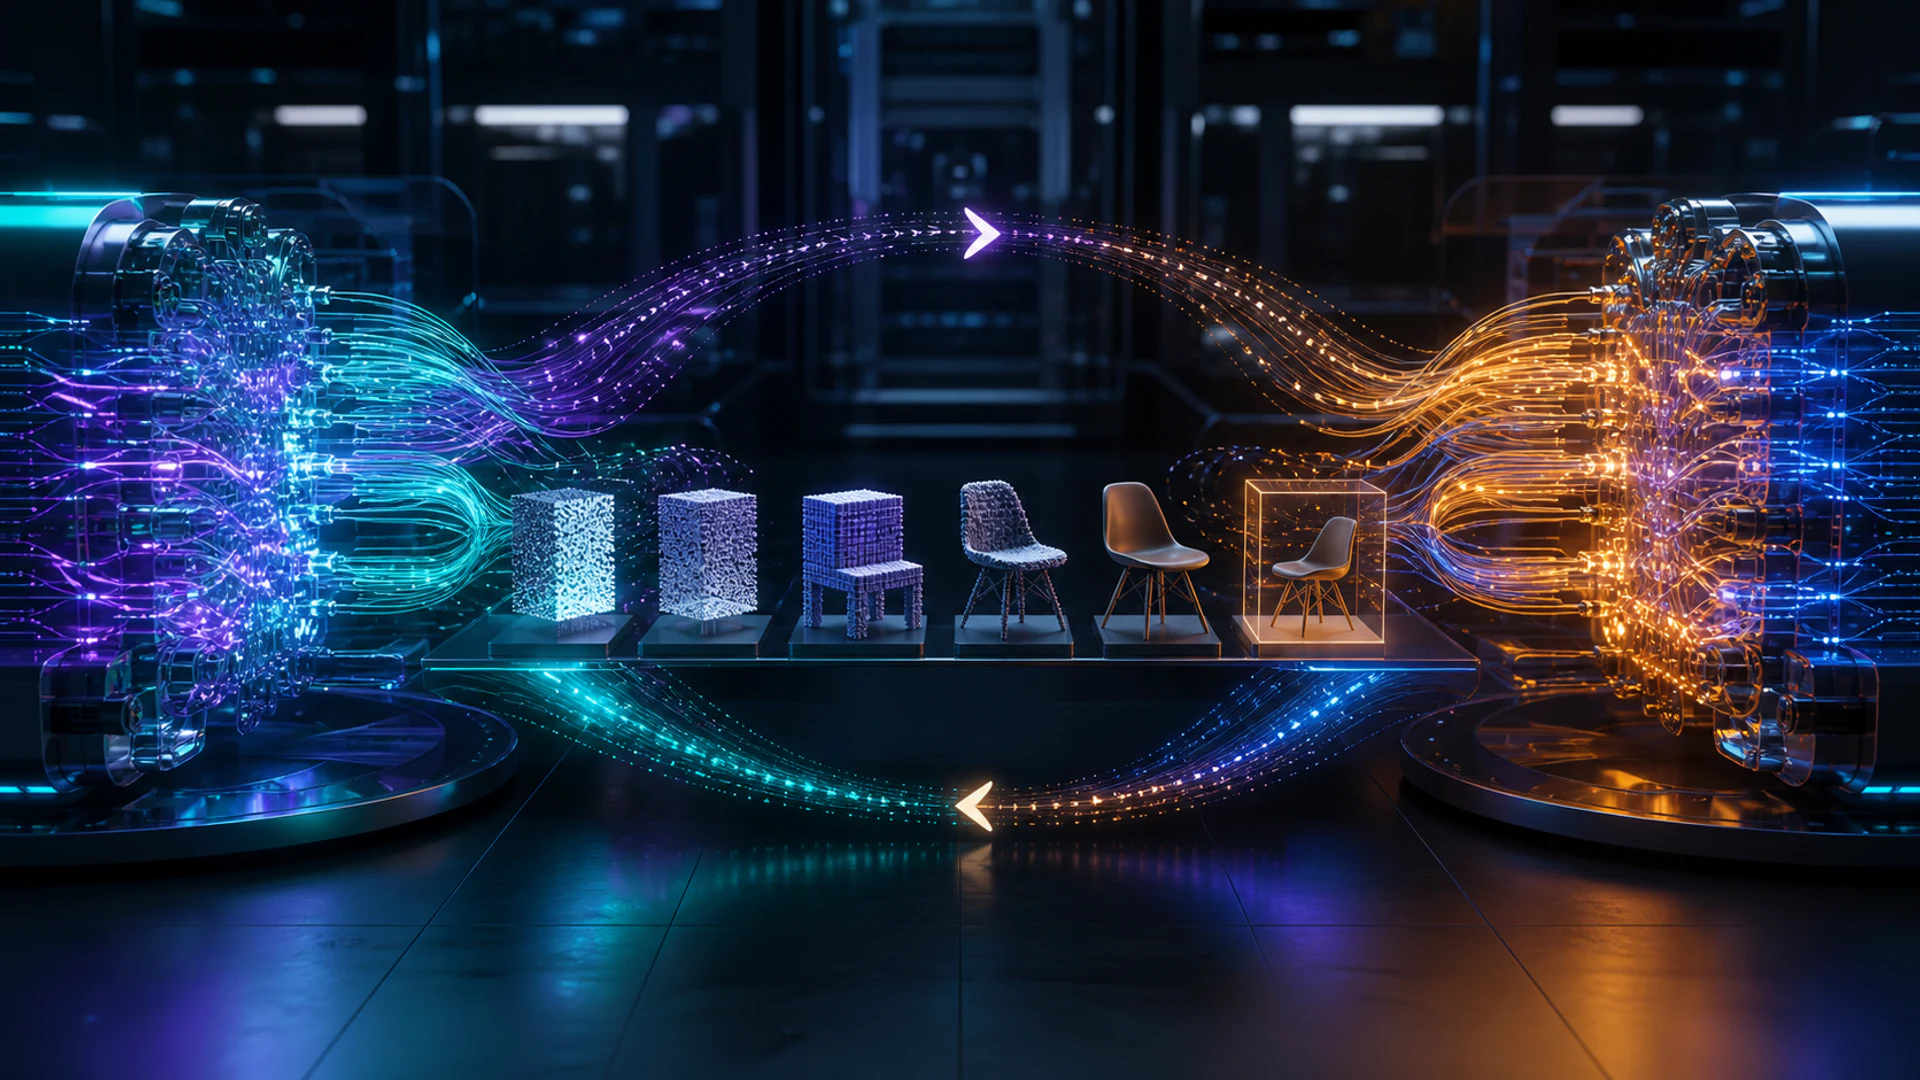
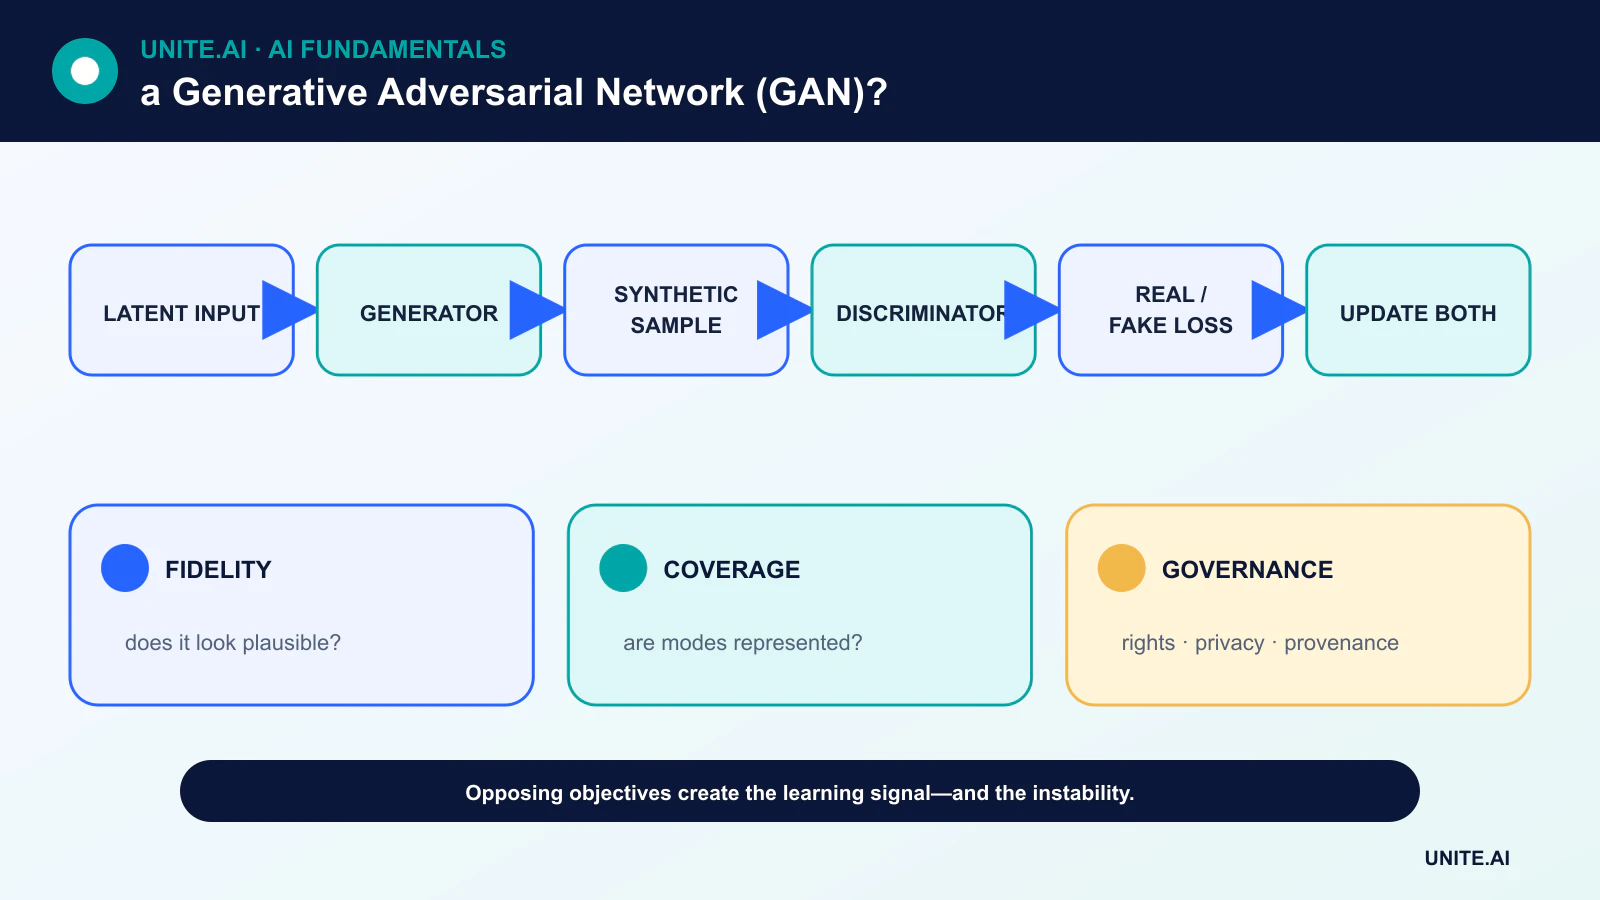
Sieć generatywna przeciwna (GAN) trenuje dwie sieci neuronowe w rywalizacji. Generator przekształca losowe lub warunkowane wejście w syntetyczne próbki. Dyskryminator próbuje odróżnić wygenerowane próbki od rzeczywistych przykładów treningowych. Informacje zwrotne każdej sieci zmieniają problem uczenia drugiej.
GAN‑y mogą tworzyć ostre obrazy i kontrolowane dane syntetyczne, ale trening przeciwny jest trudny do ustabilizowania. Realizm wizualny nie jest dowodem na różnorodność, prawdziwość faktów ani na uprawnienie do wykorzystania danych treningowych.
Kluczowe wnioski
- Generator wytwarza próbki; dyskryminator uczy się sygnału decyzyjnego rozróżniającego prawdziwe od wygenerowanych.
- Trening dąży do równowagi, ale zmiana przeciwników może powodować niestabilność, oscylacje lub zapaść trybu.
- Warunkowe GAN‑y kontrolują generowanie przy użyciu etykiet, tekstu lub innego kontekstu.
- Ocena powinna testować wierność, pokrycie, zapamiętywanie oraz ryzyko downstream, a nie jedynie jakość obrazu.
Gra przeciwna
Oryginalna formuła to gra dwugraczowa minimaksowa. Dyskryminator doskonali się w oddzielaniu rzeczywistych danych od wygenerowanych, podczas gdy generator udoskonala tworzenie próbek, które dyskryminator klasyfikuje jako prawdziwe. Obie sieci są trenowane metodą wstecznej propagacji.
Jeśli dyskryminator stanie się zbyt dokładny, jego informacja zwrotna dla generatora może być nieprzydatna. Jeśli jest zbyt słaby, generator może wykorzystać proste obejścia. Dlatego trening naprzemiennie aktualizuje sieci i starannie równoważy pojemność, straty oraz ustawienia optymalizacji.
Zapaść trybu i stabilność treningu
Zapaść trybu występuje, gdy wiele ukrytych wejść generuje podobne wyjścia, więc próbki wydają się wiarygodne, ale obejmują jedynie część rozkładu danych. Inne awarie to oscylacje, eksplodujące gradienty oraz wrażliwość na losową inicjalizację.
Cele Wassersteina, kary gradientowe, normalizacja spektralna, zmiany architektury oraz dostrojone współczynniki aktualizacji mogą poprawić stabilność. Nie eliminują one konieczności sprawdzania różnorodności i powtarzania eksperymentów z wieloma ziarnami losowości.
Generowanie warunkowe i kontrola ukrytej przestrzeni
Warunkowy GAN dostarcza generatorowi i dyskryminatorowi etykietę lub inny kontekst, umożliwiając generowanie określonych klas lub atrybutów. Architektury oparte na stylu oddzielają aspekty kontroli ukrytej przestrzeni na różnych rozdzielczościach i generują bardzo realistyczne obrazy.
Kierunki w ukrytej przestrzeni mogą korelować z pojęciami ludzkimi, ale edycja jednego atrybutu może zmienić inne, ponieważ dane treningowe zawierają skorelowane cechy. Twierdzenia o kontrolowalności powinny być testowane na różnorodnych tożsamościach i kontekstach.
Ewaluacja, prywatność i pochodzenie
Metryki takie jak Fréchet Inception Distance porównują rozkłady cech, ale dziedziczą założenia z modelu cech i mogą przeoczyć zapamiętywanie lub awarie podgrup. Analiza najbliższych sąsiadów, testy pokrycia w stylu precyzja/recall oraz przegląd ludzki dostarczają uzupełniających dowodów.
GAN może zapamiętać rzadkie przykłady, odtworzyć uprzedzenia lub generować wprowadzające w błąd media. Zespoły powinny dokumentować zestawy danych, prawa, filtrowanie, mechanizmy znaków wodnych lub pochodzenia oraz kontrolę nadużyć. Dane syntetyczne nie są automatycznie anonimowe.
GAN‑y, VAE‑y i modele dyfuzji
Wariacyjne autoenkodery optymalizują cel ukrytej przestrzeni oparty na prawdopodobieństwie i często wymieniają ostrość próbek na ustrukturyzowaną przestrzeń ukrytą. Modele dyfuzji uczą się odwracać proces szumowania i stały się powszechną podstawą generowania obrazów.
GAN‑y pozostają przydatne, gdy istotne są szybkie jednoprzebiegowe próbkowanie, konkretne mapowania obraz‑na‑obraz lub kompaktowe wdrożenie. Odpowiednia metoda zależy od jakości, różnorodności, opóźnienia, stabilności treningu i zarządzania — nie od tego, która architektura jest najnowsza.
Cele przeciwne i dynamika treningu
Generatywna sieć przeciwna trenuje generator, aby wytwarzał próbki, oraz dyskryminator, aby odróżniał wygenerowane od rzeczywistych danych. W oryginalnej grze minimaksowej dyskryminator szacuje sygnał związany ze stosunkiem gęstości, a generator stara się go oszukać. Trening naprzemiennie aktualizuje sieci, więc każda z nich uczy się przeciwko zmieniającemu się przeciwnikowi, a nie stałej funkcji straty. Jeśli dyskryminator stanie się zbyt silny, gradienty generatora mogą stać się nieprzydatne; jeśli jest zbyt słaby, jakość generowanych próbek stagnuje. Sama wartość straty nie odpowiada bezpośrednio jakości próbki.
Zapaść trybu występuje, gdy generator wytwarza ograniczoną liczbę wariantów, które oszukują dyskryminator. Częste są także oscylacje, wrażliwość na hiperparametry oraz niestabilna normalizacja. Cele Wassersteina, kary gradientowe, normalizacja spektralna, dopasowanie cech, statystyki mini‑batch oraz starannie zrównoważone harmonogramy aktualizacji rozwiązują różne mechanizmy awarii. Warunkowe GAN‑y wykorzystują etykiety, tekst lub obrazy do kierowania wyjściem; architektury oparte na stylu oddzielają wpływy ukrytej przestrzeni. Jakość i pokrycie zestawu danych pozostają kluczowe, ponieważ generator odtwarza i recombinuje obserwowany rozkład.
Ewaluacja i odpowiedzialne użycie
Ocena wierności i różnorodności powinna być przeprowadzana oddzielnie. Fréchet Inception Distance porównuje rozkłady cech, ale zależy od wielkości próbki, modelu cech, przetwarzania wstępnego i domeny; Inception Score pomija porównanie z rzeczywistymi danymi. Precyzja i recall dla modeli generatywnych, analiza najbliższych sąsiadów, kontrole zapamiętywania oraz ocena zadaniowa przez ludzi dostarczają dodatkowych dowodów. W przypadku syntezy naukowej lub medycznej używaj metryk domenowych i walidacji downstream. Trzymaj odrębny zestaw rzeczywistych danych i porównuj z modelami dyfuzji lub autoregresyjnymi przy równym nakładzie obliczeniowym i rozdzielczości.
GAN‑y mogą augmentować dane, tłumaczyć domeny, super‑rozwiązywać obrazy, syntetyzować media i wspierać symulacje, ale dane syntetyczne mogą nasilać uprzedzenia lub wyciekać przykłady treningowe. Weryfikuj licencje, zgodę, tożsamość i pochodzenie. Chroń przed niezgodnym z prawem podszywaniem się i wprowadzającym w błąd użyciem, oznaczaj lub podpisuj wyniki tam, gdzie to stosowne, i zachowuj metadane generacji. Fotorealistyczny obraz nie jest dowodem dokumentacyjnym; niepewność i syntetyczne pochodzenie muszą pozostać widoczne, gdy wyniki wpływają na decyzje.
Wdrożenie i reprodukowalność
Rejestruj generator, dyskryminator, optymalizator, zestaw danych, losowe ziarno, przycięcie i ustawienia próbkowania. Kwantyzacja lub eksport mogą zmienić normalizację i wyjście, więc zweryfikuj artefakt serwujący. Monitoruj rozkład podpowiedzi lub warunków, filtry bezpieczeństwa, różnorodność wyjść, opóźnienia i raporty. Stosuj limity szybkości i zabezpieczenia tożsamości w systemach publicznych. Trening GAN‑ów to sprzężony eksperyment optymalizacyjny: wybrane przykładowe obrazy nie mogą potwierdzić odporności, pokrycia ani braku zapamiętywania, a model powinien być oceniany na pełnym rozkładzie zamierzonych zadań generacyjnych.
Przykład praktyczny: syntetyczne obrazy defektów z użyciem GAN
Producent trenuje warunkowy GAN do tworzenia rzadkich obrazów defektów powierzchniowych. Weryfikuje, że obrazy treningowe posiadają prawa i oddziela partie produkcyjne przed treningiem i ewaluacją. Wygenerowane próbki są sprawdzane pod kątem zapamiętywania najbliższych sąsiadów, geometrii defektu, artefaktów tła, różnorodności oraz wiarygodności ocenianej przez ekspertów. Klasyfikator wytrenowany z augmentacją syntetyczną jest oceniany wyłącznie na niezależnych rzeczywistych defektach, w porównaniu z tym samym klasyfikatorem z tradycyjną augmentacją.
Dane syntetyczne są akceptowane jedynie wtedy, gdy rzeczywiste przypomnienie (recall) poprawia się bez zwiększania liczby fałszywych odrzuceń lub błędów podgrup. Ustawienia generacji i pochodzenie pozostają dołączone do każdego obrazu, a syntetyczne pliki nigdy nie trafiają do zestawu testowego ani archiwum dowodów jako rzeczywiste inspekcje. Operatorzy nie mogą używać generatora do fałszowania zapisów audytowych. Zespół porównuje alternatywy dyfuzji oraz koszt zbierania większej liczby rzeczywistych przykładów, zdając sobie sprawę, że realistyczny wygląd nie dowodzi, że GAN uchwycił fizyczny proces awarii.
Dowody wdrożeniowe i gotowość operacyjna
Decyzja produkcyjna wymaga więcej niż udanej demonstracji. Zdefiniuj docelowych użytkowników, środowisko operacyjne, wejścia, wyjścia, zależności, właściciela oraz konsekwencje każdego istotnego błędu. Ustal reprodukowalną bazę i wersjonowany zestaw ewaluacyjny przed dostrojeniem. Testuj typowe przypadki, warunki brzegowe, nieprawidłowe lub brakujące dane wejściowe, przesunięcie rozkładu, awarie zależności, nadużycia oraz grupy lub środowiska najczęściej niedoszacowane. Mierz jakość zadania wraz z kalibracją lub niepewnością, opóźnieniem, przepustowością, kosztami zasobów, dostępnością, prywatnością i bezpieczeństwem. Zapisz każdą transformację i próg, aby niezależny recenzent mógł odtworzyć wynik i odróżnić dowód od atrakcyjnego prototypu.
Przed uruchomieniem przydziel uprawnienia do wydania, wyjątków, zmian, wycofania i wycofania. Stosuj etapowe wdrażanie, zachowaj bezpieczną alternatywę i zweryfikuj monitorowanie poprzez celowo wprowadzane awarie. Telemetria operacyjna powinna ujawniać jakość danych wejściowych, zachowanie wyjść, wersję modelu lub reguły, stan zależności, interwencje ludzkie oraz potwierdzone wyniki, nie gromadząc niepotrzebnych danych wrażliwych. Zdefiniuj progi alarmowe i właściciela reakcji, a następnie przeglądaj dowody z rzeczywistego świata po wdrożeniu, zamiast zakładać, że offline’owa wydajność utrzyma się. Ponownie oceniaj, gdy zmienią się źródła danych, użytkownicy, modele, dostawcy, polityki, sprzęt lub cele. Utrzymany system wymaga także udokumentowanego przywracania, uczenia się z incydentów, procedur usuwania i przechowywania oraz jasno określonego momentu, w którym powinien zostać wyłączony lub zastąpiony.
Najczęściej zadawane pytania
Czy GAN rozumie obrazy, które tworzy?
GAN uczy się struktury statystycznej przydatnej do generowania. To nie oznacza, że posiada ludzkie rozumienie semantyczne lub przyczynowo‑skutkowe.
Czy próbki wygenerowane przez GAN są bezpieczne do wykorzystania jako dane treningowe?
Tylko po sprawdzeniu pokrycia, poprawności etykiet, zapamiętywania, uprzedzeń oraz tego, czy syntetyczny rozkład pomaga na rzeczywistym, odłożonym zestawie testowym.
Podstawowe źródła












