
Podstawy AI
Czym jest uczenie zespołowe?

 Dodaj Unite.AI do preferowanych źródeł w Google
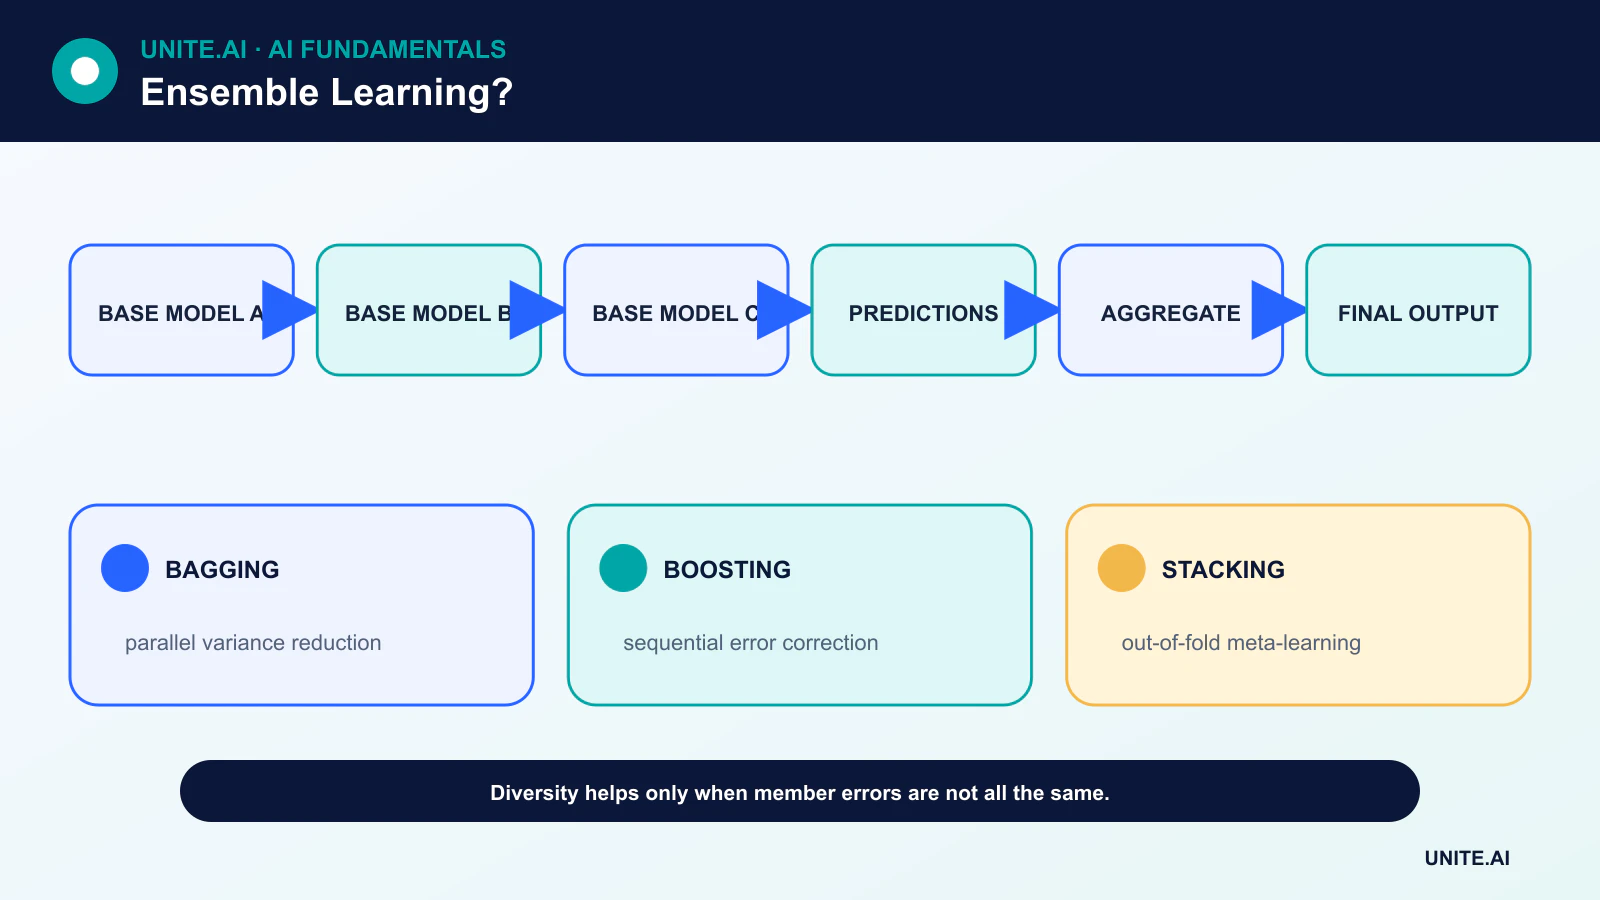
Uczenie zespołowe łączy prognozy z wielu modeli. Główną ideą jest to, że modele z różnymi błędami mogą dawać dokładniejszy lub bardziej stabilny wynik, gdy ich wyjścia są uśredniane, głosowane lub przekazywane meta‑uczącemu.
Dodanie modeli nie wystarczy. Jeśli każdy członek nauczył się tego samego skrótu, ich błędy będą skorelowane i zespoł może po prostu stać się bardziej pewny tego samego błędu.
Kluczowe wnioski
- Zespoły działają najlepiej, gdy modele członkowskie są użyteczne indywidualnie i popełniają znacząco różne błędy.
- Bagging trenuje członków równolegle na danych z próbkowaniem zwrotnym; boosting trenuje uczące się kolejno, aby korygować błędy.
- Stacking trenuje meta‑model na prognozach out‑of‑fold, a nie na prognozach w‑próbie.
- Zyski w dokładności należy ważyć wobec opóźnień, kalibracji, interpretowalności i kosztów utrzymania.
Głosowanie i uśrednianie
Twarde głosowanie wybiera klasę z największą liczbą głosów. Miękkie głosowanie uśrednia prawdopodobieństwa klas, zazwyczaj po kalibracji. Zespoły regresyjne często uśredniają prognozy liczbowe. Wersje ważone dają większy wpływ silniejszym członkom.
Uśrednienie może zmniejszyć wariancję, gdy błędy nie są idealnie skorelowane. Nie może naprawić wspólnej wady danych, błędu etykiety ani brakującej podgrupy. Różnorodność powinna być mierzona poprzez niezgodność i nakładanie się błędów, a nie zakładana na podstawie różnych nazw modeli.
Bagging i lasy losowe
Bootstrap aggregating trenuje modele na zestawach danych z próbkowaniem zwrotnym i uśrednia je. Drzewo decyzyjne ma wysoką wariancję, co czyni je naturalnym kandydatem do baggingu.
Lasy losowe dodają losowy wybór cech przy podziałach, zmniejszając korelację między drzewami. Przykłady out‑of‑bag mogą szacować wydajność, ale ostateczny nieużywany zestaw testowy pozostaje cenny przy wyborze modelu i roszczeniach dotyczących wdrożenia.
Boosting
Boosting buduje model addytywny etapami. Późniejsze uczące się koncentrują się na przykładach lub wzorcach resztkowych, które bieżący zespół obsługuje słabo. AdaBoost zmienia wagi przykładów; gradient boosting dopasowuje uczące się do ujemnych gradientów wybranej funkcji straty.
Drzewa boostowane mogą modelować złożone zależności tabelaryczne, ale głębokie drzewa, nadmierna liczba iteracji i wycieki mogą nadal przeuczyć się. Wskaźnik uczenia, głębokość drzewa, podpróbkowanie i wczesne zatrzymanie są kluczowymi parametrami.
Stacking i blending
Stacking tworzy model drugiego poziomu, który uczy się, jak łączyć prognozy bazowe. Aby uniknąć wycieku, każdy wiersz treningowy dla meta‑modelu musi pochodzić z modelu bazowego, który nie był na nim trenowany. Walidacja krzyżowa generuje te prognozy out‑of‑fold.
Blending wykorzystuje osobny zestaw odłożony (holdout) dla meta‑modelu, co jest prostsze, ale zmniejsza ilość danych dostępnych do treningu. Oba podejścia wymagają takiego samego przetwarzania wstępnego i kontroli wersji przy inferencji.
Kompromisy operacyjne
Zespół może pomnożyć zużycie pamięci, mocy obliczeniowej i liczbę trybów awarii. Może być trudniejszy do wyjaśnienia, skalibrowania i spójnej aktualizacji. Destylacja może skompresować zespół do mniejszego modelu, ale uczeń musi być oceniany niezależnie.
Praktyczny wybór porównuje wydajność, opóźnienie w ogonie, kalibrację, zużycie zasobów i koszt błędów. Czasami jeden dobrze uregulowany model jest lepszy niż niewielki przyrost dokładności uzyskany dzięki kruchemu stosowi.
Dlaczego zespoły działają
Uczenie zespołowe łączy wiele modeli, tak aby ich błędy częściowo się znosiły lub ich mocne strony pokrywały różne obszary. Bagging trenuje modele na danych z próbkowaniem zwrotnym i uśrednia prognozy, zmniejszając wariancję; lasy losowe dodają losowy wybór cech, aby odkorelować drzewa. Boosting trenuje uczące się kolejno, koncentrując się na błędach resztkowych, często zmniejszając bias, ale zwiększając wrażliwość na szum i strojenie. Stacking trenuje meta‑model na prognozach modeli bazowych. Różnorodność musi być użyteczna: uśrednianie identycznych modeli zwiększa koszty bez znaczącej redukcji błędów.
Korelacja między błędami określa korzyść. Różnorodność może wynikać z próbek danych, cech, algorytmów, hiperparametrów, losowej inicjalizacji lub okien czasowych. Twarde głosowanie odrzuca pewność; miękkie głosowanie uśrednia prawdopodobieństwa, ale wymaga kompatybilnej kalibracji. Regresja może uśredniać lub stosować solidną agregację. W stackingu prognozy out‑of‑fold są niezbędne — trenowanie meta‑modelu na prognozach bazowych pochodzących z tych samych dopasowanych danych powoduje wyciek. Zachowaj prostą bazę uśredniania przed przyjęciem złożonego łącznika.
Ewaluacja, kalibracja i niepewność
Porównaj każdego członka i zespół na odłożonym zestawie z identycznym przetwarzaniem wstępnym. Zgłoś metryki zadania, kalibrację, błędy podgrup, wariancję pomiędzy fałdami lub nasionami oraz koszt zasobów. Zespół może podnieść średnią jakość, jednocześnie maskując wspólny punkt ślepy spowodowany wspólnymi danymi lub etykietami. Zbadaj niezgodność: może ona wskazywać niepewność, ale skorelowane modele pewnie błędne mogą się zgadzać. Skalibruj ostateczny zespół, nie tylko członków, i zweryfikuj progi abstynencji względem zdolności przeglądu i konsekwencji.
Szacunki out‑of‑bag są przydatne dla modeli bagowanych, ale nie zastępują ostatecznego testu reprezentatywnego dla wdrożenia. W przypadku danych czasowych unikaj próbkowania, które łamie kolejność. W zastosowaniach związanych z bezpieczeństwem testuj awarie członków, przestarzałe modele i wejścia adversarialne. Ważone zespoły mogą przeuczyć się na danych walidacyjnych, gdy testuje się wiele kandydatów. Rejestruj wybór kandydatów i stosuj zagnieżdżoną walidację przy intensywnym strojeniu.
Serwowanie i utrzymanie
Zespoły zwiększają zużycie pamięci, opóźnienia, energii i zależności operacyjne. Destylacja może skompresować połączone zachowanie do jednego modelu, z nowym wymogiem walidacji. Wersjonuj członków, przetwarzanie wstępne, wagi i routing jako jeden artefakt; określ zachowanie, gdy członek przekroczy limit czasu lub zwróci nieprawidłowy wynik. Monitoruj prognozy członków i niezgodność, aby niewidzialne awarie były widoczne. Wycofaj zbędnych członków i celowo przeprowadzaj ponowne treningi. Zespoły poprawiają prognozy, gdy różnorodność błędów jest rzeczywista, ale nie przekształcą stronniczych danych treningowych ani nieprawidłowego celu w wiarygodny dowód.
Przykład praktyczny: zespół dla ostrzeżeń o ekstremalnej pogodzie
Zespół prognozujący łączy zestaw cech modelu fizycznego, drzewo gradient‑boostowane, model sekwencyjny neuronowy oraz skalibrowaną bazę statystyczną. Prognozy out‑of‑fold trenują prosty meta‑model, a ewaluacja wykorzystuje przyszłe burze całkowicie wykluczone z treningu członków. Metryki obejmują przywołanie zdarzeń, fałszywe alarmy, czas wczesnego ostrzeżenia, kalibrację, wydajność geograficzną i niezawodność w rzadkich warunkach ekstremalnych. Badana jest korelacja błędów członków, ponieważ wspólne dane wejściowe mogą tworzyć wspólne punkty ślepe.
Serwis zachowuje każdą prognozę oraz wynik łączony. Jeśli któryś członek jest niedostępny, system używa wcześniej zwalidowanej, degradowanej konfiguracji zamiast cichego renormalizowania. Niezgodność wywołuje dodatkowy przegląd, ale nie jest traktowana jako niepewność we wszystkich przypadkach. Monitorowanie śledzi dryf członków, opóźnienia i wyniki burz, przy czym wagi aktualizowane są wyłącznie poprzez kontrolowaną walidację. Publiczne ostrzeżenia pozostają w ramach autoryzowanych procesów decyzyjnych meteorologii; zespół poprawia dowody, ale nie redefiniuje autonomicznie polityki alarmowej.
Dowody implementacyjne i gotowość operacyjna
Decyzja produkcyjna wymaga więcej niż udanego demonstracji. Zdefiniuj docelowych użytkowników, środowisko operacyjne, dane wejściowe, wyjściowe, zależności, właściciela oraz konsekwencje każdego istotnego błędu. Ustal powtarzalną bazę i wersjonowany zestaw ewaluacyjny przed strojeniem. Testuj typowe przypadki, warunki brzegowe, nieprawidłowe lub brakujące dane, zmianę rozkładu, awarię zależności, niewłaściwe użycie oraz grupy lub środowiska najprawdopodobniej niedoszacowane. Mierz jakość zadania wraz z kalibracją lub niepewnością, opóźnieniem, przepustowością, kosztem zasobów, dostępnością, prywatnością i bezpieczeństwem. Rejestruj każdą transformację i próg, aby niezależny recenzent mógł odtworzyć wynik i odróżnić dowody od atrakcyjnego prototypu.
Przed uruchomieniem przydziel uprawnienia do wydania, wyjątków, zmian, wycofywania i wycofania. Użyj etapowego wdrożenia, zachowaj bezpieczną rezerwę i zweryfikuj monitorowanie przy celowo wprowadzonych awariach. Telemetria operacyjna powinna ujawniać jakość danych wejściowych, zachowanie wyjść, wersję modelu lub reguły, stan zależności, interwencje ludzkie oraz potwierdzone wyniki, nie gromadząc niepotrzebnych wrażliwych danych. Zdefiniuj progi alarmowe i właściciela reakcji, a następnie przeglądaj dowody z rzeczywistego świata po wdrożeniu, zamiast zakładać, że offline’owa wydajność utrzyma się. Przeprowadzaj ponowną ocenę przy każdej zmianie źródeł danych, użytkowników, modeli, dostawców, polityk, sprzętu lub celów. Utrzymany system wymaga także udokumentowanego odzyskiwania, nauki z incydentów, procedur usuwania i przechowywania oraz wyraźnego punktu, w którym powinien zostać wyłączony lub zastąpiony.
Najczęściej zadawane pytania
Czy las losowy jest zespołem?
Tak. Łączy wiele losowo zbudowanych drzew decyzyjnych, zazwyczaj poprzez głosowanie lub uśrednianie.
Czy identyczne modele mogą tworzyć użyteczny zespół?
Mogą, jeśli dane treningowe, inicjalizacja lub próbkowanie generują wystarczająco różne błędy, ale prosta duplikacja nie przynosi korzyści.
Podstawowe źródła












