Podstawy AI
Czym są maszyny wektorów nośnych?

 Dodaj Unite.AI do preferowanych źródeł w Google
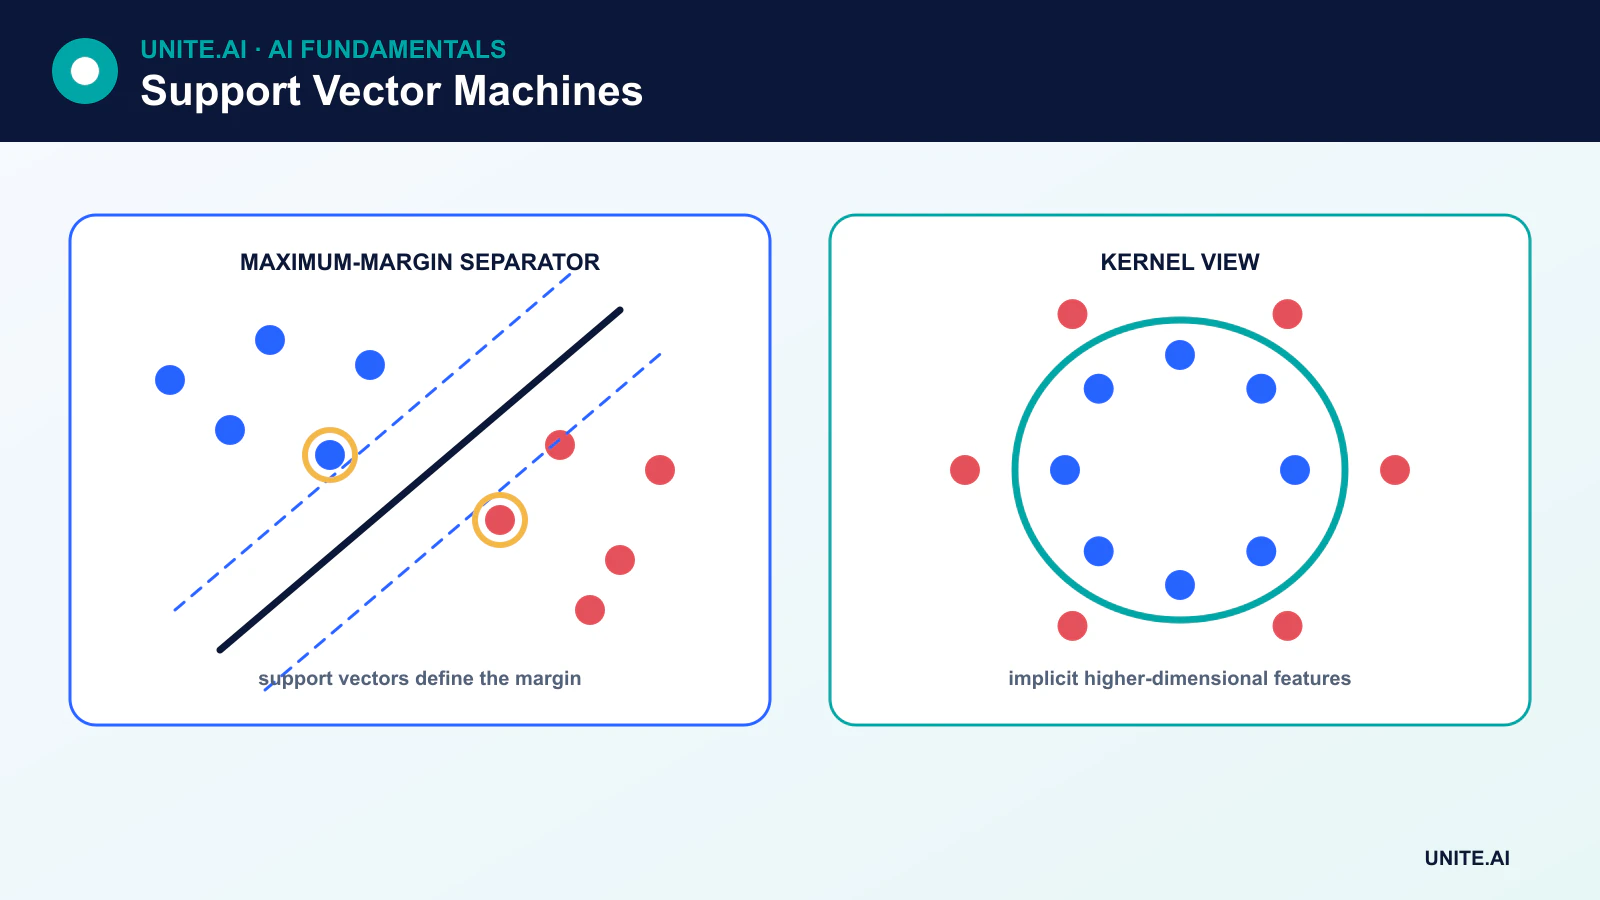
Maszyna wektorów nośnych (SVM) to metoda uczenia nadzorowanego, która znajduje granicę decyzyjną o możliwie największym marginesie pomiędzy klasami. Przykłady treningowe, które określają tę granicę, to wektory nośne.
SVM mogą wykonywać klasyfikację liniową lub nieliniową, regresję oraz wykrywanie nowości. Są szczególnie przydatne przy małych i średnich zbiorach danych z informatywnymi cechami, w tym przy wysokowymiarowych danych rzadkich, jednak koszt ich trenowania może stać się niepraktyczny przy bardzo dużych zbiorach danych.
Kluczowe wnioski
- SVM maksymalizuje minimalny margines pomiędzy granicą a najbliższymi punktami treningowymi.
- Wektory nośne są punktami danych, a nie dodatkowymi hiperpłaszczyznami.
- Parametr C równoważy szerokość marginesu z karami za naruszenia.
- Jądra obliczają podobieństwo w implicitnej przestrzeni cech, nie materializując explicite każdej przekształconej cechy.
Idea maksymalnego marginesu
Dla liniowego klasyfikatora binarnego granica decyzyjna jest hiperpłaszczyzną:
w · x + b = 0
Wektor w określa orientację, a b przesunięcie. Wiele hiperpłaszczyzn może oddzielać klasy treningowe. SVM wybiera tę, która maksymalizuje odległość do najbliższych przykładów po obu stronach. Te najbliższe przykłady to wektory nośne i mają największy wpływ na dopasowaną granicę.
Celem nie jest maksymalizacja odległości od granicy do każdego punktu osobno. SVM maksymalizuje minimalny margines, jednocześnie spełniając lub karząc za naruszenia ograniczeń klasowych.
Twarde i miękkie marginesy
SVM z twardym marginesem wymaga idealnego liniowego rozdzielenia i jest wrażliwy na wartości odstające. W rzeczywistych zbiorach danych zazwyczaj potrzebny jest miękki margines, który wprowadza zmienne luzu dla obserwacji znajdujących się wewnątrz marginesu lub po niewłaściwej stronie granicy.
Hipermetr C kontroluje karę za te naruszenia:
- Większe C kara za naruszenia jest silniejsza i często prowadzi do węższego marginesu, który ściślej podąża za przykładami treningowymi.
- Mniejsze C pozwala na więcej naruszeń w zamian za szerszy, bardziej zregularizowany margines.
Liczba wektorów nośnych jest wynikiem danych i rozwiązania; zwiększenie C nie gwarantuje określonej liczby wektorów nośnych.
Sztuczka jądra
Niektóre klasy nie mogą być oddzielone prostą hiperpłaszczyzną w oryginalnej przestrzeni cech. Jądro ocenia iloczyn skalarny odpowiadający innej przestrzeni cech. Dzięki temu SVM może dopasować nieliniową granicę bez explicite obliczania każdej przekształconej współrzędnej.
Typowe jądra obejmują:
- Linear: efektywne dla wysokowymiarowych rzadkich cech, takich jak tekst.
- Polynomial: modeluje interakcje do wybranego stopnia.
- Radial basis function (RBF): tworzy elastyczne lokalne granice oparte na odległości.
- Sigmoid: przypomina aktywację neuronową, ale rzadziej jest wyborem domyślnym.
Dla SVM z jądrem RBF, gamma kontroluje, jak lokalnie każdy przykład treningowy wpływa na granicę. Duża wartość gamma może tworzyć bardzo szczegółowe regiony i przeuczyć; mała gamma powoduje łagodniejszy wpływ.
Klasyfikacja wieloklasowa
Klasyczna funkcja celu SVM jest binarna. Biblioteki rozszerzają ją, stosując strategie takie jak one-vs-rest, które trenują jeden klasyfikator dla każdej klasy, lub one-vs-one, które trenują klasyfikatory dla par klas i łączą ich decyzje. SVM wieloklasowe nie rysują po prostu jednej linii mniej niż liczba klas.
Regresja wektorów nośnych i SVM jednowarstwowy (one-class)
Regresja wektorów nośnych (SVR) dopasowuje funkcję, ignorując błędy wewnątrz rury o szerokości epsilon i karząc większe odchylenia. SVM jednowarstwowy (one-class) szacuje granicę wokół typowych danych i może wspierać wykrywanie nowości. Nietypowy punkt nie jest automatycznie oszustwem lub awarią; jest nietypowy w kontekście dopasowanej reprezentacji.
Wymagania praktyczne
SVM opierają się na odległościach i iloczynach skalarnych, dlatego cechy numeryczne zazwyczaj wymagają skalowania. C, jądro, gamma i wagi klas powinny być wybierane poprzez walidację. Szacowanie prawdopodobieństwa nie jest inherentne dla marginesu i często wymaga kalibracji, co zwiększa koszty i powinno być oceniane osobno.
Trenowanie SVM z jądrem może skalować się od czasu kwadratowego do sześciennego w zależności od liczby próbek, w zależności od danych i implementacji. Warianty liniowych SVM lub stochastyczne modele liniowe są lepiej dopasowane do bardzo dużych zbiorów danych. W przypadku surowych obrazów, dźwięku lub języka, wyuczone reprezentacje z głębokiego uczenia mogą być skuteczniejsze, choć SVM nadal może klasyfikować stałe osadzenie.
Mocne i słabe strony SVM
SVM mogą dobrze radzić sobie z wieloma cechami, oferują przejrzysty zregularizowany cel i w czasie predykcji zależą głównie od wektorów nośnych. Ograniczenia obejmują wrażliwość na skalowanie i hiperparametry, potencjalnie kosztowne trenowanie, zmniejszoną interpretowalność przy nieliniowych jądrach oraz wymogi kalibracji prawdopodobieństwa.
Marginesy, jądra i funkcja optymalizacji
Maszyna wektorów nośnych dąży do znalezienia hiperpłaszczyzny rozdzielającej z dużym marginesem pomiędzy klasami. Tylko wektory nośne leżące na marginesie lub wewnątrz niego określają granicę. SVM z miękkim marginesem wprowadzają luz dla nakładania się i błędnie oznaczonych punktów; parametr C wymienia szerszy margines na naruszenia w treningu. Dane wejściowe zazwyczaj powinny być skalowane, ponieważ odległość i iloczyny skalarne napędzają rozwiązanie. Wagi klas lub resampling pomagają, gdy koszty błędów i ich częstość są nierówne, ale progi i prawdopodobieństwa nadal wymagają niezależnej walidacji.
Sztuczka jądra ocenia podobieństwo tak, jakby dane wejściowe były mapowane do wyższej wymiarowo przestrzeni cech. Jądra liniowe, wielomianowe, radialne i specjalistyczne kodują różne założenia. Dla jądra RBF gamma kontroluje, jak lokalnie każdy punkt wpływa na granicę: wysoka gamma może tworzyć złożone regiony i przeuczyć model, natomiast niska gamma może prowadzić do niedouczenia. Macierze jądra rosną kwadratowo wraz z liczbą próbek, co czyni nieliniowe SVM kosztownymi przy dużych zbiorach danych. Rozwiązania liniowe lub przybliżone mapy cech są często lepsze przy dużej skali.
Zastosowanie wieloklasowe, kalibracja i ograniczenia operacyjne
SVM binarne rozszerza się na wieloklasowe poprzez one-vs-rest, one-vs-one lub sformułowania strukturalne. Hiperparametry muszą być dostrojone w ramach walidacji krzyżowej, z podziałami grupowymi lub czasowymi w razie potrzeby. Należy ocenić precyzję i czułość dla poszczególnych klas, rozkłady marginesów, kalibrację oraz wydajność przy zmianach dystrybucji. Surowe wyniki decyzyjne nie są prawdopodobieństwami; skalowanie Platta lub kalibracja izotoniczna wykorzystują oddzielne dane i mogą pogorszyć się przy zmianie częstości. Porównaj z regresją logistyczną, drzewami i nowoczesnymi metodami opartymi na reprezentacjach przy równym nakładzie przetwarzania wstępnego i strojenia.
Serwisowanie wymaga dokładnego skalera, kolejności cech, parametrów jądra, wektorów nośnych i mapowania klas. Koszt predykcji dla SVM z jądrem rośnie wraz z liczbą wektorów nośnych, dlatego należy mierzyć opóźnienie i zużycie pamięci na realistycznych partiach. Dane wejściowe daleko od wektorów treningowych mogą nadal otrzymywać pewne etykiety; dodaj sprawdzenia poza rozkładem lub politykę wstrzymania, gdy to stosowne. Analizuj błędy pod kątem wrażliwych proxy i artefaktów zbioru danych. SVM pozostają silne dla problemów średniej wielkości i wysokiej wymiarowości, ale maksymalny margines geometryczny nie jest dowodem na strukturalną przyczynowość ani bezpieczeństwo.
Przykład praktyczny: SVM do rzadkiego kierowania dokumentów
Zespół ds. operacji prawnych klasyfikuje krótkie dokumenty do kategorii kierowania, wykorzystując cechy TF–IDF i liniowy SVM. Dzieli dane według sprawy i czasu, aby zapobiec wyciekom szablonów, skaluje wagi klas w oparciu o koszt błędów po przeglądzie i dostraja C w ramach zagnieżdżonej walidacji. Model liniowy jest porównywany z regresją logistyczną i transformatorem. Precyzja, czułość, kalibracja oraz obciążenie recenzentów dla poszczególnych klas mają większe znaczenie niż ogólna dokładność.
Wyniki decyzyjne są kalibrowane na oddzielnych danych, a dokumenty o niskim marginesie lub nieobsługiwanym języku trafiają do ręcznej obsługi. Artefakt serwisowy zawiera tokenizator, słownik, ważenie, model, kalibrację i mapę etykiet. Monitoring śledzi nowe terminy, częstość kategorii, marginesy i skorygowane trasy. Dokumenty i wektory nośne są chronione, ponieważ cechy tekstowe mogą ujawniać poufne informacje. Jądro nieliniowe jest odrzucane, gdy niewielki przyrost jakości nie uzasadnia opóźnień, zużycia pamięci i kosztu interpretacji.
Dowody wdrożeniowe i gotowość operacyjna
Decyzja o wdrożeniu wymaga więcej niż udanej demonstracji. Zdefiniuj docelowych użytkowników, środowisko operacyjne, wejścia, wyjścia, zależności, właściciela oraz konsekwencje każdego istotnego błędu. Ustal powtarzalną bazę odniesienia i wersjonowany zestaw oceny przed strojeniem. Testuj typowe przypadki, warunki brzegowe, niepoprawne lub brakujące dane wejściowe, zmianę rozkładu, awarie zależności, niewłaściwe użycie oraz grupy lub środowiska najprawdopodobniej niedostatecznie obsługiwane. Mierz jakość zadania wraz z kalibracją lub niepewnością, opóźnieniem, przepustowością, kosztami zasobów, dostępnością, prywatnością i bezpieczeństwem. Rejestruj każdą transformację i próg, aby niezależny recenzent mógł odtworzyć wynik i odróżnić dowody od atrakcyjnego prototypu.
Przed uruchomieniem przydziel odpowiedzialność za wydanie, wyjątki, zmiany, wycofanie i wycofanie wersji. Stosuj etapowe wdrażanie, zachowaj bezpieczną alternatywę i weryfikuj monitoring przy celowo wprowadzonych awariach. Telemetria operacyjna powinna ujawniać jakość danych wejściowych, zachowanie wyjść, wersję modelu lub reguły, stan zależności, interwencje ludzkie oraz potwierdzone wyniki, nie zbierając niepotrzebnych wrażliwych danych. Zdefiniuj progi alarmowe i właściciela reakcji, a następnie przeglądaj dowody z rzeczywistego środowiska po wdrożeniu, zamiast zakładać, że offline’owa wydajność się utrzyma. Przeprowadzaj ponowną ocenę przy zmianie źródeł danych, użytkowników, modeli, dostawców, polityk, sprzętu lub celów. Utrzymany system wymaga również udokumentowanego przywracania, nauki z incydentów, procedur usuwania i przechowywania oraz wyraźnego punktu, w którym powinien zostać wyłączony lub zastąpiony.
Najczęściej zadawane pytania
Czy SVM wykonują wyłącznie klasyfikację?
Nie. Regresja wektorów nośnych przewiduje wartości ciągłe, natomiast SVM jednowarstwowy może oszacować granicę nowości. Każda odmiana ma inny cel i zestaw hiperparametrów.
Kiedy liniowy SVM jest dobrym wyborem?
Liniowe SVM często są skuteczne przy wysokowymiarowych rzadkich cechach, w tym tradycyjnych reprezentacjach tekstu, gdzie elastyczne jądro zwiększa koszty bez wyraźnej korzyści.
Podstawowe źródła