
Podstawy AI
Czym jest regresja liniowa?

 Dodaj Unite.AI do preferowanych źródeł w Google
Regresja liniowa modeluje ciągły cel jako kombinację liniową jednej lub wielu cech wejściowych. Służy do prognozowania, szacowania oraz jako przejrzysta baza odniesienia, umożliwiająca ocenę, czy bardziej złożony model wnosi istotną wartość.
Słowa zmienna niezależna i zmienna zależna opisują role w modelu, a nie udowodnione przyczynowo‑skutkowe powiązanie. Regresja może wskazać zależność, podczas gdy zakłócenia, błąd selekcji, odwrotna przyczynowość lub błąd pomiaru wyjaśniają obserwowany związek.
Kluczowe wnioski
- Cel y jest modelowany na podstawie cech wejściowych X; starsza wersja artykułu odwróciła te etykiety w jednym wyjaśnieniu formuły.
- Metoda najmniejszych kwadratów (OLS) minimalizuje sumę kwadratów reszt.
- Diagnostyka reszt i założenia mają znaczenie dla wnioskowania i niepewności.
- Regularyzacja typu ridge i lasso pomaga, gdy predyktory są liczne lub skorelowane.
Prosta regresja liniowa
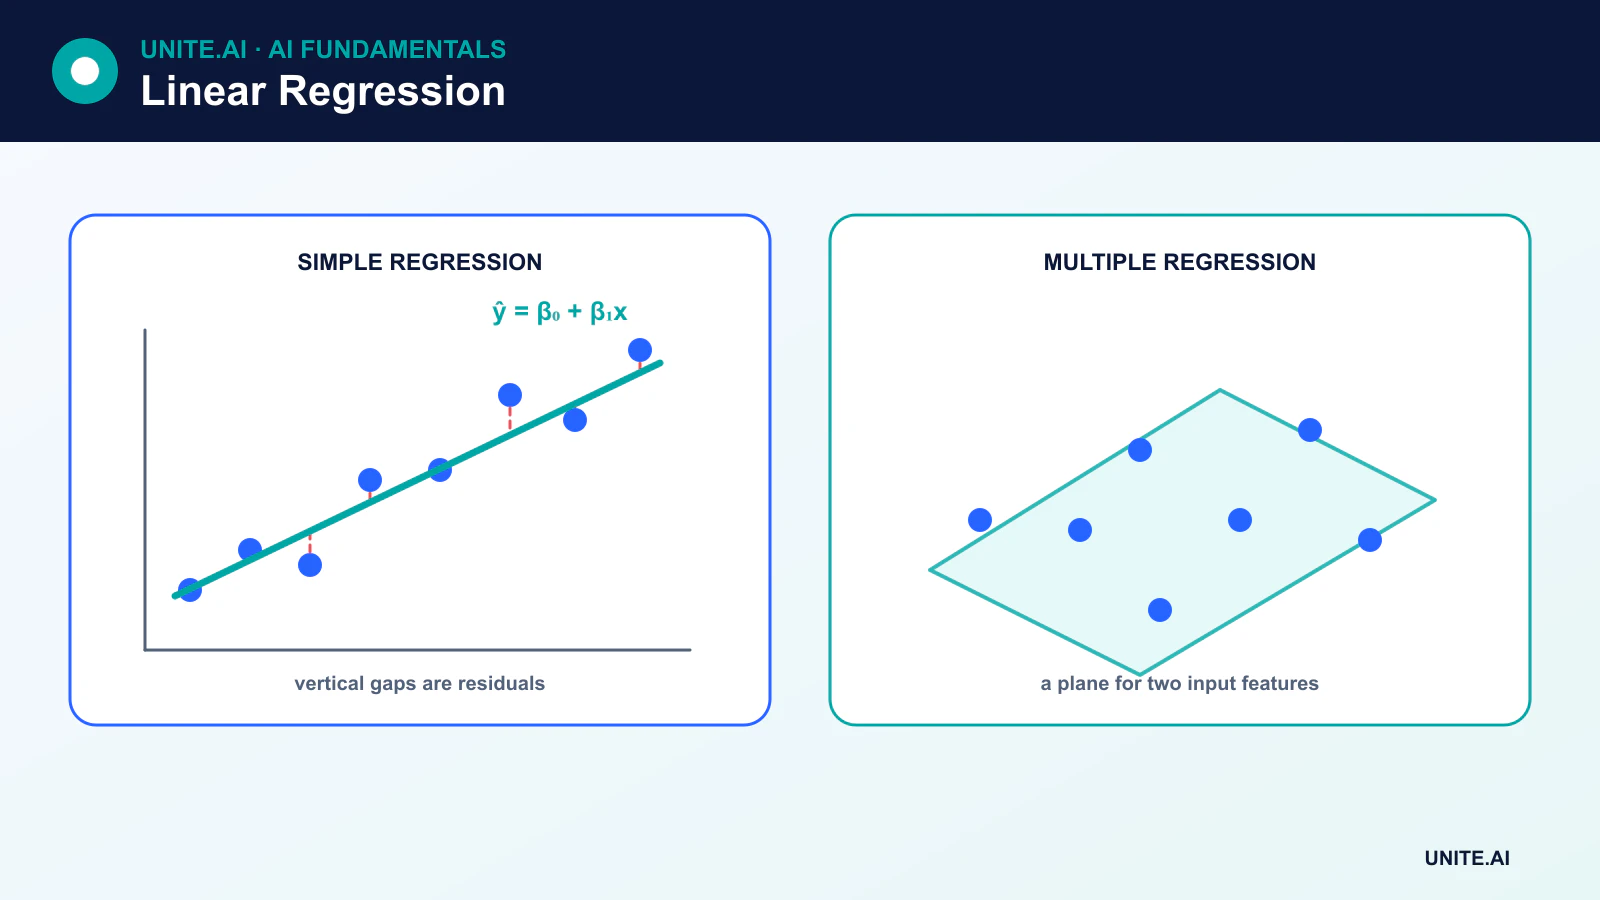
Przy jednej cesze model ma postać:
ŷ = β₀ + β₁x
β₀ jest wyrazem wolnym (przecięciem), a β₁ nachyleniem. Reszta dla obserwacji i wynosi yᵢ - ŷᵢ. Metoda najmniejszych kwadratów (OLS) wybiera współczynniki minimalizujące sumę kwadratów reszt.
Nachylenie szacuje oczekiwaną zmianę celu związaną ze zmianą cechy o jedną jednostkę w dopasowanym modelu. Nie powinno być opisywane jako efekt przyczynowy, chyba że projekt badania i założenia wspierają identyfikację przyczynowo‑szczególną.
Wielokrotna regresja liniowa
Przy p cechach:
ŷ = β₀ + β₁x₁ + β₂x₂ + … + βₚxₚ
Każdy współczynnik jest interpretowany warunkowo względem pozostałych uwzględnionych cech. Wielokrotna regresja może uwzględniać zmienne kategoryczne poprzez kodowanie, wyrazy wielomianowe i interakcje. Pozostaje „liniowa”, ponieważ jest liniowa względem współczynników, nawet jeśli włączone są przekształcone cechy, takie jak x².
Założenia i diagnostyka
W kontekście prognozowania kluczowe pytanie brzmi, jak dobrze model uogólnia. Dla klasycznych testów współczynników i przedziałów dodatkowe założenia stają się istotne:
- Liniowość: średnia warunkowa jest reprezentowana przez wybraną formę liniową.
- Niepodległe lub prawidłowo modelowane błędy: powtarzane, grupowane, przestrzenne lub szeregowe obserwacje mogą wymagać innej struktury błędów.
- Stała wariancja błędów: heteroskedastyczność wpływa na błędy standardowe i szacunki niepewności.
- Ograniczona wielokrotna kolinearity: silnie skorelowane predyktory powodują niestabilność poszczególnych współczynników.
- Rozkład reszt: normalność ma znaczenie w niektórych wnioskowaniach przy małych próbach, ale nie jest wymogiem, aby każda cecha była rozkładem normalnym.
Wykresy reszt, miary lewarowania i wpływu oraz przegląd dziedzinowy mogą wykrywać wartości odstające, nieliniowość, zmienność wariancji lub obserwacje, które dominują dopasowanie.
Ocena prognoz
- Średni błąd bezwzględny (MAE) średnia wielkość bezwzględnych reszt.
- Średni błąd kwadratowy (MSE) przyznaje większą wagę większym błędom.
- Pierwiastek z średniego błędu kwadratowego (RMSE) przywraca błąd kwadratowy do jednostek docelowych.
- R² porównuje zmienność reszt z stałą bazą na ocenianych danych.
R² nie jest miarą dokładności, nie ustala przyczynowości i może przyjmować wartości ujemne na danych odrzuconych. Walidacja powinna odzwierciedlać rzeczywiste warunki prognozowania, w tym podziały uwzględniające czas lub grupy, gdy jest to konieczne.
Ridge, lasso i elastic net
Regresja ridge dodaje karę L2, która ściąga współczynniki i stabilizuje skorelowane predyktory. Lasso wprowadza karę L1 i może ustawiać niektóre współczynniki na zero. Elastic net łączy oba podejścia. Cechy zazwyczaj wymagają odpowiedniego skalowania przed porównaniem tych kar.
Regularyzacja wprowadza bias w zamian za niższą wariancję i może zmniejszyć przeuczenie. Siła kary jest wybierana na podstawie walidacji, a nie zestawu testowego.
Kiedy regresja liniowa jest niewłaściwym narzędziem
Model liniowy może zawieść, gdy zależności są silnie nieliniowe, błędy zależą od wartości przeszłych, rozkłady celu wymagają specjalistycznego modelowania lub kilka wartości odstających dominuje kwadratową stratę. Drzewa decyzyjne, uogólnione modele liniowe, modele szeregów czasowych, regresja odporna lub metody nieliniowe mogą lepiej dopasować się do danych.
Nawet gdy model złożony okazuje się lepszy, regresja liniowa pozostaje cenną bazą odniesienia. Jeśli duży system nie potrafi jej systematycznie przewyższyć, dodatkowa złożoność może nie być uzasadniona.
Założenia modelu, estymacja i diagnostyka
Regresja liniowa modeluje średnią warunkową wyniku liczbowego jako wyraz wolny plus ważone predyktory. Metoda najmniejszych kwadratów wybiera współczynniki minimalizujące kwadraty reszt. Współczynniki opisują oczekiwaną zmianę wyniku przy zmianie predyktora o jedną jednostkę, przy stałych pozostałych zmiennych, w ramach określonego modelu. Jest to zależność, o ile nie spełnione są założenia identyfikacji przyczynowej i projekt badania nie uzasadnia inaczej. Jednostki, kodowanie, przekształcenia, interakcje i kategorie odniesienia determinują interpretację, więc współczynniki bez słownika danych są niekompletne.
Klasyczna inferencja opiera się na założeniach dotyczących formy funkcjonalnej, niezależnych błędów, stałej wariancji oraz rozkładu błędów dla konkretnych testów i przedziałów. Wykresy reszt w stosunku do dopasowanych wartości ujawniają nieliniowość lub heteroskedastyczność; wykresy Q–Q oceniają zachowanie ogonów; diagnostyka lewarowania i wpływu identyfikuje obserwacje silnie oddziałujące na szacunki. Skorelowane predyktory zwiększają niepewność i destabilizują poszczególne współczynniki, nawet gdy prognozy pozostają wystarczające. Mogą być potrzebne odporne błędy standardowe, przekształcenia, splajny, struktura hierarchiczna lub inny model, zamiast usuwania niewygodnych punktów danych.
Regularyzacja, ocena i odpowiedzialne użycie
Regresja ridge ściąga współczynniki przy użyciu kary L2, natomiast lasso może ustawiać niektóre na zero przy karze L1; elastic net łączy oba podejścia. Standaryzuj predyktory, gdy skala kary powinna być porównywalna, i wybieraj siłę kary przy użyciu walidacji lub cross‑validation. Oceń średni błąd bezwzględny, pierwiastek ze średniego błędu kwadratowego, rozkład reszt, kalibrację w różnych zakresach oraz niepewność, stosując podziały czasowe lub grupowe odzwierciedlające rzeczywiste użycie. Porównaj z bazą średnią i alternatywami nieliniowymi, ale zachowaj modele liniowe, gdy przejrzystość i stabilność są cenne.
Ekstrapolacja poza obserwowany zakres predyktorów podąża za dopasowaną linią bez dowodów i może być niebezpieczna. Monitoruj zakresy cech, brakujące wartości, reszty oraz błąd podgrup w środowisku produkcyjnym. Przedziały prognozy opisują niepewność pojedynczych wyników i są szersze niż przedziały ufności dla średniej; oba wymagają założeń. Unikaj kontrolowania zmiennych, które wprowadzają błąd przyczynowy, gdy celem jest oszacowanie efektu. Regresja liniowa jest precyzyjnym narzędziem dla określonego związku, a nie uniwersalnym gwarantem, że świat jest liniowy lub że współczynnik reprezentuje interwencję.
Przykład praktyczny: szacowanie czasu dostawy
Zespół logistyczny modeluje czas dostawy na podstawie odległości, poziomu usługi, regionu, dnia tygodnia oraz znanej pogody. Analizuje nieliniowe wzorce reszt i dodaje uzasadnione splajny oraz interakcje, zamiast traktować równanie liniowe jako dosłowną fizykę. Grupy przewoźników i tras definiują zestawy walidacyjne. Raportowane są średni błąd bezwzględny, błąd w ogonie, pokrycie przedziałów oraz systematyczne odchylenie. Anulowane dostawy i dane zarejestrowane po przybyciu są wykluczane lub modelowane explicite.
Współczynniki są dokumentowane w jednostkach i sprawdzane pod kątem niestabilności przy skorelowanych predyktorach. Model odrzuca ekstrapolację poza zwalidowane zakresy odległości i regionów. Przedziały prognozy towarzyszą szacunkom, a dalsze planowanie wykorzystuje ich niepewność. Monitorowanie śledzi zakresy cech, reszty, pokrycie przedziałów oraz odchylenie po zmianach sieci. Twierdzenie przyczynowe dotyczące przewoźnika lub pogody nie jest formułowane na podstawie współczynników predykcyjnych; potrzebne byłyby eksperymenty operacyjne lub silniejsza identyfikacja, aby wesprzeć interwencję.
Dowody wdrożeniowe i gotowość operacyjna
Decyzja produkcyjna wymaga więcej niż udanej demonstracji. Zdefiniuj docelowych użytkowników, środowisko operacyjne, wejścia, wyjścia, zależności, właściciela oraz konsekwencje każdego istotnego błędu. Ustal odtwarzalną bazę oraz wersjonowany zestaw ewaluacyjny przed strojeniem. Testuj typowe przypadki, warunki brzegowe, nieprawidłowe lub brakujące dane wejściowe, zmianę rozkładu, awarię zależności, niewłaściwe użycie oraz grupy lub środowiska najprawdopodobniej niedostatecznie obsługiwane. Mierz jakość zadania wraz z kalibracją lub niepewnością, opóźnieniem, przepustowością, kosztami zasobów, dostępnością, prywatnością i bezpieczeństwem. Rejestruj każdą transformację i próg, aby niezależny recenzent mógł odtworzyć wynik i odróżnić dowody od atrakcyjnego prototypu.
Przed uruchomieniem przydziel odpowiedzialność za wydanie, wyjątki, zmiany, wycofanie i wycofanie produktu. Stosuj stopniowe wdrażanie, zachowaj bezpieczną alternatywę i zweryfikuj monitorowanie poprzez celowe wprowadzanie awarii. Telemetria operacyjna powinna ujawniać jakość danych wejściowych, zachowanie wyjść, wersję modelu lub reguły, stan zależności, interwencje ludzkie oraz potwierdzone wyniki, bez gromadzenia niepotrzebnych danych wrażliwych. Zdefiniuj progi alarmowe i właściciela reakcji, a następnie przeglądaj dowody z rzeczywistego świata po wdrożeniu, zamiast zakładać, że wydajność offline będzie trwała. Ponownie oceniaj sytuację, gdy zmieniają się źródła danych, użytkownicy, modele, dostawcy, polityki, sprzęt lub cele. Utrzymany system wymaga także udokumentowanego odzyskiwania, nauki z incydentów, procedur usuwania i przechowywania oraz jasno określonego momentu, w którym powinien zostać wyłączony lub zastąpiony.
Najczęściej zadawane pytania
Czy regresja liniowa wymaga tylko jednej zmiennej wejściowej?
Nie. Prosta regresja ma jeden predyktor, natomiast wielokrotna regresja liniowa może wykorzystywać wiele cech numerycznych, zakodowanych kategorycznych, przekształconych oraz interakcyjnych.
Czy regresja liniowa może udowodnić przyczynowość?
Nie. Interpretacja przyczynowa wymaga uzasadnionego projektu badawczego oraz założeń dotyczących zakłóceń, selekcji, pomiaru i interwencji. Sam współczynnik predykcyjny opisuje jedynie zależność w dopasowanym modelu.
Podstawowe źródła












