Podstawy AI
Uczenie nadzorowane vs uczenie nienadzorowane

 Dodaj Unite.AI do preferowanych źródeł w Google
Uczenie nadzorowane uczy się na przykładach sparowanych z docelowymi odpowiedziami. Uczenie nienadzorowane poszukuje struktury w danych bez etykiet docelowych. Różnica nie polega na tym, które podejście jest bardziej inteligentne lub dokładne; chodzi o rodzaj dostępnego sygnału uczącego oraz pytanie, na które system ma odpowiedzieć.
Są to dwa główne paradygmaty w uczeniu maszynowym, ale współczesne systemy wykorzystują także uczenie półnadzorowane, samonadzorowane i uczenie ze wzmocnieniem.
Kluczowe wnioski
- Uczenie nadzorowane przewiduje znany cel; uczenie nienadzorowane odkrywa wzorce lub reprezentacje.
- Klasyfikacja i regresja to zadania nadzorowane; grupowanie, estymacja gęstości i wiele metod redukcji wymiarowości to zadania nienadzorowane.
- Wyniki uczenia nienadzorowanego nie są automatycznie rzeczywistymi klasami i ich ocena może być trudniejsza.
- Koszt obliczeniowy i dokładność zależą od algorytmu, danych, zadania i metody oceny — nie od samego paradygmatu.
Jak działa uczenie nadzorowane
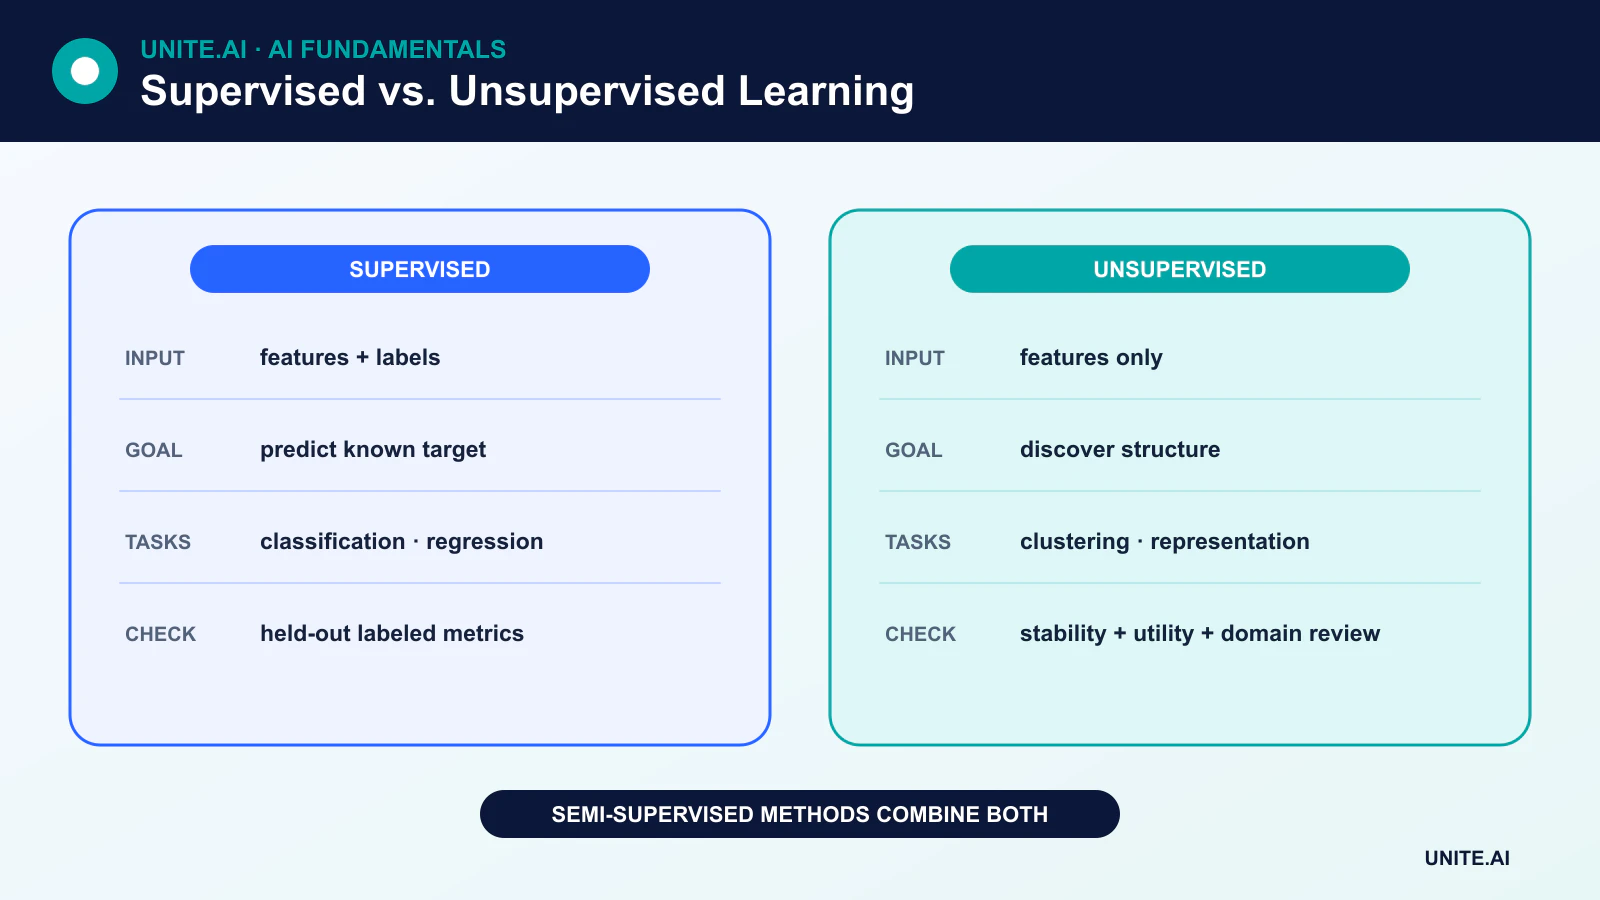
Zbiór danych nadzorowanych zawiera cechy X oraz cel y. Trening dostosowuje model tak, aby jego prognozy przybliżały wartości docelowe. Ocena wykorzystuje odłożone oznaczone przykłady, aby oszacować, jak dobrze model uogólnia.
Klasyfikacja
Klasyfikacja przewiduje kategorię: spam lub nie‑spam, temat dokumentu spośród kilku, lub jedną lub więcej obiektów na obrazie. Istotne miary to precyzja, czułość, F1, kalibracja oraz miary kosztowo‑czułe. Dokładność może być myląca, gdy jedna klasa jest rzadka; macierz pomyłek ujawnia, które klasy są mylone.
Regresja
Regresja przewiduje wartość ciągłą, taką jak popyt, czas trwania lub temperatura. Regresja liniowa może wykorzystywać jedną lub wiele cech; nie ogranicza się jedynie do zależności między dwoma zmiennymi. Miary regresji obejmują średni błąd bezwzględny, pierwiastek średniego błędu kwadratowego oraz koszty specyficzne dla zadania.
Typowe algorytmy nadzorowane
Metody nadzorowane obejmują modele liniowe i logistyczne, drzewa decyzyjne, lasy losowe, gradient boosting, maszyny wektorów nośnych, K‑najbliższych sąsiadów oraz sieci neuronowe.
Regresja logistyczna generuje wynik lub prawdopodobieństwo, które można przekształcić w klasę przy użyciu wybranego progu. Liść drzewa decyzyjnego zawiera prognozę opartą na regionie przestrzeni cech, niekoniecznie na jednej obserwacji treningowej. KNN prognozuje na podstawie pobliskich oznaczonych przykładów treningowych i nadal wymaga solidnego podziału na zestawy treningowy, walidacyjny i testowy.
Jak działa uczenie nienadzorowane
Uczenie nienadzorowane otrzymuje cechy bez kolumny docelowej. Jego cel jest definiowany pośrednio — na przykład minimalizacja odległości wewnątrz klastrów, odtworzenie wejścia, oszacowanie gęstości danych lub zachowanie jak największej wariancji przy mniejszej liczbie wymiarów.
Grupowanie
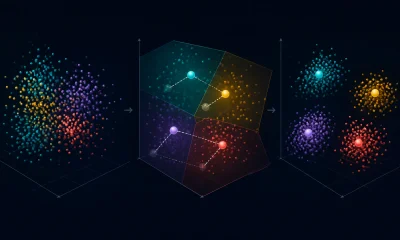
K‑means przydziela punkty do wybranej liczby klastrów i aktualizuje ich środki, aby zmniejszyć wewnątrz‑klastrową sumę kwadratów odległości. Algorytm odkrywa geometryczne grupowania w określonej odległości i reprezentacji cech. Te grupy nie odpowiadają automatycznie znaczącym typom klientów, diagnozom czy innym etykietom domenowym.
Redukcja wymiarowości
Redukcja wymiarowości reprezentuje dane przy użyciu mniejszej liczby zmiennych. Analiza głównych składowych znajduje ortogonalne kierunki, które zachowują jak najwięcej wariancji przy projekcji liniowej. Inne metody zachowują różne pojęcia struktury i mogą generować zupełnie inne wizualizacje.
Detekcja anomalii i estymacja gęstości
Metody nienadzorowane mogą szacować, gdzie dane są gęste, i sygnalizować nietypowe obserwacje. Wynik anomalii nie dowodzi oszustwa, awarii ani złośliwego zachowania; wskazuje jedynie odchylenie w wybranej reprezentacji i modelu.
Jak ocenia się uczenie nienadzorowane
Nie istnieje uniwersalna miara „dokładności” w uczeniu nienadzorowanym. Praktyk może stosować metryki wewnętrzne, takie jak współczynnik sylwetki, porównywać stabilność pomiędzy próbkami, testować użyteczność w zadaniu końcowym lub pytać ekspertów domenowych, czy odkryta struktura ma sens. Jeśli do oceny dostępne są prawdziwe etykiety, można użyć zewnętrznych miar klasteryzacji, nie przekształcając procesu treningowego w uczenie nadzorowane.
Poza dwukierunkowym porównaniem
Uczenie półnadzorowane
Uczenie półnadzorowane łączy mniejszy zestaw oznaczonych danych z większym zestawem nieoznaczonych. Przykładami są pseudo‑etykietowanie, regularizacja spójności oraz metody oparte na grafach. Nieoznaczone dane muszą wciąż wystarczająco przypominać docelowy rozkład, aby były pomocne.
Uczenie samonadzorowane
Uczenie samonadzorowane wyprowadza cele z samego wejścia, np. przewidywanie zamaskowanych tokenów lub dopasowywanie przekształconych widoków. Stanowi podstawę współczesnych modeli językowych, wizualnych i multimodalnych, w tym transformerów.
Uczenie ze wzmocnieniem
Uczenie ze wzmocnieniem optymalizuje decyzje poprzez nagrody generowane w wyniku interakcji. Różni się zarówno od przewidywania opartego na etykietach, jak i od statycznego odkrywania wzorców.
Wybór właściwego podejścia
Zacznij od decyzji lub wniosku, który system ma wygenerować. Jeśli istnieją wiarygodne cele i celem jest prognozowanie, naturalnym wyborem jest uczenie nadzorowane. Jeśli celem jest eksploracja, reprezentacja lub grupowanie, lepsze może być podejście nienadzorowane. Gdy etykiety są rzadkie, wstępne uczenie samonadzorowane lub półnadzorowane, a następnie ocena nadzorowana, może być skuteczniejsze.
W każdym przypadku wycieki danych, stronnicze próbkowanie, słabe przybliżenia i zmiana rozkładu mogą zdominować wybór algorytmu. Technicznie poprawny model wytrenowany na niewłaściwym celu i tak może zawieść.
Sygnały uczące, cele i reprezentatywne metody
Uczenie nadzorowane wykorzystuje przykłady sparowane z etykietami lub wartościami docelowymi i minimalizuje błąd predykcji. Klasyfikacja, regresja, ranking i prognozowanie strukturalne różnią się wyjściem i funkcją straty. Uczenie nienadzorowane poszukuje struktury bez etykiet docelowych poprzez grupowanie, estymację gęstości, redukcję wymiarowości, uczenie reprezentacji lub modelowanie generatywne. Uczenie samonadzorowane tworzy cele predykcyjne z samych danych, natomiast uczenie półnadzorowane łączy mały zestaw oznaczony z większym zestawem nieoznaczonym. Te kategorie opisują sygnał uczący; tę samą architekturę neuronową można trenować w ramach kilku paradygmatów.
Etykiety czynią cel explicite, ale wprowadzają koszty anotacji, szum, założenia polityczne i opóźnienie czasowe. Dane nieoznaczone są łatwiejsze do zebrania, ale nie mówią algorytmowi, które odkryte struktury są użyteczne. Klastr może odzwierciedlać oświetlenie, długość dokumentu lub źródło pozyskania zamiast znaczącej kategorii. Definiuj ocenę niezależnie: modele nadzorowane używają odłożonych oznaczonych wyników, podczas gdy modele nienadzorowane potrzebują stabilności, odtworzenia, prawdopodobieństwa, wyszukiwania, użyteczności w zadaniu końcowym lub walidacji ekspertów. Sama wizualna separacja nie jest dowodem na prawidłową strukturę.
Wybór paradygmatu i unikanie typowych błędów
Stosuj uczenie nadzorowane, gdy istnieje stabilny cel i reprezentatywne etykiety. Używaj eksploracji nienadzorowanej do podsumowań, wykrywania nowości, kompresji lub generowania hipotez, ale traktuj wyniki jako prowizoryczne. Wstępne uczenie samonadzorowane jest wartościowe, gdy surowe dane są obfite, a zadania końcowe dzielą reprezentacje. Metody półnadzorowane pomagają tylko wtedy, gdy spełnione są założenia dotyczące nieoznaczonych danych i struktury klas. Porównuj z prostymi bazami odniesienia i uwzględniaj całkowity koszt zbierania, etykietowania, przeglądu, obliczeń i błędów, zamiast zakładać, że nieoznaczone dane są automatycznie tanie.
Zapobiegaj wyciekom, oddzielając powiązane jednostki przed tworzeniem etykiet, augmentacji lub pseudo‑etykiet. Monitoruj równowagę klas, zgodność anotacji, stabilność klastrów, kolaps i dryf. Pseudo‑etykiety mogą utrwalać wczesne pomyłki; grupowanie może kodować wrażliwe atrybuty; wstępnie wytrenowana reprezentacja może przenosić uprzedzenia źródłowe. Przegląd ludzki powinien koncentrować się na przypadkach granicznych i konsekwencjach. W produkcji dokumentuj, jak powstał sygnał uczący i kiedy staje się przestarzały. Paradygmat określa, gdzie w systemie pojawia się nadzór, nie to, czy w nim występują ludzkie wybory i wartości.
Przykład praktyczny: odkrywanie i etykietowanie tematów wsparcia
Firma najpierw używa nienadzorowanych osadzeń i grupowania, aby eksplorować tematy w zanonimizowanych wiadomościach wsparcia. Analitycy przeglądają reprezentatywne i brzegowe przykłady i odkrywają, że niektóre klastry odzwierciedlają długość wiadomości i kanał, a nie rzeczywiste problemy. Następnie opracowują nadzorowaną taksonomię z nieznaną klasą, wytycznymi anotacji i zmierzoną zgodą. Klasyfikator jest potem oceniany na późniejszych okresach, językach i produktach względem bazowych słów kluczowych i metod najbliższych sąsiadów.
Nowe nieoznaczone wiadomości wspierają wykrywanie dryfu, ale nie trenują klasyfikator automatycznie. Recenzenci etykietują wybrane niepewne i pojawiające się przypadki przy użyciu aktywnego uczenia, z kontrolą jakości i zamkniętym zestawem ewaluacyjnym. Monitorowanie śledzi częstość tematów, pewność, niezgodę i wyniki kierowania. Gdy wprowadzany jest nowy produkt, taksonomia i pojemność zespołów downstream są aktualizowane jednocześnie. Przepływ pracy wykorzystuje metody nienadzorowane do generowania hipotez oraz dowody nadzorowane do operacyjnego kierowania.
Dowody wdrożeniowe i gotowość operacyjna
Decyzja produkcyjna wymaga więcej niż udany prototyp. Zdefiniuj docelowych użytkowników, środowisko operacyjne, wejścia, wyjścia, zależności, właściciela oraz konsekwencje każdego istotnego błędu. Ustal powtarzalną bazę odniesienia i wersjonowany zestaw ewaluacyjny przed strojeniem. Testuj typowe przypadki, warunki brzegowe, niepoprawne lub brakujące wejścia, zmianę rozkładu, awarię zależności, niewłaściwe użycie oraz grupy lub środowiska najczęściej niedoszacowane. Mierz jakość zadania wraz z kalibracją lub niepewnością, opóźnieniem, przepustowością, kosztami zasobów, dostępnością, prywatnością i bezpieczeństwem. Rejestruj każdą transformację i próg, aby niezależny recenzent mógł odtworzyć wynik i odróżnić dowód od atrakcyjnego prototypu.
Przed uruchomieniem przydziel odpowiedzialność za wydanie, wyjątki, zmiany, wycofanie i wycofanie. Stosuj stopniowe wdrażanie, zachowaj bezpieczny fallback i zweryfikuj monitorowanie poprzez celowo wprowadzone awarie. Telemetria operacyjna powinna ujawniać jakość wejść, zachowanie wyjść, wersję modelu lub reguły, stan zależności, interwencje ludzkie oraz potwierdzone wyniki, nie gromadząc niepotrzebnych wrażliwych danych. Określ progi alarmowe i właściciela reakcji, a następnie po wdrożeniu przeglądaj dowody z rzeczywistości, zamiast zakładać, że offline‑owa wydajność się utrzyma. Przeglądaj ponownie przy każdej zmianie źródeł danych, użytkowników, modeli, dostawców, polityk, sprzętu lub celów. Utrzymany system wymaga także udokumentowanego odzyskiwania, nauki z incydentów, procedur usuwania i przechowywania oraz wyraźnego momentu, w którym powinien zostać wyłączony lub zastąpiony.
Podstawowe źródła