
Podstawy AI
Co to jest grupowanie K‑średnich?

 Dodaj Unite.AI do preferowanych źródeł w Google
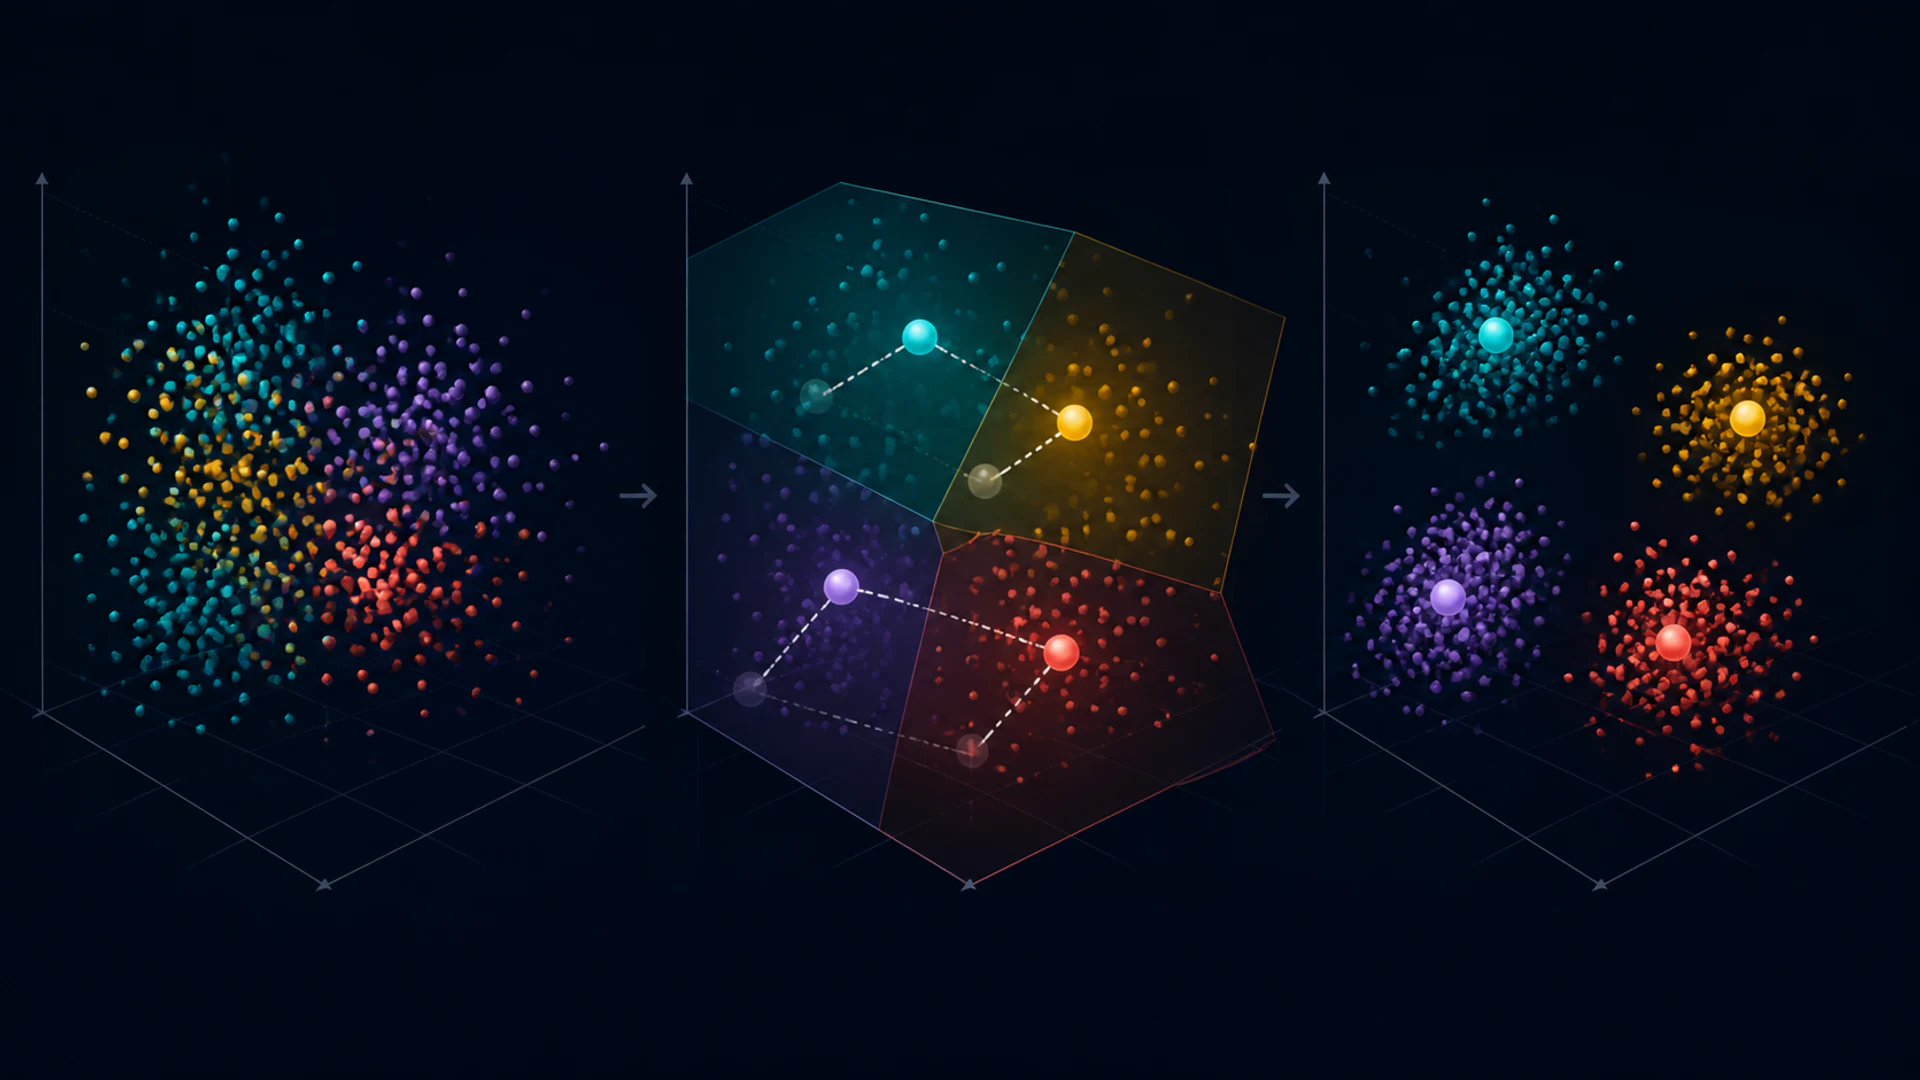
K-means to algorytm nienadzorowany, który dzieli obserwacje liczbowe na k klastrów. Alternuje pomiędzy przypisywaniem każdego punktu do najbliższego centroidu a przeliczaniem każdego centroidu jako średniej z przypisanych do niego punktów.
Algorytm jest szybki i przydatny, ale jego wynik zależy od skalowania, miary odległości, inicjalizacji oraz wybranego k. Klastr jest podziałem matematycznym, niekoniecznie odzwierciedla rzeczywistą kategorię.
Kluczowe wnioski
- K-means minimalizuje sumę kwadratów odległości euklidesowych wewnątrz klastra do centroidów.
- Inicjalizacja ma znaczenie; k-means++ rozprasza początkowe centroidy i zazwyczaj poprawia wyniki.
- Standaryzuj cechy, gdy ich jednostki lub skale powinny mieć porównywalny wpływ.
- K-means ma trudności z wartościami odstającymi, niesferycznymi klastrami, nierówną gęstością oraz danymi kategorycznymi.
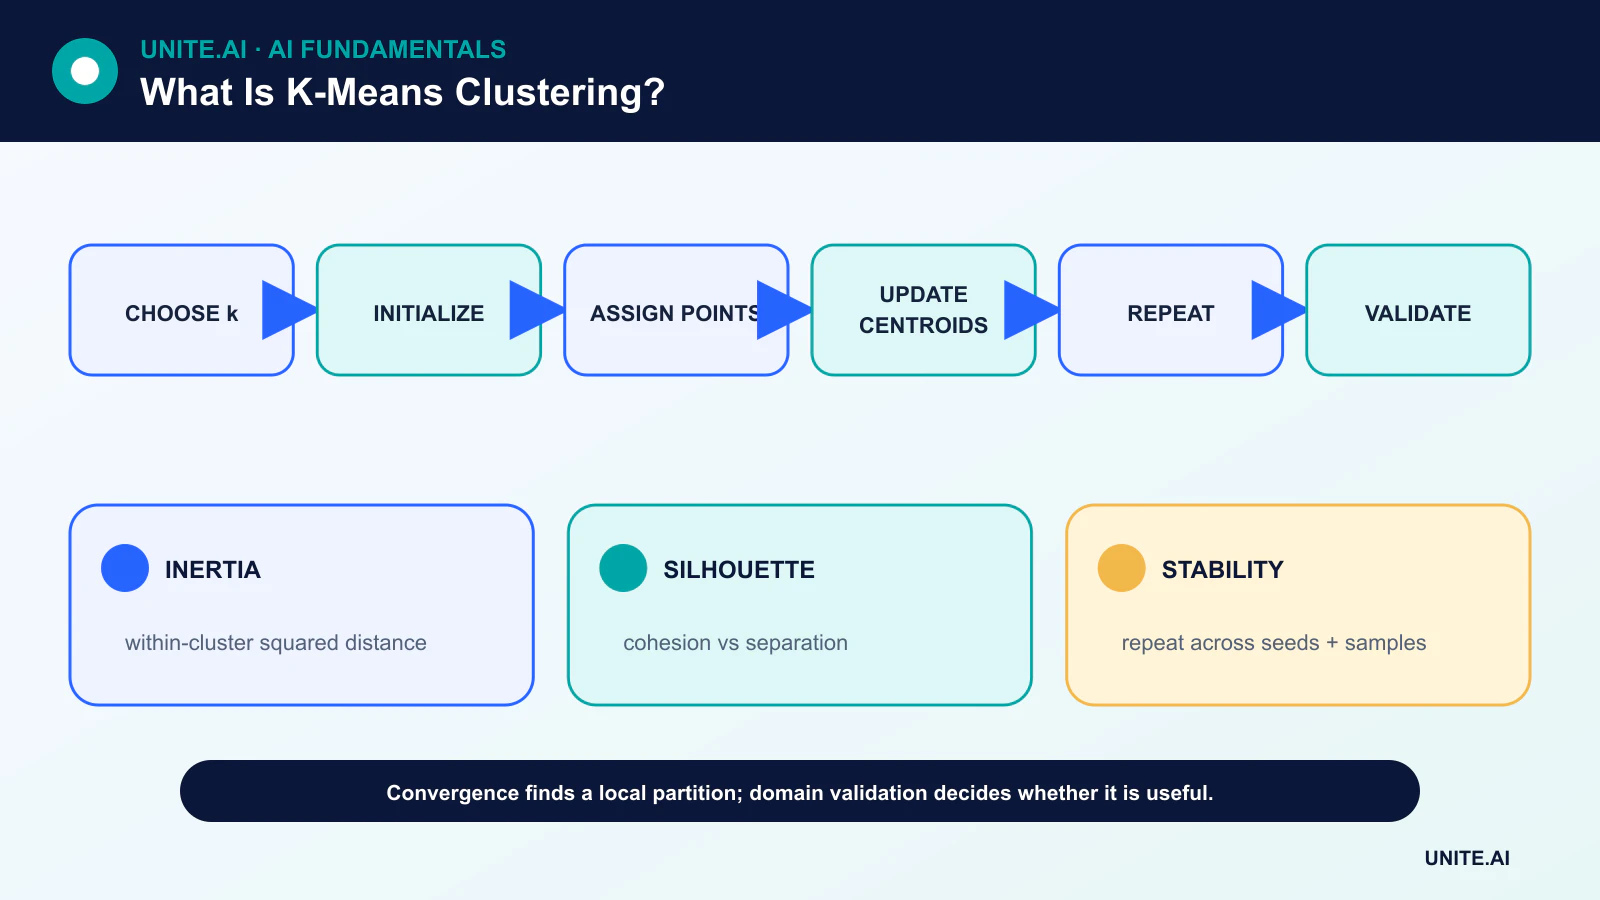
Cel i pętla aktualizacji
Posiadając k centroidów, krok przypisywania wysyła każdą obserwację do najbliższego z nich. Krok aktualizacji zastępuje każdy centroid średnią z przypisanych do niego obserwacji. Suma kwadratów wewnątrz klastra nie może rosnąć w wyniku tych kroków, więc proces zbiega do lokalnego optimum.
Zbieżność nie gwarantuje optimum globalnego. Różne początkowe centroidy mogą prowadzić do różnych podziałów, dlatego implementacje uruchamiają kilka inicjalizacji i zachowują rozwiązanie o najniższej inercji.
Inicjalizacja i k-means++
Losowy wybór wszystkich początkowych centroidów z jednej gęstej okolicy może dać słabe rozwiązanie lub wolną zbieżność. k-means++ wybiera nasiona z prawdopodobieństwem zależnym od odległości od istniejących nasion, co sprzyja pokryciu całego zbioru danych.
Wiele uruchomień pozostaje przydatnych. Zapisz losowe ziarno i liczbę inicjalizacji, aby wyniki można było odtworzyć.
Skalowanie i odległość
Kwadratowa odległość euklidesowa sprawia, że K-means jest wrażliwy na jednostki. Cecha mierzona w tysiącach może zdominować inną mierzoną w przedziale od zera do jednego. Standaryzacja jest powszechna, lecz wiedza domenowa powinna decydować, czy równa znormalizowana wariancja odzwierciedla równą ważność.
Wartości odstające mogą przesunąć średnią daleko od typowych punktów. Lepsze mogą być skalowanie odporne, przycinanie lub metody oparte na medoidach. Cechy kategoryczne zakodowane metodą one‑hot tworzą geometrię odległości, która niekoniecznie odzwierciedla podobieństwo kategorii.
Wybór k i walidacja klastrów
Inercja maleje wraz ze wzrostem k, więc nie może sama wybrać k. Heurystyka łokcia szuka malejących przyrostów. Analiza silhouette porównuje spójność i separację. Stabilność w różnych próbkach i przy różnych ziarnach dodaje kolejny warunek.
Najsilniejszą walidacją jest przydatność dla zamierzonej dziedziny. Porównaj klastry z znanymi wynikami, recenzją ekspertów lub zadaniem dalszym, nie udając, że etykiety po fakcie zostały odkryte obiektywnie.
Ograniczenia i alternatywy
K-means preferuje zwarte, mniej‑lub‑bardziej sferyczne grupy o podobnej skali. Modele mieszanki Gaussa (Gaussian mixture models) reprezentują probabilistyczne komponenty elipsoidalne; metody typu DBSCAN identyfikują gęste regiony i szumy; grupowanie hierarchiczne tworzy drzewo łączeń.
Redukcja wymiarowości może przyspieszyć działanie lub odszumieć dane wejściowe, ale dopasowanie jej do pełnego zbioru danych może zmienić pytanie walidacyjne. Mini‑batch K‑means zmniejsza obliczenia przy dużych zbiorach danych kosztem przybliżonej aktualizacji.
Cel, inicjalizacja i zbieżność
K-means dzieli obserwacje liczbowe na k klastrów, minimalizując sumę kwadratów odległości euklidesowych wewnątrz klastra do centroidów. Algorytm Lloyda naprzemiennie przypisuje każdy punkt do najbliższego centroidu i przelicza centroidy, aż przydziały lub funkcja celu ustabilizują się. Zbiega do lokalnego optimum, niekoniecznie najlepszego globalnie. Inicjalizacja k‑means++ rozprasza początkowe środki i zazwyczaj poprawia wyniki, ale wiele nasion pozostaje istotnych. Standaryzuj cechy, gdy jednostki powinny mieć porównywalny wkład, ponieważ kwadratowa odległość wzmacnia zmienne o dużej skali i wartości odstające.
Metoda zakłada mniej‑lub‑bardziej zwarte, sferyczne, podobnie skalowane klastry w geometrii euklidesowej. Ma trudności z wydłużonymi rozmaitościami, nierówną gęstością, danymi kategorycznymi, silnymi wartościami odstającymi oraz strukturą zagnieżdżoną. Puste klastry i duplikaty punktów wymagają określonego sposobu obsługi. Mini‑batch k‑means skaluje się do dużych danych kosztem przybliżenia. Dla rzadkiego tekstu, sferyczny k‑means oparty na kosinusie może lepiej dopasować kierunek, podczas gdy mieszanki, metody gęstościowe, grupowanie hierarchiczne lub k‑medoidy wprowadzają inne założenia.
Wybór k i walidacja znaczenia
Krzywe łokcia, wyniki silhouette, kryteria informacyjne w powiązanych modelach i stabilność mogą sugerować k, ale żadne nie odkrywa jednoznacznie prawidłowej liczby. Przydatność biznesowa i interpretacja domenowa mają znaczenie. Przeprowadzaj ponowne dopasowanie na różnych próbkach i ziarnach, porównuj ruch centroidów i spójność przydziałów oraz waliduj klastry na niezależnych wynikach, które nie były użyte przy ich tworzeniu. Projekcja dwuwymiarowa może zniekształcać separację, więc analizuj odległości i przykłady w oryginalnej lub zwalidowanej przestrzeni reprezentacji.
Klastry są opisowymi grupami utworzonymi na podstawie wybranych cech i metryki; nie są naturalnymi rodzajami ani segmentami przyczynowymi. Profile oparte na tych samych zmiennych, które służyły do grupowania, mogą być cykliczne. Używaj odrzuconych atrybutów i przeglądu jakościowego oraz sprawdzaj, czy klastry głównie odzwierciedlają geografię, źródło danych lub wrażliwe cechy. Małe klastry mogą być anomaliami lub artefaktami. Nazwanie klastra nie sprawia, że każdy jego członek pasuje do etykiety.
Wdrożenie i utrzymanie
Przechowuj skalowanie, kolejność cech, centroidy, definicję odległości i etykiety klastrów razem. Dla nowych punktów monitoruj odległość do przypisanego centroidu oraz odsetek znacznie wykraczający poza zakres treningowy; zapewnij stan nieznany zamiast wymuszać przypisanie każdego przypadku do klastra. Śledź rozmiary klastrów, centroidy i istotność wyników w czasie. Ponowne trenowanie zmienia tożsamość klastrów, więc mapuj lub wersjonuj reguły downstream zamiast cicho używać starych nazw. K‑means jest przydatną bazą kompresji i segmentacji, gdy jego geometria odpowiada pytaniu, a nie uniwersalnym silnikiem odkrywania.
Przykładowe zastosowanie: segmentacja klientów przy użyciu k‑means
Firma oferująca subskrypcje standaryzuje cechy użytkowania w stałym oknie czasowym, usuwa identyfikatory kont i testuje różne wartości k przy różnych ziarnach. Przeglądane są stabilność, silhouette oraz wyniki biznesowe na danych odrzuconych, ale zespoły produktowe analizują także reprezentatywne i brzegowe konta. Odkrywają, że jeden klaster to po prostu nowi klienci z krótszym okresem obserwacji, więc staż jest obsługiwany explicite. K‑means jest porównywany z alternatywami hierarchicznymi i opartymi na gęstości, zamiast zakładać jego adekwatność. Ćwiczenie traktowane jest jako uczenie nienadzorowane, a nie odkrywanie etykiet.
Segmenty kierują badaniami i eksperymentami komunikacyjnymi, a nie kwalifikacją czy ceną. Nowe konta daleko od każdego centroidu otrzymują przypisanie nieznane. Skalowanie, cechy, centroidy i nazwy są wersjonowane, a ponowne trenowanie mapuje nowe klastry na stare wyłącznie na podstawie dowodów. Monitorowanie śledzi rozmiar klastra, odległość i istotność wyników. Atrybuty wrażliwe i ich zamienniki są audytowane, a zespół unika opisywania klastrów jako naturalnych typów osobowości, gdy są one jedynie matematycznymi podziałami wybranych zachowań.
Dowody wdrożeniowe i gotowość operacyjna
Decyzja produkcyjna wymaga więcej niż udanej demonstracji. Zdefiniuj docelowych użytkowników, środowisko operacyjne, dane wejściowe, wyjściowe, zależności, właściciela oraz konsekwencje każdego istotnego błędu. Ustal odtwarzalną bazę i wersjonowany zestaw ewaluacyjny przed strojeniem. Testuj typowe przypadki, warunki brzegowe, niepoprawne lub brakujące dane, przesunięcie rozkładu, awarię zależności, niewłaściwe użycie oraz grupy lub środowiska najprawdopodobniej niedoszacowane. Mierz jakość zadania wraz z kalibracją lub niepewnością, opóźnieniem, przepustowością, kosztami zasobów, dostępnością, prywatnością i bezpieczeństwem. Zapisz każdą transformację i próg, aby niezależny recenzent mógł odtworzyć wynik i odróżnić dowody od atrakcyjnego prototypu.
Przed uruchomieniem przydziel uprawnienia do wydania, wyjątków, zmian, wycofania i wycofania produktu. Użyj stopniowego wdrożenia, zachowaj bezpieczną alternatywę i zweryfikuj monitorowanie poprzez celowo wprowadzone awarie. Telemetria operacyjna powinna ujawniać jakość danych wejściowych, zachowanie wyjścia, wersję modelu lub reguły, stan zależności, interwencje ludzkie oraz potwierdzone wyniki, nie zbierając niepotrzebnych danych wrażliwych. Zdefiniuj progi alarmowe i właściciela reakcji, a następnie przeglądaj dowody z rzeczywistego świata po wdrożeniu, zamiast zakładać, że offline wydajność utrzyma się. Przeglądaj ponownie, gdy zmienią się źródła danych, użytkownicy, modele, dostawcy, polityki, sprzęt lub cele. Utrzymany system wymaga także udokumentowanego odzyskiwania, nauki z incydentów, procedur usuwania i przechowywania oraz wyraźnego momentu, w którym powinien zostać wyłączony lub zastąpiony.
Najczęściej zadawane pytania
Czy K-means jest nadzorowany czy nienadzorowany?
Jest nienadzorowany, ponieważ otrzymuje cechy i wybraną liczbę klastrów, a nie etykiety docelowe.
Czy K-means klasyfikuje nowe dane?
Po dopasowaniu nowy punkt może zostać przypisany do najbliższego centroidu. To jest przydział do klastra, niekoniecznie predykcja klasy w trybie nadzorowanym.
Podstawowe źródła












