Podstawy AI
Czym jest Data Science?

 Dodaj Unite.AI do preferowanych źródeł w Google
Data science to praktyka przekształcania danych w uzasadnioną wiedzę, prognozy lub decyzje. Łączy wiedzę dziedzinową, statystykę, informatykę, inżynierię danych, wizualizację i komunikację. Model może być częścią pracy, ale dyscyplina zaczyna się przed modelowaniem i trwa po wdrożeniu.
Najważniejsze pytanie nie brzmi „Jaki algorytm powinniśmy użyć?”. Brzmi „Jaką decyzję wspieramy, jakie dowody ją uzasadnią i jak będziemy wiedzieć, że wynik pozostaje użyteczny?”
Kluczowe wnioski
- Data science to kompleksowy przepływ dowodowy od początku do końca, a nie synonim uczenia maszynowego.
- Definicja problemu, pomiar i zarządzanie danymi często decydują o sukcesie bardziej niż złożoność modelu.
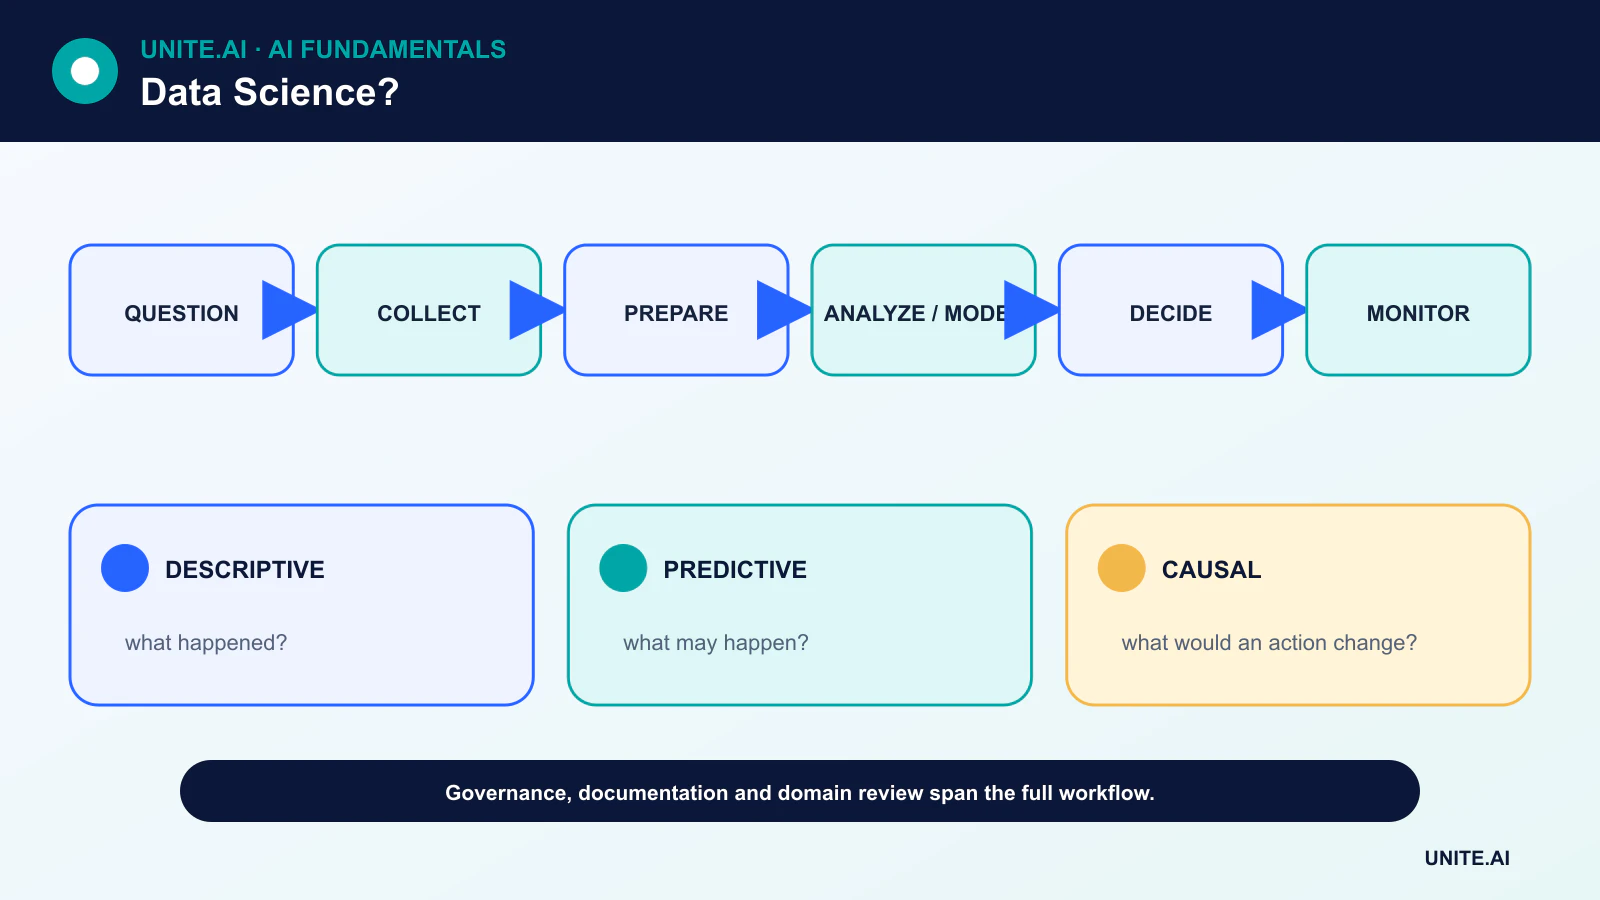
- Pytania predykcyjne i przyczynowe wymagają różnych założeń i projektów ewaluacji.
- Wdrożona analiza wymaga monitorowania, dokumentacji i komunikacji odpowiedniej dla jej użytkowników.
Zacznij od decyzji i estymandu
Projekt powinien określić użytkownika, decyzję, interwencję oraz koszt błędu. W przypadku pytania opisowego celem może być wskaźnik lub trend. W prognozowaniu może to być przyszły popyt lub ryzyko. W pytaniu przyczynowym estymand opisuje efekt określonej interwencji przy założonych warunkach.
Niejasne cele, takie jak „znaleźć wnioski”, uniemożliwiają ocenę. Mierzalny cel wyznacza granicę zbierania danych i zapobiega rozciąganiu analizy na wszystkie dostępne pola.
Zbieraj, zarządzaj i rozumiej dane
Zespoły inwentaryzują źródła, własność, zgodę, przechowywanie, pochodzenie i dostęp. Rozróżniają dane strukturalne i niestrukturalne, definiują jednostki i znaczniki czasu oraz sprawdzają, czy rekordy odzwierciedlają populację i okres czasu będący przedmiotem analizy.
Czyszczenie to nie tylko usuwanie brakujących wierszy. Obejmuje rozwiązywanie duplikatów, niemożliwych wartości, niejednoznaczności etykiet, dryf schematu, cenzurowanie oraz łączenia zmieniające jednostkę analizy. Każda transformacja powinna być odtwarzalna i udokumentowana.
Eksploruj przed modelowaniem
Analiza eksploracyjna bada rozkłady, brakujące dane, zależności i potencjalne artefakty pomiarowe. Wizualizacja może uwidocznić wartości odstające i różnice w podgrupach, które ukrywa średnia podsumowująca. Eksploracja powinna inspirować hipotezy, nie będąc mylona z dowodami potwierdzającymi.
Inżynieria cech, redukcja wymiarowości i uczenie reprezentacji mogą poprawić modelowanie, ale transformacje muszą być dopasowywane wyłącznie na danych treningowych, aby zapobiec wyciekowi informacji.
Wybierz metody odpowiednie do pytania
Estymacja statystyczna kwantyfikuje niepewność wokół interesujących nas wielkości. Uczenie maszynowe jest przydatne, gdy głównym celem jest wydajność predykcyjna na nowych danych. Eksperymenty i metody wnioskowania przyczynowego są potrzebne, gdy celem jest efekt interwencji.
Podstawowy model powinien być wystarczająco prosty, aby go zrozumieć. Bardziej złożone modele muszą uzasadniać dodatkowy koszt lepszą wydajnością na danych testowych, skalibrowaną niepewnością, wartością operacyjną lub niezbędną funkcjonalnością, taką jak przetwarzanie obrazu czy języka.
Ewaluuj, komunikuj i monitoruj
Ewaluacja powinna odpowiadać decyzji. Klasyfikator może wymagać precyzji, czułości, kalibracji i analizy podgrup, a nie tylko dokładności; system prognozowania wymaga testów wstecznych uwzględniających czas. Przeuczenie i wyciek danych to awarie procesu, a nie jedynie właściwości modelu.
Komunikacja obejmuje założenia, niepewność, ograniczenia oraz zalecane działania. Gdy model lub pulpit nawigacyjny jest używany, zespoły monitorują jakość danych wejściowych, dryf wyników, zachowanie użytkowników i wpływ na dalsze procesy. Zakończony proces decyzyjny wymaga archiwum i wyraźnego właściciela, tak jak wdrożony wymaga operatora.
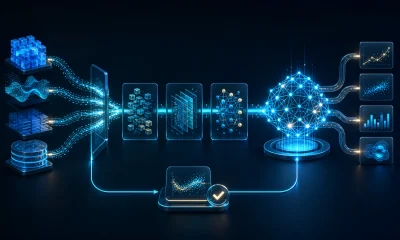
Cykl życia data science i pytania analityczne
Data science łączy wiedzę dziedzinową, statystykę, informatykę i komunikację, aby przekształcić dane w dowody dla decyzji. Zacznij od rozróżnienia opisu, diagnozy, prognozy i wnioskowania przyczynowego. Pulpit nawigacyjny raportujący, co się wydarzyło, model przewidujący, kto odejdzie, oraz eksperyment szacujący, czy interwencja zmienia wskaźnik odejść, odpowiadają na różne pytania. Przed pobraniem danych określ jednostkę, populację, okno czasowe, wynik, działanie i koszt błędów. Wiele nieudanych projektów rozwiązuje mierzalny wskaźnik pośredni, który nie może wesprzeć zamierzonej decyzji.
Pozyskanie wymaga pochodzenia, uprawnień, projektu próbkowania i umowy danych. Eksploracja sprawdza rozkłady, brakujące dane, duplikaty, wartości odstające, zależności, zmiany pomiarowe i potencjalny wyciek. Wybory czyszczenia są założeniami analitycznymi: usuwanie brakujących wierszy, imputacja wartości lub ograniczanie wartości odstających może zmienić populację i wnioski. Wersjonuj surowe dane niezmiennie oraz transformacje jako kod i utwórz słownik danych z jednostkami i znaczeniem. Podziel dane ewaluacyjne przed nauką transformacji lub wielokrotnym testowaniem hipotez.
Modelowanie, wnioskowanie i reprodukowalność
Wnioskowanie statystyczne kwantyfikuje niepewność przy założeniach; modelowanie predykcyjne szacuje wydajność poza próbką; analiza przyczynowa wymaga identyfikacji poprzez projekt lub uzasadnione założenia. Dobierz metody pasujące do pytania i procesu generowania danych. Porównuj z prostymi bazowymi modelami, stosuj walidację grupową lub uwzględniającą czas oraz raportuj niepewność i czułość. Wysoka korelacja lub istotność cech nie dowodzi przyczynowości. Wielokrotne testowanie, swoboda badacza i selektywne raportowanie mogą tworzyć przekonujące wzorce, dlatego rejestracja wstępna lub wyraźnie oddzielny etap potwierdzający może pomóc.
Reprodukowalność obejmuje kod, środowisko, migawkę danych, losowe nasiona, definicje zapytań oraz zapis decyzji manualnych. Automatyczne testy powinny obejmować schematy, invariancje biznesowe, transformacje i metryki. Notatniki są przydatne do eksploracji, ale praca produkcyjna wymaga modularnych, podlegających przeglądowi potoków. Recenzja rówieśnicza powinna kwestionować założenia, wyciek, ważność celu oraz możliwość uogólnienia wyników. Komunikuj wielkości efektu, niepewność, ograniczenia i dowody przeciwne, a nie jedynie istotność statystyczną czy wynik modelu.
Wdrożenie i wpływ decyzji
Jeśli analiza napędza powtarzalny proces, wyznacz właścicieli, monitoruj aktualność danych i jakość wyników oraz określ procedury wycofania lub wycofania. Chroń informacje osobiste i poufne poprzez minimalizację, kontrolę dostępu, przechowywanie i bezpieczne wyniki. Oceń efekty w podgrupach oraz reakcje użytkowników na model; pętle sprzężenia zwrotnego mogą zmienić przyszłe dane. Mierz, czy decyzja poprawiła rzeczywisty cel, a nie jedynie, czy model został wdrożony. Data science odnosi sukces, gdy dowody wiarygodnie i przejrzyście zmieniają działanie — a nie wtedy, gdy organizacja gromadzi pulpity, funkcje lub eksperymenty bez właściciela.
Przykład praktyczny: pomiar interwencji retencyjnej
Zespół produktowy obserwuje spadek retencji i definiuje aktywnego użytkownika, kohortę, okno, wykluczenia oraz decyzję. Analitycy audytują instrumentację, brakujące zdarzenia i miks pozyskania przed modelowaniem. Kohorty opisowe identyfikują miejsce spadku, model predykcyjny priorytetyzuje uczestników badania, a randomizowany eksperyment wprowadzający ocenia, czy proponowana zmiana poprawia retencję. Są to trzy odrębne analizy z osobnymi założeniami i wynikami.
Notatnik, zapytania, migawka danych, definicja metryki i plan eksperymentu są wersjonowane i poddawane recenzji. Wyniki podają wielkość efektu i niepewność z zabezpieczeniami dotyczącymi zapotrzebowania na wsparcie i dostępności. Pulpit monitoruje eksperyment, ale nie zastępuje wcześniej określonej analizy. Jeśli interwencja odniesie sukces, wdrożenie pozostaje etapowe i sprawdza zachowanie w dłuższym okresie. Praca jest uznawana za wartościową tylko wtedy, gdy wspiera reprodukowalną decyzję, a nie dlatego, że powstał złożony model lub wizualnie atrakcyjny wykres.
Dowody wdrożeniowe i gotowość operacyjna
Decyzja produkcyjna wymaga więcej niż udanej demonstracji. Określ docelowych użytkowników, środowisko operacyjne, wejścia, wyjścia, zależności, właściciela oraz konsekwencje każdego istotnego błędu. Ustal reprodukowalną bazę i wersjonowany zestaw ewaluacyjny przed strojeniem. Testuj typowe przypadki, warunki brzegowe, nieprawidłowe lub brakujące dane wejściowe, przesunięcie rozkładu, awarię zależności, niewłaściwe użycie oraz grupy lub środowiska najprawdopodobniej niedoszacowane. Mierz jakość zadania wraz z kalibracją lub niepewnością, opóźnieniem, przepustowością, kosztami zasobów, dostępnością, prywatnością i bezpieczeństwem. Zapisz każdą transformację i próg, aby niezależny recenzent mógł odtworzyć wynik i odróżnić dowód od atrakcyjnego prototypu.
Przed uruchomieniem przydziel uprawnienia do wydania, wyjątków, zmian, wycofania i wycofania. Stosuj etapowe wdrożenie, zachowaj bezpieczną rezerwę i weryfikuj monitorowanie przy celowo wprowadzonych awariach. Telemetria operacyjna powinna ujawniać jakość danych wejściowych, zachowanie wyjść, wersję modelu lub reguły, stan zależności, interwencje ludzkie oraz potwierdzone wyniki, nie gromadząc niepotrzebnych danych wrażliwych. Określ progi alarmowe i właściciela reakcji, a następnie przeglądaj dowody z rzeczywistego świata po wdrożeniu, zamiast zakładać, że offline’owa wydajność utrzyma się. Przeprowadzaj ponowną ocenę przy zmianie źródeł danych, użytkowników, modeli, dostawców, polityk, sprzętu lub celów. Utrzymany system wymaga także udokumentowanego przywracania, nauki z incydentów, procedur usuwania i przechowywania oraz wyraźnego punktu, w którym powinien zostać wyłączony lub zastąpiony.
Najczęściej zadawane pytania
Czy data science jest tym samym co data analytics?
Terminy częściowo się pokrywają. Data science często obejmuje tworzenie produktów danych i systemów predykcyjnych, podczas gdy analytics może skupiać się bardziej na opisowym i diagnostycznym wsparciu decyzji. Zastosowanie w organizacjach jest zróżnicowane.
Czy każdy projekt data science wymaga AI?
Nie. Dobrze zaprojektowane zapytanie, wykres, eksperyment lub estymacja statystyczna mogą być bardziej użyteczne i wiarygodne niż złożony model.
Podstawowe źródła