
Podstawy AI
Czym jest przeuczenie?

 Dodaj Unite.AI do preferowanych źródeł w Google
Overfitting występuje, gdy model przechwytuje wzorce lub szum, które działają wyjątkowo dobrze na danych treningowych, ale nie potrafią uogólnić się na nowe przykłady. Model przeuczony może mieć bardzo niski błąd treningowy, podczas gdy wydajność na walidacji lub w rzeczywistych warunkach jest znacznie gorsza.
Przeciwieństwem jest underfitting: model lub proces treningowy nie jest w stanie uchwycić wystarczającej części sygnału nawet na zbiorze treningowym. Dobre modelowanie równoważy dopasowanie z uogólnieniem, zamiast dążyć do perfekcyjnej wydajności treningowej.
Kluczowe wnioski
- Wydajność treningowa sama w sobie nie pozwala zdiagnozować uogólnienia.
- Wczesne zatrzymanie powinno opierać się na zachowaniu walidacji, nigdy nie powtarzając decyzji na ostatecznym zbiorze testowym.
- Więcej danych może pomóc, ale więcej cech lub większa pojemność może również nasilić przeuczenie.
- Regularizacja, augmentacja, walidacja krzyżowa, zapobieganie wyciekom oraz odpowiednia ewaluacja rozwiązują różne przyczyny.
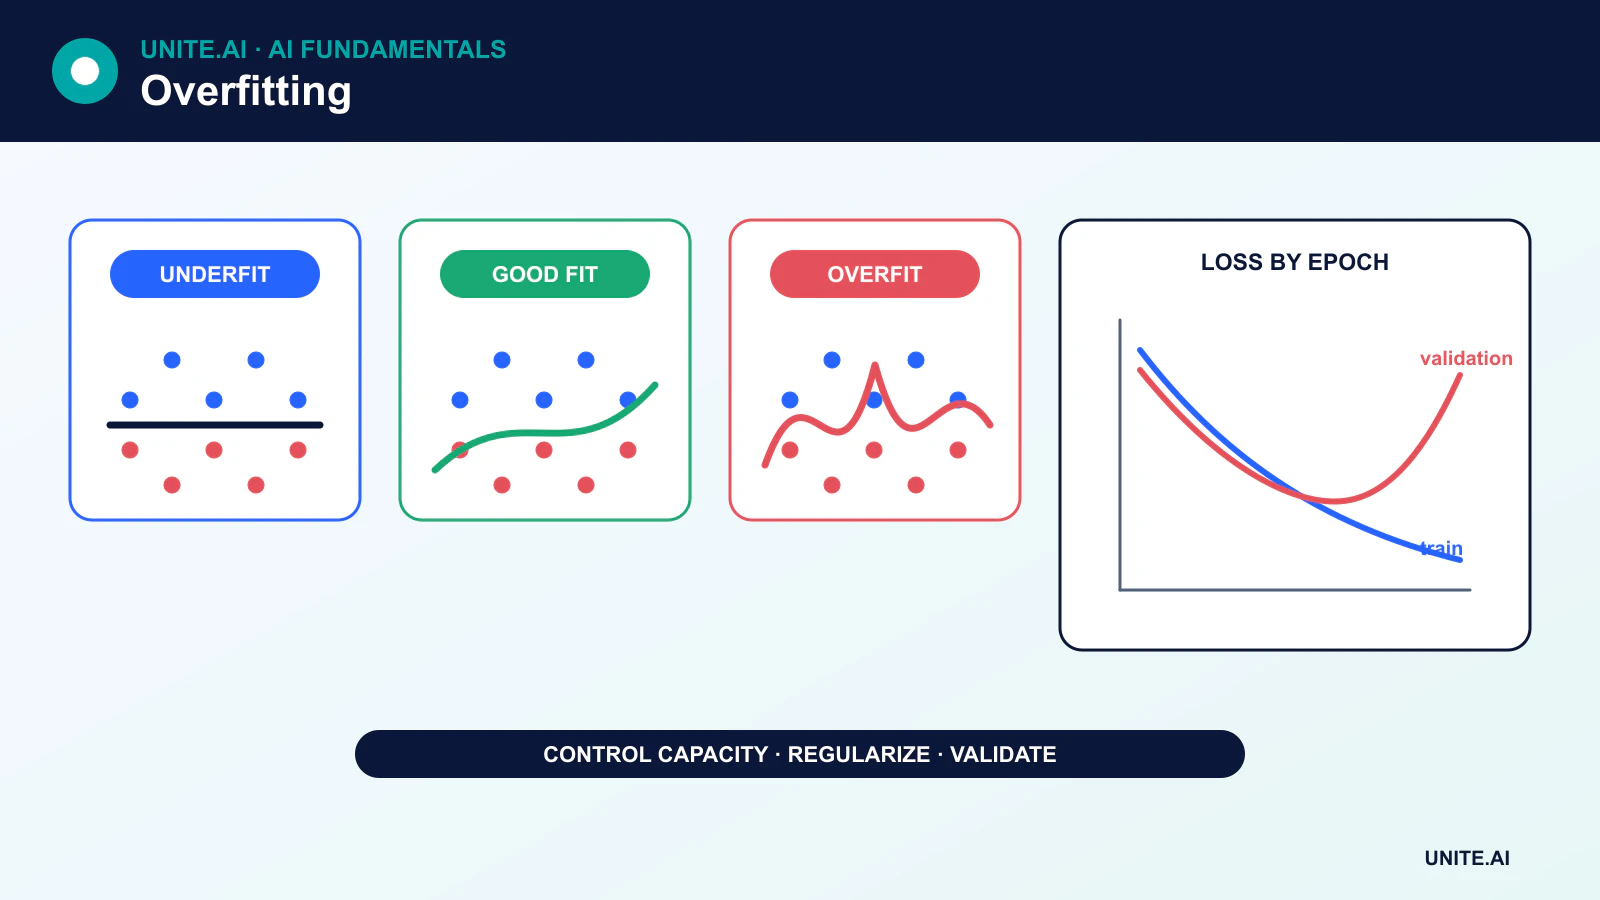
Dopasowanie, niedopasowanie i przeuczenie
Model niedopasowuje się, gdy jego założenia są zbyt restrykcyjne, cechy pomijają istotny sygnał, optymalizacja jest niewystarczająca lub trening jest niewystarczający. Dodanie odpowiednich cech lub zwiększenie pojemności może pomóc, ale proste dodanie dowolnych cech może zwiększyć szum i przeuczenie.
Model przeucza się, gdy jego efektywna pojemność jest zbyt wysoka w stosunku do informacji zawartych w danych treningowych. Przykłady obejmują głębokie drzewo decyzyjne tworzące małe liście, wielomian podążający za losowymi fluktuacjami lub sieć neuronową zapamiętującą przykłady.
Rola danych treningowych, walidacyjnych i testowych
- Training data dopasowuje parametry modelu.
- Validation data wybiera architekturę, hiperparametry, progi i moment zatrzymania.
- Test data zapewnia ostateczną ocenę po zakończeniu tych wyborów.
Jeśli zestaw testowy wielokrotnie kieruje decyzjami, staje się częścią procesu rozwoju i nie zapewnia już bezstronnej ostatecznej oceny. Walidacja krzyżowa może efektywniej wykorzystać ograniczone dane, ale wszystkie przetwarzania wstępne i wybór cech muszą odbywać się wewnątrz każdego podziału treningowego.
Wczesne zatrzymanie
Podczas treningu strata treningowa zazwyczaj nadal spada. Strata walidacyjna może początkowo spadać, a później rosnąć, gdy model specjalizuje się w szumie treningowym. Wczesne zatrzymanie zapisuje punkt kontrolny z najlepszym celem walidacyjnym lub zatrzymuje się po tym, jak walidacja nie poprawia się przez określony okres cierpliwości.
Prawidłowy punkt kontrolny nie jest tym, który ma najniższą stratę treningową. Oddzielny ostateczny zestaw testowy jest oceniany po zakończeniu wczesnego zatrzymania i decyzji dotyczących strojenia.
Metody regularizacji
Kary wagowe
Regularizacja L2 lub zanikanie wag (weight decay) zniechęca do dużych wartości parametrów. Regularizacja L1 może promować rzadkie współczynniki. Ich wpływ zależy od modelu i optymalizatora; na przykład AdamW oddziela zanikanie wag od adaptacyjnej aktualizacji.
Dropout i regularizacja stochastyczna
Dropout losowo maskuje aktywacje podczas treningu. Inne metody usuwają ścieżki, zakłócają cechy lub wygładzają etykiety. Techniki te zmieniają cel treningowy i muszą być wyłączone lub odpowiednio obsłużone podczas wnioskowania.
Augmentacja danych
Augmentacja tworzy realistyczne wariacje — takie jak przycięcia, obroty, szum czy parafrazy — które powinny zachować cel. Nieprawidłowe transformacje mogą zmienić etykietę i zaszkodzić modelowi. W dziedzinie wizji narzędzia takie jak Albumentations pomagają wdrożyć kontrolowane pipeline’y.
Kontrola pojemności
Płytsze drzewa, mniejsza liczba parametrów, wybór cech, przycinanie i prostsze klasy hipotez mogą zmniejszyć wariancję. Przycinanie drzew jest oparte na kryteriach, a nie losowym usuwaniu wyuczonych szczegółów.
Wycieki danych mogą wyglądać jak wyjątkowa wydajność
Wycieki występują, gdy informacje niedostępne w czasie predykcji trafiają do treningu lub ewaluacji. Typowe przykłady to dopasowywanie normalizacji na pełnym zbiorze danych, dzielenie powtarzających się rekordów pomiędzy podziały, używanie przyszłych danych do przewidywania przeszłości lub uwzględnianie cechy wyprowadzonej z celu.
Wycieki nie są zwykłym przeuczeniem, ale tworzą tę samą mylną lukę między wynikami offline a wdrożeniem. Strategia podziału powinna respektować czas, tożsamość, lokalizację i procesy generowania danych.
Przesunięcie rozkładu to odrębny problem
Model może uogólnić się do swojego rozkładu testowego i nadal zawieść, gdy dane produkcyjne się zmieniają. Nowe urządzenia, polityki, populacje, sezony lub zachowania adwersarialne mogą zmienić zależność wejścia od celu. Monitorowanie i okresowa ponowna ocena są konieczne, nawet gdy pierwotny model nie był przeuczony.
Diagnozowanie przeuczenia
Używaj krzywych uczenia, wariancji walidacji krzyżowej, metryk podgrup, kalibracji i analizy błędów. Jeśli zarówno wydajność treningowa, jak i walidacyjna są słabe, skup się na niedopasowaniu, cechach, etykietach lub optymalizacji. Jeśli trening jest silny, a walidacja słaba, zbadaj pojemność, wycieki, regularizację i reprezentatywność przed prostym gromadzeniem większej ilości danych.
Dlaczego dochodzi do przeuczenia i jak je wykrywać
Przeuczenie występuje, gdy model uczy się wzorców, które zmniejszają błąd treningowy, ale nie uogólniają się na docelową populację. Przyczyny obejmują nadmierną pojemność w stosunku do efektywnych danych, szum w etykietach, powtarzające się jednostki, elastyczny wybór cech, wycieki oraz strojenie względem tego samego zestawu walidacyjnego. Rosnąca luka między wydajnością treningową a walidacyjną jest powszechnym dowodem, ale mała luka nie wyklucza przeuczenia, jeśli oba zestawy są skażone lub różnią się od środowiska wdrożeniowego. Krzywe uczenia w zależności od objętości danych i pojemności pomagają odróżnić wariancję od biasu.
Wycieki są szczególnie zwodnicze: informacje z przyszłości, duplikaty, nakładanie się podmiotów, dopasowywanie przetwarzania wstępnego do wszystkich danych lub etykiety zakodowane w metadanych mogą dawać doskonałe wyniki na odrzuconych danych. Podziel według jednostki, która będzie nowa przy wdrożeniu — pacjenta, klienta, maszyny, lokalizacji lub czasu — przed dopasowaniem transformacji lub augmentacji. Trzymaj ostateczny zestaw testowy zamknięty podczas wyboru cech, architektury i progów. Jeśli zespoły wielokrotnie przeglądają wyniki testu, zestaw testowy staje się kolejnym zestawem walidacyjnym i wymaga wymiany lub formalnej korekty.
Regularizacja, wybór modelu i dryf produkcyjny
Zredukuj przeuczenie, używając bardziej reprezentatywnych danych, niższej pojemności, zaniku wag, dropoutu, wczesnego zatrzymania, augmentacji, zespołowania lub ograniczeń odzwierciedlających strukturę domeny. Każda metoda ma kompromisy: augmentacja może zniekształcać etykiety, dropout zmienia optymalizację, a zespoły zwiększają koszt serwowania. Walidacja krzyżowa szacuje zmienność wyboru, ale grupowane lub uwzględniające czas podziały muszą zachować granicę wdrożenia. Porównaj z prostym modelem i raportuj niepewność w podziałach lub losowych seedach, zamiast wybierać najkorzystniejszy przebieg.
Produkcja może ujawnić inną formę niepowodzenia uogólnienia, gdy zmieniają się wejścia, użytkownicy, zachęty lub pomiary. Monitoruj rozkłady cech i prognoz, kalibrację, wyniki podgrup oraz opóźnioną prawdziwą wartość. Nie przeprowadzaj automatycznego ponownego treningu na niezweryfikowanych opiniach; decyzje modelu mogą kształtować etykiety, które później widzi. Zdiagnozuj, czy awaria wynika z dryfu, potoków danych, zmian polityki czy nieprawidłowego celu. Przeuczenie jest kontrolowane przez projekt eksperymentu i dyscyplinę cyklu życia, a nie jedną ustawienie regularizacji.
Przykład praktyczny: eliminacja wycieków w modelu oszustw
Początkowy klasyfikator oszustw uzyskuje bardzo wysokie wyniki, ponieważ powtarzające się zdarzenia kart i sprzedawców pojawiają się w losowych wierszach treningowych i testowych, a informacje o chargebackach zarejestrowane kilka tygodni później są uwzględniane jako cecha. Zespół odtwarza czas dostępności każdej cechy, usuwa pola po podjęciu decyzji, grupuje według konta i stosuje podział w czasie w przód. Wydajność spada gwałtownie, ale teraz szacuje rzeczywistą decyzję. Prosta baza reguł i krzywe uczenia kierują wymaganą złożonością modelu.
Regularizacja i wczesne zatrzymanie są strojonе tylko w ramach historycznych podziałów. Ostateczna ewaluacja raportuje precyzję przy pojemności przeglądu, czułość, kalibrację i koszt według typu oszustwa oraz segmentu klienta. W produkcji potwierdzone etykiety przychodzą późno i są obciążone tym, które transakcje zostały przeglądnięte, więc monitorowanie oddziela dryf wyniku od szacunków rezultatów. Ponowne trenowanie wykorzystuje przypadki rozstrzygnięte i odtwarza je względem bieżącej polityki. Projekt woli niższą, uczciwą ocenę niż wysoką, wyciekłą, której nie utrzyma się w środowisku produkcyjnym.
Dowody wdrożeniowe i gotowość operacyjna
Decyzja o wdrożeniu wymaga więcej niż udanej demonstracji. Zdefiniuj docelowych użytkowników, środowisko operacyjne, wejścia, wyjścia, zależności, właściciela oraz konsekwencje każdego istotnego błędu. Ustal odtwarzalną bazę i wersjonowany zestaw ewaluacyjny przed strojeniem. Testuj typowe przypadki, warunki brzegowe, nieprawidłowe lub brakujące dane wejściowe, przesunięcie rozkładu, awarie zależności, niewłaściwe użycie oraz grupy lub środowiska najprawdopodobniej niedostatecznie obsłużone. Mierz jakość zadania wraz z kalibracją lub niepewnością, opóźnieniem, przepustowością, kosztami zasobów, dostępnością, prywatnością i bezpieczeństwem. Zarejestruj każdą transformację i próg, aby niezależny recenzent mógł odtworzyć wynik i odróżnić dowód od atrakcyjnego prototypu.
Przed uruchomieniem przydziel odpowiedzialność za wydanie, wyjątki, zmiany, wycofanie i wycofanie. Stosuj stopniowe wdrażanie, zachowaj bezpieczną alternatywę i zweryfikuj monitorowanie poprzez celowo wprowadzane awarie. Telemetria operacyjna powinna ujawniać jakość danych wejściowych, zachowanie wyjścia, wersję modelu lub reguły, stan zależności, interwencje ludzkie oraz potwierdzone wyniki, nie gromadząc niepotrzebnych wrażliwych danych. Zdefiniuj progi alarmowe i właściciela reakcji, a następnie przeglądaj dowody z rzeczywistego świata po wdrożeniu, zamiast zakładać, że wydajność offline będzie trwała. Ponownie oceniaj, gdy zmieniają się źródła danych, użytkownicy, modele, dostawcy, polityki, sprzęt lub cele. Utrzymany system wymaga także udokumentowanego odzyskiwania, nauki z incydentów, procedur usuwania i przechowywania oraz wyraźnego momentu, w którym powinien zostać wyłączony lub zastąpiony.
Często zadawane pytania
Czy prosty model może się przeuczyć?
Tak. Powtarzający się wybór cech, strojenie progów lub ewaluacja na tym samym odrzuconym zbiorze może przeuczyć proces rozwoju, nawet gdy ostateczny model jest prosty.
Czy więcej danych treningowych zawsze rozwiązuje problem przeuczenia?
Nie. Więcej reprezentatywnych, prawidłowo oznakowanych danych może pomóc, ale duplikowane, uprzedzone, wyciekające lub spoza domeny dane mogą nie przynieść korzyści. Cel uczenia i projekt ewaluacji nadal mają znaczenie.
Podstawowe źródła












