
Podstawy AI
Gotowe vs. Niestandardowe Modele Uczenia Maszynowego

 Dodaj Unite.AI do preferowanych źródeł w Google
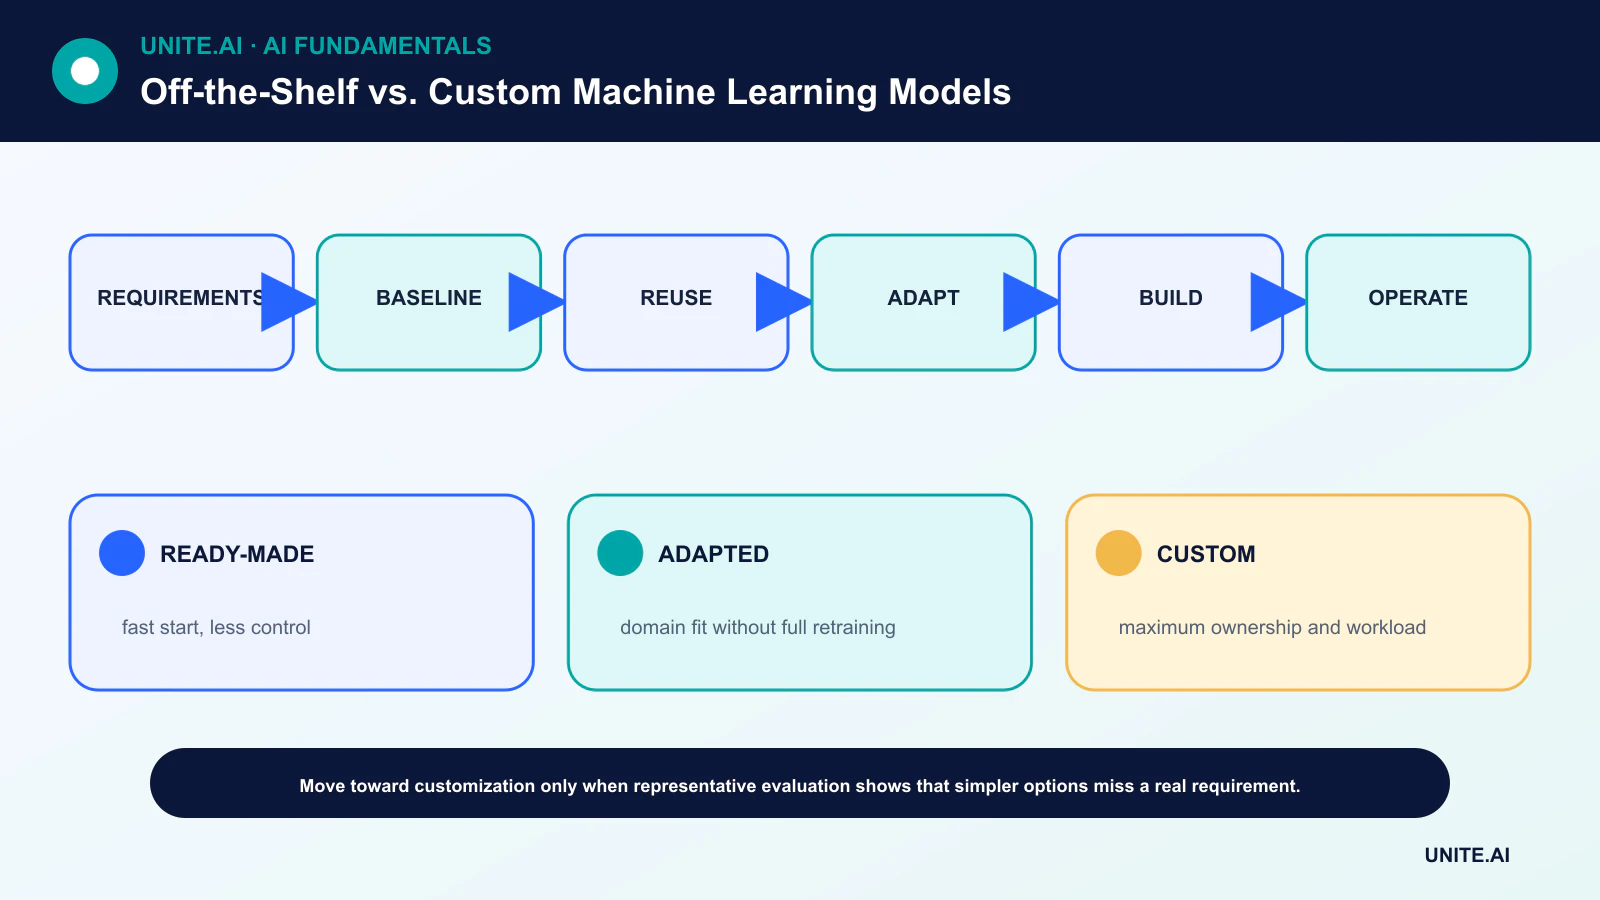
Wybór rozwiązania uczenia maszynowego rzadko jest prostą decyzją „kup vs. buduj”. Rzeczywisty kontinuum rozciąga się od hostowanego API lub gotowego modelu, przez promptowanie, wyszukiwanie i dostrajanie, aż po w pełni niestandardową architekturę trenowaną na danych specyficznych dla organizacji.
Najlepszą opcją jest najprostsze podejście, które spełnia zweryfikowane wymagania produktu. Niestandardowy model może zapewnić kontrolę i wyróżnienie, ale jednocześnie nakłada stały obowiązek zarządzania potokami danych, ocenami, monitorowaniem, bezpieczeństwem, aktualizacjami i przywracaniem poprzednich wersji.
Kluczowe wnioski
- Rozpocznij od mierzalnego zadania, nie‑ML bazowego rozwiązania oraz progów akceptacji.
- Ocenić modele kandydatów na reprezentatywnych prywatnych danych, a nie wyłącznie na podstawie wyników publicznych benchmarków.
- Uwzględnij koszty integracji, opóźnień, przeglądów, ponownego treningu i incydentów w całkowitym koszcie posiadania.
- Preferuj odwracalne etapy: bazowy, wyszukiwanie lub prompt, dostrajanie, a dopiero trenowanie od zera, gdy dowody to uzasadniają.
Zdefiniuj decyzję przed wyborem modelu
Określ użytkownika, decyzję, wejście, wyjście, koszty błędów, budżet opóźnień, wzorzec ruchu oraz ścieżkę eskalacji. Zdecyduj, czy deterministyczna reguła lub system wyszukiwania rozwiązuje wystarczającą część problemu. Zasady ML od Google zalecają proste rozwiązania bazowe i wiarygodną infrastrukturę przed zastosowaniem złożonych modeli.
Utwórz zestaw oceny offline odzwierciedlający środowisko produkcyjne, włączając rzadkie i adwersarialne przypadki. Gdy decyzje wpływają na ludzi, określ kontrole podgrup oraz zasady przeglądu ludzkiego. Te bramki czynią porównania konkretnymi, zamiast przekształcać wybór architektury w preferencję.
Kontinuum ponownego użycia i adaptacji
Hostowane API zapewnia szybką integrację i zarządzane skalowanie, ale ograniczoną kontrolę nad wewnętrzną strukturą modelu, wersjami i obsługą danych. Otwarty model wstępnie wytrenowany zwiększa kontrolę nad wdrożeniem. Wyszukiwanie lub prompt engineering może dodać kontekst domenowy bez zmiany wag.
Dostrajanie lub adaptery o wysokiej efektywności parametrów mogą specjalizować zachowanie. Trening od zera jest uzasadniony tylko wtedy, gdy dane, cel, skala lub wymóg własności nie mogą być spełnione poprzez ponowne użycie. Transfer learning często uchwyca większość wartości przy znacznie mniejszej ilości danych i mocy obliczeniowej.
Jakość, kontrola i uzależnienie
Mierz jakość zadania, kalibrację, opóźnienia, przepustowość, dostępność oraz spójność awarii. Model dostawcy może automatycznie się ulepszać, ale może też zmienić zachowanie; model samodzielnie hostowany można „przytwierdzić”, ale wymaga od zespołu zarządzania aktualizacjami i podatnościami.
Warunki umowne powinny obejmować przechowywanie danych, wykorzystanie do treningu, przetwarzanie regionalne, własność intelektualną, poziomy usług, ścieżki eksportu i wycofywanie. Przenośność rośnie, gdy aplikacja oddziela adaptery specyficzne dla modelu od logiki biznesowej i przechowuje powtarzalne artefakty oceny.
Prywatność, bezpieczeństwo i operacje
Zmapuj każdy przepływ danych i granicę zagrożenia. Wrażliwe dane wejściowe mogą wymagać prywatnej sieci, inferencji on‑premises lub edge AI. Samodzielne hostowanie nie czyni systemu automatycznie bezpiecznym; przenosi odpowiedzialność za bezpieczeństwo i zgodność na operatora.
Właściciel produkcji obejmuje obserwowalność, kontrole dryfu, monitorowanie nadużyć, reakcję na incydenty i przywracanie poprzednich wersji. Zespół operacyjny musi być w stanie odpowiedzieć, który model, prompt, wersja danych i polityka wygenerowały dany wynik.
Używaj etapowych dowodów, nie ideologii
Przeprowadź ograniczony czasowo benchmark przy użyciu tego samego zestawu danych i kryteriów akceptacji dla wszystkich opcji. Oszacuj czas inżynieryjny, anotację, wykorzystanie akceleratorów, opłaty dostawcy, pracę przeglądającą, koszty awarii oraz przewidywaną częstotliwość zmian.
Wybierz najprostszy wariant, który przejdzie przez bramki, a następnie ponownie oceniaj go w miarę zmiany wymagań lub cen. Dostosowanie ma wartość, gdy przynosi wymierne korzyści lub niezbędną kontrolę — nie tylko dlatego, że dedykowany model brzmi strategicznie istotnie.
Wymagania i porównanie kosztów całkowitych
Gotowy model, API lub system w pakiecie zapewnia wstępnie zbudowane możliwości z wsparciem dostawcy i szybsze początkowe wdrożenie. Niestandardowy model jest trenowany lub znacząco adaptowany do konkretnego zadania, danych i środowiska operacyjnego. Wybór zaczyna się od wymagań: docelowy rezultat, jakość w podgrupach i przypadkach brzegowych, opóźnienie, przepustowość, dostępność, wyjaśnialność, lokalizacja danych, kontrola aktualizacji, integracja, bezpieczeństwo oraz konsekwencje awarii. Ogólny benchmark lub demo nie mogą odpowiedzieć, czy produkt spełnia te wymagania.
Całkowity koszt obejmuje ocenę, przygotowanie danych, etykietowanie, integrację, licencje lub użytkowanie, infrastrukturę, monitorowanie, przegląd, reakcję na incydenty, aktualizacje i wyjście. Gotowe rozwiązania obniżają początkowe koszty inżynieryjne, ale mogą generować zmienne koszty, uzależnienie, zmiany zachowań i ograniczoną obserwowalność. Niestandardowy rozwój dodaje odpowiedzialność za dane i MLOps oraz może nadal zależeć od wstępnie wytrenowanych wag i dostawców. Koszt modelu powinien być mierzony na podstawie udanego zadania przy wymaganej jakości, a nie na podstawie tokenu czy samego treningu.
Ocena, zamówienie i adaptacja
Stwórz reprezentatywny prywatny zestaw testowy przed wyborem dostawcy i przetestuj każdego kandydata przy identycznych promptach, przetwarzaniu wstępnym, progach i limitach operacyjnych. Uwzględnij przypadki niejednoznaczne, adwersarialne, nieobsługiwane, wielojęzyczne oraz o wysokich konsekwencjach. Mierz dokładność, kalibrację, opóźnienie, koszt, odrzuty, bezpieczeństwo oraz wpływ na przepływ pracy ludzi. Testuj awarie API, limity szybkości, zachowanie regionalne i zmiany wersji. Twierdzenia dostawcy wymagają dokumentacji dotyczącej treningu, praw, prywatności, przechowywania, podwykonawców, bezpieczeństwa, wsparcia i powiadamiania o incydentach.
Opcje adaptacji tworzą spektrum: konfiguracja, wyszukiwanie, promptowanie, dostrajanie, aktualizacje o wysokiej efektywności parametrów, niestandardowe głowy lub trening od zera. Użyj najprostszego sposobu, który spełnia dowody. Wyszukiwanie jest odpowiednie dla często zmieniającej się wiedzy; dostrajanie może kształtować format lub zachowanie domenowe; deterministyczny kod powinien obsługiwać dokładne reguły. Waliduj połączone systemy, ponieważ silny model bazowy może nadal zawieść z powodu słabego wyszukiwania, uprawnień lub integracji.
Planowanie cyklu życia i wyjścia
Produkty hostowane mogą się zmienić lub zniknąć, podczas gdy niestandardowe modele stają się długiem technicznym bez właścicieli. Monitoruj zależności wersji, zachowanie i wyniki, definiuj wyzwalacze ponownego treningu lub ponownej oceny oraz utrzymuj możliwość przywrócenia. Zachowaj dane i interfejsy potrzebne do migracji, negocjuj usunięcie i eksport oraz unikaj eksponowania własnościowego schematu jednego dostawcy w całej aplikacji. Najlepszy wybór może być hybrydowy: komercyjna zdolność do zadań standardowych oraz komponenty niestandardowe tam, gdzie wydajność domenowa, kontrola lub ryzyko tworzą trwałą wartość.
Przykładowe zastosowanie: wybór modelu ekstrakcji dokumentów
Firma tworzy prywatny zestaw testowy faktur od różnych dostawców, w różnych językach, skanach, odręcznym piśmie i przypadkach brzegowych, a następnie porównuje zarządzane API, otwarty model wstępnie wytrenowany, model adaptowany oraz bazowy zestaw reguł. Ocena obejmuje dokładność pól, błąd finansowy, nieobsługiwane dokumenty, opóźnienie, przepustowość, prywatność, lokalizację danych, integrację oraz koszt za prawidłowo przetworzoną fakturę. Demonstracje dostawcy i publiczne benchmarki nie zastępują tej dopasowanej oceny.
Wybrana hybryda korzysta z komercyjnej usługi OCR z lokalną weryfikacją i przeglądem ludzkim w przypadku niskiej pewności lub wysokich kwot. Umowy definiują przechowywanie, podwykonawców, aktualizacje i usuwanie; architektura zachowuje pliki źródłowe oraz ścieżkę wyjścia. Okres cieniowy wykrywa luki w schemacie i dostawcach. Monitorowanie oddziela OCR, ekstrakcję, weryfikację i korekty recenzentów. Jeśli zachowanie dostawcy się zmieni, zespół może zamrozić, przełączyć lub przenieść większą część pracy do własnego komponentu bez przepisywania przepływu finansowego.
Dowody wdrożenia i gotowość operacyjna
Decyzja produkcyjna wymaga więcej niż udanej demonstracji. Zdefiniuj docelowych użytkowników, środowisko operacyjne, wejścia, wyjścia, zależności, właściciela oraz konsekwencje każdego istotnego błędu. Ustal powtarzalną bazę oraz wersjonowany zestaw oceny przed dostrojeniem. Testuj typowe przypadki, warunki brzegowe, nieprawidłowe lub brakujące wejścia, przesunięcie rozkładu, awarie zależności, niewłaściwe użycie oraz grupy lub środowiska najprawdopodobniej niedostatecznie obsłużone. Mierz jakość zadania wraz z kalibracją lub niepewnością, opóźnieniem, przepustowością, kosztami zasobów, dostępnością, prywatnością i bezpieczeństwem. Zarejestruj każdą transformację i próg, aby niezależny recenzent mógł odtworzyć wynik i odróżnić dowody od atrakcyjnego prototypu.
Przed uruchomieniem przydziel uprawnienia do wydania, wyjątków, zmian, przywracania i wycofywania. Użyj etapowego wdrożenia, zachowaj bezpieczną alternatywę i zweryfikuj monitorowanie przy celowo wprowadzonych awariach. Telemetria operacyjna powinna ujawniać jakość danych wejściowych, zachowanie wyjścia, wersję modelu lub reguły, stan zależności, interwencje ludzkie oraz potwierdzone wyniki, bez zbierania niepotrzebnych wrażliwych danych. Zdefiniuj progi alarmowe i właściciela reakcji, a następnie przeglądaj dowody z rzeczywistego świata po wdrożeniu, zamiast zakładać, że offline wydajność utrzyma się. Ponownie oceniaj, gdy zmienią się źródła danych, użytkownicy, modele, dostawcy, polityki, sprzęt lub cele. Utrzymany system wymaga także udokumentowanej procedury odzyskiwania, nauki z incydentów, usuwania i przechowywania oraz wyraźnego punktu, w którym powinien zostać wyłączony lub zastąpiony.
Najczęściej zadawane pytania
Kiedy zespół powinien trenować model od podstaw?
Gdy opcje wstępnie wytrenowane lub hostowane nie mogą spełnić zweryfikowanych wymagań, a zespół dysponuje wystarczającymi własnymi danymi, mocą obliczeniową, wiedzą i długoterminową zdolnością operacyjną.
Czy gotowy model jest wolny od konserwacji?
Nie. Integracja, ocena, zmiany wersji, monitorowanie, kontrola prywatności i zachowanie awaryjne pozostają odpowiedzialnością użytkownika.
Podstawowe źródła











