
Podstawy AI
Czym jest inżynieria platformowa? Platformy, doświadczenie deweloperów i mechanizmy zabezpieczające

 Dodaj Unite.AI do preferowanych źródeł w Google
Inżynieria platformowa to praktyka budowania i utrzymywania współdzielonych wewnętrznych możliwości, które pomagają zespołom programistycznym dostarczać i uruchamiać aplikacje poprzez wspierane przepływy pracy typu self‑service. Platforma jest traktowana jak produkt, którego użytkownikami są deweloperzy i inne zespoły techniczne.
Platforma nie jest automatycznie portalem, klastrem Kubernetes ani zestawem skryptów. Staje się użyteczna, gdy zmniejsza obciążenie poznawcze i czas realizacji, jednocześnie podnosząc niezawodność, bezpieczeństwo, obserwowalność i spójność organizacyjną.
Kluczowe wnioski
- Rozpocznij od badań deweloperów i powtarzających się problemów, a nie od z góry określonego zestawu narzędzi.
- Oferuj opcjonalne, wspierane „złote ścieżki” z wyraźnymi możliwościami wyjścia dla uzasadnionych wyjątków.
- Udostępniaj możliwości poprzez API, szablony, automatyzację i dokumentację; portal to tylko jeden z interfejsów.
- Mierz wyniki użytkowników i przyjęcie produktu razem z dostawą, niezawodnością, bezpieczeństwem i kosztami.
Platforma jako wewnętrzny produkt
Zespół platformowy identyfikuje wewnętrznych użytkowników, ich ścieżki, problemy oraz pożądane rezultaty. Utrzymuje plan rozwoju, poziomy usług, dokumentację, wsparcie i pętle informacji zwrotnej, tak jak każdy zespół produktowy. Przyjęcie platformy wynika z jej użyteczności, a nie z narzuconego nazwania centralnego zespołu.
Rozszerza to współpracę DevOps. Zespoły aplikacyjne zachowują własność swoich usług, podczas gdy platforma dostarcza wielokrotnego użytku możliwości i zasady.
Możliwości, portale i złote ścieżki
Możliwości mogą obejmować repozytoria, środowiska, CI/CD, tajemnice, tożsamość, infrastrukturę, obserwowalność, katalogi usług, koszty oraz integrację incydentów. Portal deweloperski może je udostępniać, ale to orkiestracja i usługi operacyjne czynią platformę rzeczywistą.
Złota ścieżka to dobrze wspierany sposób realizacji typowego zadania. Powinna zawierać bezpieczne domyślne ustawienia i pozostawać przejrzysta. Zespoły potrzebują zarządzanej ścieżki wyjątkowej, gdy wymagania się różnią.
Architektura i mechanizmy zabezpieczające
Używaj stabilnych interfejsów i deklaratywnych API, aby platforma mogła się rozwijać za ich pomocą. Oddziel płaszczyznę sterującą od obciążeń, ogranicz zakres poświadczeń, zachowaj metadane własności i spraw, aby generowane zmiany były podlegające przeglądowi i odwracalne.
Zintegruj kontrole DevSecOps, zasady i pochodzenie artefaktów w przepływy pracy. Mechanizmy zabezpieczające powinny dostarczać szybką informację zwrotną i praktyczne rozwiązania, a nie nieuzasadnione odrzuty.
Mierzenie i rozwój
Mierz czas do pierwszego wdrożenia, lead time, odzyskiwanie po nieudanej zmianie, dostępność platformy, obciążenie wsparcia, przyjęcie, satysfakcję, stan bezpieczeństwa i koszty. Unikaj liczenia logowań do portalu jako wskaźnika poprawy dostawy.
Wyposaż platformę w praktyki operacji IT i regularnie przeprowadzaj wywiady z użytkownikami. Wycofaj nieużywane ścieżki, standaryzuj tam, gdzie powtarzalność jest kosztowna, i dopuszczaj różnorodność tam, gdzie tworzy ona wartość produktu.
Wewnętrzne platformy deweloperskie i złote ścieżki
Wewnętrzna platforma deweloperska to produkt, który udostępnia zatwierdzoną infrastrukturę i możliwości operacyjne poprzez interfejsy typu self‑service. Może łączyć portal, katalog usług, szablony, API, narzędzia wiersza poleceń, przepływy wdrożeń, tajemnice, środowiska i obserwowalność. Platforma nie zastępuje chmury ani Kubernetes; organizuje je w użyteczne możliwości.
Złota ścieżka to nacechowany opinią, wspierany sposób realizacji typowego zadania, np. tworzenia usługi z repozytorium, potoku CI, środowiska uruchomieniowego, pulpitów, alertów i metadanych własności. Powinna być najłatwiejszą i najbezpieczniejszą opcją, jednocześnie dopuszczając uzasadnione wyjątki. Wymuszona ścieżka, która nie może obsłużyć rzeczywistych obciążeń, staje się wąskim gardłem lub jest omijana.
Zespoły platformowe powinny traktować deweloperów jako klientów, a możliwości jako produkty. Wywiady odkrywcze, analizy użycia, dane wsparcia, plany rozwoju, dokumentacja i cele poziomu usług są tak ważne jak automatyzacja. Przyjęcie jest dowodem użyteczności, ale samo przyjęcie nie dowodzi, że dostawa, niezawodność, bezpieczeństwo czy doświadczenie dewelopera się poprawiły.
Płaszczyzny sterujące, interfejsy i model operacyjny
Płaszczyzna sterująca platformy dopasowuje zadeklarowaną intencję dewelopera do zasobów podstawowych. Definicja usługi może żądać środowiska uruchomieniowego, bazy danych, regionu i poziomu niezawodności; kontrolery przekształcają to w konfigurację chmury, sieci, zasad i obserwowalności. Stabilne abstrakcje powinny ukrywać przypadkową złożoność, nie zasłaniając jednak stanu operacyjnego potrzebnego do debugowania.
Interfejsy mogą obejmować portale internetowe, API, konfigurację opartą na Git, CLI oraz wielokrotnego użytku komponenty potoków. Najlepszy interfejs zależy od częstotliwości zadań i przepływu pracy użytkownika. Każdy interfejs wymaga uwierzytelniania, autoryzacji, walidacji, historii audytu, wyjaśnień błędów i wersjonowania. Self‑service bez zarządzania cyklem życia prowadzi do porzuconych zasobów i rozrostu konfiguracji.
Zespół platformowy posiada wspólne możliwości i wytyczone ścieżki, podczas gdy zespoły aplikacyjne zachowują odpowiedzialność za zachowanie oprogramowania i wyniki biznesowe. Zespoły ds. bezpieczeństwa, niezawodności, finansów i infrastruktury wnoszą zasady i usługi. Wyraźne granice odpowiedzialności zapobiegają przekształceniu platformy w nieodpowiedzialną kolejkę zgłoszeń lub w próbę centralizacji każdej decyzji inżynieryjnej.
Mierzenie wartości i unikanie awarii platformy
Mierz lead time do pierwszego wdrożenia produkcyjnego, czas przygotowania środowiska, częstotliwość wdrożeń, wskaźnik niepowodzeń zmian, czas odzyskiwania, obciążenie poznawcze, wolumen wsparcia, niezawodność oraz przyjęcie kontroli bezpieczeństwa. Segmentuj wyniki według zespołu i obciążenia. Szybsze uruchomienie szablonu ma ograniczoną wartość, jeśli zmiany po pierwszym dniu pozostają wolne lub incydenty trudniej diagnozować.
Typowe niepowodzenia obejmują budowanie przed zrozumieniem użytkowników, kopiowanie stosu dużej firmy, udostępnianie surowej infrastruktury za portalem, wymuszanie przedwczesnej standaryzacji oraz optymalizację pod kątem wydajności zespołu platformowego. Zacznij od jednej bolesnej, powtarzającej się ścieżki, zmapuj jej kroki i oczekiwania, dostarcz lekką ścieżkę end‑to‑end i iteruj, wykorzystując obserwowane wyniki.
Platformy muszą się rozwijać, nie destabilizując każdej usługi. Stosuj wersjonowane kontrakty, okna wycofywania, automatyczne migracje, testy kompatybilności i jasną własność. Śledź zależności platformy, aby awaria płaszczyzny sterującej nie blokowała wszystkich wdrożeń ani nie uszkadzała działających obciążeń. Dokumentuj procedury awaryjne (break‑glass) i regularnie testuj odzyskiwanie po awarii platformy.
Przykładowe zastosowanie: ścieżka self‑service dla nowego API
Deweloper wybiera zatwierdzony szablon API i podaje nazwę usługi, właściciela, klasyfikację danych, język oraz poziom niezawodności. Platforma tworzy repozytorium, politykę zależności, potok CI, środowisko testowe, konfigurację wdrożenia, wpis w katalogu usług, pulpity, alerty oraz początkowy runbook. Polityka weryfikuje nazwy, regiony, uprawnienia i ekspozycję sieciową przed provisioningiem, a wygenerowane artefakty pozostają poddane inspekcji i własności zespołu.
Platforma udostępnia operacje cyklu życia — tworzenie środowiska, wdrożenie, skalowanie, rotację tajemnicy, przeglądanie logów, wycofanie i wycofanie — poprzez stabilne API i portal. Działające obciążenia kontynuują pracę, jeśli portal jest niedostępny. Wyjątki wykorzystują udokumentowany punkt rozszerzenia i termin wygaśnięcia, zamiast nieśledzonej ręcznej zmiany. Wersjonowane szablony i automatyczne migracje zapobiegają cichej awarii istniejących usług w wyniku ulepszeń platformy.
Mierz czas od utworzenia repozytorium do zdrowego wdrożenia produkcyjnego, wysiłek dewelopera, zapotrzebowanie na wsparcie, niepowodzenia zmian, odzyskiwanie, zgodność z polityką oraz przyjęcie według typu obciążenia. Przeprowadzaj wywiady z użytkownikami, którzy porzucają ścieżkę, i analizuj, gdzie czekają lub omijają abstrakcję. Zespół platformowy powinien priorytetyzować największe powtarzające się problemy, publikować informacje o niezawodności i roadmapie oraz wycofywać nieużywane możliwości. Wypolerowany katalog nie jest platformą, jeśli zespoły wciąż potrzebują zgłoszeń do każdej istotnej operacji.
Przyjęcie powinno odbywać się etapowo. Zacznij od zespołów ochotników i jednej klasy obciążenia, udowodnij operacje po pierwszym dniu, a następnie migruj z narzędziami i wsparciem. Publikuj cele usług platformy i status zależności oraz zaprojektuj trasę awaryjną (break‑glass), która jest kontrolowana, ale użyteczna podczas awarii. Model chargeback lub showback może ujawnić koszty zasobów, ale zespoły produktowe potrzebują także rozsądnych domyślnych ustawień, aby zarządzanie finansami nie stało się kolejną kolejką ręcznych zatwierdzeń.
Praktyczna lista kontrolna wdrożenia
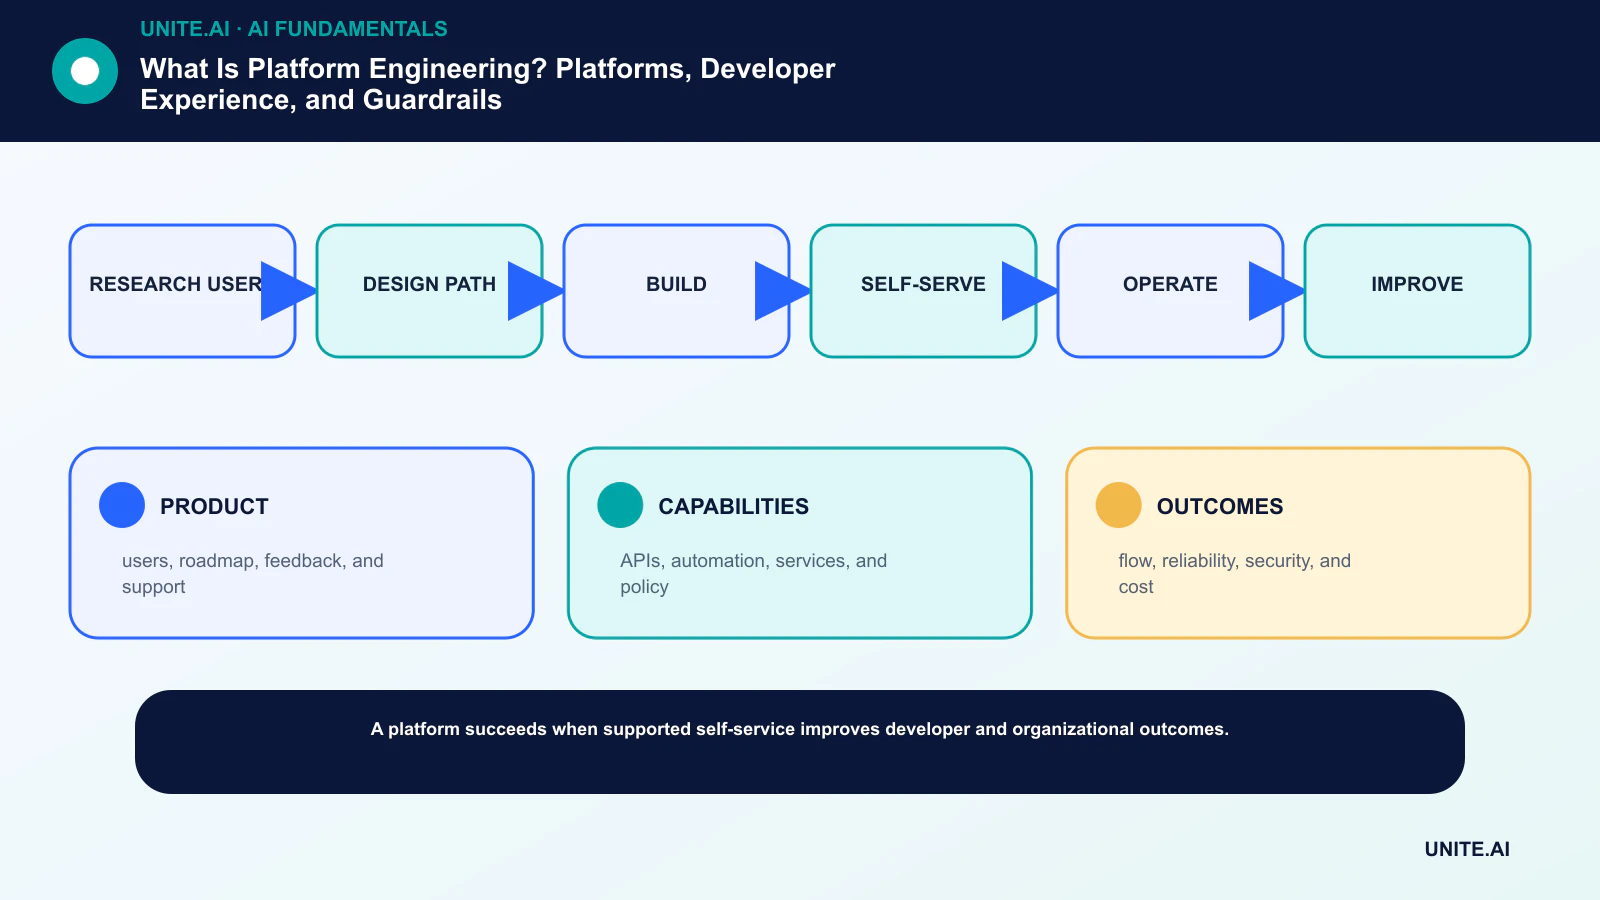
Przekształć koncepcję w ograniczony, testowalny przepływ pracy: badanie użytkowników → projektowanie ścieżki → budowa → self‑service → operacje → usprawnienia. Wyznacz odpowiedzialnego właściciela, udokumentuj dane i zależności, ustal prostą bazę odniesienia, określ kryteria akceptacji i zakończenia, przetestuj reprezentatywne awarie oraz zdefiniuj monitorowanie, wycofanie i przegląd przed rozszerzeniem zakresu. Zapisz wersje i założenia, aby inny zespół mógł odtworzyć wynik i zrozumieć, co się zmieniło.
Przed uruchomieniem przeprowadź udokumentowany przegląd gotowości z osobami, które budują, obsługują, zabezpieczają i są dotknięte systemem. Testuj przypadki normalne, warunki brzegowe, awarie zależności i niewłaściwe użycie; zachowaj dowody i nierozwiązane ryzyka. Określ, kto może zatwierdzić wydanie, zmienić próg, obejść wynik lub zatrzymać operację. Ponownie rozważ decyzję po otrzymaniu danych z rzeczywistości, ponieważ technicznie udany pilot nie gwarantuje niezawodnej wydajności na większą skalę.
- PRODUKT: użytkownicy, plan rozwoju, opinie i wsparcie.
- CAPABILITIES: API, automatyzacja, usługi i zasady.
- OUTCOMES: przepływ, niezawodność, bezpieczeństwo i koszty.
Najczęściej zadawane pytania
Czy inżynieria platformowa zastępuje DevOps?
Nie. Inżynieria platformowa to jeden ze sposobów skalowania zasad DevOps poprzez dostarczanie współdzielonych produktów i możliwości self‑service. Współpraca i własność usług pozostają kluczowe.
Czy wewnętrzny portal deweloperski jest platformą?
Zazwyczaj nie. Portal jest interfejsem. Platforma obejmuje także API, automatyzację, infrastrukturę, zasady, usługi, dokumentację, wsparcie i własność operacyjną.
Podstawowe źródła











