
Podstawy AI
Czym jest automatyzacja incydentów? Przepływy pracy, zabezpieczenia i przypadki użycia

 Dodaj Unite.AI do preferowanych źródeł w Google
Automatyzacja incydentów wykorzystuje oprogramowanie do wykrywania, wzbogacania, kierowania, koordynowania, a czasem także naprawiania incydentów operacyjnych lub bezpieczeństwa. Łączy sygnały monitoringu z runbookami, systemami zgłoszeń, komunikacją, kontrolą dostępu i działaniami przywracania, dzięki czemu reagujący spędzają mniej czasu na kopiowaniu danych, a więcej na podejmowaniu decyzji.
Automatyzacja nie oznacza usunięcia odpowiedzialności człowieka. Bezpieczny program odróżnia niskiego ryzyka kroki deterministyczne od działań, które mogą wpływać na klientów lub produkcję, a następnie stosuje zatwierdzenia, ograniczone poświadczenia, ścieżki audytu, limity czasu i przywracanie zgodnie z wpływem.
Kluczowe wnioski
- Automatyzuj powtarzalne zbieranie dowodów przed próbą autonomicznej naprawy.
- Używaj kryteriów: nasilenie, pewność, promień rażenia i odwracalność, aby wybrać poziom zatwierdzenia.
- Traktuj każdy runbook jako wersjonowany kod produkcyjny z testami i właścicielem.
- Mierz wykrycie, potwierdzenie, odzyskanie, ponowne wystąpienie i wpływ na użytkownika — nie tylko liczbę alertów.
Od sygnału do skoordynowanej reakcji
Przepływ pracy może odfiltrować duplikaty alertów, dołączyć ostatnie wdrożenia i logi, zidentyfikować właściciela usługi, otworzyć rekord incydentu, wezwać zespół dyżurny, utworzyć kanał komunikacji i rozpocząć oś czasu. Te kroki zmniejszają obciążenie poznawcze, nie dokonując automatycznie ryzykownej diagnozy.
Korelacja musi zachować dowody. Jeśli platforma zbyt agresywnie grupuje symptomy, może ukrywać równoczesne incydenty. Połącz automatyzację z własnością operacji IT i zachowaj surowe sygnały, które mogą być potrzebne reagującym.
Wybieraj działania według ryzyka
Zapytania tylko do odczytu, migawki i odwracalne przekierowania ruchu są zazwyczaj łatwiejsze do automatyzacji niż usuwanie danych, rotacja szerokich poświadczeń czy zmiana schematu produkcji. Zdefiniuj warunki wstępne, limit czasu wykonania, warunki końcowe i przywrócenie dla każdego działania.
Używaj tożsamości usługowych o najmniejszych uprawnieniach i oddziel autoryzację od silnika przepływu pracy. Kroki o dużym wpływie powinny wymagać zidentyfikowanego zatwierdzającego. Jeśli AIOps proponuje przyczynę lub rozwiązanie, reagujący nadal potrzebują dowodów wspierających oraz bezpiecznego sposobu odrzucenia ich.
Tworzenie niezawodnych runbooków
Runbook powinien określać wejścia, zależności, właściciela, zakres, zachowanie w przypadku awarii oraz generowane dowody. Przetestuj go w środowisku testowym oraz podczas symulacji (game days). Kroków idempotentnych jest wartość, ponieważ ich ponowne wykonanie nie powoduje dodatkowych szkód.
Wersjonuj i przeglądaj automatyzację tak jak inne oprogramowanie. Monitoruj wygaśnięcie poświadczeń, zmiany API, limity szybkości, częściowe wykonanie oraz ukryte powiązania między usługami. Procedury ręczne pozostają niezbędne, gdy platforma automatyzacji jest niedostępna.
Ucz się po odzyskaniu
Automatyzacja powinna zachować znacznikowany czasowo zapis sygnałów, decyzji, działań, zatwierdzeń i rezultatów. Bezkarna analiza może wtedy oddzielić warunki systemowe przyczyniające się od ostatecznego wyzwalacza i przekształcić wnioski w przetestowane ulepszenia.
Przydatne miary obejmują średni czas do potwierdzenia i przywrócenia, procent bezpiecznych kroków zautomatyzowanych, wskaźnik nieudanych działań, powtarzające się incydenty oraz wpływ na klientów. Powiąż wyniki z planowaniem DevOps, zamiast optymalizować liczbę zamkniętych zgłoszeń.
Rodzaje automatyzacji incydentów
Automatyzacja zdarzeń normalizuje i wzbogaca przychodzące sygnały. Automatyzacja koordynacji tworzy rekord incydentu, powiadamia właścicieli, otwiera kanały komunikacji i publikuje aktualizacje statusu. Automatyzacja diagnostyczna wykonuje zapytania tylko do odczytu lub tworzy migawki. Automatyzacja naprawcza zmienia stan systemu, natomiast automatyzacja odzyskiwania weryfikuje zdrowie usługi i zamyka tymczasowe środki zaradcze.
Te kategorie nie powinny mieć jednego domyślnego poziomu zaufania. Wzbogacanie może często działać automatycznie; przełączenie produkcyjne może wymagać kontroli pewności i zatwierdzającego; przywracanie danych zazwyczaj wymaga dowódcy incydentu i właściciela aplikacji. Kontrola powinna zależeć od potencjalnego wpływu, a nie od tego, czy krok jest realizowany przez regułę czy model uczenia maszynowego.
Incydenty bezpieczeństwa wprowadzają dodatkowe wymagania dotyczące zachowania dowodów. Automatyzacja musi unikać modyfikacji zhakowanego hosta przed zebraniem danych tymczasowych, ujawniania wrażliwych wskaźników w publicznych kanałach lub kwarantanny współdzielonej infrastruktury bez zrozumienia promienia rażenia. Runbooki operacyjne i forensic mogą się pokrywać, ale ich kolejność może się różnić.
Projektowanie przepływu pracy i warstwa sterująca
Modeluj runbook jako wyraźne stany z warunkami wstępnymi i końcowymi wynikami. Każde działanie powinno zgłaszać rozpoczęcie, sukces, niepowodzenie, przekroczenie limitu czasu lub pominięcie, wraz z niezmiennym identyfikatorem wykonania. Centralny orkiestrator może koordynować kroki, ale usługi zależne powinny samodzielnie egzekwować autoryzację i niezależnie weryfikować wejścia.
Używaj ograniczonych, krótkotrwałych poświadczeń i ograniczaj ścieżki sieciowe od silnika automatyzacji. Oddziel środowiska uruchamiania: deweloperskie, testowe i produkcyjne. Sekrety nie mogą pojawiać się w transkryptach czatów ani w logach. W przypadku działań o dużym wpływie wymagana jest dwupoziomowa akceptacja lub rola awaryjna, której użycie tworzy natychmiastowy ślad przeglądu.
Projektuj z myślą o częściowej awarii. Zgłoszenie może zostać utworzone, gdy powiadomienie nie powiedzie się; przekierowanie ruchu może odnieść sukces w jednym regionie i przekroczyć limit czasu w innym. Działania kompensacyjne, zadania uzgadniające i jasna własność zapobiegają raportowaniu sukcesu jedynie dlatego, że proces orkiestracji zakończył się.
Przykłady, testowanie i dojrzałość
Dojrzałym pierwszym przypadkiem użycia jest wyczerpanie połączeń bazy danych: zbierz metryki puli, ostatnie wdrożenia, wolne zapytania i informacje o właścicielu; otwórz incydent; zaproponuj odwracalną skalowanie lub akcję ruchu; wymaga zatwierdzenia; a następnie zweryfikuj współczynnik błędów i opóźnienia. Ten sam wzorzec może służyć do wygaśnięcia certyfikatów, przeciążenia dysku, nieudanych zadań lub podejrzanej aktywności konta.
Testuj runbooki przy użyciu testów jednostkowych, symulowanych API, incydentów w środowisku testowym, symulacji (game days) oraz kontrolowanych ćwiczeń produkcyjnych. Wprowadzaj przestarzałe dane, odmowy uprawnień, wolne zależności, zdarzenia duplikujące się i sprzeczne incydenty. Potwierdź, że ponowne próby są bezpieczne i że reagujący mogą przejąć ręczną kontrolę bez walki z automatyzacją.
Dojrzałość rozwija się od powiadamiania, przez wzbogacanie, po prowadzone działania, aż po ograniczoną automatyczną naprawę. Postęp powinien zależeć od dowodów: stabilna diagnoza, niski wskaźnik nieudanych działań, zweryfikowane przywrócenie oraz wyraźna korzyść dla użytkownika. Autonomiczne zamknięcie powinno być rzadkie, dopóki system nie udowodni odzyskiwania i nie zachowa wystarczającej ilości dowodów do późniejszej nauki.
Przykładowe zastosowanie: automatyzacja incydentu w usłudze produkcyjnej
Rozważmy API płatności, którego wskaźnik błędów rośnie po wdrożeniu. Monitoring generuje strukturalny alert zawierający usługę, środowisko, region, wersję, budżet błędów i link do runbooka. Automatyzacja wzbogaca go o rekord zmian, stan zależności, ostatnie logi i informacje o właścicielu, a następnie grupuje duplikaty alertów w jeden incydent. Deterministyczna polityka może natychmiast wstrzymać dalsze wdrożenie; przywrócenie powinno wymagać dowodów, że nowa wersja jest przyczyną i że przywrócenie jest bezpieczne.
Przepływ pracy przydziela dowódcę incydentu, otwiera kanały komunikacji, rejestruje oś czasu i sugeruje kroki diagnostyczne. Zautomatyzowana naprawa rozpoczyna się od niskiego ryzyka odwracalnych działań, takich jak przekierowanie ruchu do zdrowej instancji. Każde działanie wymaga autoryzacji, limitów współbieżności, limitu czasu, zweryfikowanych warunków końcowych i przywrócenia. Generatywne podsumowania mogą wspierać reagujących, ale telemetria źródłowa i polecenia pozostają widoczne, aby zespół mógł kwestionować nieprawidłową narrację.
Mierz czas wykrycia, potwierdzenia, łagodzenia i odzyskania; liczbę alertów; tłumienie duplikatów; skuteczność naprawy; powtarzalność; oraz szkody spowodowane automatyzacją. Przeprowadzaj symulacje (game days) dla wygasłych poświadczeń, częściowych regionów, mylących alertów i nieudanych przywróceń. Po odzyskaniu zachowaj faktograficzną oś czasu, zidentyfikuj techniczne i organizacyjne warunki przyczyniające się, zaktualizuj runbooki i testy oraz śledź prace korekcyjne aż do ich zakończenia, zamiast traktować szybkie łagodzenie jako koniec działań na rzecz niezawodności.
Lista kontrolna praktycznej implementacji
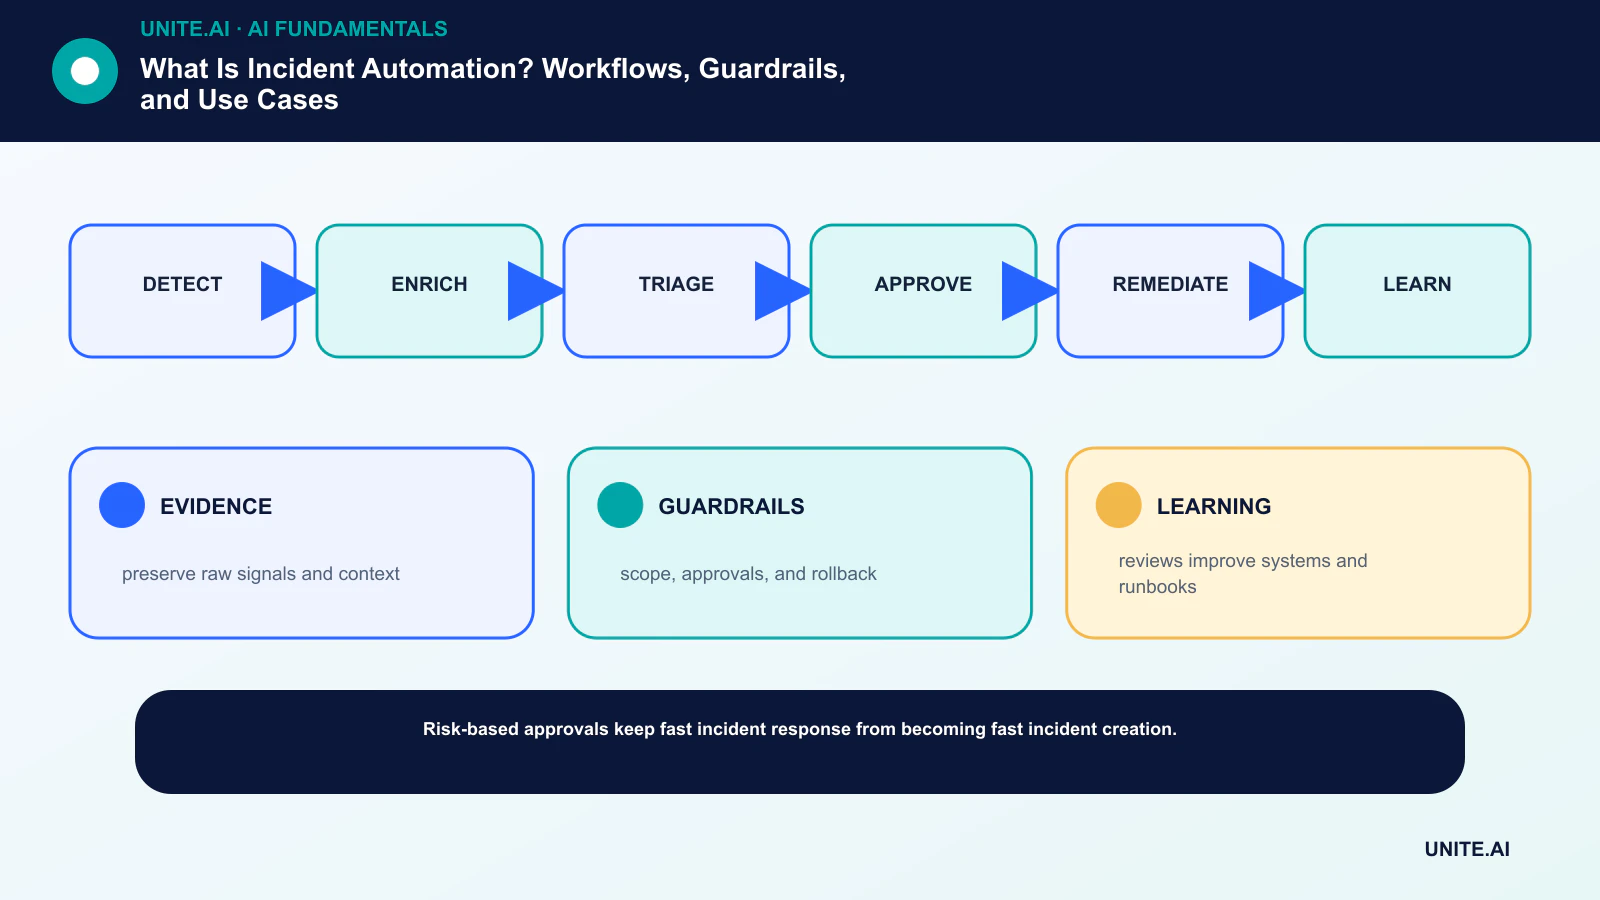
Przekształć koncepcję w ograniczony, testowalny przepływ pracy: wykryj → wzbogacaj → klasyfikuj → zatwierdzaj → naprawiaj → ucz się. Wyznacz odpowiedzialnego właściciela, udokumentuj dane i zależności, ustal prostą bazę odniesienia, określ kryteria akceptacji i zakończenia, przetestuj reprezentatywne awarie oraz zdefiniuj monitorowanie, przywracanie i przegląd przed rozszerzeniem zakresu. Zapisz wersje i założenia, aby inny zespół mógł odtworzyć wynik i zrozumieć, co się zmieniło.
Przed uruchomieniem przeprowadź udokumentowany przegląd gotowości z osobami, które budują, utrzymują, zabezpieczają i są dotknięte systemem. Testuj przypadki normalne, warunki brzegowe, awarie zależności i niewłaściwe użycie; zachowaj dowody i nierozwiązane ryzyka. Określ, kto może zatwierdzić wydanie, zmienić próg, nadpisać wynik lub zatrzymać działanie. Ponownie oceń decyzję po otrzymaniu danych z rzeczywistości, ponieważ technicznie udany pilotaż nie gwarantuje niezawodnej wydajności na szerszą skalę.
- DOWODY: zachowaj surowe sygnały i kontekst.
- ZABEZPIECZENIA: zakres, zatwierdzenia i przywrócenie.
- NAUKA: przeglądy ulepszają systemy i runbooki.
Najczęściej zadawane pytania
Czy automatyzacja incydentów jest tym samym co AIOps?
Nie. AIOps stosuje analitykę lub uczenie maszynowe do danych operacyjnych. Automatyzacja incydentów to szersza warstwa wykonawcza i koordynacyjna; może wykorzystywać proste reguły, wyniki AIOps lub oba rozwiązania.
Co powinno być automatyzowane w pierwszej kolejności?
Rozpocznij od wysokiej częstotliwości, niskiego ryzyka, dobrze zrozumianych kroków, takich jak wzbogacanie, wyszukiwanie właściciela, zbieranie dowodów, aktualizacje statusu i odwracalne diagnostyki.
Podstawowe źródła











