
Podstawy AI
Czym jest AIOps? Sztuczna inteligencja dla operacji IT

 Dodaj Unite.AI do preferowanych źródeł w Google
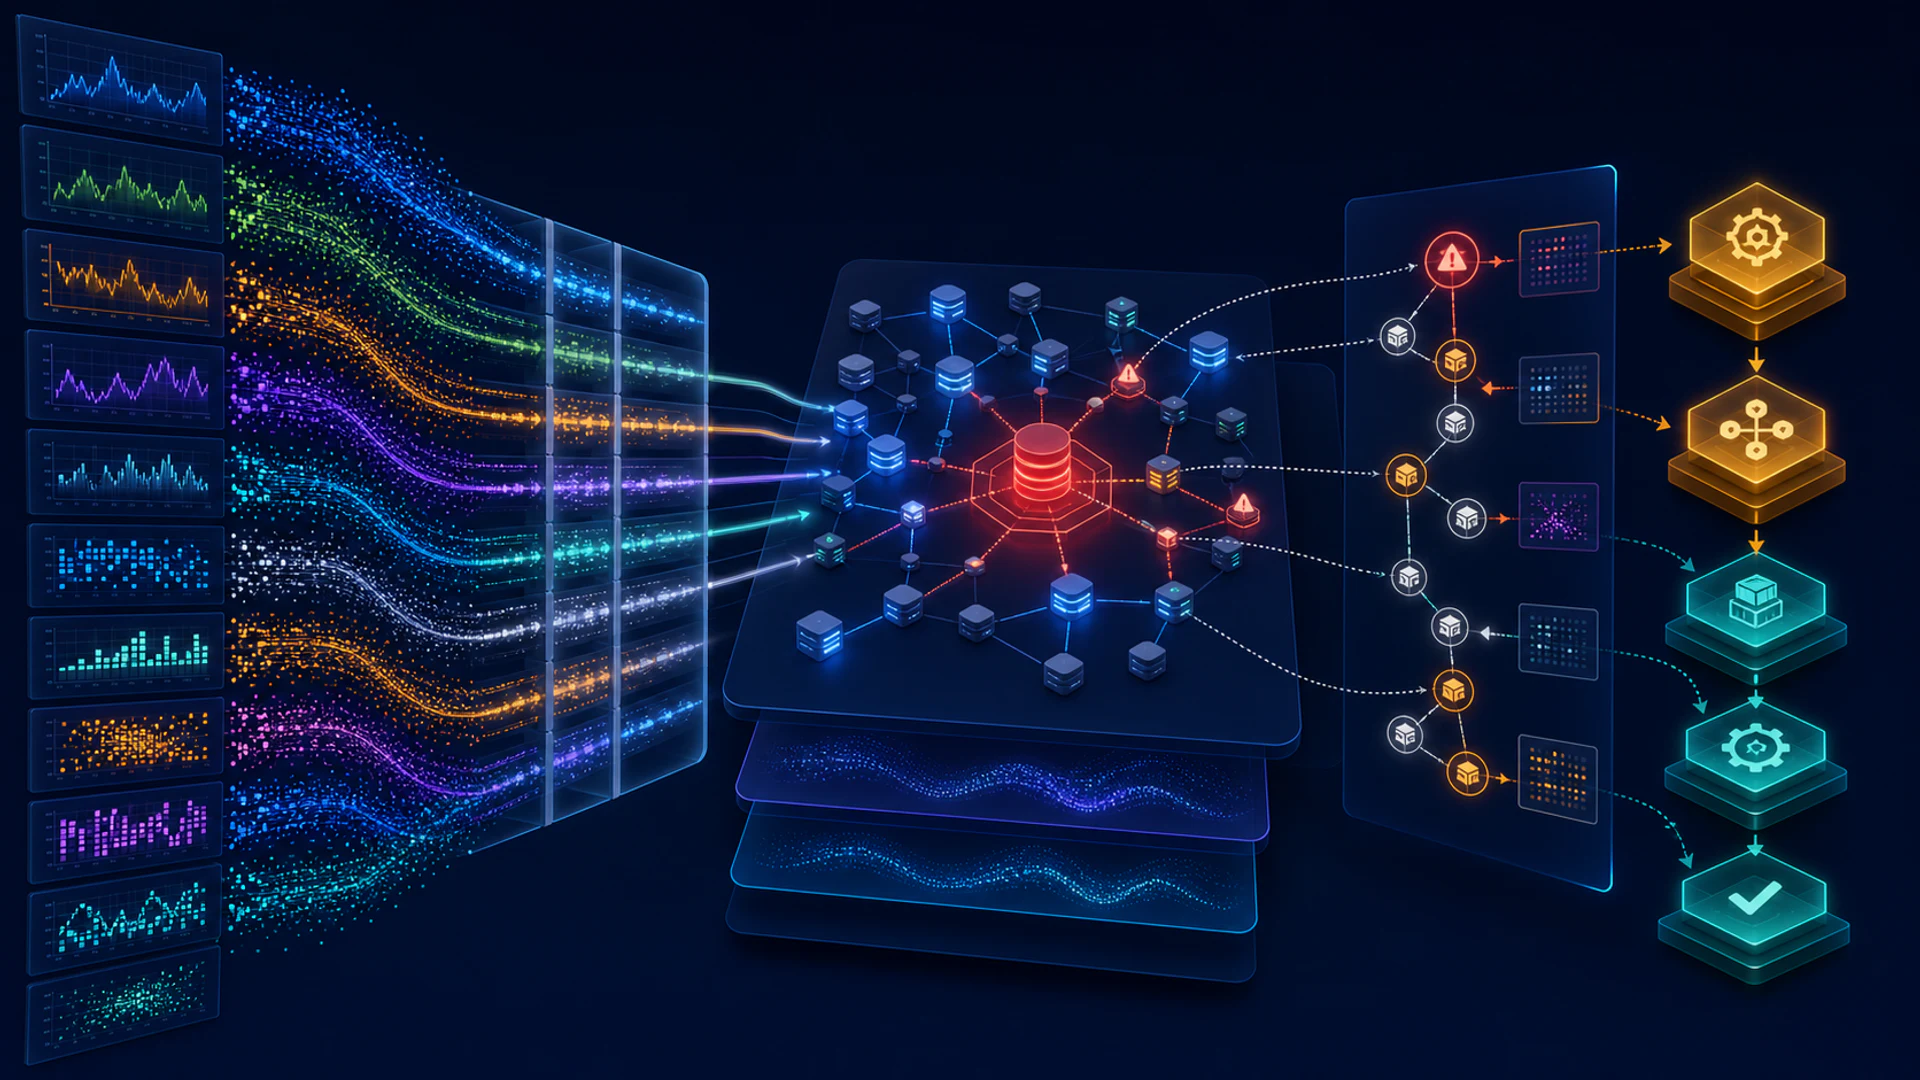
AIOps stosuje uczenie maszynowe i automatyzację do danych operacji IT, aby zespoły mogły wykrywać nietypowe zachowania, redukować powielające się alerty, łączyć powiązane zdarzenia, klasyfikować prawdopodobne przyczyny oraz rekomendować lub wykonywać działania naprawcze.
AIOps nie jest autonomiczną alternatywą dla operacji. Jest warstwą wewnątrz systemu ITOps, a jego wartość zależy od jakości telemetryki, topologii usług, historii zmian, opinii ludzkich oraz bezpiecznych granic automatyzacji.
Kluczowe wnioski
- Normalizuj zdarzenia i dodaj kontekst usług przed zastosowaniem zaawansowanych modeli.
- Wykrywanie anomalii identyfikuje odchylenia, niekoniecznie awarie lub przyczyny źródłowe.
- Korelacja i ranking prawdopodobnych przyczyn powinny ujawniać dowody i niepewność.
- Zautomatyzowane naprawy wymagają zasady najmniejszych uprawnień, zatwierdzeń, kanarków, wycofania i monitorowania wyników.
Budowanie warstwy danych operacyjnych
Platformy AIOps pobierają metryki, logi, ślady, alerty, zgłoszenia, topologię, wdrożenia oraz zmiany konfiguracji. Znaczniki czasu, identyfikatory i własność usług muszą być zreconciliowane, aby system mógł łączyć sygnały odnoszące się do tego samego incydentu.
Brak lub niespójny kontekst powoduje fałszywe korelacje. Retencja danych, dostęp i prywatność również mają znaczenie, ponieważ logi mogą zawierać poświadczenia lub dane osobowe. Stosuj te same zasady zarządzania, które obowiązują w innych systemach danych produkcyjnych.
Wykrywanie i redukcja szumów
Statyczne progi działają w przypadku znanych limitów; metody statystyczne i uczenia maszynowego mogą modelować sezonowość lub wzorce wielowymiarowe. Deduplication grupuje powtarzające się powiadomienia, natomiast supresja usuwa alerty, które nie są możliwe do podjęcia działań zgodnie z określonymi regułami.
Anomalia to jedynie odchylenie od oczekiwanego zachowania. Planowane wydania, kampanie ruchu i cykle biznesowe mogą być nietypowe, ale zdrowe. Oceń precyzję, recall, opóźnienie wykrywania i obciążenie operatora zamiast świętować liczbę usuniętych alertów.
Korelacja i prawdopodobna przyczyna
Korelacja zdarzeń łączy objawy w ramach grafu zależności i okna czasowego. Model prawdopodobnej przyczyny może klasyfikować komponenty lub niedawne zmiany, które mogą wyjaśnić incydent. To priorytetyzuje dochodzenie; nie ustala przyczynowości.
Pokaż dowody przyczynowe, alternatywne hipotezy i poziom pewności. Explainable AI jest szczególnie ważne, gdy operator musi zdecydować, czy odizolować usługę, czy wycofać wdrożenie.
Od rekomendacji do automatyzacji
Runbook może zbierać diagnostykę, uruchamiać ponownie bezstanowego pracownika lub skalować pojemność. Copiloty mogą podsumowywać incydenty i przywoływać procedury. Agenci mogą planować wywołania narzędzi, ale uprawnienia produkcyjne powinny być wąskie, a działania weryfikowane względem aktualnego stanu.
Zacznij od rekomendacji w trybie tylko do odczytu. Promuj dojrzałe działania poprzez symulację, zatwierdzenie przez człowieka, kanarki i automatyczne wycofanie. Rejestruj wejścia, wersję modelu, autoryzację i wynik każdego działania.
Ewaluacja i sprzężenie operacyjne
Odtwarzaj historyczne incydenty bez wyciekania ich ostatecznych etykiet do cech. Testuj na nowych usługach i zmianach, mierz fałszywe tłumienie, czas wykrycia, czas łagodzenia, akceptację operatora i powtarzalność. Porównaj z istniejącymi regułami i prostymi bazami odniesienia.
Dryft pojawia się, gdy zmienia się architektura, ruch lub praktyki reagowania. Zamknij pętlę, pozwalając operatorom korygować korelacje i wyniki, a następnie sprawdź, czy system redukuje żmudną pracę bez ukrywania ryzyka lub tworzenia samozadowolenia z automatyzacji.
Dane AIOps i pipeline analityczny
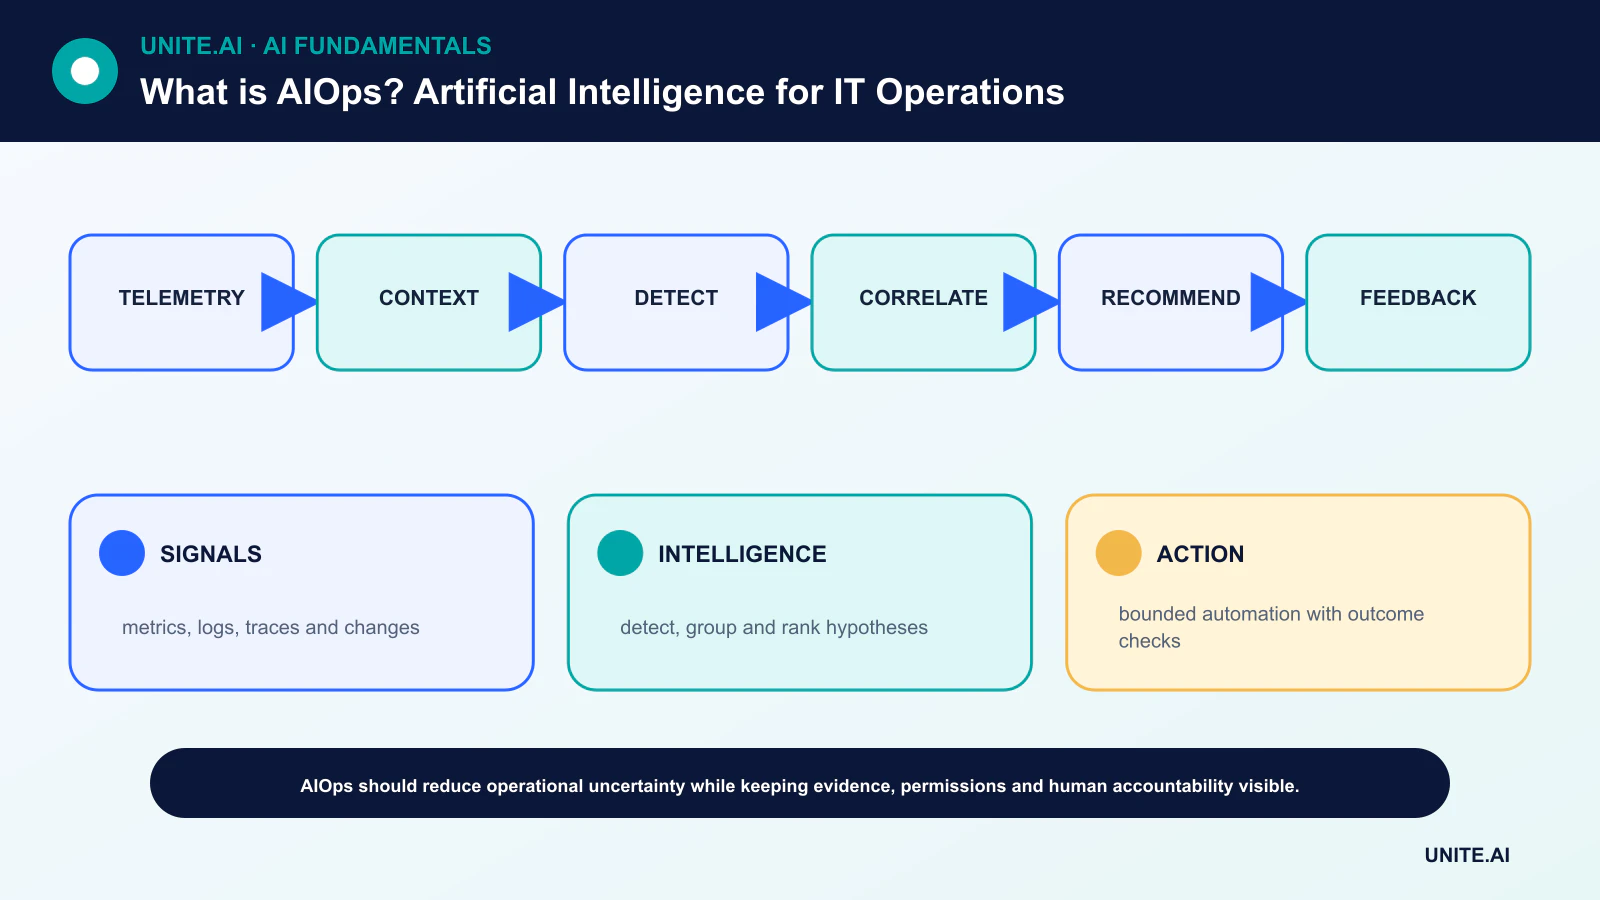
AIOps stosuje metody statystyczne i uczenia maszynowego do danych operacyjnych, takich jak metryki, logi, ślady, zdarzenia, topologia, zgłoszenia i zmiany. Pipeline zbiera i normalizuje sygnały, wzbogaca je o kontekst usług i własności, wykrywa anomalie, koreluje powiązane zdarzenia, szacuje prawdopodobne przyczyny oraz rekomenduje lub wyzwala akcję. Jakość zależy od znaczników czasu, identyfikatorów, topologii i rejestrów zmian. Zaawansowany model nie może wiarygodnie korelować alertów odnoszących się do tej samej usługi przy niespójnych nazwach.
Wykrywanie anomalii uczy się bazowych profili według usługi, sezonu i stanu operacyjnego; statyczne progi mogą być lepsze dla znanych limitów bezpieczeństwa. Korelacja zdarzeń grupuje objawy w incydent, wykorzystując czas, topologię, tekst i wzorce historyczne. Ranking przyczyn pierwotnych proponuje hipotezy, ale może pomylić pierwszą zaobserwowaną awarię z prawdziwą przyczyną lub przeoczyć współdzieloną zależność nieobecną w topologii. Streszczenia w języku naturalnym mogą wspierać reagujących, ale muszą odwoływać się do surowych dowodów i wskazywać niepewność.
Automatyzacja, ewaluacja i sprzężenie zwrotne
Zacznij od wsparcia decyzyjnego i niskiego ryzyka odwracalnych napraw. Każde zautomatyzowane działanie wymaga autoryzacji, warunków wstępnych, ograniczonego zakresu, limitu czasu, weryfikacji warunków końcowych, wycofania i śladu audytu. Model nie powinien przyznawać sobie poświadczeń ani traktować tekstu logu jako zaufanych instrukcji. Ludzcy reagujący powinni akceptować, odrzucać lub korygować rekomendacje, a te wyniki powinny aktualizować reguły lub dane treningowe poprzez przegląd, a nie niekontrolowane samouczenie.
Oceń redukcję alertów bez pomijania incydentów, czasu wczesnego wykrycia, precyzji korelacji, rankingu przyczyn pierwotnych, sukcesu napraw, czasu odzyskiwania, powtarzalności i obciążenia reagującego. Wykorzystaj odtwarzanie historyczne i wprowadzane błędy, ale uwzględnij niekompletne etykiety incydentów. Mierz według usługi i typu incydentu; średnia może ukrywać niebezpieczne awarie w rzadkich, krytycznych systemach. Porównaj z regułami deterministycznymi i ulepszoną obserwowalnością przed dodaniem złożoności AI.
Zarządzanie i tryby awarii
AIOps może nasilać luki w telemetryce, automatyzować błędną diagnozę lub tworzyć skorelowane działania obejmujące całą flotę. Izoluj środowiska, ogranicz współbieżność, utrzymuj przycisk awaryjny poza modelem i przeprowadzaj symulacje awarii samej platformy AIOps. Chroń logi i zgłoszenia zawierające tajemnice lub dane osobowe. Monitoruj dryft modelu, aktualność topologii, fałszywe działania i nadpisania. AIOps wspiera niezawodne operacje, gdy przyspiesza dowody i ograniczone działania; nie jest autonomiczną alternatywą dla własności usług, dowodzenia incydentem ani oceny inżynierskiej.
Przykład praktyczny: AIOps w incydencie płatności
AIOps grupuje gwałtowny wzrost błędów API, nasycenie bazy danych i regionalne alerty w jeden incydent i wzbogaca go o niedawne wdrożenie, topologię oraz właściciela. Model klasyfikuje wdrożenie jako prawdopodobnego współsprawcę, ale udostępnia surową telemetrykę i alternatywy. Deterministyczna polityka wstrzymuje dalsze wdrażanie; ludzki dowódca incydentu zatwierdza zmianę ruchu po sprawdzeniu, że pojemność i spójność danych są bezpieczne.
System mierzy precyzję grupowania, czas wczesnego wykrycia, dokładność rankingu, akceptację reagującego, odzyskanie oraz fałszywe naprawy w odtwarzaniu historycznym i dniach testowych. Wszystkie zautomatyzowane działania mają ograniczenia, idempotentność, kontrole warunków końcowych i możliwość wycofania. Logi są oczyszczane, a złośliwy tekst nie może stać się poleceniem. Po incydencie potwierdzona przyczyna i wyniki działań aktualizują przeglądane reguły i dane ewaluacyjne. Platforma AIOps wspiera dowody i koordynację; nigdy nie zastępuje dowodzenia incydentem ani zewnętrznej autoryzacji.
Dowody wdrożeniowe i gotowość operacyjna
Decyzja produkcyjna wymaga więcej niż udanej demonstracji. Zdefiniuj docelowych użytkowników, środowisko operacyjne, wejścia, wyjścia, zależności, właściciela oraz konsekwencje każdego istotnego błędu. Ustal odtwarzalną bazę odniesienia i wersjonowany zestaw ewaluacyjny przed dostrojeniem. Testuj typowe przypadki, warunki brzegowe, niepoprawne lub brakujące dane wejściowe, przesunięcie rozkładu, awarie zależności, niewłaściwe użycie oraz grupy lub środowiska najprawdopodobniej niedostatecznie obsługiwane. Mierz jakość zadania wraz z kalibracją lub niepewnością, opóźnieniem, przepustowością, kosztami zasobów, dostępnością, prywatnością i bezpieczeństwem. Rejestruj każdą transformację i próg, aby niezależny recenzent mógł odtworzyć wynik i odróżnić dowody od atrakcyjnego prototypu.
Przed uruchomieniem przydziel uprawnienia do wydania, wyjątków, zmian, wycofania i wycofania produktu. Użyj etapowego wdrożenia, zachowaj bezpieczną rezerwę i zweryfikuj monitorowanie przy celowo wprowadzonych awariach. Telemetria operacyjna powinna ujawniać jakość danych wejściowych, zachowanie wyjścia, wersję modelu lub reguły, stan zależności, interwencje ludzkie oraz potwierdzone wyniki, nie gromadząc niepotrzebnych danych wrażliwych. Zdefiniuj progi alertów i właściciela reakcji, a następnie przeglądaj dowody z rzeczywistego świata po wdrożeniu, zamiast zakładać, że wydajność offline będzie trwała. Przeprowadzaj ponowną ocenę, gdy zmieniają się źródła danych, użytkownicy, modele, dostawcy, polityki, sprzęt lub cele. Utrzymany system wymaga także udokumentowanego odzyskiwania, nauki z incydentów, procedur usuwania i przechowywania oraz jasnego punktu, w którym powinien zostać wyłączony lub zastąpiony.
Najczęściej zadawane pytania
Czy AIOps jest tym samym co obserwowalność?
Nie. Obserwowalność dostarcza i analizuje sygnały systemowe; AIOps wykorzystuje analitykę i automatyzację na bazie tych sygnałów. Każde z nich może istnieć niezależnie od drugiego.
Czy AIOps może automatycznie określić przyczynę źródłową?
Może klasyfikować hipotezy i zbierać dowody, ale twierdzenia przyczynowe wymagają topologii, kontekstu zmian i weryfikacji. Wiele incydentów ma współdziałające przyczyny.
Podstawowe źródła












