
Podstawy AI
Czym jest zarządzanie wydajnością aktywów (APM)?

 Dodaj Unite.AI do preferowanych źródeł w Google
Zarządzanie wydajnością aktywów (APM) łączy strategię aktywów, utrzymanie, monitorowanie stanu, analizę niezawodności oraz dane operacyjne, aby zwiększyć wartość dostarczaną przez fizyczne aktywa. Jest powszechnie stosowane do sprzętu takiego jak turbiny, pompy, pojazdy, linie produkcyjne i infrastruktura.
APM nie jest sam w sobie panelem czujników ani modelem utrzymania predykcyjnego. Jest procesem decyzyjnym, który równoważy wydajność, koszty, ryzyko, bezpieczeństwo i zrównoważony rozwój w całym cyklu życia aktywu, z wyraźnym przypisaniem odpowiedzialności za inspekcje, prace, części zamienne i planowanie kapitałowe.
Kluczowe wnioski
- Zacznij od krytyczności i konsekwencji awarii, a nie od najłatwiejszego do zebrania czujnika.
- Połącz dane o stanie z historią utrzymania, kontekstem operacyjnym i wiedzą inżynieryjną.
- Wykorzystaj sygnały predykcyjne, aby wesprzeć określoną decyzję o pracy i wymóg czasu realizacji.
- Mierz uniknięte ryzyko, dostępność, jakość utrzymania, koszt cyklu życia oraz fałszywe alarmy.
Od strategii aktywów do prac
Organizacje definiują cele, hierarchie aktywów, krytyczność, standardy wydajności, tryby awarii i strategie utrzymania. System zarządzania pracą planuje inspekcje i naprawy; analizy APM pomagają określić priorytety, kiedy i dlaczego prace powinny być wykonywane.
Ten sam stan może wymagać innego działania dla redundantnej, niskokosztowej pompy i turbiny krytycznej pod względem bezpieczeństwa. APM łączy dowody techniczne z kontekstem biznesowym i bezpieczeństwa, zamiast optymalizować jedynie wynik prognozy.
Dane i reprezentacje cyfrowe
Przydatne źródła obejmują szereg czasowy czujników, alarmy, obchody operatorów, notatki z utrzymania, części, warunki środowiskowe, obciążenia i limity projektowe. Identyfikatory aktywów i znaczniki czasu muszą być zgodne przed analizą. Brakujące, dryfujące lub wymienione czujniki mogą generować fałszywe trendy.
Cyfrowy bliźniak (digital twin) może łączyć modele inżynieryjne i stan bieżący, ale wymaga zweryfikowanych założeń i reguł aktualizacji. Niestrukturalne (Unstructured) notatki techników mogą dodać kontekst, którego brakuje w telemetrii.
Stan, prognozowanie i decyzja
Progi wykrywają znane limity; modele anomalii sygnalizują odchylenia; modele diagnostyczne szacują przyczyny; modele prognostyczne szacują pozostały przydatny okres eksploatacji. Każdy z nich wymaga horyzontu czasowego i niepewności odpowiedniej do decyzji o utrzymaniu.
Model przewidujący awarię pięć minut przed jej wystąpieniem może być dokładny, ale operacyjnie bezużyteczny, jeśli części potrzebują tygodnia. Uczenie maszynowe powinno być porównane z regułami i metodami niezawodności oraz przetestowane w różnych warunkach operacyjnych.
Wdrożenie i pomiar
Rozpocznij od krytycznej klasy aktywów, wiarygodnego trybu awarii, dostępnego czasu realizacji i właściciela, który może podjąć działanie. Zintegruj rekomendacje z planowaniem, zleceniami pracy i inwentarzem; zbieraj wyniki, aby regułę lub model można było ocenić.
Śledź dostępność, nieplanowane przestoje, koszty utrzymania, zgodność z harmonogramem, fałszywe alarmy, pominięte zdarzenia, narażenie na ryzyko bezpieczeństwa i wartość cyklu życia. Unikaj twierdzeń o unikniętych awariach bez metody kontrfaktycznej i udokumentowanych założeń.
Hierarchia aktywów, zachowanie awarii i krytyczność
Program APM zaczyna się od hierarchii aktywów, która łączy obiekty, systemy, sprzęt, zespoły i komponenty podlegające utrzymaniu. Każdy poziom wymaga spójnych identyfikatorów, własności, lokalizacji, specyfikacji i powiązań. Bez tej podstawy strumienie danych z czujników, zlecenia pracy, wyniki inspekcji i rejestry kosztów nie mogą wiarygodnie opisywać tego samego fizycznego aktywu.
Tryby awarii wyjaśniają, w jaki sposób aktyw może przestać spełniać wymaganą funkcję, dlaczego dochodzi do awarii, jakie dowody pojawiają się jako pierwsze i jaka jest następna konsekwencja. Analiza trybów awarii i ich skutków (FMEA), utrzymanie oparte na niezawodności (RCM) oraz analiza przyczyn źródłowych przekształcają utrzymanie z czynności kalendarzowej w dyscyplinę opartą na ryzyku. Analiza powinna odróżniać objawy od mechanizmów przyczynowych.
Krytyczność łączy prawdopodobieństwo z konsekwencjami dla bezpieczeństwa, środowiska, produkcji, jakości, zgodności i kosztów. Redundantna pompa obsługująca nieistotny obieg nie powinna otrzymywać takiego samego budżetu monitoringu jak sprężarka będąca pojedynczym punktem awarii. Krytyczność zmienia się w zależności od kontekstu operacyjnego, dlatego zespoły powinny ponownie ocenić rankingi po zmianach procesu, aktywów lub zapotrzebowania.
Monitorowanie stanu, prognozowanie i decyzje o utrzymaniu
Monitorowanie stanu może wykorzystywać wibracje, temperaturę, ciśnienie, prąd, emisję akustyczną, analizę smaru, inspekcję wizualną oraz obserwacje operatora. Częstotliwość próbkowania musi odpowiadać fizyce awarii. Wibracje łożysk o wysokiej częstotliwości i powoli dryfująca korozja wymagają różnych czujników, przechowywania, cech i logiki alarmów. Kalibracja i jakość instalacji są częścią jakości danych.
Modele predykcyjne mogą wykrywać anomalie, klasyfikować znane usterki, szacować wskaźniki zdrowia lub prognozować pozostały przydatny okres eksploatacji. Statystycznie nietypowy sygnał nie jest automatycznie akcjonowaną awarią. Modele potrzebują kontekstu stanu operacyjnego, niepewności, oceny czasu realizacji oraz weryfikacji w różnych urządzeniach, porach roku, obciążeniach i zdarzeniach utrzymania. Fałszywe alarmy podważają zaufanie i pochłaniają pracę; pominięte wykrycia mogą spowodować poważne straty.
Wynik analiz musi łączyć się z decyzją: inspekcja, smarowanie, obniżenie parametrów, planowanie prac, zamówienie części lub wyłączenie. Progi decyzyjne powinny odzwierciedlać konsekwencje awarii, czas realizacji interwencji, zdolności siły roboczej, części zamienne i okna produkcyjne. Ekonomicznie optymalny próg rzadko jest tym, który maksymalizuje ogólny wskaźnik modelu.
Integracja APM, pomiar wartości i zarządzanie
APM łączy technologię operacyjną z systemami korporacyjnymi, takimi jak komputerowe zarządzanie utrzymaniem (CMMS), zarządzanie aktywami przedsiębiorstwa (EAM), systemy historyczne, inwentarz i planowanie. Integracja powinna zachować znaczniki czasu, jednostki, tożsamość aktywu, status pracy i pochodzenie danych. Segmentacja sieci i kontrolowane bramy są niezbędne, ponieważ wygoda diagnostyczna nie może tworzyć ścieżki do systemów sterowania krytycznych dla bezpieczeństwa.
Mierz wartość poprzez uniknięte przestoje, zmniejszoną liczbę prac awaryjnych, koszty utrzymania, dostępność części zamiennych, efektywność energetyczną, wydajność, narażenie na ryzyko bezpieczeństwa i żywotność aktywów. Uniknięte awarie są kontrfaktyczne, dlatego należy używać wiarygodnych baz odniesienia, porównywalnych aktywów, udokumentowanych założeń i zakresów wrażliwości. Pilotaż, który wykrywa wiele anomalii, ale nie zmienia decyzji o utrzymaniu, nie wykazał wartości biznesowej.
Zarządzanie przydziela właścicieli czujników, modeli, reguł alarmowych, baz awarii i procesów pracy. Przeglądaj alerty po każdej interwencji, rejestruj, czy diagnoza była prawidłowa, i wprowadzaj potwierdzone wyniki z powrotem do reguł i modeli. Operatorzy i utrzymaniowcy potrzebują możliwości kwestionowania zaleceń; lokalna wiedza jest dowodem, a nie oporem wobec automatyzacji.
Przykład praktyczny: ochrona krytycznego aktywu obrotowego
W przypadku sprężarki produkcyjnej zespół mapuje komponenty i tryby awarii, ocenia konsekwencje utraty produkcji i bezpieczeństwa oraz łączy tagi historyczne, czujniki wibracji, próbki smaru, inspekcje i zlecenia pracy z jedną tożsamością aktywu. Dane bazowe muszą obejmować rozruch, stałe obciążenie, obniżenie mocy i warunki sezonowe. W przeciwnym razie model może oznaczać normalne przejścia operacyjne jako usterki lub przeoczyć degradację widoczną tylko przy określonym obciążeniu.
Warstwa analityczna wykrywa zmiany w widmie wibracji i temperaturze łożysk, szacuje niepewność i prezentuje dowody obok porównywalnych zdarzeń historycznych. Trwały alarm generuje żądanie inspekcji zamiast automatycznego wyłączenia. Utrzymaniowiec rejestruje ustalenia, podjęte działania, wymienioną część i potwierdzoną przyczynę. Te wyniki decydują, czy próg, model awarii lub instalacja czujnika powinny zostać zmienione.
Oceń czas realizacji ostrzeżenia, wskaźnik potwierdzonych wykryć, obciążenie fałszywymi alarmami, uniknięte przestoje, prace awaryjne, gotowość części zamiennych oraz koszty utrzymania w odniesieniu do udokumentowanej bazy. Uwzględnij koszty czujników, integracji, analiz i zmienionych procesów pracy. Przegląd bezpieczeństwa cybernetycznego izoluje monitorowanie od sterowania, a zarządzanie przydziela właścicieli danych i modeli. Celem jest bezpieczniejsza, ekonomiczna decyzja o utrzymaniu, a nie największy możliwy zbiór danych telemetrycznych aktywu.
Lista kontrolna praktycznej implementacji
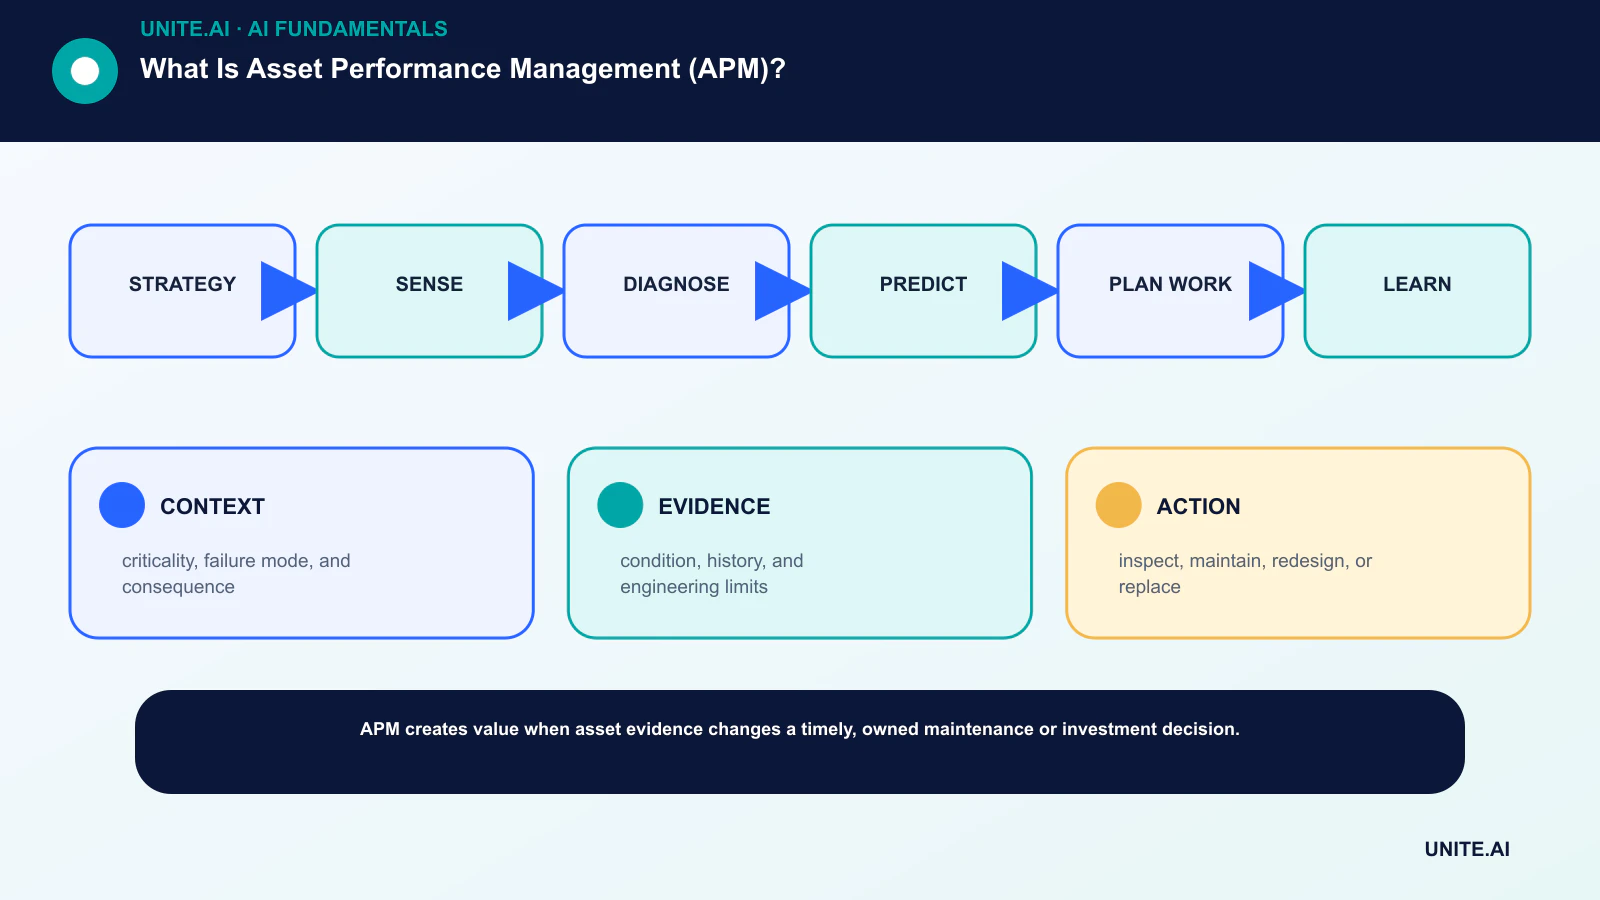
Przekształć koncepcję w ograniczony, testowalny przepływ pracy: strategia → pomiar → diagnoza → prognoza → planowanie prac → nauka. Wyznacz odpowiedzialnego właściciela, udokumentuj dane i zależności, ustal prostą bazę, określ kryteria akceptacji i zakończenia, przetestuj reprezentatywne awarie oraz zdefiniuj monitorowanie, wycofanie i przegląd przed rozszerzeniem zakresu. Rejestruj wersje i założenia, aby inny zespół mógł odtworzyć wynik i zrozumieć, co się zmieniło.
Przed uruchomieniem przeprowadź udokumentowany przegląd gotowości z osobami, które budują, obsługują, zabezpieczają i są dotknięte systemem. Testuj przypadki normalne, warunki brzegowe, awarie zależności i niewłaściwe użycie; zachowaj dowody i nierozwiązane ryzyka. Określ, kto może zatwierdzić wydanie, zmienić próg, nadpisać wynik lub zatrzymać działanie. Ponownie przeanalizuj decyzję po pojawieniu się danych z rzeczywistości, ponieważ technicznie udany pilotaż nie gwarantuje niezawodnej wydajności na większą skalę.
- CONTEXT: krytyczność, tryb awarii i konsekwencje.
- EVIDENCE: stan, historia i limity inżynieryjne.
- ACTION: inspekcja, utrzymanie, przedefiniowanie lub wymiana.
Najczęściej zadawane pytania
Czym APM różni się od CMMS?
CMMS głównie zarządza pracami utrzymania, harmonogramami i rejestrami. APM dodaje strategię aktywów, analizę niezawodności i stanu, priorytetyzację oraz decyzje dotyczące wydajności; systemy często są zintegrowane.
Czy utrzymanie predykcyjne jest wymagane w APM?
Nie. Strategie prewencyjne, oparte na stanie, eksploatacji do awarii, przedefiniowania i wymiany mogą być wszystkie odpowiednie. Prognozowanie jest jednym z narzędzi w ramach strategii aktywów.
Podstawowe źródła












