
Podstawy AI
Czym są operacje informatyczne (ITOps)?

 Dodaj Unite.AI do preferowanych źródeł w Google
Operacje informatyczne (ITOps) to praca związana z uruchamianiem usług technologicznych, od których zależy organizacja. Obejmuje przetwarzanie, sieci, tożsamość, urządzenia końcowe, platformy chmurowe, bazy danych, przechowywanie, kopie zapasowe oraz procesy operacyjne, które zapewniają dostępność, bezpieczeństwo i możliwość wsparcia tych elementów.
Współczesne ITOps nie ogranicza się do centrum operacji sieciowych monitorującego pulpity. Zespoły coraz częściej zarządzają infrastrukturą definiowaną programowo, usługami platformowymi, automatyzacją i rozproszonym własnością, jednocześnie zachowując odpowiedzialność za incydenty, pojemność, ciągłość i poziomy usług.
Kluczowe wnioski
- ITOps zarządza usługami i ich zależnościami w środowiskach lokalnych, chmurowych i brzegowych.
- Obserwowalność, konfiguracja i inwentaryzacja dostarczają kontekst niezbędny do interpretacji awarii.
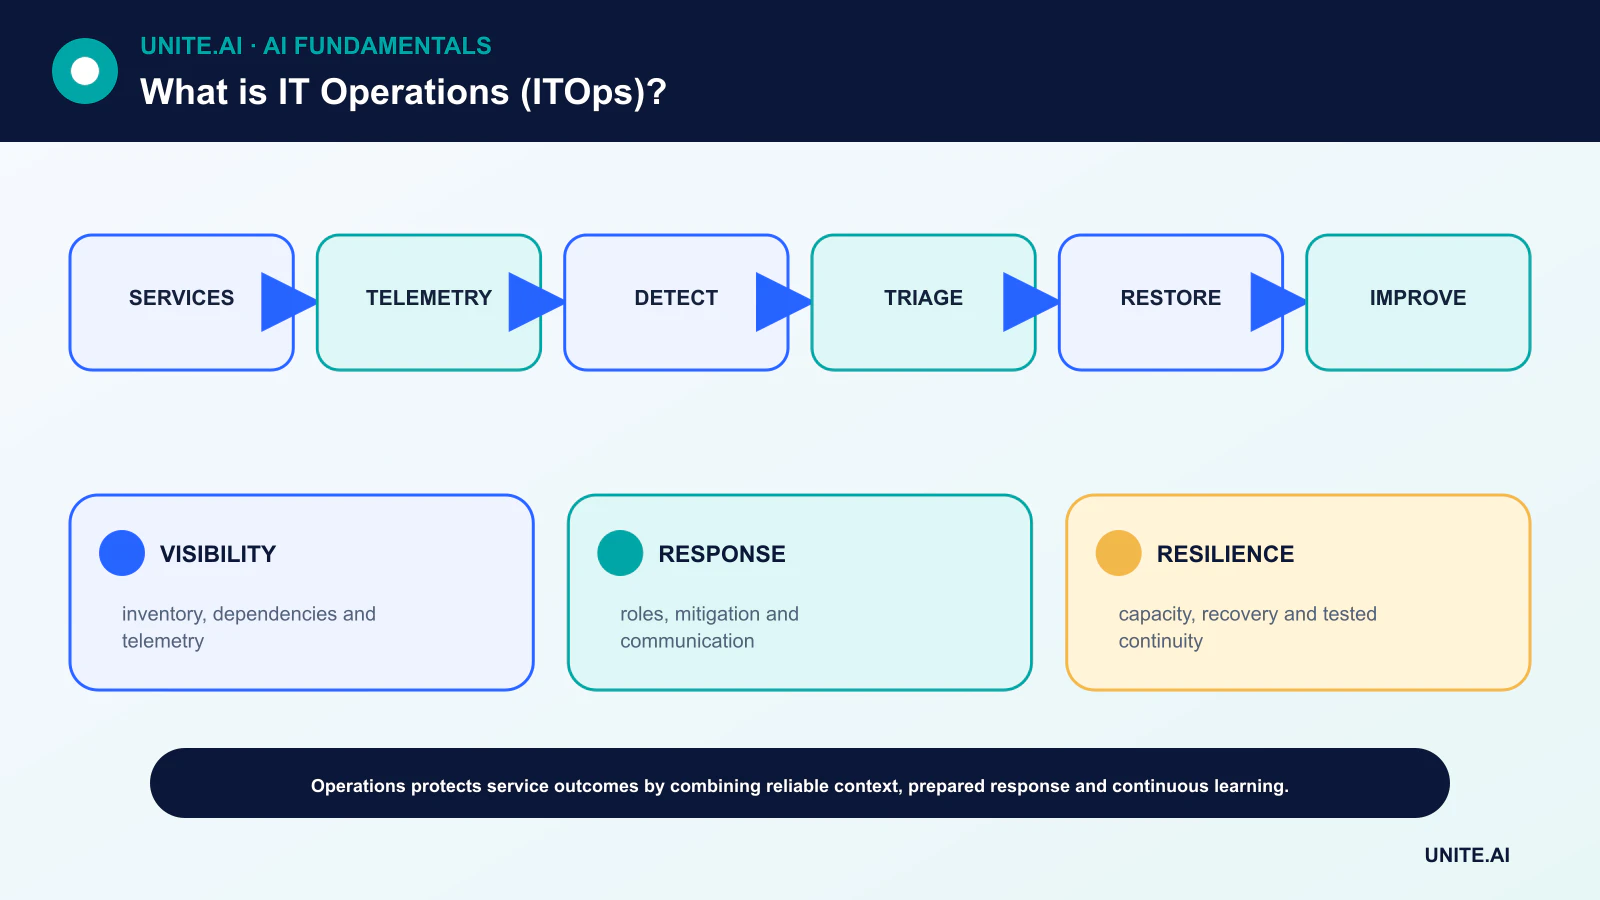
- Zarządzanie incydentami przywraca usługę; zarządzanie problemami zajmuje się przyczynami powtarzającymi się lub systemowymi.
- ITOps nakłada się na ITSM, SRE, DevOps, SecOps i AIOps, ale nie jest identyczne z żadnym z nich.
Usługi, zasoby i konfiguracja
Operacje zaczynają się od poznania, które usługi istnieją, kto jest ich właścicielem, od których użytkowników zależą i jaka infrastruktura je wspiera. Inwentaryzacja zasobów rejestruje komponenty; zarządzanie konfiguracją zapisuje odpowiednie zależności i kontrolowany stan.
Inwentaryzacja, która nigdy nie jest uzgadniana, staje się myląca. Automatyzuj wykrywanie tam, gdzie jest to przydatne, identyfikuj autorytatywne źródła i zapisuj poziom pewności lub aktualności, zamiast udawać, że każda mapa zależności jest kompletna.
Obserwowalność i cele usług
Metryki ilościowo opisują zachowanie, logi rejestrują zdarzenia, a ślady śledzą pracę pomiędzy usługami. Syntetyczne kontrole mogą testować ścieżkę użytkownika. Przydatna obserwowalność zaczyna się od pytań i celów usług, a następnie zbiera sygnały niezbędne do ich odpowiedzi.
Alertowanie powinno identyfikować warunki wymagające szybkiej reakcji. Progi bez wpływu na użytkownika generują szum, a brak kontekstu zależności spowalnia diagnozę. AIOps może pomóc w korelacji, ale potrzebuje wiarygodnej telemetrii i informacji zwrotnej z operacji.
Zarządzanie incydentami, problemami i zmianami
Zarządzanie incydentami koordynuje wykrywanie, triage, łagodzenie, komunikację i przywracanie. Jasne role redukują zamieszanie w sytuacjach stresowych. Tymczasowe obejście może przywrócić usługę, podczas gdy późniejsze badanie problemu zajmuje się głębszymi przyczynami.
Zarządzanie zmianami ocenia i rejestruje ryzyko, nie zamieniając każdej zmiany w kolejkę. Standardowe, zautomatyzowane i niskoryzykowe zmiany mogą podążać za wstępnie zatwierdzonymi ścieżkami; zmiany o wysokim wpływie wymagają silniejszych dowodów, planowania oraz przygotowania przywracania.
Pojemność, odporność i ciągłość
Zespoły prognozują zapotrzebowanie na zasoby, usuwają wąskie gardła i testują zachowanie pod obciążeniem. Kopie zapasowe są przydatne tylko wtedy, gdy testowane jest przywracanie. Redundancja pomaga jedynie, gdy tryby awarii są niezależne, a przełączenie awaryjne rzeczywiście działa.
Ciągłość działania definiuje priorytety, czas przywracania i dopuszczalną utratę danych. Zależności od tożsamości, DNS, płaszczyzn kontrolnych chmury i dostawców powinny być uwzględniane w ćwiczeniach, a nie przyjmowane jako dostępne.
ITOps, ITSM, SRE i DevOps
Zarządzanie usługami IT dostarcza procesy umożliwiające dopasowanie usług do potrzeb organizacji. Inżynieria niezawodności serwisów (SRE) stosuje inżynierię oprogramowania w operacjach i wykorzystuje cele poziomu usług oraz budżety błędów. DevOps łączy informacje zwrotne z rozwoju i operacji.
SecOps koncentruje się na zagrożeniach i reagowaniu, podczas gdy ITOps utrzymuje szersze zdrowie usług. Schematy organizacyjne różnią się; ważnym wymogiem jest wyraźna własność i wspólne dowody w tych dyscyplinach.
Model operacyjny ITOps
Operacje informatyczne utrzymują dostępność, wydajność, bezpieczeństwo i możliwość przywrócenia usług technologicznych organizacji. Zakres zazwyczaj obejmuje urządzenia końcowe, tożsamość, sieci, serwery, chmurę, przechowywanie, współpracę, bazy danych, monitorowanie, biuro obsługi, kopie zapasowe i usługi dostawców. Współczesne ITOps obejmuje własną infrastrukturę i zarządzane platformy, więc odpowiedzialność musi być wyraźna, nawet gdy operacje są outsourcowane. Inwentaryzacja konfiguracji lub usług łączy komponenty techniczne z właścicielami, użytkownikami, zależnościami, klasyfikacją danych i krytycznością biznesową.
Zarządzanie usługami organizuje incydenty, zgłoszenia, problemy, zmiany, zasoby, wiedzę i poziomy usług. Zarządzanie incydentami przywraca usługę; zarządzanie problemami bada przyczyny powtarzające się; umożliwianie zmian ocenia i koordynuje ryzyko. Traktowanie każdej zmiany jako wolnego procesu zatwierdzania tworzy obejścia, podczas gdy niezarządzana automatyzacja powoduje niekontrolowane awarie. Standardowe zmiany niskiego ryzyka mogą być wstępnie autoryzowane i zautomatyzowane; zmiany wysokiego ryzyka wymagają dowodów, komunikacji, przywracania i planowania w oparciu o wpływ.
Niezawodność, pojemność i ciągłość
Monitorowanie powinno obejmować usługi skierowane do użytkowników i ich zależności, a nie tylko liczbę urządzeń. Określ dostępność, opóźnienia, pojemność, aktualność i cele wsparcia wraz z właścicielami biznesowymi. Alertuj na symptomy wymagające działania i zużycie budżetu błędów; wzbogacaj zdarzenia o informacje o właścicielu i ostatnich zmianach. Modele planowania pojemności obejmują zapotrzebowanie, nasycenie, licencje i czas realizacji. Elastyczność chmury skraca opóźnienia w provisioningu, ale nie eliminuje limitów, ograniczeń regionalnych ani kontroli kosztów.
Ciągłość działania wymaga przetestowanych kopii zapasowych, przywracania, odzyskiwania tożsamości, alternatywnych sieci, kontaktów z dostawcami i procedur ręcznych. Określ cele czasu przywracania i punktu przywracania dla każdej usługi. Kopia zapasowa nie jest dowodem przywrócenia, dopóki nie zostanie odtworzona i zweryfikowana. Ćwicz scenariusze ransomware, utratę regionu, wygasłe certyfikaty, awarię tożsamości i awarię dostawcy. Śledź konfigurację i infrastrukturę jako kod, gdy to możliwe, aby przywracanie było odtwarzalne.
Bezpieczeństwo, automatyzacja i metryki
Stosuj zasadę najmniejszych przywilejów, zarządzanie łatkami i podatnościami, kontrolę urządzeń końcowych, segmentację sieci, logowanie i reagowanie na incydenty. Automatyzuj powtarzalne zadania przy użyciu idempotencji, limitów, zatwierdzeń i audytu. Mierz dostępność usług, powtarzalność incydentów, realizację zgłoszeń, niepowodzenia zmian, przywracanie, narażenie na luki, pojemność, koszty i satysfakcję użytkowników — nie tylko zamknięcie zgłoszenia. ITOps odnosi sukces, gdy technologia wspiera pracę przewidywalnie i potrafi przywrócić działanie po awarii, a nie wtedy, gdy infrastruktura wydaje się zajęta lub pulpity wyświetlają więcej zielonych wskaźników.
Przykład praktyczny: odzyskiwanie usługi współpracy
Firma definiuje czterogodzinny cel czasu przywracania (RTO) i jednorogodzinny cel punktu przywracania (RPO) dla platformy współpracy. Inwentaryzuje tożsamość, DNS, sieć, dane, klucze, konfigurację, integracje i zależności od dostawców. Ćwiczenie odzyskiwania zakłada, że główny region i konto administratora są niedostępne. Operatorzy aktywują niezależnie chronioną tożsamość awaryjną, przywracają konfigurację usługi i dane w odizolowanym regionie oraz weryfikują uprawnienia, wiadomości, integracje i dostęp klientów. Właściciele biznesowi weryfikują przywróconą usługę przy użyciu realistycznych ścieżek użytkowników, a nie polegają wyłącznie na kontrolach stanu infrastruktury.
Ćwiczenie rejestruje rzeczywistą utratę danych, upływ czasu, ręczne kroki, nieudane kontakty i ukryte zależności. Kopia zapasowa, która przywraca pliki, ale nie klucze szyfrowania ani politykę tożsamości, jest oznaczona jako niekompletna. Działania korygujące otrzymują właścicieli i daty, a podręcznik operacyjny jest aktualizowany i ponownie testowany. Dołączono szablony monitorowania i komunikacji. Organizacja mierzy dowody przywracania, a nie sukces zadania kopii zapasowej, uznając, że niezawodne ITOps muszą przywrócić usługę, której potrzebują użytkownicy, w realistycznych warunkach awaryjnych.
Dowody wdrożenia i gotowość operacyjna
Decyzja o wdrożeniu wymaga więcej niż udanej demonstracji. Zdefiniuj docelowych użytkowników, środowisko operacyjne, dane wejściowe, wyjściowe, zależności, właściciela oraz konsekwencje każdego istotnego błędu. Ustal odtwarzalną bazę i wersjonowany zestaw oceny przed dostrojeniem. Testuj typowe przypadki, warunki brzegowe, nieprawidłowe lub brakujące dane, zmianę dystrybucji, awarię zależności, niewłaściwe użycie oraz grupy lub środowiska, które najczęściej są niedostatecznie obsługiwane. Mierz jakość zadania wraz z kalibracją lub niepewnością, opóźnieniem, przepustowością, kosztami zasobów, dostępnością, prywatnością i bezpieczeństwem. Zapisz każdą transformację i próg, aby niezależny recenzent mógł odtworzyć wynik i odróżnić dowody od atrakcyjnego prototypu.
Przed uruchomieniem przydziel uprawnienia do wydania, wyjątków, zmian, przywracania i wycofania. Stosuj etapowe wdrażanie, zachowaj bezpieczną alternatywę i weryfikuj monitorowanie przy celowo wprowadzonych awariach. Telemetria operacyjna powinna ujawniać jakość danych wejściowych, zachowanie wyjścia, wersję modelu lub reguły, stan zależności, interwencje ludzkie i potwierdzone wyniki, bez gromadzenia niepotrzebnych wrażliwych danych. Zdefiniuj progi alertów i właściciela reakcji, a następnie przeglądaj dowody z rzeczywistego świata po wdrożeniu, zamiast zakładać, że wydajność offline będzie się utrzymywać. Ponownie oceniaj przy każdej zmianie źródeł danych, użytkowników, modeli, dostawców, polityk, sprzętu lub celów. Utrzymany system wymaga także udokumentowanego przywracania, uczenia się z incydentów, procedur usuwania i przechowywania oraz jasno określonego momentu, w którym powinien zostać wyłączony lub zastąpiony.
Często zadawane pytania
Jaki jest podstawowy cel ITOps?
Dostarczanie i przywracanie niezawodnych usług technologicznych w ramach uzgodnionych ograniczeń dotyczących bezpieczeństwa, wydajności, ciągłości i kosztów.
Czy infrastruktura chmurowa jest obsługiwana w całości przez dostawcę chmury?
Nie. Dostawcy zarządzają częściami podstawowej platformy, podczas gdy klienci pozostają odpowiedzialni za konfigurację, tożsamość, dane, obciążenia, monitorowanie i wiele decyzji dotyczących poziomu usług.
Podstawowe źródła












