
Podstawy AI
Czym jest wyjaśnialna sztuczna inteligencja?

 Dodaj Unite.AI do preferowanych źródeł w Google
Explainable AI (XAI) obejmuje metody i praktyki, które pomagają ludziom zrozumieć zachowanie lub wynik systemu AI. Wyjaśnienie może opisywać wpływowe wejścia, pokazywać podobny przykład, przedstawiać zmianę kontrfaktyczną, podsumowywać globalną regułę lub komunikować, kiedy system nie jest pewny.
Nie istnieje uniwersalne najlepsze wyjaśnienie. Programista debugujący model, audytor testujący zgodność z polityką i osoba dotknięta decyzją potrzebują różnych dowodów. Wyjaśnienia muszą więc być oceniane pod kątem dokładności, znaczenia i zamierzonego zastosowania — nie tylko atrakcyjności wizualnej.
Kluczowe wnioski
- Transparentność opisuje dostępne informacje; interpretowalność dotyczy znaczenia; wyjaśnienie przekazuje dowody lub przyczyny.
- Metody globalne podsumowują model, natomiast metody lokalne odnoszą się do jednej prognozy lub małego regionu.
- Wyjaśnienia post‑hoc mogą być użyteczne, ale mogą być niestabilne lub nieodpowiadające rzeczywistemu modelowi.
- Wyjaśnienie nie dowodzi sprawiedliwości, przyczynowości, odporności ani poprawności.
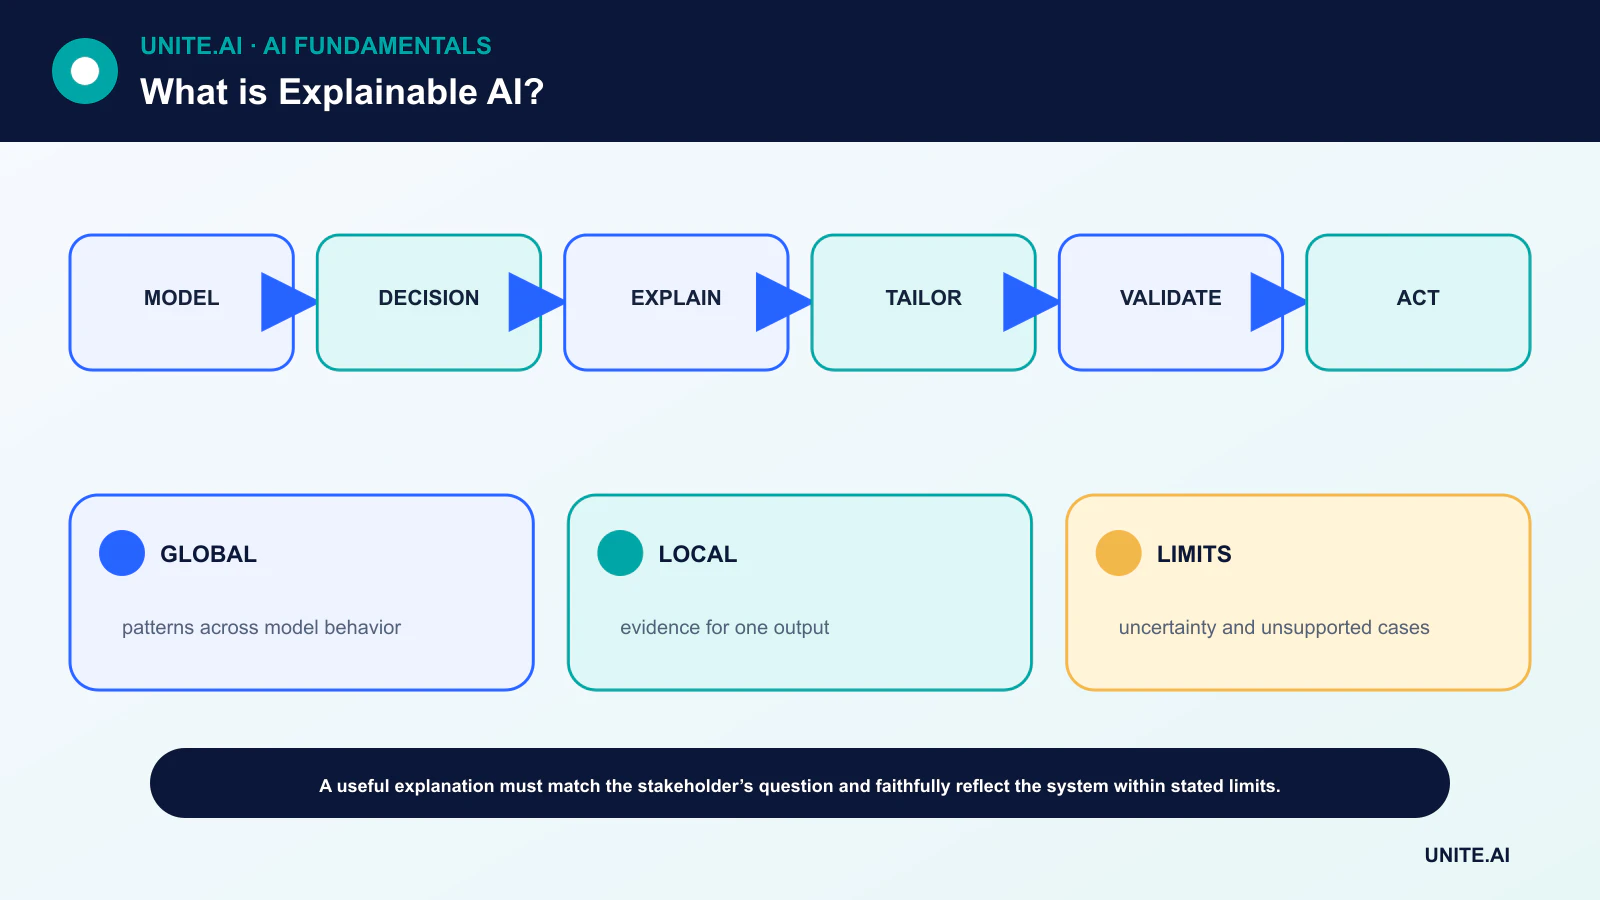
Cztery zasady użytecznych wyjaśnień
NIST proponuje, aby system zapewniał wyjaśnienie, czynił je zrozumiałym dla zamierzonego użytkownika, zapewniał, że dokładnie odzwierciedla proces systemu oraz komunikował jego ograniczenia wiedzy. Zasady te rozdzielają istnienie wyjaśnienia od jego jakości.
Znaczenie jest specyficzne dla odbiorcy. Zwięzły kod przyczyny może pomóc wnioskodawcy, podczas gdy deweloper modelu może potrzebować rozkładów, zachowań cech i klastrów błędów. Oba powinny być powiązane z tym samym udokumentowanym systemem i kontekstem decyzji.
Metody wewnętrzne i post‑hoc
Rzadki model liniowy lub ograniczone drzewo decyzyjne może być bezpośrednio interpretowalne w swoim dopuszczalnym zakresie. Złożony model może natomiast korzystać z post‑hoc przypisywania cech, lokalnego surrogatu, przykładów, map uwagi lub kontrfaktyków.
Wewnętrzna prostota nie jest automatycznie wierna, gdy cechy są słabo zdefiniowane lub pipeline jest ukryty. Złożoność post‑hoc nie jest automatycznie myląca. Metodę należy przetestować pod kątem pytania, na które ma odpowiedzieć.
Przypisywanie cech i skorelowane wejścia
Metody przypisywania przydzielają części wyniku do cech wejściowych przy wyraźnych założeniach. LIME dopasowuje prosty lokalny surrogat wokół prognozy; metody powiązane z SHAP łączą przydziały addytywne z koncepcjami wartości Shapleya.
Skorelowane cechy mogą współdzielić lub wymieniać przydziały, a wysoki przydział nie jest efektem przyczynowym. Zmiana jednej cechy w izolacji może stworzyć niemożliwą osobę, obraz lub transakcję. Wyjaśnienia powinny podawać swoje założenia dotyczące bazowego poziomu, próbkowania i zależności.
Kontrafakty, przykłady i zachowanie globalne
Kontrafakt pyta, jaka wykonalna zmiana zmieniłaby wynik. Ograniczenia są niezbędne: praktyczne wyjaśnienie nie powinno zalecać niezmiennych, nielegalnych ani nierealistycznych zmian. Metody oparte na przykładach pokazują prototypy lub wpływowe przypadki treningowe, ale mogą ujawniać prywatne dane.
Analiza globalna bada wydajność, zależność częściową, monotoniczność, interakcje i zachowanie podgrup. Dla zespołów, takich jak gradient boosting, łączy się podsumowania z lokalnymi dowodami i bezpośrednimi testami oczekiwanych ograniczeń.
Walidacja wyjaśnienia i systemu
Testuj wierność, stabilność przy małych perturbacjach, spójność przy równoważnych wejściach, zrozumienie przez użytkownika oraz to, czy wyjaśnienie wspiera odpowiednią decyzję. Testy adwersarialne powinny sprawdzać, czy przekonujące wyjaśnienie może towarzyszyć błędnemu lub zmanipulowanemu wynikowi.
XAI należy umieścić w szerszej ocenie: jakość na zbiorze testowym, kalibrację, sprawiedliwość, prywatność, bezpieczeństwo, monitorowanie i mechanizmy odwoławcze. Wyjaśnienie może wspierać rozliczalność, ale nie może zastąpić odpowiedzialnego zarządzania.
Docelowe grupy wyjaśnień i rodziny metod
Explainable AI powinno zaczynać się od pytania i odbiorcy: dlaczego podjęto daną decyzję, jak model zachowuje się ogólnie, jakie dowody na nią wpłynęły, co zmieniłoby wynik lub czy spełniono politykę. Wyjaśnienia lokalne dotyczą jednej prognozy; wyjaśnienia globalne podsumowują szersze zachowanie. Modele wewnętrznie interpretowalne ujawniają współczynniki, reguły lub struktury, podczas gdy metody post‑hoc przybliżają złożone modele. Wyjaśnienie zachowania modelu nie jest automatycznie wyjaśnieniem przyczynowym świata ani uzasadnieniem, że decyzja jest sprawiedliwa.
Metody przypisywania cech obejmują gradienty, zintegrowane gradienty, wartości w stylu SHAP, permutacje i lokalne modele surrogatowe. Wyjaśnienia oparte na przykładach przywołują wpływowe lub podobne przypadki; kontrfakty proponują zmiany związane z innym wynikiem; metody koncepcyjne łączą wewnętrzne reprezentacje z ludzkimi kategoriami. Każda z nich ma założenia dotyczące bazowych poziomów, niezależności cech, lokalnej liniowości lub dostępu do modelu. Skorelowane zmienne, interakcje i przetwarzanie wstępne mogą sprawiać, że przydziały są niestabilne lub mylące. Porównuj metody i perturbuj wejścia, aby sprawdzić, czy wyjaśnienie przewiduje zachowanie.
Ewaluacja i czynniki ludzkie
Ocena wierności — czy wyjaśnienie odpowiada modelowi — powinna być oddzielona od jego wiarygodności dla człowieka. Testuj stabilność, czułość, kompletność, rzadkość i użyteczność w określonym zadaniu, takim jak debugowanie lub odwołanie. Badania z udziałem ludzi wymagają reprezentatywnych uczestników i powinny mierzyć jakość decyzji, wykrywanie błędów, zależność i czas, a nie to, czy użytkownicy mówią, że wykres jest czytelny. Przekonujące wyjaśnienie może zwiększyć zaufanie do błędnego modelu, więc interfejsy muszą pokazywać niepewność, alternatywy i ograniczenia.
Kontrafakty powinny być wykonalne, praktyczne i nie zalecać zmiany chronionych lub niezmiennych cech. Wyjaśnienia mogą wyciekać informacje o modelu lub osobie i pomagać atakującym w odwróconym inżynierii decyzji. Stosuj kontrolę dostępu i minimalizację wyjścia. W zastosowaniach regulowanych lub o wysokim wpływie zachowuj pochodzenie danych, wersję modelu, próg i rzeczywistą logikę decyzji; ogólny wykres ważności cech nie zastąpi prawnie istotnego uzasadnienia ani przeglądu ludzkiego.
Stosowanie wyjaśnień odpowiedzialnie
Wybierz najprostszy model spełniający wymagania wydajności i operacyjne, ale nie poświęcaj ważności na rzecz powierzchownej interpretowalności. Łącz wyjaśnienia z testami podgrup, kontrolą odporności, analizą przyczynową tam, gdzie ma to sens, oraz monitorowaniem wyników. Dokumentuj zamierzoną publiczność i nieważne wnioski. Jeśli wyjaśnienie zmienia się po nieszkodliwej perturbacji, zbadaj to przed wdrożeniem. Wyjaśnialność jest dowodem o systemie przy użyciu określonej metody; jest cenna przy debugowaniu, nadzorze i komunikacji, ale nie poświadcza prawdy, sprawiedliwości, bezpieczeństwa ani zrozumienia.
Przykład praktyczny: wyjaśnianie modelu ryzyka kredytowego
Kredytodawca najpierw definiuje odbiorcę i wymagany powód: wnioskodawcy potrzebują dokładnych czynników decyzji i ścieżki korekty, a deweloperzy potrzebują diagnostyki. Skalibrowany, interpretowalny baseline jest porównywany z modelem boostowanym. Lokalne przydziały, kontrfakty i globalna analiza błędów są testowane pod kątem wierności, stabilności, zachowania skorelowanych cech i użyteczności. Wyjaśnienia nie mogą zalecać zmiany wieku, niepełnosprawności ani innej niezmiennej cechy i nie są przedstawiane jako efekty przyczynowe.
Rejestr decyzji produkcyjnej zachowuje źródłowe dane, transformację cech, model, próg, politykę i działanie człowieka. Wnioskodawcy mogą kwestionować nieprawidłowe dane i otrzymać sensowny przegląd. Monitorowanie sprawdza stabilność wyniku i wyjaśnienia w różnych grupach i przy aktualizacjach modelu. Jeśli wiarygodne wyjaśnienie zmieni się przy nieszkodliwej perturbacji cechy lub pominie decydującą regułę polityki, wdrożenie zostaje wstrzymane. Wyjaśnialność uzupełnia walidację i prawa proceduralne; nie usprawiedliwia niewłaściwego celu, dyskryminacyjnych wyników ani braku odpowiedzialnej ludzkiej władzy.
Dowody wdrożeniowe i gotowość operacyjna
Decyzja produkcyjna wymaga więcej niż udane demo. Zdefiniuj zamierzone grupy użytkowników, środowisko operacyjne, wejścia, wyjścia, zależności, właściciela oraz konsekwencje każdego istotnego błędu. Ustal odtwarzalny baseline i wersjonowany zestaw ewaluacyjny przed strojeniem. Testuj typowe przypadki, warunki brzegowe, niepoprawne lub brakujące wejścia, przesunięcie rozkładu, awarię zależności, nadużycie oraz grupy lub środowiska najczęściej niedoszacowane. Mierz jakość zadania wraz z kalibracją lub niepewnością, opóźnieniem, przepustowością, kosztem zasobów, dostępnością, prywatnością i bezpieczeństwem. Rejestruj każdą transformację i próg, aby niezależny recenzent mógł odtworzyć wynik i odróżnić dowód od atrakcyjnego prototypu.
Przed uruchomieniem przydziel odpowiedzialność za wydanie, wyjątki, zmiany, wycofanie i wycofanie. Stosuj etapowe wdrażanie, zachowaj bezpieczną wersję awaryjną i zweryfikuj monitorowanie przy celowo wprowadzonych awariach. Telemetria operacyjna powinna ujawniać jakość wejść, zachowanie wyjść, wersję modelu lub reguły, stan zależności, interwencje ludzkie oraz potwierdzone wyniki, nie gromadząc niepotrzebnych wrażliwych danych. Określ progi alarmowe i właściciela reakcji, a następnie po wdrożeniu przeglądaj dowody z rzeczywistego świata zamiast zakładać, że offline’owa wydajność się utrzyma. Reewaluuj przy zmianie źródeł danych, użytkowników, modeli, dostawców, polityk, sprzętu lub celów. Utrzymany system wymaga również udokumentowanych procedur przywracania, nauki z incydentów, usuwania i przechowywania oraz jasnego punktu, w którym powinien zostać wyłączony lub zastąpiony.
Najczęściej zadawane pytania
Czy mapy uwagi są wyjaśnieniami?
Można je traktować jako sygnały diagnostyczne, ale same wagi uwagi nie gwarantują wiernego odzwierciedlenia przyczyn wyniku modelu.
Czy wyjaśnialna AI wymaga prostego modelu?
Nie zawsze. Złożone modele mogą być analizowane metodami post‑hoc, ale takie wyjaśnienia wymagają niezależnej walidacji i jasno określonych granic.
Podstawowe źródła












