Podstawy AI
Czym jest generatywna sztuczna inteligencja?

 Dodaj Unite.AI do preferowanych źródeł w Google
Generative AI odnosi się do modeli, które uczą się wzorców w danych i generują nowy tekst, obrazy, dźwięk, wideo, kod lub inne reprezentacje, gdy są warunkowane instrukcjami lub przykładami. Wynik jest syntetyzowany z modelu prawdopodobieństwa; nie jest pobierany w całości z bazy danych, choć narzędzia wyszukiwania mogą dostarczać zewnętrzne dowody.
Różne rodziny modeli generują w odmienny sposób. Autoregresywne transformatory przewidują sekwencję token po tokenie, modele dyfuzyjne iteracyjnie odszumiają próbkę, a generatywne sieci przeciwstawne (GAN) uczą się poprzez rywalizację generatora i dyskryminatora.
Kluczowe wnioski
- Generowanie to warunkowe próbkowanie z wyuczonego rozkładu, nie gwarantujące przywołania faktów.
- Transformatory, modele dyfuzyjne, GANy oraz wariacyjne autoenkodery podejmują różne kompromisy.
- Wyszukiwanie i narzędzia mogą stanowić podstawę systemu, ale ich wyniki i uprawnienia nadal wymagają weryfikacji.
- Zarządzanie ryzykiem obejmuje dane, model, interfejs, wdrożenie, monitorowanie oraz pochodzenie treści.
Jak uczą się modele generatywne
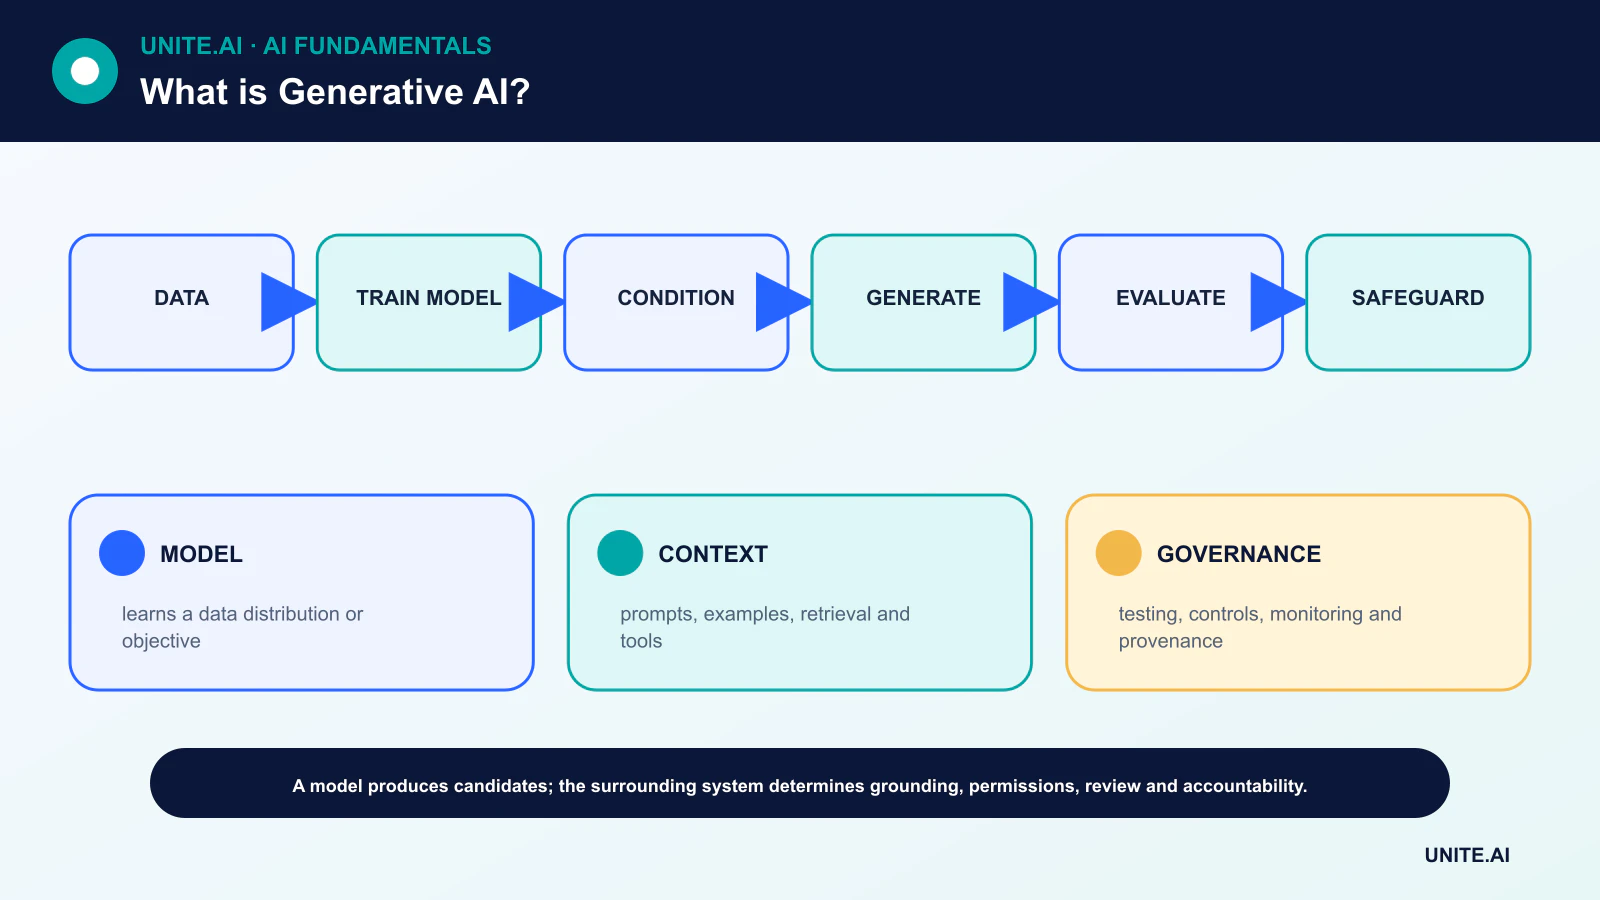
Cele treningowe nagradzają model za przewidywanie lub odtwarzanie wzorców w przykładach. Model językowy szacuje kolejny token; model dyfuzyjny uczy się odwracać proces szumu; wariacyjny autoenkoder uczy się ustrukturyzowanego rozkładu ukrytego oraz dekodera.
To szkolenie tworzy statystyczną generalizację, ale może także odtwarzać uprzedzenia, zapamiętywać rzadkie sekwencje lub nie działać poza rozkładem danych. Dokumentacja zestawów danych, deduplikacja, kontrola prywatności oraz ocena na odrębnych danych są więc istotne przed wdrożeniem.
Główne rodziny architektur
Autoregresywne transformatory dominują w tekście i obsługują sekwencje multimodalne. Modele dyfuzyjne są szeroko stosowane do generacji obrazów i dźwięków o wysokiej wierności. GANy mogą tworzyć ostre próbki i kontrolowane systemy obrazowe, ale ich trening może być trudny.
Wariacyjne autoenkodery zapewniają modelowanie zmiennych ukrytych i efektywne reprezentacje, czasami działając w większych potokach generatywnych. Rzeczywiste produkty często łączą kilka modeli z wyszukiwaniem, filtrami, narzędziami i deterministycznym kodem.
Warunkowanie, próbkowanie i kontrola
Prompt, etykieta klasy, obraz, klip audio lub ustrukturyzowany rekord mogą warunkować generowanie. Parametry próbkowania wpływają na różnorodność i deterministyczność. Niższa temperatura może skoncentrować prawdopodobieństwa tokenów, ale nie sprawia, że nieprawidłowa odpowiedź staje się prawdziwa.
Kontrola poprawia się, gdy system wykorzystuje explicite schematy, ograniczone dekodowanie, materiały odniesienia i weryfikację. Inżynieria promptów zmienia kontekst; dopasowanie (fine‑tuning) zmienia parametry; wyszukiwanie dostarcza zewnętrzne informacje. Każde z nich adresuje inny tryb awarii.
Ocena jest specyficzna dla zastosowania
Systemy tekstowe mogą wymagać testów faktualności, realizacji zadania, wsparcia cytowań, toksyczności i kalibracji. Systemy obrazu lub dźwięku mogą wymagać wierności, semantycznego dopasowania, różnorodności, bezpieczeństwa tożsamości oraz przeglądu percepcyjnego. Łącz automatyczne metryki z reprezentatywną oceną ludzką.
Stwórz wersjonowany zestaw oceny, który obejmuje przypadki zwykłe, rzadkie, adversarialne i istotne z perspektywy polityki. Monitoruj opóźnienia, koszty i zachowania odmowy, a także jakość wyników. Demo wybrane przez jego twórcę nie jest dowodem na niezawodność na poziomie populacji.
Ryzyka, zabezpieczenia i pochodzenie
Istotne ryzyka obejmują halucynacje, wstrzyknięcia promptów, szkodliwe treści, podszywanie się, niebezpieczne użycie narzędzi, wycieki prywatności, spory prawne dotyczące praw autorskich, uprzedzenia automatyzacji oraz nieprzejrzyste łańcuchy dostaw. Profil Generatywnej AI NIST organizuje działania w zakresie zarządzania, pochodzenia treści, testów przed wdrożeniem i ujawniania incydentów.
Używaj narzędzi o najmniejszych uprawnieniach, kontroli wejścia/wyjścia, przeglądu ludzkiego przy decyzjach o konsekwencjach, logowania, wycofywania i zgłaszania przez użytkowników. Znaki wodne lub poświadczenia treści mogą dodać sygnały, ale żaden pojedynczy detektor ani etykieta nie ustala prawdy. Szerszy przepływ syntetycznych mediów musi zachować kontekst i odpowiedzialność.
Rodziny modeli i mechanizmy generacji
Modele generatywnej AI szacują lub uczą się procesu, który może wytwarzać nowy tekst, obrazy, dźwięk, wideo, kod lub ustrukturyzowane dane. Modele autoregresywne przewidują kolejny token lub element; modele dyfuzyjne uczą się odwracać proces szumu; wariacyjne autoenkodery uczą się probabilistycznych zmiennych ukrytych; GANy trenują generator przeciwko dyskryminatorowi. Systemy multimodalne łączą reprezentacje pomiędzy mediami. Wynik jest próbkowany z wyuczonej struktury statystycznej warunkowanej promptami, kontekstem, narzędziami lub innymi wejściami — nie jest pobierany jako gwarantowany fakt.
Modele bazowe są wstępnie trenowane na szerokich danych i dostosowywane poprzez prompting, wyszukiwanie, fine‑tuning, optymalizację preferencji, sieci kontrolne lub głowice specyficzne dla zadania. Tokenizery, enkodery, dekodery, przestrzenie latentne i ustawienia próbkowania kształtują wyniki. Temperatura i filtrowanie kandydatów wymieniają deterministyczność i różnorodność. Dłuższe prompty dostarczają kontekst, ale mogą powodować konflikty, rozproszenia lub zawierać złośliwe instrukcje. Wyszukiwanie może ugruntować zmieniającą się wiedzę, podczas gdy deterministyczny kod powinien obsługiwać dokładne obliczenia i reguły.
Ocena, pochodzenie i prawa
Ocena według zadania: poprawność faktualna i cytowanie odpowiedzi, wykonanie i bezpieczeństwo kodu, wierność i różnorodność mediów oraz rezultat ludzki przy pomocy kreatywnej. Uwzględnij odmowy, kalibrację, opóźnienia, koszty, języki, dostępność oraz testy adversarialne. Płynny lub fotorealistyczny wynik może być błędny. Zachowaj model, prompt, seed, źródłowe dowody, wywołania narzędzi i przetwarzanie końcowe w celu reprodukowalności. Oddziel jakość wyszukiwania od generacji, aby dopracowana odpowiedź nie mogła ukrywać brakujących dowodów.
Szkolenie i wyniki podnoszą kwestie praw autorskich, licencji, zgody, prywatności, publicity oraz poufności. Ustal pochodzenie i dozwolone użycie danych wejściowych; zapobiegaj ujawnianiu tajemnic przez użytkowników; testuj zapamiętywanie; oraz zapewnij procesy raportowania i usuwania. Syntetyczne media powinny zawierać trwałe pochodzenie lub ujawnienie, gdy to możliwe, szczególnie gdy mogą być pomylone z dowodami. Nie używaj podobizny, głosu ani stylu w sposób naruszający prawa lub wprowadzający w błąd.
Kontrole wdrożenia
Traktuj wyjście modelu jako nieufne wejście. Waliduj schematy, sanitizuj kod i pliki, izoluj wykonywanie, autoryzuj każde narzędzie zewnętrznie, ograniczaj koszty i tempo oraz wymagaj potwierdzenia przy działaniach o konsekwencjach. Monitoruj awarie, nadużycia, dryft oraz korekty użytkowników, z możliwością wycofania i alternatywą nie‑generatywną. Dokumentuj zamierzone i zabronione zastosowania. Generatywna AI rozszerza interfejs do tworzenia i przekształcania informacji, ale niezawodność i odpowiedzialność pochodzą z otaczających danych, oceny, bezpieczeństwa, pochodzenia i procesu decyzyjnego człowieka.
Przykładowe zastosowanie: asystent generujący opisy produktów
Sprzedawca pozwala redaktorom generować szkice opisów wyłącznie na podstawie zatwierdzonych atrybutów produktów i wytycznych marki. Prompt zawiera ustrukturyzowane fakty, a wyszukiwanie dostarcza aktualną politykę. Wynik musi spełniać schemat i jest weryfikowany względem wartości źródłowych; nieobsługiwane wymiary, twierdzenia o bezpieczeństwie lub certyfikaty skutkują odrzuceniem. Ocena obejmuje poprawność faktualną, styl, duplikację, jakość wielojęzyczną, dostępność, opóźnienie oraz korekty redaktora, w porównaniu z szablonami i ręcznym pisaniem.
Redaktorzy zatwierdzają każdą publikację i mogą zobaczyć pola źródłowe. Model nie ma możliwości zmiany ceny, stanu magazynowego ani bezpośredniego publikowania. Prompt i dane produktu są chronione przed wstrzyknięciami, a poufne notatki dostawcy są wykluczone. Monitorowanie śledzi nieobsługiwane roszczenia, edycje, skargi, koszty i wersje dostawcy. Wygenerowany tekst jest przechowywany wraz z pochodzeniem. System oszczędza czas tworzenia szkicu tylko wtedy, gdy korekty i przegląd nie wymażą korzyści, a prawda o produkcie pozostaje zarządzana przez autorytatywne dane.
Dowody wdrożeniowe i gotowość operacyjna
Decyzja o wdrożeniu wymaga więcej niż udanej demonstracji. Zdefiniuj docelowych użytkowników, środowisko operacyjne, wejścia, wyjścia, zależności, właściciela oraz konsekwencje każdego istotnego błędu. Ustal odtwarzalną bazę i wersjonowany zestaw oceny przed dostrojeniem. Testuj przypadki zwykłe, warunki brzegowe, nieprawidłowe lub brakujące dane wejściowe, przesunięcie rozkładu, awarie zależności, niewłaściwe użycie oraz grupy lub środowiska najprawdopodobniej niedostatecznie obsłużone. Mierz jakość zadania wraz z kalibracją lub niepewnością, opóźnieniem, przepustowością, kosztami zasobów, dostępnością, prywatnością i bezpieczeństwem. Zapisz każdą transformację i próg, aby niezależny recenzent mógł odtworzyć wynik i odróżnić dowody od atrakcyjnego prototypu.
Przed uruchomieniem przydziel uprawnienia do wydania, wyjątków, zmian, wycofania i wycofania z eksploatacji. Stosuj etapowe wdrażanie, zachowaj bezpieczną alternatywę i zweryfikuj monitorowanie przy celowo wprowadzonych awariach. Telemetria operacyjna powinna ujawniać jakość danych wejściowych, zachowanie wyjścia, wersję modelu lub reguły, stan zależności, interwencje ludzkie oraz potwierdzone wyniki, nie gromadząc niepotrzebnych wrażliwych danych. Określ progi alarmowe i właściciela reakcji, a następnie przeglądaj dowody z rzeczywistego świata po wdrożeniu, zamiast zakładać, że wydajność offline będzie trwała. Ponownie oceniaj, gdy zmieniają się źródła danych, użytkownicy, modele, dostawcy, polityki, sprzęt lub cele. Utrzymany system wymaga także udokumentowanego odzyskiwania, nauki z incydentów, procedur usuwania i przechowywania oraz wyraźnego momentu, w którym powinien zostać wyłączony lub zastąpiony.
Często zadawane pytania
Czy generatywna AI jest tym samym co duży model językowy?
Nie. LLM‑y są jedną klasą modeli generatywnych. Generatywna AI obejmuje także systemy obrazowe, dźwiękowe, wideo oraz ustrukturyzowane dane, zbudowane w oparciu o różne architektury.
Czy model kopiuje swoje dane treningowe?
Zazwyczaj syntetyzuje na podstawie wyuczonych wzorców, ale może dochodzić do zapamiętywania i prawie identycznych duplikatów. Ryzyka związane z prywatnością i pochodzeniem muszą być oceniane, a nie zakładane jako nieistniejące.
Podstawowe odniesienia