Podstawy AI
Co to jest autoenkoder?

 Dodaj Unite.AI do preferowanych źródeł w Google
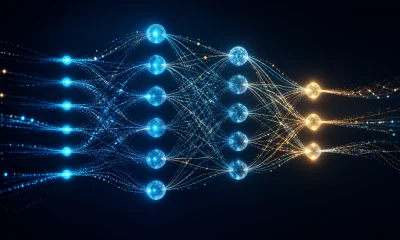
Autoenkoder to sieć neuronowa uczona do odtwarzania swojego wejścia. Enkoder mapuje wejście na reprezentację ukrytą; dekoder mapuje tę reprezentację z powrotem na odtworzenie. Trening minimalizuje stratę rekonstrukcji, czasami z dodatkowymi ograniczeniami.
Idealne kopiowanie wejścia nie jest automatycznie użyteczne. Architektura lub cel muszą wprowadzić wąskie gardło, dodać szum, narzucić rzadkość lub w inny sposób zapobiec trywialnemu odwzorowaniu tożsamościowemu, aby kod ukryty uchwycił użyteczną strukturę.
Kluczowe wnioski
- Enkoder kompresuje lub przekształca wejście; dekoder odtwarza je z kodu ukrytego.
- Wąskie gardło o mniejszej liczbie wymiarów, szum lub regularizacja zachęcają model do uczenia się struktury, a nie kopiowania.
- Błąd rekonstrukcji może wspierać wykrywanie anomalii, ale nie ma gwarancji, że anomalie będą miały wysoki błąd.
- Wariacyjne autoenkodery uczą się probabilistycznego modelu ukrytego i różnią się od deterministycznych autoenkoderów.
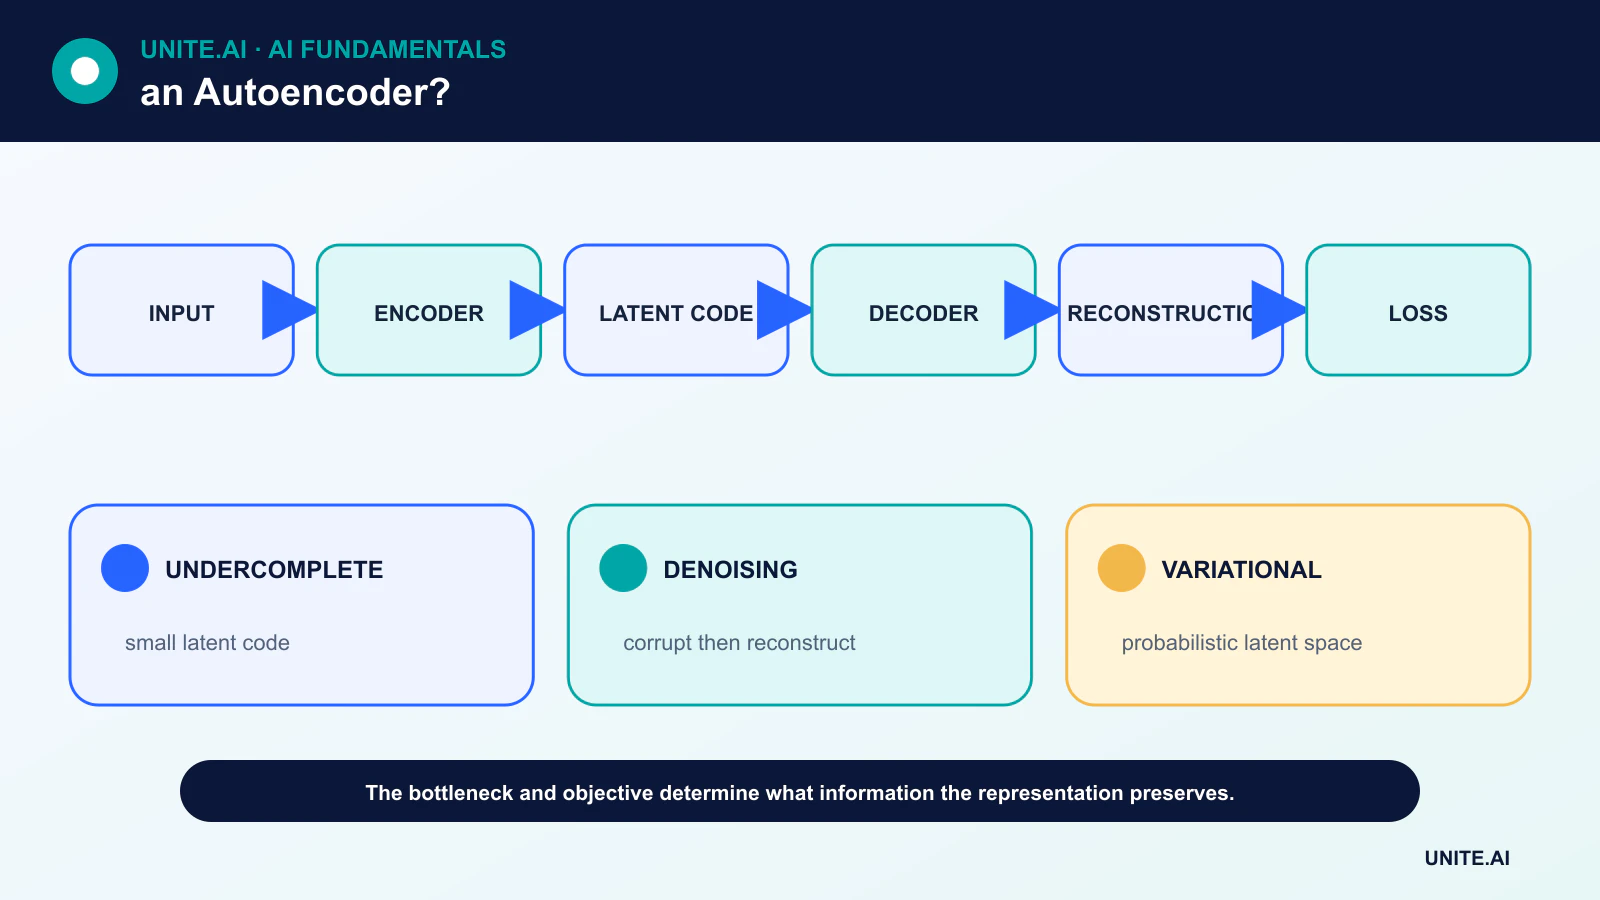
Enkoder, przestrzeń ukryta i dekoder
Dla wejścia x enkoder generuje kod ukryty z = f(x), a dekoder generuje rekonstrukcję x̂ = g(z). Strata porównuje x i x̂, na przykład przy użyciu średniego błędu kwadratowego dla wartości ciągłych lub funkcji wiarygodności dopasowanej do danych.
Wymiar ukryty może być mniejszy niż wymiar wejścia, tworząc podkompletny autoenkoder. Głęboka sieć może także uczyć się nieliniowych reprezentacji, rozwijając koncepcję redukcji wymiarowości.
Popularne warianty autoenkoderów
Rzadki autoenkoder karze rozległą aktywację. Autoenkoder odszumiający otrzymuje zniekształcone wejście i odtwarza czystą wersję. Autoenkoder kontraktywny karze wrażliwość kodu na małe zmiany wejścia.
Wariacyjny autoenkoder (VAE) koduje parametry rozkładu prawdopodobieństwa, losuje wartość ukrytą i równoważy rekonstrukcję z wyrazem regularizacji, który kształtuje przestrzeń ukrytą. To umożliwia próbkowanie, ale zmienia cel i interpretację.
Trening i unikanie trywialnych rozwiązań
Autoenkodery używają propagacji wstecznej podobnie jak inne sieci neuronowe. Sieć o nadmiernej pojemności może zapamiętywać przykłady treningowe lub uczyć się funkcji prawie identycznej. Rozmiar wąskiego gardła, zniekształcenia, kary i walidacja na niewidzianych danych ograniczają to.
Wybór funkcji straty ma znaczenie. Strata pikselowa może prowadzić do rozmytych rekonstrukcji obrazu, podczas gdy straty percepcyjne dziedziczą założenia z innej sieci. Najlepsza miara rekonstrukcji nie musi być najlepszą miarą podobieństwa semantycznego.
Zastosowania i ograniczenia
Autoenkodery mogą uczyć się cech, odszumiać sygnały, kompresować dane, inicjować modele i generować zmienne ukryte do wizualizacji. Do wykrywania anomalii model wytrenowany na danych normalnych może przypisywać wyższy błąd rekonstrukcji nietypowym wejściom.
To podejście może zawieść, gdy autoenkoder dobrze odtwarza także anomalie lub gdy nieszkodliwa zmienność jest trudniejsza do odtworzenia niż docelowa anomalia. Progi wymagają oznakowanych lub starannie zweryfikowanych danych walidacyjnych, a błąd powinien być monitorowany w podgrupach i warunkach operacyjnych.
Autoenkodery a inne modele generatywne
Deterministyczny autoenkoder nie jest automatycznie probabilistycznym modelem generatywnym. VAE definiują ustrukturyzowany rozkład ukryty; GANy trenują generator przeciwko dyskryminatorowi; modele dyfuzyjne uczą się procesu odszumiania.
Wybór zależy od tego, czy celem jest rekonstrukcja, reprezentacja, prawdopodobieństwo, jakość próbek, kontrolowalność czy ocena anomalii. Mniejszy model dostosowany do konkretnego zadania jest często bardziej praktyczny niż duży generator obrazów.
Cele enkodera‑dekodera i reprezentacje ukryte
Autoenkoder uczy się enkodera, który mapuje wejście x na kod ukryty z i dekodera, który odtwarza x z z. Jeśli pojemność nie jest ograniczona, może nauczyć się odwzorowania tożsamościowego z niewielką użyteczną strukturą. Wąskie gardła, regularizacja, zniekształcenia, rzadkość lub ograniczenia architektoniczne wymuszają reprezentację, która zachowuje wybrane informacje. Strata rekonstrukcji definiuje, co uznaje się za podobne: średni błąd kwadratowy sprzyja średniej wierności pikseli, podczas gdy straty percepcyjne lub specyficzne dla modalności podkreślają różne cechy. Niska wartość straty nie gwarantuje znaczenia semantycznego.
Podkompletne autoenkodery ograniczają wymiar ukryty. Autoenkodery odszumiające odtwarzają czyste dane z zniekształconego wejścia. Rzadkie warianty karzą aktywację; kontraktywne warianty karzą wrażliwość. Wariacyjne autoenkodery uczą się probabilistycznego rozkładu ukrytego, łącząc rekonstrukcję z wyrazem dywergencji, co umożliwia próbkowanie, ale zmienia cel. Konwolucyjne, sekwencyjne, grafowe i transformerowe autoenkodery kodują strukturę modalności. Wybierz rozmiar ukryty i regularizację poprzez walidację downstream, a nie jedynie atrakcyjne dwuwymiarowe wykresy.
Wykrywanie anomalii, kompresja i ocena
Do wykrywania anomalii trenuj na reprezentatywnych danych normalnych i oceniaj błąd rekonstrukcji lub prawdopodobieństwo ukryte, ale anomalie czasami mogą być dobrze odtwarzane, a rzadkie przypadki normalne słabo. Dobieraj progi na podstawie oznakowanych lub zweryfikowanych przypadków walidacyjnych, raportuj czułość na poziomie zdarzeń i fałszywe alarmy oraz testuj zmiany w stanie operacyjnym. Porównuj z prostymi metodami statystycznymi i jednowarstwowymi. Do kompresji uwzględnij pełny kodek — w tym rozmiar modelu, kwantyzację, metadane i koszt dekodowania — i porównaj jakość przy dopasowanym bitrate z ustalonymi kodekami.
Jakość reprezentacji można ocenić za pomocą sond liniowych, stabilności klasteryzacji, wyszukiwania, rekonstrukcji i zadań downstream, z których każde odpowiada na inne pytanie. Unikaj wycieków przy uczeniu enkodera i wyborze progów. Sprawdź, które cechy są pomijane przez stratę i czy wrażliwe atrybuty pozostają zakodowane. Skompresowany kod ukryty nie jest automatycznie anonimowy; odwrócenie i wnioskowanie atrybutów mogą odzyskać prywatne informacje. Generowane rekonstrukcje mogą wyglądać wiarygodnie, jednocześnie zmieniając istotne szczegóły.
Wdrożenie i monitorowanie
Wersjonuj enkoder i dekoder razem, weryfikuj zmiany liczbowe po eksporcie i zachowuj skalowanie wejścia. Monitoruj rozkład rekonstrukcji, dryft ukryty, alerty progowe i potwierdzone wyniki. W monitoringu przemysłowym warunkuj model na tryb pracy, aby normalne przejścia nie były traktowane jako usterki. W rekonstrukcji medycznej lub naukowej nigdy nie przedstawiaj wygenerowanego szczegółu jako zmierzonego dowodu bez walidacji i pochodzenia. Autoenkodery są elastycznymi uczącymi się reprezentacji, ale to ograniczenia i strata — a nie nazwa architektury — określają, które informacje są zachowywane, odrzucane lub wymyślane.
Przykład praktyczny: autoenkoder do wykrywania anomalii w pompach
Podkompletny autoenkoder uczy się okien drgań na podstawie zweryfikowanej, prawidłowej pracy pomp przy różnych obciążeniach i temperaturach. Jest porównywany z progami statystycznymi i metodami jednowarstwowymi, a próg rekonstrukcji jest dobierany na podstawie przeglądanych normalnych przejść i znanych usterek. Ocena wykorzystuje czułość zdarzeń, czas ostrzeżenia, liczbę fałszywych alarmów na godzinę pracy oraz wyniki per pompa, a nie losowe okna, które umieszczają sąsiadujące próbki w zbiorze treningowym i testowym.
Model produkcyjny warunkuje się na stanie operacyjnym i udostępnia inżynierom wzorce resztkowe. Wysoki błąd wywołuje inspekcję; nie diagnozuje części ani nie zatrzymuje pompy automatycznie. Odłączenie czujnika, przycięcie sygnału i nieznane obciążenie generują wyraźne stany nieprawidłowe. Monitorowanie śledzi rozkład rekonstrukcji, potwierdzenie alertu i stan czujników. Gdy konserwacja lub zmiana sprzętu modyfikuje bazę, stary model pozostaje dostępny, podczas gdy kandydat jest trenowany na przeglądanych danych i odtwarzany w odniesieniu do historycznych incydentów.
Dowody wdrożeniowe i gotowość operacyjna
Decyzja produkcyjna wymaga więcej niż udanej demonstracji. Zdefiniuj docelowych użytkowników, środowisko operacyjne, wejścia, wyjścia, zależności, właściciela oraz konsekwencje każdego istotnego awarii. Ustal powtarzalną bazę odniesienia i wersjonowany zestaw ewaluacyjny przed dostrojeniem. Testuj typowe przypadki, warunki brzegowe, nieprawidłowe lub brakujące dane wejściowe, przesunięcie rozkładu, awarie zależności, niewłaściwe użycie oraz grupy lub środowiska najprawdopodobniej niedostatecznie obsłużone. Mierz jakość zadania wraz z kalibracją lub niepewnością, opóźnieniem, przepustowością, kosztami zasobów, dostępnością, prywatnością i bezpieczeństwem. Zarejestruj każdą transformację i próg, aby niezależny recenzent mógł odtworzyć wynik i odróżnić dowody od atrakcyjnego prototypu.
Przed uruchomieniem przydziel odpowiedzialność za wydanie, wyjątki, zmiany, wycofanie i wycofanie produktu. Stosuj etapowe wdrażanie, zachowaj bezpieczną alternatywę i zweryfikuj monitorowanie przy celowo wprowadzonych awariach. Telemetria operacyjna powinna ujawniać jakość danych wejściowych, zachowanie wyjścia, wersję modelu lub reguły, stan zależności, interwencje ludzkie oraz potwierdzone wyniki, nie gromadząc niepotrzebnych danych wrażliwych. Zdefiniuj progi alarmowe i właściciela reakcji, a następnie przeglądaj dowody z rzeczywistego świata po wdrożeniu, zamiast zakładać, że wydajność offline będzie trwała. Przeprowadzaj ponowną ocenę przy zmianie źródeł danych, użytkowników, modeli, dostawców, polityk, sprzętu lub celów. Utrzymany system wymaga także udokumentowanego odzyskiwania, nauki z incydentów, procedur usuwania i przechowywania oraz wyraźnego momentu, w którym powinien zostać wyłączony lub zastąpiony.
Najczęściej zadawane pytania
Czy autoenkodery są bezstratną kompresją?
Nie, zazwyczaj nie. Uczą się one reprezentacji stratnych, specyficznych dla zadania i rozkładu, i wymagają wytrenowanego dekodera do odtworzenia danych.
Czy każde wąskie gardło jest interpretowalne?
Nie. Zwięzły kod może być użyteczny, nawet jeśli każda jego wymiar nie odpowiada pojęciu czytelnemu przez człowieka.
Podstawowe źródła