
Podstawy AI
Czym jest transfer learning?

 Dodaj Unite.AI do preferowanych źródeł w Google
Transfer learning ponownie wykorzystuje wiedzę zdobytą przy rozwiązywaniu jednego problemu, aby usprawnić uczenie się na powiązanym zadaniu. Zamiast inicjalizować każdy parametr losowo, praktyk rozpoczyna od modelu lub reprezentacji wstępnie wytrenowanej i dostosowuje ją do docelowego zadania.
Podejście to jest szczególnie przydatne, gdy docelowy zestaw danych jest mały, etykietowanie jest kosztowne lub wstępne uczenie wymaga więcej mocy obliczeniowej, niż zespół docelowy może uzasadnić. Trenowanie modelu od podstaw jest alternatywą dla transfer learningu — nie jest rodzajem transfer learningu.
Kluczowe wnioski
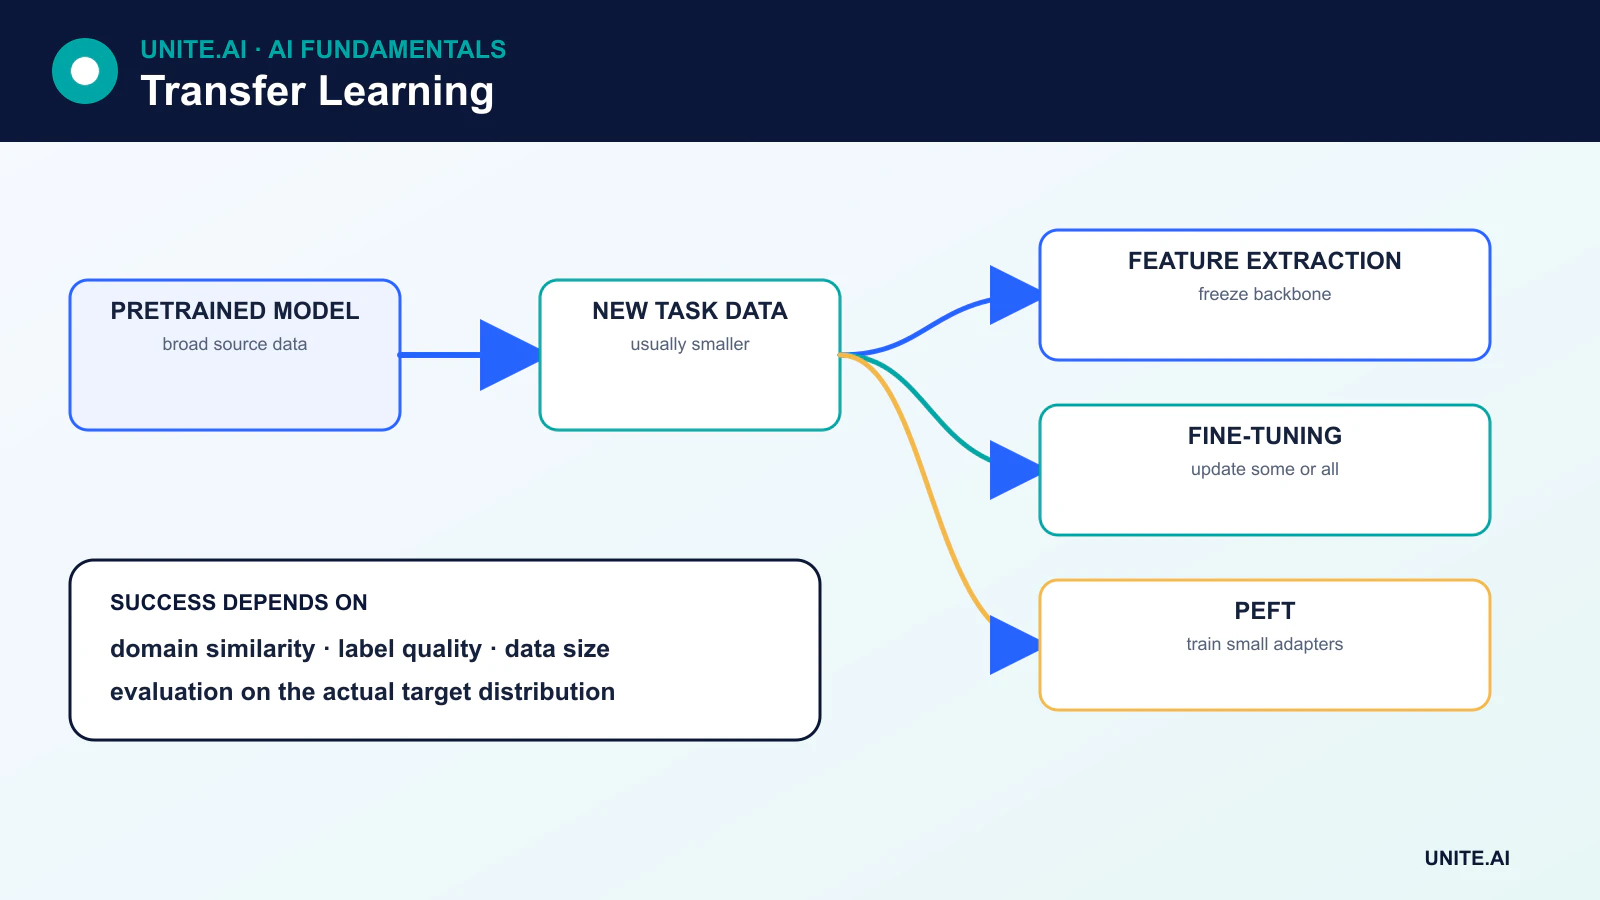
- Ekstrakcja cech utrzymuje wstępnie wytrenowaną bazę zamrożoną i trenuje nową głowicę specyficzną dla zadania.
- Dostrajanie aktualizuje niektóre lub wszystkie wstępnie wytrenowane parametry przy użyciu danych z docelowej dziedziny.
- Metody efektywne pod względem parametrów, takie jak adaptery i LoRA, aktualizują niewielką część modelu.
- Transfer może się nie udać, gdy domeny źródłowa i docelowa różnią się, licencje są niezgodne lub model źródłowy zawiera nieodpowiednie uprzedzenia.
Dlaczego transfer learning działa
Modele często uczą się reprezentacji przydatnych poza dokładnymi danymi, na których były trenowane. Wczesne warstwy modelu obrazowego mogą wychwytywać wielokrotnie użyteczne lokalne wzorce; model językowy może nauczyć się składni, semantyki i szerokich skojarzeń dzięki samonadzorowanej predykcji. Zadanie docelowe może korzystać z tych reprezentacji, zamiast uczyć się wszystkiego od nowa na podstawie ograniczonych przykładów.
Korzyść zależy od podobieństwa między zadaniami źródłowym i docelowym, skali i jakości wstępnego treningu oraz sposobu adaptacji modelu. Ponowne użycie nie jest gwarantowane: przeniesione cechy mogą być nieistotne lub wręcz szkodliwe.
Ekstrakcja cech
W ekstrakcji cech wstępnie wytrenowana baza jest zamrożona, więc jej parametry nie ulegają zmianie. Jej wyjście staje się wejściem dla nowego klasyfikatora, regresora lub innej głowicy specyficznej dla zadania. Trenuje się tylko nową głowicę.
Jest to szybkie i efektywne pod względem danych, a także zmniejsza ryzyko uszkodzenia użytecznych wstępnie wytrenowanych reprezentacji. Może jednak prowadzić do niedouczenia, gdy docelowa domena znacząco różni się od danych wstępnego treningu. Warstwy takie jak batch normalization wymagają szczególnej uwagi, ponieważ ich przechowywane statystyki i zachowanie podczas treningu mogą wpływać na adaptację, nawet gdy większość wag jest zamrożona.
Dostrajanie
Fine-tuning aktualizuje wstępnie wytrenowane parametry na danych docelowych. Typowy przepływ pracy wygląda następująco:
- Wczytaj wstępnie wytrenowany model i zamień lub dodaj głowicę wyjściową.
- Zamroź bazę i wytrenuj nową głowicę.
- Odmroź wybrane warstwy — lub cały model — i kontynuuj z mniejszą szybkością uczenia.
- Zweryfikuj pod kątem przeuczenia, zapominania i wydajności w docelowej domenie.
Nie ma uniwersalnej zasady, że należy dostrajać tylko ostatnie warstwy. Najlepszy wybór zależy od architektury, wielkości danych docelowych, podobieństwa domen, warstw normalizacyjnych, pamięci i mocy obliczeniowej. Pełne dostrajanie może zapewnić większą pojemność, ale wymaga więcej zasobów i może prowadzić do katastrofalnego zapominania.
Efektywne pod względem parametrów dostrajanie
Duże transformery sprawiają, że pełne dostrajanie jest kosztowne. Efektywne pod względem parametrów dostrajanie (PEFT) modyfikuje lub dodaje niewielki zestaw parametrów, pozostawiając większość bazowego modelu zamrożoną.
- Adapters wstawiają małe moduły uczące się do sieci.
- LoRA reprezentuje aktualizacje wag za pomocą macierzy o niskim rzędzie, zmniejszając liczbę uczących się parametrów oraz pamięć optymalizatora.
- Prompt and prefix tuning uczą ciągłych wejść specyficznych dla zadania lub wewnętrznych prefiksów.
PEFT może przechowywać wiele adaptacji zadań wokół jednego bazowego modelu, choć serwowanie wnioskowania, kompatybilność adapterów i zarządzanie połączonymi wagami nadal wymagają starannego inżynieringu.
Transfer learning w różnych typach danych
Klasyfikatory obrazów zazwyczaj zaczynają od modeli wstępnie wytrenowanych na dużych zestawach danych obrazowych. Systemy językowe korzystają z modelu bazowego i adaptują go poprzez nadzorowane dostrajanie, optymalizację preferencji, wyszukiwanie lub użycie narzędzi. Modele mowy, dźwięku, białek i multimodalne podążają podobnymi schematami.
Transfer może również zachodzić bez zmiany oryginalnego modelu. Zamrożony model może generować osadzenia (embeddings) dla klasyfikatora downstream, systemu wyszukiwania podobieństwa wektorowego lub potoku wyszukiwania.
Przesunięcie domeny i negatywny transfer
Domain shift występuje, gdy dane wejściowe docelowe różnią się od danych źródłowych. Model medycznych obrazów, na przykład, może napotkać sprzęt, populacje lub protokoły akwizycji nieobecne w danych wstępnego treningu. Negative transfer oznacza, że ponowne użycie pogarsza wydajność docelową w porównaniu z odpowiednią bazą trenowaną od podstaw.
Zespoły powinny porównywać strategie adaptacji, oceniać istotne podgrupy i utrzymywać zestaw testowy z docelowej domeny. Jeśli zadanie źródłowe jest słabo dopasowane, mniejszy model specyficzny dla domeny może przewyższyć większy model ogólny.
Licencjonowanie, pochodzenie i bezpieczeństwo
Pobierany model nie jest automatycznie bezpieczny do wdrożenia. Przejrzyj licencję, dozwolone zastosowania, ujawnienia danych treningowych, ograniczenia model‑card oraz łańcuch zależności. Modele mogą odtwarzać uprzedzenia, zapamiętywać wrażliwe dane lub zawierać złośliwy kod w postaci serializowanej. Używaj zaufanych formatów, skanuj artefakty i wczytuj niewiarygodne wagi w odizolowanym środowisku.
Kiedy używać transfer learningu
Transfer learning jest solidnym domyślnym rozwiązaniem, gdy istnieje odpowiedni wstępnie wytrenowany model i dane docelowe są ograniczone. Trenowanie od podstaw może być lepsze, gdy domena jest wysoce specjalistyczna, licencja jest niekompatybilna, rozmiar modelu przekracza limity wdrożeniowe lub proste zadanie nie korzysta z dużej wstępnie wytrenowanej reprezentacji. Decyzję należy weryfikować empirycznie, a nie zakładać na podstawie skali modelu.
Co się przenosi i jak to dostosować
Transfer learning ponownie wykorzystuje reprezentacje wyuczone na zadaniu lub zestawie danych źródłowym do zadania docelowego. W wizji wczesne cechy często wychwytują krawędzie i tekstury; w języku modele wstępnie wytrenowane kodują wzorce statystyczne pomiędzy tokenami i kontekstami. Transfer działa, gdy reprezentacje źródłowe zawierają informacje istotne dla celu, ale różnice w domenie, etykietach, modalności i metodach akwizycji mogą powodować negatywny transfer. Zacznij od wstępnie wytrenowanej bazy, sprawdź jej licencję treningową i dokumentację oraz porównaj ją z trenowaniem małego modelu specyficznego dla zadania od podstaw.
Ekstrakcja cech zamraża szkielet i trenuje nową głowicę; częściowe dostrajanie odblokowuje wybrane warstwy; pełne dostrajanie aktualizuje cały model. Metody efektywne pod względem parametrów dodają adaptery lub aktualizacje o niskim rzędzie, zmniejszając liczbę uczących się parametrów, ale niekoniecznie pamięć wnioskowania. Używaj niższej szybkości uczenia dla wstępnie wytrenowanych wag, zachowuj zachowanie normalizacji i unikaj katastrofalnego zapominania za pomocą harmonogramów, regularizacji, powtórek lub ograniczonych aktualizacji w razie potrzeby. Wybieraj punkty kontrolne na danych walidacyjnych docelowego zadania i testuj kilka losowań, ponieważ małe zestawy danych docelowych generują dużą zmienność.
Dane, ocena i kompromisy wdrożeniowe
Dane docelowe powinny odzwierciedlać warunki wdrożenia i istotne podgrupy, a nie być jedynie wygodnym oznakowanym próbkowaniem. Podziel je według podmiotu, źródła, czasu lub lokalizacji, aby zapobiec przenikaniu powiązanych przykładów między podziałami. Testuj zarówno warunki w‑dziedzinie, jak i przesunięte. Porównaj zamrożone, częściowo dostrojone i w pełni dostrojone warianty pod kątem jakości, kalibracji, kosztu treningu, opóźnienia i odporności. Poprawa średniego wyniku może ukrywać spadek w rzadkich klasach odziedziczonych po uprzedzeniach źródłowych. Przejrzyj przykłady niepowodzeń pod kątem skrótów specyficznych dla źródła, luk w słownictwie lub różnic w czujnikach.
Śledź bazowy model, wagi, tokenizator lub preprocessing, adapter, dane i licencję jako jedną zależność grafu. Hostowane modele bazowe mogą zmieniać zachowanie; otwarte wagi mogą wprowadzać odpowiedzialności związane z łańcuchem dostaw i aktualizacjami. Zweryfikuj połączony lub wyeksportowany artefakt i skanuj pliki modelu pochodzące z niewiarygodnych źródeł. W produkcji monitoruj dryf docelowy i wydajność oraz zachowaj możliwość przywrócenia zarówno adaptacji, jak i wersji bazowej. Transfer zmniejsza wymaganą ilość danych docelowych; nie eliminuje jednak etykietowania, oceny, prywatności ani wiedzy domenowej.
Przykład praktyczny: adaptacja modelu wizualnego do nowej kliniki
Klinika adaptuje wstępnie wytrenowany enkoder obrazowania, aby klasyfikować jakość obrazu przed przeglądem diagnostycznym. Weryfikuje licencję modelu źródłowego i docelową modalność, zbiera lokalne urządzenia i warunki akwizycji oraz dzieli dane według pacjentów. Porównuje warianty zamrożonych cech, adapterów, częściowego i pełnego dostrajania z małą lokalną bazą. Metryki obejmują przywołanie klasy, kalibrację, zachowanie podgrup, zużycie obliczeń oraz wrażliwość na urządzenie, miejsce i rzadkie artefakty.
Dostosowany model nie może postawić diagnozy i kieruje obrazy o niskim poziomie pewności lub nieobsługiwane do techników. Walidacja eksportu potwierdza lokalny preprocessing i równoważność numeryczną. Model, adapter, urządzenie i wersje zestawów danych są powiązane w rejestrze. Monitorowanie wykrywa nowe skanery, zmiany protokołów i dryf wyników, a okresowe przeglądane próbki szacują rzeczywistą wydajność. Aktualizacja modelu źródłowego jest traktowana jako nowa zależność wymagająca walidacji; transfer learning nie uzasadnia automatycznego ponownego użycia starszych dowodów.
Dowody implementacji i gotowość operacyjna
Decyzja produkcyjna wymaga więcej niż udanej demonstracji. Zdefiniuj docelowych użytkowników, środowisko operacyjne, wejścia, wyjścia, zależności, właściciela oraz konsekwencje każdego istotnego błędu. Ustal odtwarzalną bazę i wersjonowany zestaw oceny przed dostrojeniem. Testuj typowe przypadki, warunki brzegowe, niepoprawne lub brakujące dane wejściowe, przesunięcie rozkładu, awarię zależności, niewłaściwe użycie oraz grupy lub środowiska najprawdopodobniej niedostatecznie obsługiwane. Mierz jakość zadania wraz z kalibracją lub niepewnością, opóźnieniem, przepustowością, kosztami zasobów, dostępnością, prywatnością i bezpieczeństwem. Zarejestruj każdą transformację i próg, aby niezależny recenzent mógł odtworzyć wynik i odróżnić dowody od atrakcyjnego prototypu.
Przed uruchomieniem przydziel odpowiedzialność za wydanie, wyjątki, zmiany, wycofanie i wycofanie. Stosuj etapowe wdrożenie, zachowaj bezpieczną alternatywę i zweryfikuj monitorowanie przy celowo wprowadzonych awariach. Telemetria operacyjna powinna ujawniać jakość danych wejściowych, zachowanie wyjść, wersję modelu lub reguły, stan zależności, interwencje ludzkie oraz potwierdzone wyniki, nie zbierając niepotrzebnych wrażliwych danych. Zdefiniuj progi alarmowe i właściciela reakcji, a następnie przeglądaj dowody z rzeczywistego świata po wdrożeniu, zamiast zakładać, że offline‑owa wydajność będzie trwała. Przeprowadzaj ponowną ocenę przy zmianie źródeł danych, użytkowników, modeli, dostawców, polityk, sprzętu lub celów. Utrzymany system wymaga również udokumentowanego przywracania, nauki z incydentów, procedur usuwania i przechowywania oraz wyraźnego punktu, w którym powinien zostać wyłączony lub zastąpiony.
Podstawowe źródła











