
Podstawy AI
Czym jest Albumentations? Augmentacja obrazów w wizji komputerowej

 Dodaj Unite.AI do preferowanych źródeł w Google
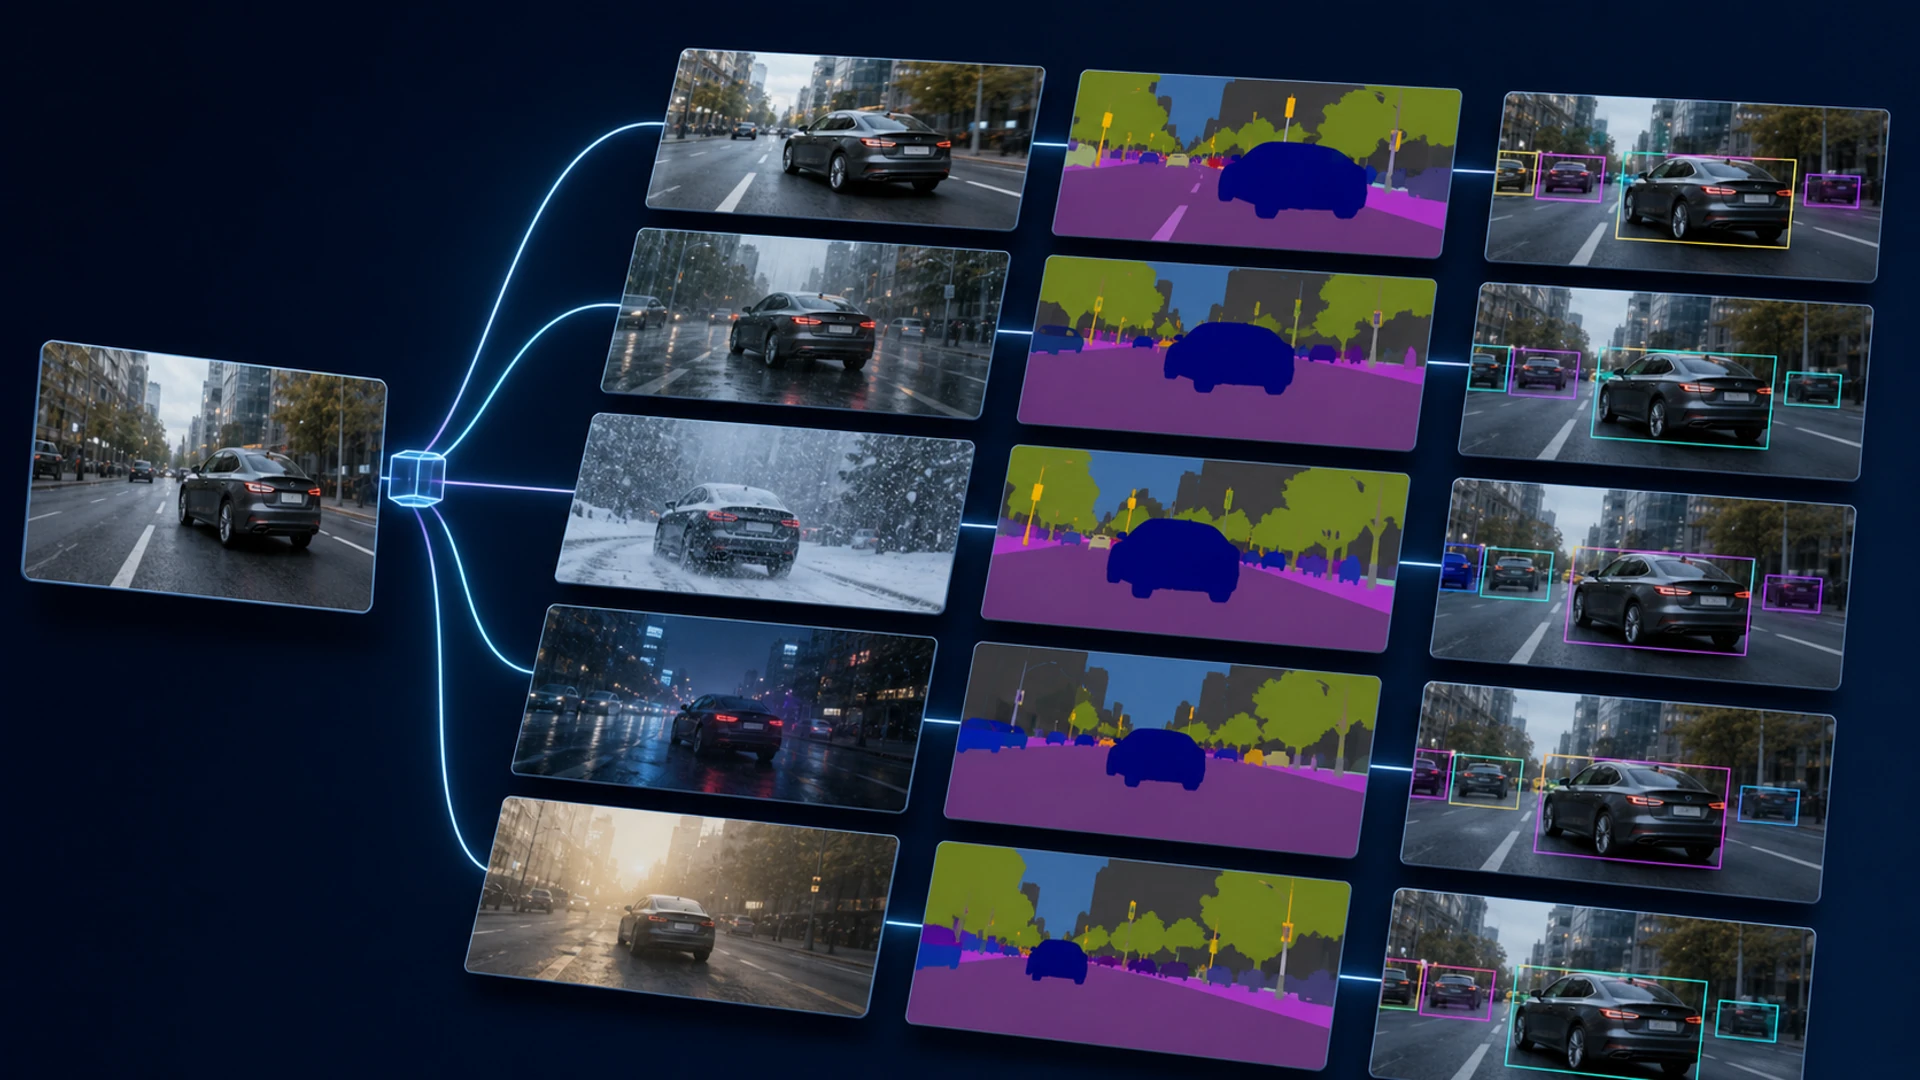
Albumentations jest otwarto‑źródłową biblioteką Pythona do augmentacji obrazów. Stosuje losowe transformacje geometryczne i fotometryczne, jednocześnie utrzymując powiązane cele — takie jak maski segmentacyjne, ramki ograniczające i kluczowe punkty — wyrównane z obrazem.
Augmentacja jest założeniem o niezmienności: informuje model, że wybrane zmiany nie powinny zmieniać etykiety zadania. Szybka biblioteka ułatwia eksperymenty, ale tylko wiedza domenowa i walidacja mogą określić, czy dana transformacja jest dopuszczalna.
Kluczowe wnioski
- Łącz transformacje probabilistyczne w powtarzalny pipeline treningowy.
- Transformuj obrazy i powiązane cele przestrzenne jednocześnie; wyraźnie weryfikuj konwencje dotyczące ramek i kluczowych punktów.
- Stosuj losową augmentację do danych treningowych, a nie do niezmienionych danych walidacyjnych lub testowych.
- Mierz efekty per klasa i podgrupy, ponieważ silniejsza augmentacja może pomóc jednemu przypadkowi, a zaszkodzić innemu.
Jak działa pipeline Albumentations
Pipeline przyjmuje obraz i nazwane cele, losuje transformacje zgodnie z ich prawdopodobieństwami i zwraca słownik zaktualizowanych wyników. Transformacje geometryczne mogą przycinać, obracać, odbijać lub deformować; transformacje fotometryczne mogą zmieniać kolor, kontrast, rozmycie lub szum.
Biblioteka integruje się ze stosami treningowymi, pozostając jednocześnie skoncentrowana na augmentacji. Dla computer vision, takie rozdzielenie umożliwia benchmarkowanie polityk danych niezależnie od frameworku modelu.
Utrzymuj etykiety w poprawnej geometrii
Przycięcie zmieniające obraz musi również przyciąć jego maskę oraz zaktualizować lub usunąć dotknięte ramki i kluczowe punkty. Skonfiguruj format współrzędnych, pola etykiet, minimalną widoczność, przycinanie i reguły filtrowania, a następnie zwizualizuj partie przed treningiem.
Interpolacja różni się w zależności od celu: obraz może używać interpolacji dwuliniowej, podczas gdy maska klasowa zazwyczaj wymaga interpolacji najbliższego sąsiada, aby nie wymyślać wartości kategorii. Nieprawidłowe obchodzenie się z celami może cicho uszkodzić zbiór danych.
Wybieraj transformacje z perspektywy wdrożenia
Poziome odbicie może być dopuszczalne dla zdjęć przyrody, ale nieodpowiednie dla tekstu, znaków drogowych, lateracji medycznej czy asymetrycznego sprzętu. Zmiany koloru mogą zwiększyć odporność na oświetlenie, ale jednocześnie usunąć cechę diagnostyczną, gdy kolor ma znaczenie.
Zacznij od prawdopodobnych wariacji zakłócających, dodawaj jedną rodzinę na raz i analizuj trudne przykłady. Powiąż wybory z hipotezami przeuczenia, zamiast zakładać, że większa syntetyczna różnorodność jest zawsze lepsza.
Powtarzalność i ewaluacja
Zapisz wersję biblioteki, konfigurację pipeline’u, prawdopodobieństwa, strategię losowego ziarna, kolejność przetwarzania wstępnego oraz normalizację. Losowość powinna zmieniać próbki treningowe, podczas gdy eksperymenty pozostają powtarzalne na poziomie uruchomienia.
Utrzymuj obrazy walidacyjne i testowe reprezentatywne i nieprzetworzone, z wyjątkiem deterministycznego przetwarzania wstępnego. Porównuj dokładność, kalibrację, błędy per klasa oraz odporność. Macierze pomyłek mogą ujawnić, kiedy augmentacja przesuwa błąd zamiast go zmniejszać.
Kompozycja, prawdopodobieństwa i cele
Compose stosuje sekwencję transformacji, z których każda ma określone prawdopodobieństwo. Konstrukcje OneOf lub SomeOf losują spośród alternatyw, a zagnieżdżone prawdopodobieństwa określają rzeczywistą dystrybucję. Efektywna polityka augmentacji jest więc programem stochastycznym; zapisz ją i sprawdzaj częstotliwości próbkowania zamiast analizować każde prawdopodobieństwo oddzielnie.
Dodatkowe cele pozwalają kilku obrazom lub maskom współdzielić geometrię, co jest przydatne przy parach stereoskopowych, zdjęciach przed‑po lub wielu adnotacjach. Obsługa ramek ograniczających wymaga zadeklarowanego formatu, takiego jak Pascal VOC, COCO, YOLO lub współrzędne Albumentations. Format kluczowych punktów może zawierać kąt lub skalę, a transformacje muszą zachować te semantyki.
Przycięcia mogą usunąć wszystkie cele. Zdecyduj, czy ponownie próbować, zachować przykład tła, czy odfiltrować go, ponieważ każdy wybór zmienia rozkład klas. Pipeline’y detekcji i segmentacji powinny rejestrować odrzucone ramki, widoczne frakcje i puste próbki, aby ujawnić ciche uszkodzenia etykiet.
Projektowanie polityki w zależności od zadania
Klasyfikacja często toleruje przycięcia, zmiany koloru, rozmycie i zakrycie, gdy klasa pozostaje widoczna. Detekcja wymaga jednoczesnej transformacji obiektów i ramek. Segmentacja wymaga dokładnej geometrii maski. Estymacja pozy wymaga zachowania kluczowych punktów i może wymagać zamiany etykiet lewo‑prawo po odbiciu.
Obrazowanie medyczne może zakazywać odbić, agresywnych zmian koloru lub interpolacji zmieniającej ilościową intensywność. Zdalne teledetekcje muszą brać pod uwagę orientację, porę roku, pasma sensorów i skalę geoprzestrzenną. Analiza dokumentów musi zachować czytelność i układ. Domeny definiują niezmienność; biblioteka jedynie ją realizuje.
Metody mieszania, takie jak MixUp, CutMix, Mosaic czy copy‑paste, tworzą złożone etykiety i mogą występować w loaderze danych lub frameworku, a nie w Albumentations. Ich interakcja z podstawowymi transformacjami, normalizacją i batchowaniem powinna być przetestowana. Silne polityki mogą spowolnić zbieżność lub zmienić kalibrację, nawet gdy ostateczna dokładność się poprawia.
Wydajność, debugowanie i projektowanie eksperymentów
Augmentacja działa na CPU, chyba że użyto innej ścieżki. Mierz przepustowość loadera danych, liczbę wątków, koszt dekodowania, kopiowanie pamięci oraz czas bezczynności GPU. Szybsze transformacje są wartościowe tylko wtedy, gdy nie zmieniają semantyki. Buforuj niezmienne etapy dekodowania lub przetwarzania wstępnego, gdy pozwalają na to zasoby i powtarzalność.
Zwizualizuj siatki oryginalnych i przekształconych próbek z nałożonymi wszystkimi celami. Dodaj automatyczne testy dla cykli koordynatów, wartości maski, kształtu, typu danych i deterministycznego odtwarzania. Ustaw ziarna w odpowiednim zasięgu; identyczna augmentacja we wszystkich wątkach może niezamierzenie zmniejszyć różnorodność.
Przeprowadzaj ablacje względem stałej bazy: brak augmentacji, prawdopodobne podstawowe transformacje, a następnie silniejsze polityki. Powtarzaj ziarna i raportuj wariancję. Oceniaj czyste dane, istotne zakłócenia i podgrupy oddzielnie. Zachowaj politykę tylko wtedy, gdy jej korzyść przetrwa testy na odłożonych danych, a przekształcone obrazy pozostaną wiarygodne dla ekspertów domenowych.
Projektowanie i walidacja pipeline Albumentations
Zacznij od wariacji oczekiwanych po wdrożeniu: kąt kamery, przycięcie, skalowanie, oświetlenie, kompresja, rozmycie, warunki pogodowe, zakrycie i szum sensora. Wybierz transformacje, które zachowują etykietę i odpowiadają tym mechanizmom. Poziome odbicie może być dopuszczalne dla zwierząt, ale nieodpowiednie dla tekstu, orientacji ruchu drogowego czy asymetrycznej anatomii. Silne zmiany koloru mogą zniszczyć diagnostycznie istotne informacje, nawet jeśli obraz nadal wydaje się wiarygodny.
Albumentations komponuje transformacje i stosuje zmiany przestrzenne konsekwentnie do obrazów, masek, ramek ograniczających i kluczowych punktów, gdy jest poprawnie skonfigurowany. Zadeklaruj formaty współrzędnych, minimalną widoczność, interpolację i obsługę masek wyraźnie. Zwizualizuj setki przekształconych próbek z nałożonymi adnotacjami, testuj przypadki puste i brzegowe oraz zapisz losowe parametry do debugowania. Podziel dane według podmiotu lub sceny przed augmentacją, aby powiązane obrazy nie przeciekały między treningiem a testem.
Porównaj brak augmentacji, prostą augmentację i proponowaną politykę na niezmienionym zestawie testowym oraz realistycznych zestawach stresowych. Śledź dokładność per klasa, lokalizację, kalibrację i przykłady niepowodzeń, nie tylko stratę treningową. Nadmierna augmentacja może spowodować niedopasowanie do rzeczywistego rozkładu, podczas gdy słaba augmentacja może zachęcać do uczenia się skrótów. Wersjonuj pipeline wraz z modelem, ziarna uruchomień ewaluacji i unikaj stosowania losowych transformacji treningowych podczas walidacji lub inferencji, chyba że augmentacja w czasie testu jest celowo oceniana.
Dla detekcji i segmentacji zweryfikuj przycinanie współrzędnych, minimalny obszar ramki, widoczność kluczowych punktów oraz interpolację używaną dla masek kategorycznych. Interpolacja najbliższego sąsiada jest zazwyczaj wymagana dla identyfikatorów klas, podczas gdy interpolacja dwuliniowa może tworzyć nieprawidłowe etykiety. Profiluj również loader danych: agresywne transformacje mogą uczynić augmentację na CPU wąskim gardłem treningu. Buforuj tylko transformacje, które są deterministyczne i zachowują zamierzoną losowość w trakcie epok i wątków.
Praktyczna lista kontrolna wdrożenia
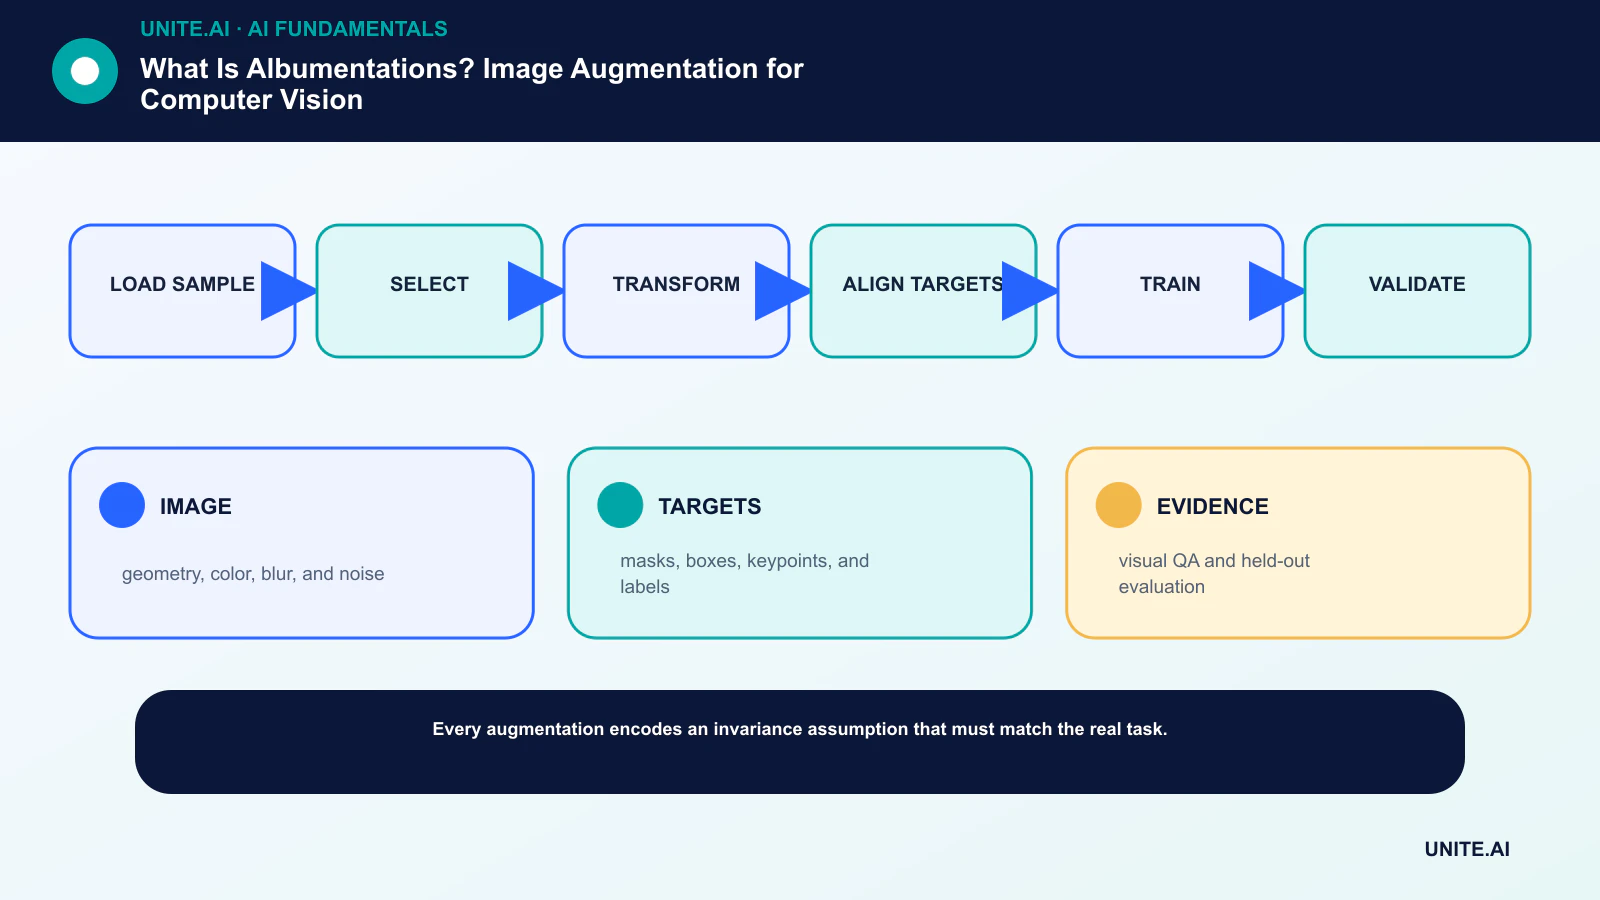
Przekształć koncepcję w ograniczony, testowalny przepływ pracy: wczytaj próbkę → wybierz → przekształć → dopasuj cele → trenuj → waliduj. Wyznacz odpowiedzialnego właściciela, udokumentuj dane i zależności, ustal prostą bazę, określ kryteria akceptacji i zakończenia, przetestuj reprezentatywne awarie oraz zdefiniuj monitorowanie, przywrócenie i przegląd przed rozszerzeniem zakresu. Zapisz wersje i założenia, aby inny zespół mógł odtworzyć wynik i zrozumieć, co się zmieniło.
Przed uruchomieniem przeprowadź udokumentowaną ocenę gotowości z osobami, które budują, utrzymują, zabezpieczają i są dotknięte systemem. Testuj przypadki normalne, warunki brzegowe, awarie zależności i niewłaściwe użycie; zachowaj dowody i nierozwiązane ryzyka. Określ, kto może zatwierdzić wydanie, zmienić próg, nadpisać wynik lub zatrzymać działanie. Ponownie rozważ decyzję po pojawieniu się danych rzeczywistych, ponieważ technicznie udany pilotaż nie gwarantuje niezawodnej wydajności na szerszą skalę.
- IMAGE: geometria, kolor, rozmycie i szum.
- TARGETS: maski, ramki, kluczowe punkty i etykiety.
- EVIDENCE: wizualna kontrola jakości i ewaluacja na odłożonych danych.
Najczęściej zadawane pytania
Czy augmentacja obrazu tworzy nową prawdziwą wartość?
Nie. Tworzy przekształcone przykłady treningowe przy założeniu, że etykiety pozostają prawidłowe. Nierzeczywista lub niepoprawnie oznaczona transformacja wprowadza szum.
Czy obrazy walidacyjne powinny być augmentowane?
Użyj deterministycznego skalowania i normalizacji wymaganych przez model, ale zachowaj stałą dystrybucję ewaluacyjną. Augmentacja w czasie testu jest odrębną metodą inferencji i powinna być wyraźnie zgłoszona.
Podstawowe źródła












