
Podstawy AI
Czym jest mechanistyczna interpretowalność? Jak badacze analizują modele SI

 Dodaj Unite.AI do preferowanych źródeł w Google
Mechanistyczna interpretowalność bada, w jaki sposób wyuczone komponenty w sieci neuronowej przyczynowo generują zachowanie. Zamiast jedynie korelować wejścia z wyjściami, badacze formułują hipotezy dotyczące cech, głowic uwagi, neuronów i obwodów, a następnie interweniują, aby przetestować te hipotezy.
Dziedzina ta dostarczyła szczegółowych wyjaśnień wybranych zachowań w małych i średnich modelach, ale pełne, wierne opisanie modelu na granicy możliwości wciąż pozostaje poza zasięgiem. Zautomatyzowane wyjaśnienia i atrakcyjne wizualizacje mogą być przydatnym punktem wyjścia, ale nie stanowią dowodu.
Kluczowe wnioski
- Cechy to reprezentowane wzorce; obwody to współdziałające komponenty proponowane do realizacji obliczenia.
- Łatanie aktywacji, ablacja i śledzenie przyczynowe testują, czy dany komponent zmienia zachowanie.
- Superpozycja oznacza, że jeden neuron może uczestniczyć w wielu cechach; rzadkie autoenkodery starają się stworzyć inną bazę cech.
- Metody interpretowalności potrzebują prawdziwego odniesienia, testów falsyfikowalnych, pokrycia oraz oceny w porównaniu z alternatywnymi wyjaśnieniami.
Od reprezentacji do mechanizmu
Badanie (probing) pyta, czy informację można odkodować z aktywacji. Atrybucja szacuje, które wejścia lub komponenty mają znaczenie. Praca mechanistyczna idzie dalej, proponując wewnętrzne obliczenia i sprawdzając, czy interwencje zmieniają oczekiwane zachowanie pośrednie i końcowe.
Sprawia to, że jest to powiązane, ale węższe niż explainable AI. Wyjaśnienie post‑hoc jednej decyzji nie musi być odwróconym algorytmem wewnątrz modelu.
Obwody i przyczynowe interwencje
Badacze mogą zidentyfikować głowicę uwagi lub cechę powiązaną z zadaniem, usunąć ją (ablatować), podmienić aktywacje z innego przebiegu lub prześledzić, jak informacja przemieszcza się przez warstwy. Dobra hipoteza przewiduje zachowanie na nowych przykładach i wytrzymuje kontrolę.
Interwencje mogą tworzyć stany poza rozkładem, więc zmiana zachowania nie ujawnia automatycznie naturalnego obliczenia. Należy stosować wiele metod, dopasowane kontrole oraz ilościowe efekty, a nie jedynie jedną ilustracyjną podpowiedź.
Superpozycja i rzadkie cechy
Sieci neuronowe mogą reprezentować więcej cech niż pojedyncze wymiary, nakładając je na siebie. Neuron może więc aktywować się dla kilku niepowiązanych wzorców, co sprawia, że etykiety na poziomie neuronów mogą być mylące.
Rzadkie autoenkodery uczą większego słownika cech z aktywacji modelu. Mogą one uczynić wzorce bardziej rozdzielne, ale wybrana rzadkość, dane treningowe, błąd rekonstrukcji i automatyczne etykiety wpływają na to, co zostaje odzyskane. Neural-network cechy nadal wymagają przyczynowej weryfikacji.
Bezpieczeństwo, debugowanie i ograniczenia
Narzędzia mechanistyczne mogą pomóc wykrywać zapamiętane fakty, uprzedzenia, mylące strategie lub obwody awaryjne oraz wspierać ich edycję lub monitorowanie. Te same narzędzia mogą przeoczyć rozproszone, rzadkie lub zależne od kontekstu obliczenia.
Traktuj wyniki jako ograniczone dowody: wersja modelu, zadanie, zbiór danych, warstwa, interwencja, efekt i niepewność. Połącz interpretację z ocenami behawioralnymi, testami red‑team oraz responsible‑AI w ramach zarządzania, zamiast używać jej jako uniwersalnego certyfikatu bezpieczeństwa.
Reprezentacje, obwody i przyczynowe dowody
Mechanistyczna interpretowalność bada, w jaki sposób wewnętrzne obliczenia generują zachowanie modelu. Badacze analizują aktywacje, wagi, uwagę i cechy pośrednie, a następnie formułują hipotezy o reprezentacjach i obwodach. Reprezentacja nie musi być przechowywana w jednym neuronie; może być rozproszona w różnych kierunkach, warstwach, tokenach i kombinacjach zależnych od kontekstu.
Rzadkie autoenkodery próbują rozłożyć gęste aktywacje na większy zestaw cech, które aktywują się selektywnie. Etykiety cech są ludzką interpretacją zaobserwowanych przykładów, a nie prawdziwą rzeczywistością. Błąd rekonstrukcji, rzadkość, podział cech, absorpcja i martwe cechy wpływają na to, co dekompozycja ujawnia i co pomija.
Korelacja jest niewystarczająca dla twierdzenia mechanistycznego. Łatanie aktywacji, ablacja, śledzenie przyczynowe, sterowanie i ukierunkowane interwencje wag testują, czy komponent zmienia zachowanie zgodnie z przewidywaniami. Interwencje mogą również tworzyć stany poza rozkładem, dlatego wyniki wymagają kontroli, analizy dawka‑odpowiedź, alternatywnych wyjaśnień i replikacji na różnych podpowiedziach i modelach.
Rygorystyczny przepływ pracy interpretowalności
Zacznij od precyzyjnie zmierzonego zachowania i zbioru danych, który rozdziela konkurujące hipotezy. Zlokalizuj istotne warstwy, pozycje, komponenty lub cechy; przeanalizuj kandydatów na mechanizmy; interweniuj; i sprawdź, czy proponowany obwód przewiduje nowe przypadki. Trzymaj przykłady eksploracyjne oddzielnie od oceny potwierdzającej, aby ograniczyć błąd selekcji.
Zautomatyzowane narzędzia mogą rankować neurony, cechy, głowice lub ścieżki, a modele językowe mogą proponować opisy. Automatyzacja zwiększa pokrycie, ale może wytwarzać wiarygodne historie. Oceń wyjaśnienia na podstawie odłożonych przykładów aktywacji i przyczynowych prognoz, zapisz niepewność i udostępnij artefakty z informacjami o wersji modelu, tokenizatorze, podpowiedziach i kodzie.
Mechanizmy mogą być wieloznaczne, redundantne, nieliniowe i rozproszone. Usunięcie jednego komponentu może być zrekompensowane przez inne, a cecha może uczestniczyć w kilku zachowaniach. Negatywne wyniki są informacyjne: widoczny obwód, który nie działa poza wyselekcjonowanymi przykładami, powinien być zawężony lub odrzucony, a nie ratowany coraz bardziej niejasnym wyjaśnieniem.
Zastosowania, ograniczenia i twierdzenia o bezpieczeństwie
Interpretowalność może pomóc w debugowaniu halucynacji, uprzedzeń, zapamiętywania, zachowań typu jailbreak lub nieoczekiwanej generalizacji; porównywaniu modeli; oraz generowaniu hipotez naukowych. Może także identyfikować cechy do monitorowania lub interwencji. Te zastosowania wymagają walidacji specyficznej dla zadania, ponieważ użyteczna wizualizacja badawcza nie jest automatycznie wiarygodną kontrolą produkcyjną.
Brak wykrytej cechy nie dowodzi braku zdolności lub intencji, a czytelna cecha nie dowodzi, że model używa jej w konkretnej odpowiedzi. Narzędzia obserwują jedynie projekcję obliczeń o ograniczonym zasięgu. Twierdzenia o bezpieczeństwie muszą określać czułość wykrywania, fałszywe alarmy, rozkład, przeciwnika oraz znane ślepe punkty.
Stosuj interpretowalność razem z ocenami behawioralnymi, testami red‑team, zarządzaniem danymi, kontrolą dostępu, monitorowaniem i reagowaniem na incydenty. Publikuj metody i kontrprzykłady, kiedy to możliwe. Dziedzina rozwija się szybko, ale obecne techniki nie zapewniają pełnego, wiernego wyjaśnienia rozumowania modeli na granicy możliwości ani ogólnej gwarancji zgodności.
Przykład praktyczny: testowanie proponowanego obwodu modelu
Załóżmy, że model wydaje się wykorzystywać zestaw głowic uwagi i cech do rozwiązania pośredniego dopełnienia w zdaniu. Badacze definiują kontrolowany zbiór danych z różnymi imionami, pozycjami, dystraktorami i kontrprzykładami, a następnie mierzą zachowanie. Analiza aktywacji identyfikuje kandydatów na komponenty, ale hipoteza jest sformułowana przed interwencją: jaka informacja jest przenoszona przez każdy komponent, gdzie się przemieszcza i jak jego zmiana powinna wpłynąć na wynik.
Łatanie aktywacji i ablacja testują konieczność i wystarczalność na odłożonych przykładach. Ukierunkowana edycja, która zmienia przewidywany token w oczekiwanym kierunku, wspiera mechanizm; szerokie pogorszenie wydajności nie potwierdza tego. Kontrole podmieniają niepowiązane pozycje i komponenty, zmieniają natężenie interwencji i porównują alternatywne obwody. Zespół publikuje przypadki negatywne, w których wyjaśnienie zawodzi, i unika przypisywania ludzkiej, czytelnej funkcji wyłącznie na podstawie korelacji.
Aby twierdzić o zastosowaniu w bezpieczeństwie, metoda musi wykrywać istotne zachowanie ze znaną czułością przy realistycznych podpowiedziach i adaptacji adwersarialnej. Monitory cech są oceniane pod kątem fałszywych alarmów, omijania, aktualizacji modelu i przyczynowej istotności. Dowody interpretowalności mogą kierować debugowaniem i dalszymi testami, ale egzekwowanie pozostaje w zewnętrznych kontrolach i monitoringu zachowań. Przekonujący diagram obwodu jest hipotezą naukową popartą dowodami — nie pełnym wyjaśnieniem modelu ani gwarancją co do nieobserwowanych zachowań.
Praktyczna lista kontrolna wdrożenia
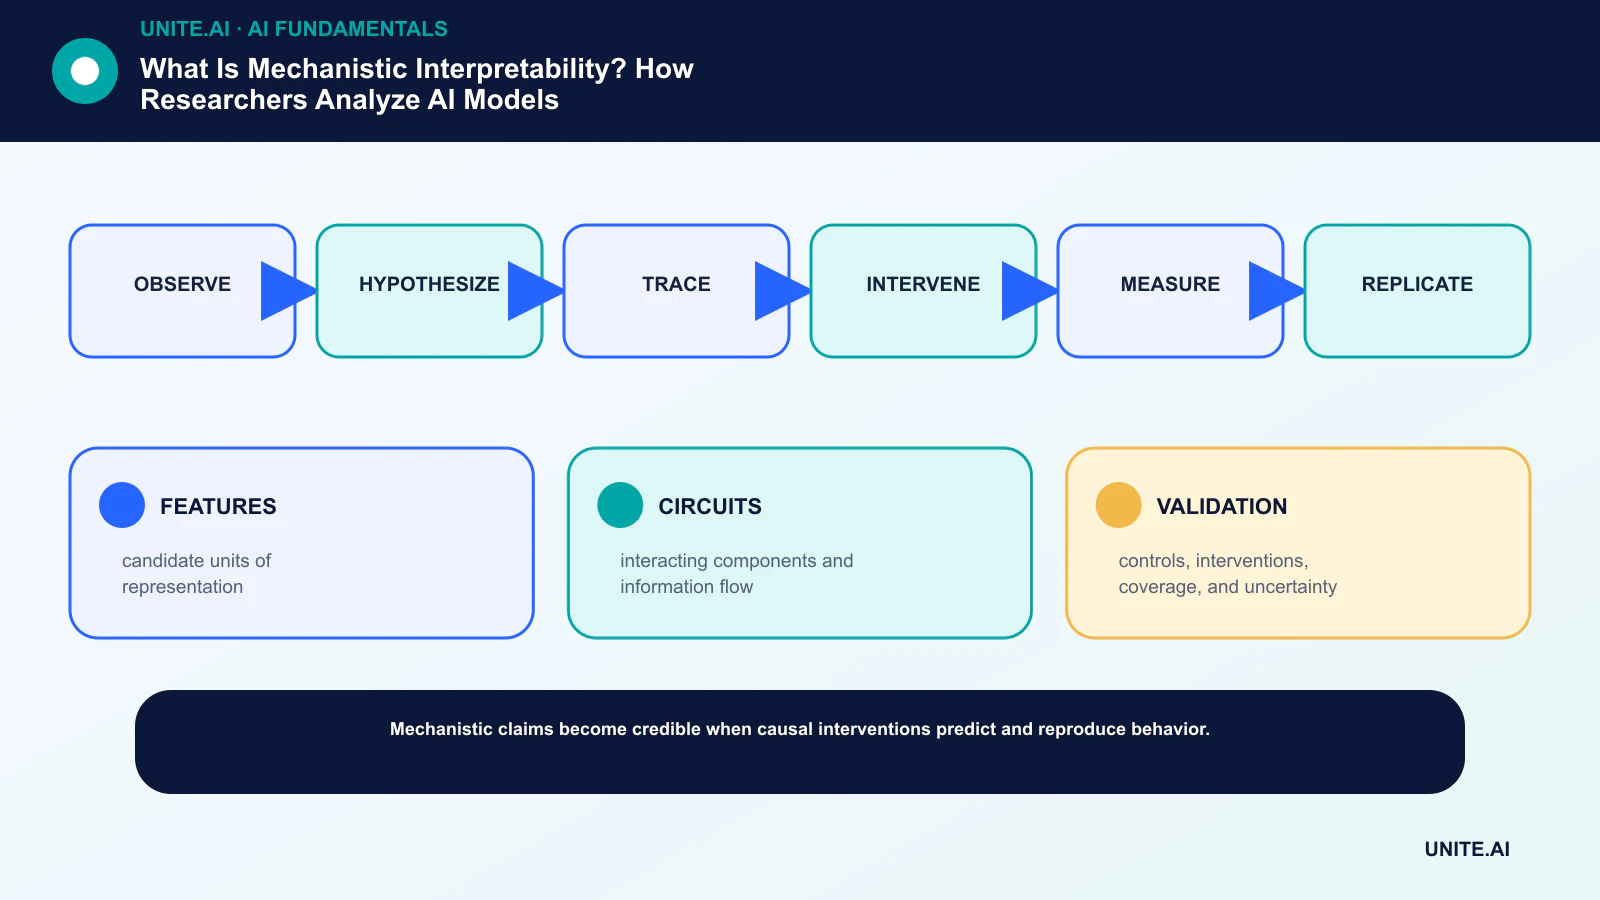
Przekształć koncepcję w ograniczony, testowalny przepływ pracy: obserwuj → formułuj hipotezę → śledź → interweniuj → mierz → powtarzaj. Wyznacz odpowiedzialnego właściciela, udokumentuj dane i zależności, ustal prostą bazę odniesienia, określ kryteria akceptacji i zakończenia, przetestuj reprezentatywne awarie oraz zdefiniuj monitorowanie, wycofanie i przegląd przed rozszerzeniem zakresu. Rejestruj wersje i założenia, aby inny zespół mógł odtworzyć wynik i zrozumieć, co się zmieniło.
Przed uruchomieniem przeprowadź udokumentowaną ocenę gotowości z osobami, które budują, obsługują, zabezpieczają i są dotknięte systemem. Testuj przypadki normalne, warunki brzegowe, awarie zależności i niewłaściwe użycie; zachowaj dowody i nierozwiązane ryzyka. Określ, kto może zatwierdzić wydanie, zmienić próg, nadpisać wynik lub zatrzymać działanie. Ponownie rozważ decyzję po pojawieniu się danych rzeczywistych, ponieważ technicznie udany pilotaż nie gwarantuje niezawodnej wydajności w szerszej skali.
- FEATURES: kandydat jednostek reprezentacji.
- CIRCUITS: współdziałające komponenty i przepływ informacji.
- VALIDATION: kontrole, interwencje, pokrycie i niepewność.
Najczęściej zadawane pytania
Czy mechanistyczna interpretowalność jest tym samym co czytanie wag modelu?
Nie. Same wagi nie wyjaśniają się same. Badacze analizują aktywacje, cechy, komponenty i interwencje, aby budować i testować przyczynowe hipotezy.
Czy rzadkie autoenkodery mogą w pełni wyjaśnić duży model językowy (LLM)?
Nie. Oferują one kandydatową bazę cech i mogą wspierać analizę obwodów, ale pokrycie, wierność, rekonstrukcja, etykietowanie i skalowalność pozostają otwartymi problemami.
Podstawowe odniesienia












