
Podstawy AI
Co to jest drzewo decyzyjne?

 Dodaj Unite.AI do preferowanych źródeł w Google
Drzewo decyzyjne jest modelem uczenia nadzorowanego, który dokonuje prognozy, stosując sekwencję reguł typu jeśli‑wtedy. Każdy wewnętrzny węzeł testuje cechę, każda gałąź reprezentuje wynik tego testu, a każdy liść generuje prognozę klasy, prawdopodobieństwo lub wartość numeryczną.
Drzewa decyzyjne są używane do klasyfikacji i regresji. Ich zaletą jest praktyczność: potrafią reprezentować nieliniowe interakcje, wymagają stosunkowo niewiele wstępnego przetwarzania i generują ścieżkę, którą człowiek może przeanalizować. Ich słabością jest niestabilność — małe zmiany w danych treningowych mogą spowodować powstanie innego drzewa.
Kluczowe wnioski
- Drzewo rekurencyjnie dzieli przestrzeń cech; nie musi izolować każdej obserwacji treningowej.
- Podziały w klasyfikacji najczęściej wykorzystują impurity Gini lub entropię, natomiast podziały w regresji redukują błąd prognozy lub wariancję.
- Głębokość, minimalny rozmiar liścia i przycinanie kontrolują złożoność oraz nadmierne dopasowanie.
- Random forest i drzewa gradientowo wzmacniane zwiększają moc predykcyjną poprzez łączenie wielu drzew.
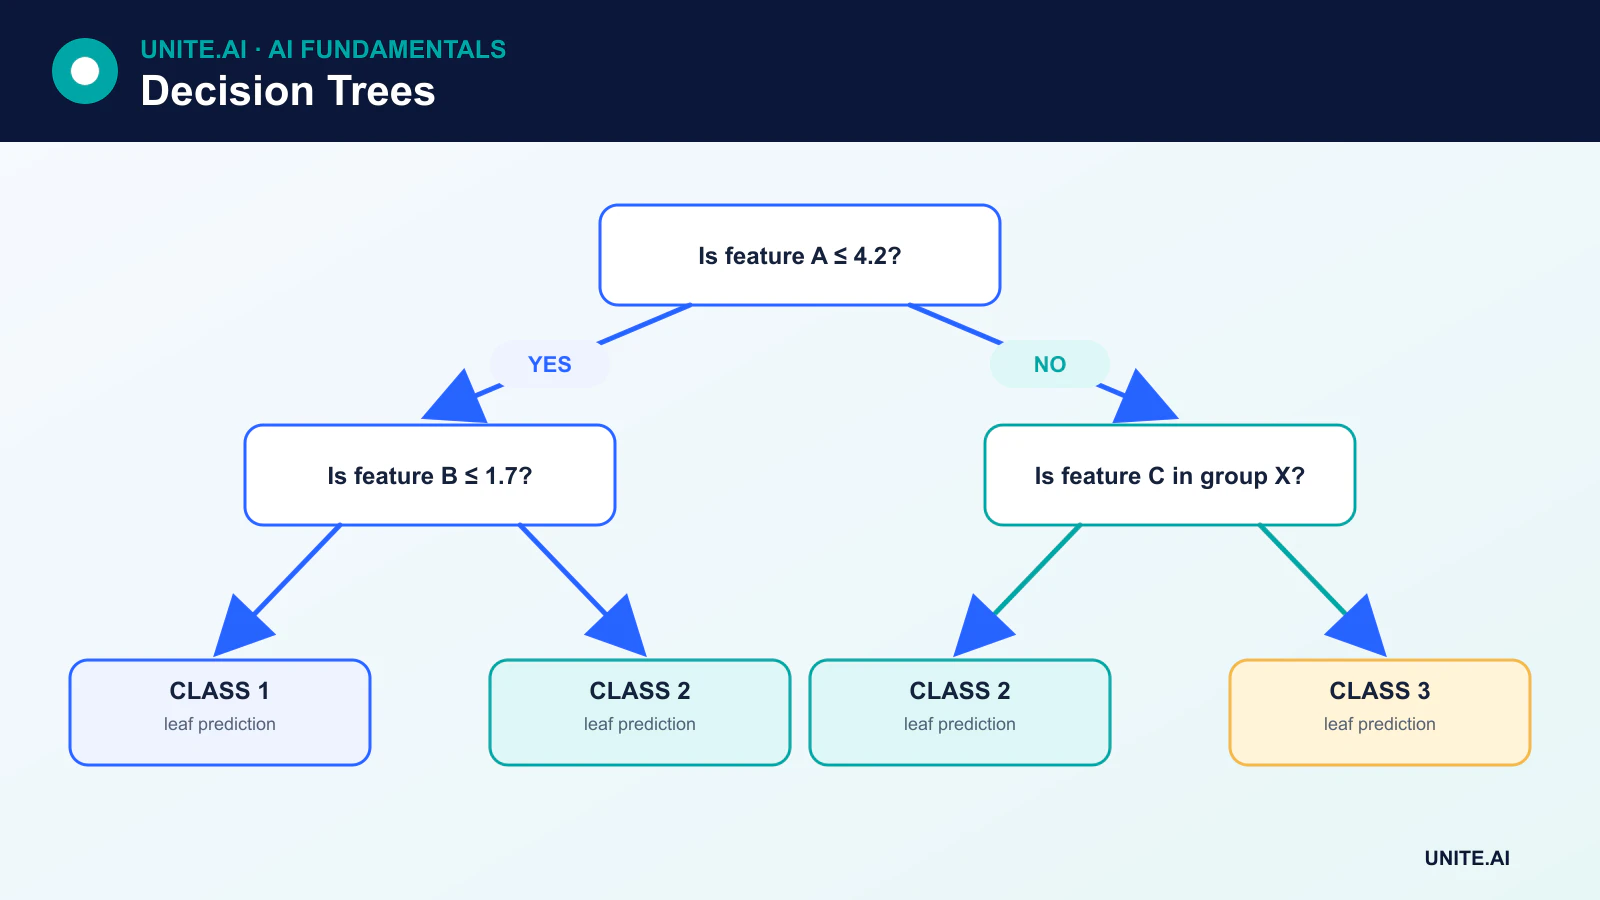
Jak drzewo decyzyjne dokonuje prognozy
Załóżmy, że model przewiduje, czy maszyna prawdopodobnie ulegnie awarii. Węzeł korzenia może pytać, czy drgania przekraczają wyuczony próg. Następnie gałąź może testować temperaturę pracy. Obserwacja trafia do liścia zawierającego szacowane prawdopodobieństwo awarii wśród przykładów treningowych, które podążały tą samą ścieżką.
W regresji liść może zwrócić średnią wartość docelową obserwacji w danym regionie. W klasyfikacji może zwrócić klasę większościową lub rozkład częstości klas. Liść może zawierać wiele obserwacji; pełne rozdzielenie danych treningowych jest zazwyczaj niepożądane, ponieważ może prowadzić do przeuczenia drzewa.
Jak drzewo wybiera podział
Podczas treningu rozważa się cechy i progi kandydatów, a następnie wybiera podział, który najbardziej poprawia określony cel. Poprawa musi być ważona liczbą obserwacji trafiających do każdego węzła potomnego.
Miara Gini
W klasyfikacji impurity Gini mierzy, jak mieszane są klasy w węźle:
Gini = 1 - Σ p(k)²
Węzeł zawierający tylko jedną klasę ma impurity równą zero. Podział kandydat jest użyteczny, gdy ważona impurity jego potomków jest niższa niż impurity rodzica.
Entropia i przyrost informacji
Entropia jest inną miarą niepewności klasy:
Entropy = -Σ p(k) log₂ p(k)
Przyrost informacji to entropia rodzica minus ważona entropia potomków. Gini i entropia często prowadzą do podobnych drzew, choć nie zawsze identycznych.
Strata regresji
Drzewa regresyjne zazwyczaj wybierają podziały, które redukują błąd kwadratowy, błąd bezwzględny lub inną miarę regresji. Każdy liść następnie prognozuje wartość na podstawie docelowych wartości treningowych w tym regionie.
CART i inne algorytmy drzew
CART, czyli Classification and Regression Trees, używa podziałów binarnych i jest podstawą popularnych implementacji, takich jak drzewa decyzyjne scikit-learn. Inne algorytmy to ID3, C4.5 i C5.0. Implementacje różnią się obsługiwanymi typami podziałów, sposobem radzenia sobie z brakującymi wartościami, przycinaniem i celami.
Zmienne kategoryczne mogą wymagać kodowania, bezpośrednich podziałów podzbiorów lub obsługi specyficznej dla danej implementacji. Brakujące wartości można imputować lub obsługiwać poprzez wyuczone domyślne kierunki lub podziały zastępcze. Ważne jest zrozumienie zachowania konkretnej biblioteki, a nie zakładanie, że każda implementacja drzewa działa tak samo.
Kontrolowanie złożoności drzewa
Głębokie drzewo może zapamiętywać szum. Typowe środki kontroli obejmują:
- Maksymalna głębokość: ogranicza długość ścieżki prognozy.
- Minimalna liczba próbek na podział lub liść: zapobiega tworzeniu bardzo małych regionów.
- Minimalny spadek impurity: wymaga, aby podział przyniósł wystarczającą korzyść.
- Maksymalna liczba liści: ogranicza całkowitą złożoność.
- Przycinanie kosztowo‑złożonościowe: usuwa gałęzie, których poprawa nie uzasadnia dodatkowej złożoności.
Przycinanie jest strukturalnym procesem optymalizacji, a nie losowym usuwaniem. Hiperparametry powinny być dobierane przy użyciu danych walidacyjnych lub cross‑validation, przy czym ostateczny zestaw testowy pozostaje nienaruszony.
Mocne i słabe strony
Drzewa decyzyjne mogą modelować interakcje i efekty progowe bez skalowania cech. Akceptują dane numeryczne oraz, w zależności od implementacji, kategoryczne. Prognozowanie jest szybkie, a małe drzewo łatwe do wizualizacji.
Jednak pojedyncze drzewo może mieć wysoką wariancję, powodować nagłe zmiany prognozy w pobliżu podziału i faworyzować cechy z wieloma możliwymi punktami podziału. Drzewa słabo ekstrapolują w regresji: poza obserwowanymi regionami liść nadal zwraca wartość wyuczoną na próbkach treningowych. Duże drzewo może nie być bardziej zrozumiałe niż inny złożony model.
Od jednego drzewa do zespołów
Uczenie zespołowe łączy wiele modeli. Random forest trenuje wiele drzew na przetworzonych ponownie obserwacjach i podzbiorach cech, a następnie uśrednia ich prognozy. Gradient boosting buduje drzewa kolejno, tak aby każde nowe drzewo korygowało pozostały błąd. Podejścia te zazwyczaj przewyższają pojedyncze drzewo, ale kosztem częściowej utraty interpretowalności i zwiększonego kosztu obliczeniowego.
Znaczenie cech pochodzące z drzewa lub zespołu powinno być interpretowane ostrożnie. Znaczenie oparte na impurity może być tendencywne, a istotność cechy nie dowodzi przyczynowości. Znaczenie permutacyjne, narzędzia częściowej zależności oraz przegląd domenowy dostarczają dodatkowego kontekstu.
Jak drzewo uczy się podziałów i prognoz
Drzewo decyzyjne rekurencyjnie dzieli przestrzeń cech. W każdym węźle algorytm treningowy ocenia progi cech lub podziały kategorii i wybiera podział, który najbardziej redukuje impurity, np. impurity Gini lub entropię w klasyfikacji oraz błąd kwadratowy w regresji. Liście przechowują rozkład klas lub prognozę numeryczną na podstawie obserwacji treningowych, które do nich docierają. Chciwe podziały są praktyczne obliczeniowo, ale nie gwarantują globalnie najlepszego drzewa, a różne próbki lub rozstrzygnięcia remisów mogą prowadzić do różnych struktur.
Ciągłe, porządkowe, kategoryczne i brakujące cechy wymagają explicitego traktowania. Kodowanie one‑hot może tworzyć wiele kandydatów podziałów; natywne metody kategoryczne mogą wykorzystywać statystyki porządkowe, ale wymagają implementacji zabezpieczonej przed wyciekami. Drzewa nie wymagają skalowania, jednak mogą faworyzować zmienne o wysokiej liczbie unikalnych wartości i izolować małe grupy. Głębokość, minimalny rozmiar liścia, minimalny spadek impurity oraz przycinanie kosztowo‑złożonościowe kontrolują wariancję. Należy je dobrać przy użyciu danych walidacyjnych i ocenić kalibrację, ponieważ prawdopodobieństwo liścia oparte na niewielkiej liczbie przypadków może być skrajne i niestabilne.
Interpretacja, tryby awarii i zastosowanie w produkcji
Ścieżka od korzenia do liścia jest dokładną regułą dla jednej prognozy modelu, ale nie jest automatycznie wyjaśnieniem przyczynowym. Skorelowane zmienne mogą się wzajemnie zastępować, małe zmiany w danych mogą zmienić podziały wyższego poziomu, a pozornie prosta ścieżka może zależeć od tendencywnych etykiet. Globalne znaczenie cech oparte na impurity może być mylące; znaczenie permutacyjne, częściowa zależność i kontrole kontrfaktyczne dodają kontekst, ale mają własne założenia. Należy raportować niepewność i testować, czy domniemana reguła utrzymuje się na danych niezależnych i istotnych podgrupach.
Pojedyncze drzewa są przydatne, gdy ważna jest przejrzystość, niskie opóźnienie i umiarkowana nieliniowość, ale zespoły zazwyczaj zapewniają lepszą wydajność predykcyjną. Należy weryfikować zachowanie na granicach, rzadkie kategorie, brakujące wartości oraz dane spoza zakresu treningowego. Eksportowane reguły muszą dokładnie odtwarzać przetwarzanie wstępne i porównania liczbowe użyte podczas treningu. Monitoruj zajętość liści, rozkład wyników, błędy i pojawiające się kategorie. Drzewo, które kieruje wiele nowych przypadków do małego lub wcześniej pustego regionu, powinno wywołać przegląd, nawet jeśli ogólne dryfowanie jest niewielkie. Zachowaj mechanizm awaryjny dla nieprawidłowych schematów i udokumentuj każdy przycięcie lub decyzję progową.
Przykład praktyczny: interpretowalne drzewo triage pożyczkowego
Pożyczkodawca używa drzewa wyłącznie do priorytetyzacji niekompletnych wniosków do ręcznej weryfikacji, a nie do zatwierdzania lub odrzucania kredytu. Celem jest udokumentowany wynik kompletności, a cechy dostępne przy przyjęciu wykluczają późniejsze decyzje. Grupowa walidacja czasowa porównuje płytkie przycięte drzewo z regułami i regresją logistyczną. Minimalny rozmiar liścia zapobiega regułom opartym na kilku wnioskodawcach, a kalibracja oraz błędy specyficzne dla klas są raportowane w różnych kanałach i istotnych grupach chronionych.
Recenzenci widzą dokładną ścieżkę i wartości źródłowe, ale mogą poprawiać błędne dane i nadpisywać trasowanie. Organizacja testuje skorelowane proxy i zmiany kontrfaktyczne, monitoruje zajętość liści i brakujące wartości oraz traktuje nagły napływ do małego liścia jako incydent jakości danych. Zmiany polityki tworzą nową wersję modelu i walidację, a nie nieudokumentowaną edycję podziału. Ponieważ zastosowanie wpływa na dostęp i obciążenie, wnioskodawcy otrzymują kanał ludzki, a drzewo nigdy nie jest przedstawiane jako przyczynowe wyjaśnienie zdolności kredytowej.
Dowody wdrożenia i gotowość operacyjna
Decyzja produkcyjna wymaga więcej niż udanej demonstracji. Zdefiniuj docelowych użytkowników, środowisko operacyjne, wejścia, wyjścia, zależności, właściciela oraz konsekwencje każdego istotnego błędu. Ustal odtwarzalną bazę i wersjonowany zestaw oceny przed strojeniem. Testuj typowe przypadki, warunki brzegowe, niepoprawne lub brakujące dane wejściowe, przesunięcie rozkładu, awarie zależności, niewłaściwe użycie oraz grupy lub środowiska najprawdopodobniej niedoszacowane. Mierz jakość zadania wraz z kalibracją lub niepewnością, opóźnieniem, przepustowością, kosztami zasobów, dostępnością, prywatnością i bezpieczeństwem. Rejestruj każdą transformację i próg, aby niezależny recenzent mógł odtworzyć wynik i odróżnić dowody od atrakcyjnego prototypu.
Przed uruchomieniem przydziel odpowiedzialność za wydanie, wyjątki, zmiany, wycofanie i wycofanie wersji. Stosuj etapowe wdrożenie, zachowaj bezpieczną alternatywę i zweryfikuj monitorowanie przy celowo wprowadzonych awariach. Telemetria operacyjna powinna ujawniać jakość danych wejściowych, zachowanie wyjść, wersję modelu lub reguły, stan zależności, interwencje ludzkie oraz potwierdzone wyniki, nie gromadząc niepotrzebnych danych wrażliwych. Zdefiniuj progi alarmowe i właściciela reakcji, a następnie przeglądaj dowody z rzeczywistego świata po wdrożeniu, zamiast zakładać, że offline‑owa wydajność utrzyma się. Przeprowadzaj ponowną ocenę przy zmianie źródeł danych, użytkowników, modeli, dostawców, polityk, sprzętu lub celów. Utrzymany system wymaga także udokumentowanego odzyskiwania, nauki z incydentów, procedur usuwania i przechowywania oraz wyraźnego punktu, w którym powinien zostać wyłączony lub zastąpiony.
Podstawowe źródła












