
Podstawy AI
Czym jest macierz pomyłek?

 Dodaj Unite.AI do preferowanych źródeł w Google
Macierz pomyłek jest tabelą, która zlicza, jak często prognozy klasyfikatora zgadzają się lub nie zgadzają z znanymi etykietami. Pokazuje, które klasy są mylone i dostarcza liczby używane do obliczania miar takich jak precyzja, czułość, specyficzność i F1. Jest jednym z podstawowych narzędzi diagnostycznych dla uczenia nadzorowanego w problemach klasyfikacji.
Sama macierz nie jest pojedynczą miarą wydajności. Stanowi ustrukturyzowany widok wyników przy określonym progu decyzyjnym, zestawie danych i definicji klasy.
Kluczowe wnioski
- Dla klasyfikacji binarnej cztery wyniki to prawdziwie pozytywne (TP), fałszywie pozytywne (FP), fałszywie negatywne (FN) i prawdziwie negatywne (TN).
- Zawsze oznaczaj osie: biblioteki i publikacje nie zawsze umieszczają rzeczywiste i przewidywane klasy w tej samej orientacji.
- Dokładność może ukrywać poważne błędy, gdy klasy są niezrównoważone.
- Zmiana progu klasyfikacji zmienia macierz pomyłek oraz kompromis między precyzją a czułością.
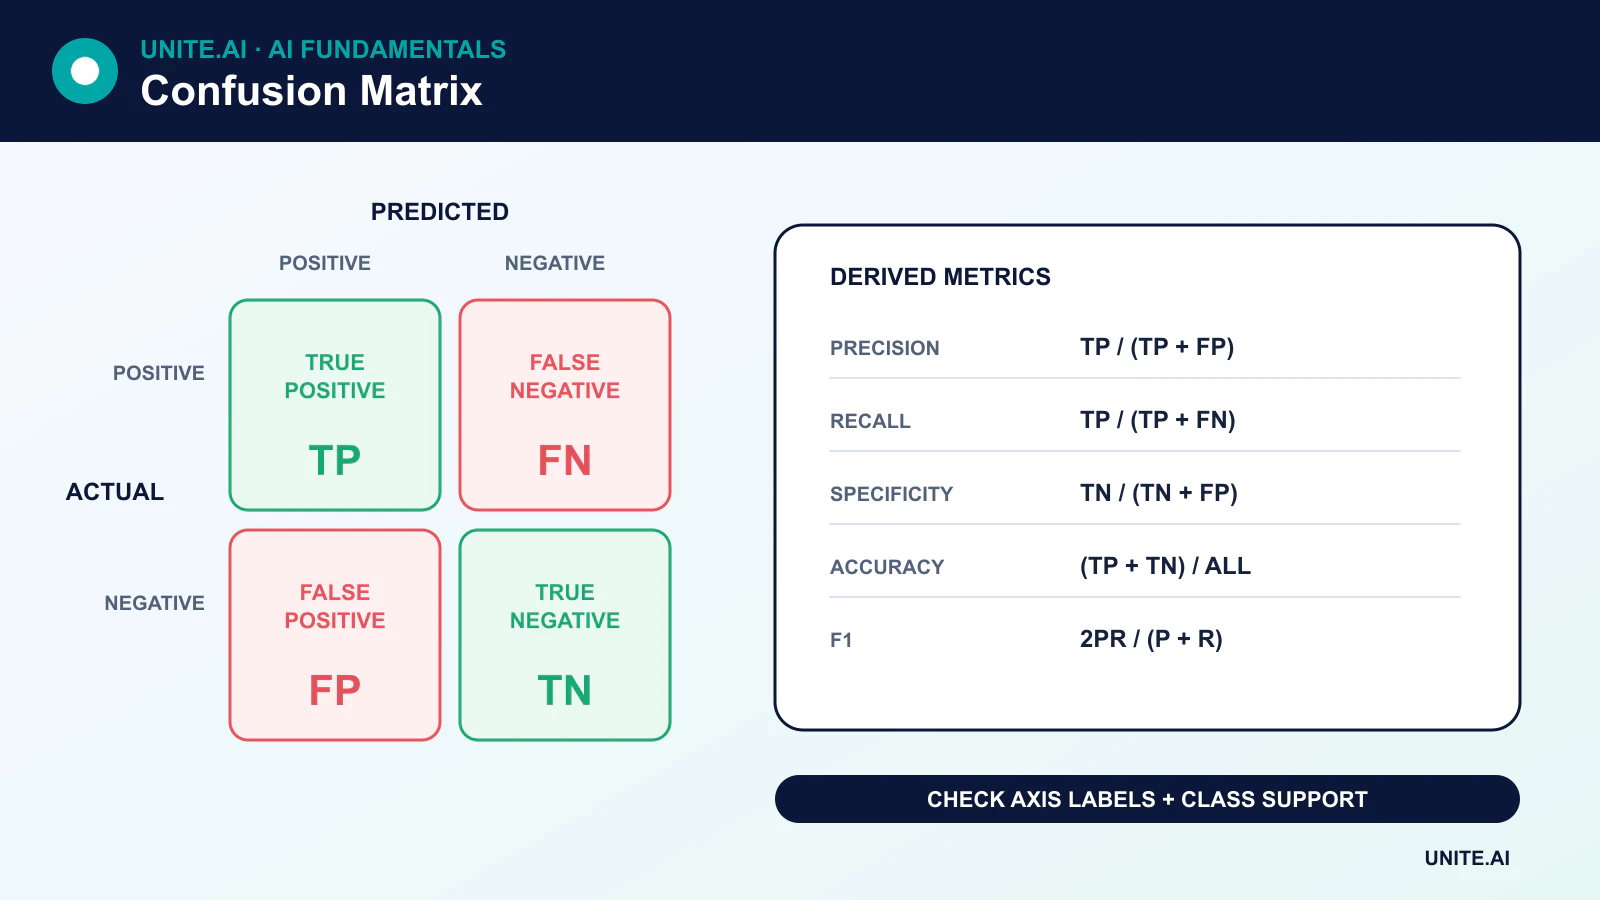
Cztery wyniki klasyfikacji binarnej
- Prawdziwie pozytywne (TP): przykład jest pozytywny, a model przewiduje pozytywny.
- Fałszywie pozytywne (FP): przykład jest negatywny, ale model przewiduje pozytywny.
- Fałszywie negatywne (FN): przykład jest pozytywny, ale model przewiduje negatywny.
- Prawdziwie negatywne (TN): przykład jest negatywny, a model przewiduje negatywny.
W konwencji scikit-learn wiersze reprezentują prawdziwe klasy, a kolumny przewidywane klasy. Inne wizualizacje mogą transponować tę organizację, więc etykiety — a nie pozycje w rogach — powinny kierować interpretacją.
Miary wyprowadzane z macierzy pomyłek
Precyzja
Precision = TP / (TP + FP)
Precyzja odpowiada na pytanie: spośród przykładów przewidzianych jako pozytywne, jaki odsetek był rzeczywiście pozytywny?
Czułość (recall)
Recall = TP / (TP + FN)
Czułość odpowiada na pytanie: spośród wszystkich rzeczywistych pozytywnych przykładów, jaki odsetek model zidentyfikował? W klasyfikacji binarnej czułość klasy pozytywnej nazywana jest także czułością (sensitivity) lub wskaźnikiem prawdziwie pozytywnych.
Specyficzność
Specificity = TN / (TN + FP)
Specyficzność to czułość dla klasy negatywnej: spośród rzeczywistych negatywów, jaki odsetek model poprawnie odrzucił?
Dokładność
Accuracy = (TP + TN) / (TP + TN + FP + FN)
Dokładność jest przydatna, gdy klasy i koszty błędów są w miarę zrównoważone. Może być myląca, gdy jedna klasa dominuje.
Miara F1
F1 = 2 × (Precision × Recall) / (Precision + Recall)
Miara F1 podsumowuje precyzję i czułość za pomocą średniej harmonicznej. Ignoruje prawdziwe negatywy, więc nie jest odpowiednim podsumowaniem dla każdego zadania.
Przykład praktyczny
Załóżmy, że zbiór testowy zawiera 1 000 transakcji. Pięćdziesiąt z nich jest oszukańczych. Model wykrywa 40 z tych oszustw, ale oznacza jako podejrzane 30 prawidłowych transakcji:
- TP = 40
- FN = 10
- FP = 30
- TN = 920
Model osiąga 96 % dokładności, ale jego precyzja wynosi około 57 %, a czułość 80 %. Wysoka dokładność wynika głównie z dużej liczby prawidłowych transakcji. Czy model jest akceptowalny, zależy od kosztu niewykrytych oszustw, możliwości dochodzeniowych oraz tego, jak skalibrowane są jego oceny ryzyka.
Progi zmieniają macierz
Wiele klasyfikatorów zwraca wynik liczbowy zamiast jednoznacznej odpowiedzi tak/nie. Obniżenie progu pozytywnego zazwyczaj zwiększa czułość i liczbę fałszywych alarmów; podniesienie go zazwyczaj zwiększa precyzję lub specyficzność, jednocześnie pomijając więcej pozytywów. Próg powinien być dobrany na podstawie danych walidacyjnych i rzeczywistych kosztów błędów, a nie automatycznie ustalony na 0,5.
Krzywe precyzja‑czułość oraz ROC podsumowują wydajność przy różnych progach. Krzywe precyzja‑czułość są często bardziej informacyjne, gdy klasa pozytywna jest rzadka.
Wieloklasowe macierze pomyłek
Dla K klas macierz ma rozmiar K × K. Poprawne prognozy znajdują się na przekątnej; komórki poza przekątną pokazują, które pary klas są mylone. Miary per‑klasa można uśredniać na różne sposoby:
- Średnia makro: każda klasa ma równą wagę.
- Średnia ważona: waga każdej klasy zależy od liczby jej przykładów.
- Średnia mikro: najpierw sumuje się liczbę wyników, a dopiero potem oblicza miarę.
Raportowanie tylko jednej średniej może ukrywać słabą wydajność w mniejszych klasach. Należy podawać liczby wsparcia oraz wyniki per‑klasa tam, gdzie różnice mają znaczenie.
Częste błędy
- Odczytywanie transponowanej macierzy bez sprawdzenia etykiet osi.
- Obliczanie miar na danych treningowych zamiast na odpowiednim zestawie odrzuconym.
- Ignorowanie częstości klas, strategii próbkowania lub duplikatów jednostek w podziałach.
- Porównywanie macierzy wygenerowanych przy różnych progach bez zaznaczenia zmiany.
- Traktowanie wszystkich fałszywych alarmów i fałszywych negatywów jako równocennych kosztowo.
Macierz pomyłek jest więc narzędziem diagnostycznym, a nie pełną oceną. Do przeglądu klasyfikacji należy także uwzględnić kalibrację, analizę podgrup, odporność oraz konsekwencje downstream.
Czytanie każdej komórki i wyprowadzanie użytecznych miar
Dla klasyfikacji binarnej macierz pomyłek liczy prawdziwie pozytywne, fałszywie pozytywne, fałszywie negatywne i prawdziwie negatywne dla wybranej klasy pozytywnej i progu. Dokładność dzieli liczbę poprawnych prognoz przez wszystkie przypadki; precyzja pyta, jaki odsetek przewidzianych pozytywów był prawidłowy; czułość pyta, jaki odsetek rzeczywistych pozytywów został wykryty; specyficzność mierzy, ile rzeczywistych negatywów zostało poprawnie odrzuconych. Miara F1 jest harmoniczną średnią precyzji i czułości. Żadna z nich nie jest uniwersalnie najlepsza: screening oszustw, triage medyczny i filtrowanie spamu przypisują różne konsekwencje tym samym komórkom.
Dla problemów wieloklasowych wiersze zazwyczaj reprezentują klasy rzeczywiste, a kolumny klasy przewidywane, choć konwencje się różnią, więc etykiety muszą być wyraźne. Liczenie „jeden‑przeciw‑reszcie” daje precyzję i czułość per‑klasa. Średnia makro waży klasy równomiernie; średnia mikro agreguje decyzje i faworyzuje klasy częste; średnia ważona uwzględnia wsparcie klasy. Zadania wieloetykietowe pozwalają na kilka etykiet na element i wymagają definicji per‑etykieta lub per‑próbka. Normalizacja wierszowa pozwala analizować wzorce czułości, a kolumnowa – skład prognoz, ale należy zachować surowe liczby, aby rzadkie grupy nie były wizualnie wyolbrzymiane.
Progi, niepewność i decyzje operacyjne
Macierz pomyłek podsumowuje twarde decyzje przy jednym progu. Użyj krzywych precyzja‑czułość lub ROC, aby porównać progi, a następnie wybierz punkt operacyjny na podstawie pojemności, częstości i kosztów błędów. Kalibracja pyta, czy prognozowane prawdopodobieństwa odpowiadają obserwowanej częstości i jest odrębna od rankingu. Gdy częstość zmienia się, precyzja może się zmienić, nawet jeśli czułość i specyficzność pozostają stabilne. Raportuj przedziały ufności lub wariancję bootstrap i unikaj wyciągania wniosków z kilku błędów w małej podgrupie.
Audytuj macierze według czasu, lokalizacji, urządzenia, języka i istotnych grup, aby znaleźć skoncentrowane błędy. Porównaj model z istniejącym procesem decyzyjnym, w tym przeglądem ludzkim. Dla kaskad rejestruj błędy na każdym etapie: pobieranie, klasyfikacja, progowanie i akcja. Monitoruj rzeczywiste etykiety wyników z opóźnieniem i procesem korekty. Wyglądająca na lepsza miara F1 może nadal zwiększać szkodliwe fałszywe negatywy lub przekraczać pojemność przeglądu. Macierz pomyłek jest rejestrem decyzji; połącz każdą komórkę z tym, kto doświadcza błędu i jaką reakcję podjąć.
Przykład praktyczny: wybór progu w badaniu medycznym
Model uczenia maszynowego do screeningu wyjściowego generuje wynik ryzyka dla rzadko występującej choroby. Zespół tworzy macierze pomyłek przy różnych progach i raportuje czułość, specyficzność, precyzję, liczbę fałszywych skierowań oraz pominiętych przypadków wraz z przedziałami ufności. Ponieważ dodatnia wartość predykcyjna zależy od częstości, modeluje się docelową populację zamiast cytować jedynie precyzję z jednego zestawu danych. Wyniki są segmentowane według urządzenia, miejsca, wieku, płci i innych klinicznie uzasadnionych grup.
Klinicyści wybierają punkt operacyjny, który zachowuje wymaganą czułość bez przytłaczania testami potwierdzającymi. Macierz jest przeliczana na oczekiwane liczby na 10 000 badanych osób, aby konsekwencje były zrozumiałe. Wyniki spoza zwalidowanych warunków nie generują automatycznej decyzji. Monitorowanie porównuje prognozy z opóźnionymi, potwierdzonymi diagnozami, śledzi pojemność i kalibrację oraz wyzwala przegląd, gdy częstość lub sposób pozyskania danych się zmienia. Macierz pomyłek pozostaje powiązana z konkretnym modelem, progiem i populacją.
Dowody wdrożeniowe i gotowość operacyjna
Decyzja produkcyjna wymaga więcej niż udany pokaz. Określ docelowych użytkowników, środowisko operacyjne, wejścia, wyjścia, zależności, właściciela oraz konsekwencje każdego istotnego błędu. Ustal powtarzalną bazę i wersjonowany zestaw ewaluacyjny przed strojeniem. Testuj typowe przypadki, warunki brzegowe, niepoprawne lub brakujące dane, przesunięcia rozkładu, awarie zależności, niewłaściwe użycie oraz grupy lub środowiska najprawdopodobniej niedostatecznie obsłużone. Mierz jakość zadania wraz z kalibracją lub niepewnością, opóźnieniem, przepustowością, kosztami zasobów, dostępnością, prywatnością i bezpieczeństwem. Rejestruj każdą transformację i próg, aby niezależny recenzent mógł odtworzyć wynik i odróżnić dowód od atrakcyjnego prototypu.
Przed uruchomieniem przydziel odpowiedzialność za wydanie, wyjątki, zmiany, wycofanie i wycofanie. Użyj etapowego wdrożenia, zachowaj bezpieczny fallback i zweryfikuj monitorowanie poprzez celowo wstrzyknięte awarie. Telemetria operacyjna powinna ujawniać jakość wejść, zachowanie wyjść, wersję modelu lub reguły, stan zależności, interwencje ludzkie i potwierdzone wyniki, bez zbierania niepotrzebnych danych wrażliwych. Zdefiniuj progi alarmowe i właściciela reakcji, a następnie po wdrożeniu analizuj rzeczywiste dowody, zamiast zakładać, że offline wydajność się utrzyma. Przeglądaj ponownie przy zmianie źródeł danych, użytkowników, modeli, dostawców, polityk, sprzętu lub celów. Utrzymany system wymaga także udokumentowanego przywracania, nauki z incydentów, procedur usuwania i przechowywania oraz jasnego momentu, w którym powinien zostać wyłączony lub zastąpiony.
Najczęściej zadawane pytania
Czym jest znormalizowana macierz pomyłek?
Normalizacja dzieli liczbę obserwacji przez sumę wiersza rzeczywistej klasy, sumę w kolumnie przewidywanej klasy lub przez wszystkie obserwacje. Ułatwia porównywanie wskaźników między klasami, ale raport powinien także zachować surowe liczby wsparcia, aby małe grupy nie były mylnie traktowane jako równie duże.
Czy macierz pomyłek może oceniać regresję?
Nie bezpośrednio. Macierz pomyłek wymaga dyskretnych klas. Grupowanie ciągłego celu powoduje utratę informacji; regresję zazwyczaj ocenia się przy użyciu analizy reszt i miar przeznaczonych dla wartości ciągłych, takich jak MAE lub RMSE.
Podstawowe źródła












