Podstawy AI
Czym jest hurtownia danych? Architektura, ETL i przypadki użycia

 Dodaj Unite.AI do preferowanych źródeł w Google
Hurtownia danych jest systemem analitycznym, który integruje informacje z źródeł operacyjnych i organizuje je do raportowania, analizy biznesowej oraz powtarzalnych analiz. Oddziela wiele obciążeń analitycznych od aplikacji rejestrujących transakcje.
Nowoczesne hurtownie mogą być kolumnowe, rozproszone, bezserwerowe lub połączone z przechowywaniem obiektowym. Definiująca praca pozostaje spójna: zarządzane pobieranie danych, modelowane znaczenie, historia, wydajność zapytań, bezpieczeństwo, jakość i niezawodne dostarczanie użytkownikom.
Kluczowe wnioski
- Systemy operacyjne optymalizują bieżące transakcje; hurtownie optymalizują analizę historyczną z różnych źródeł.
- ETL przetwarza przed załadowaniem, podczas gdy ELT najpierw ładuje, a transformacje odbywają się wewnątrz platformy analitycznej.
- Modele wymiarowe, znormalizowane i szerokotabelaryczne obsługują różne obciążenia i potrzeby zarządzania.
- Zaufanie zależy od pochodzenia danych, testów, aktualności, kontroli dostępu, definicji semantycznych i monitorowania kosztów.
Źródła, pobieranie i przechowywanie
Dane mogą napływać w partiach, za pomocą przechwytywania zmian danych, strumieni, plików i interfejsów API. Warstwa lądowania zachowuje kontekst źródła; transformacje standaryzują typy, usuwają duplikaty rekordów, obsługują opóźnione zdarzenia i tworzą wielokrotnego użytku jednostki analityczne.
Rozszerza to przepływ pracy ETL. ELT wykorzystuje moc obliczeniową hurtowni do transformacji, podczas gdy ETL może redukować lub weryfikować dane przed załadowaniem. Odpowiedni wybór zależy od opóźnień, prywatności, skali i zestawu narzędzi.
Modelowanie danych pod kątem pytań
Modele wymiarowe organizują mierzalne fakty wokół opisowych wymiarów, takich jak klient, produkt i czas. Znormalizowane modele podstawowe mogą zachować relacje w przedsiębiorstwie, natomiast denormalizowane hurtownie danych upraszczają typowe zapytania.
Warstwa semantyczna zapewnia spójne definicje miar. Bez niej zespoły mogą generować kilka pozornie prawidłowych wskaźników przychodów lub retencji z tych samych wierszy. Dane strukturalne wciąż wymagają uzgodnionego znaczenia.
Hurtownia, jezioro danych i lakehouse
Jezioro danych zazwyczaj przechowuje pliki oraz różnorodne surowe lub przetworzone dane w przechowywaniu obiektowym. Hurtownia dostarcza zarządzane tabele analityczne i usługi zapytań. Projekt lakehouse dodaje do przechowywania jeziora metadane tabel, transakcje i zarządzanie.
Są to wzorce architektoniczne, a nie gwarancje. Organizacje często łączą je za pomocą data fabric lub wspólnej warstwy zarządzania. Obciążenie, umiejętności, interoperacyjność i koszt cyklu życia mają większe znaczenie niż nazwa.
Jakość, bezpieczeństwo i operacje
Zdefiniuj właścicieli, umowy, cele aktualności, pochodzenie danych, testy, retencję oraz dostęp do wierszy lub kolumn. Oddziel dane osobowe, stosuj zasadę najmniejszych uprawnień i audytuj wrażliwe zapytania. Uzupełnienia i zmiany schematu wymagają kontrolowanych, obserwowalnych procedur.
Mierz udane odświeżenia, opóźnienia danych, niepowodzenia testów, wydajność zapytań, przyjęcie, wpływ incydentów oraz koszt na obciążenie. Hurtownia jest przydatna, gdy użytkownicy mogą śledzić miarę do zarządzanych danych i odtworzyć wynik.
Modelowanie wymiarowe i semantyka
Tabela faktów rejestruje zdarzenia lub okresowe pomiary w zadeklarowanej ziarnistości, np. jedną pozycję zamówienia lub jedno urządzenie na godzinę. Wymiary dostarczają opisowego kontekstu. Deklarowanie ziarnistości przed wyborem kolumn zapobiega mieszaniu poziomów, które powodują podwójne liczenie. Miary addytywne można sumować wzdłuż wszystkich wymiarów; miary póładdytywne wymagają ostrożności w kontekście czasu.
Klucze zastępcze odłączają historię hurtowni od zmieniających się identyfikatorów źródłowych. Wolno zmieniające się wymiary określają, jak obsługiwać zmiany atrybutów: nadpisanie, zachowanie nowego wiersza historycznego lub utrzymanie ograniczonych poprzednich wartości. Odpowiednia metoda zależy od pytania analitycznego i wymogów retencji.
Metryka semantyczna powinna definiować formułę, filtry, zachowanie w czasie, walutę, wykluczenia, właściciela i testy. Centralne definicje zmniejszają niespójność, ale zarządzanie powinno umożliwiać proponowane zmiany i wersjonowanie. Jedna warstwa semantyczna staje się wąskim gardłem, jeśli użytkownicy nie mogą jej odpowiedzialnie przeglądać ani rozszerzać.
Nowoczesne przechowywanie i architektura zapytań
Przechowywanie kolumnowe utrzymuje wartości jednej kolumny razem, poprawiając kompresję i skanowanie tylko potrzebnych pól. Partycjonowanie przycina duże sekcje według daty lub innego klucza; klastrowanie współlokalizuje powiązane wartości; widoki materializowane i pamięci podręczne ponownie wykorzystują wyniki. Złe wybory partycjonowania tworzą małe pliki, nieproporcjonalność lub kosztowne pełne skany.
Masowo równoległe silniki zapytań dzielą skany, łączenia i agregacje pomiędzy pracownikami. Przemieszczanie danych podczas łączeń może dominować czas wykonania, więc dystrybucja, statystyki i kolejność łączeń mają znaczenie. Autoskalowanie i usługi bezserwerowe upraszczają pojemność, ale wymagają kontroli kosztów, priorytetów obciążeń i ograniczeń dla niekontrolowanych zapytań.
Formaty tabel lakehouse dodają metadane, migawki, ewolucję schematu i semantykę transakcji nad plikami obiektowymi. Poprawiają interoperacyjność, ale wprowadzają obowiązki katalogu i utrzymania. Otwarte formaty zmniejszają uzależnienie tylko wtedy, gdy silniki obliczeniowe, zarządzanie i procedury operacyjne rzeczywiście mogą z nich korzystać.
Niezawodne potoki danych i produkty danych
Potoki powinny być idempotentne lub zdolne do rozwiązywania duplikatów. Znaczniki wody i czas zdarzenia obsługują późne przybycia; uzupełnienia odtwarzają historyczne transformacje; kontrakty schematu definiują zgodne zmiany. Testy danych obejmują unikalność, kompletność, dopuszczalne wartości, relacje i reguły biznesowe — nie tylko to, czy zadanie zostało uruchomione.
Traktuj ważne zestawy danych jako produkty z właścicielami, dokumentacją, oczekiwaniami serwisowymi, możliwością odnalezienia, wsparciem i użytkownikami. Pochodzenie łączy pola źródłowe przez transformacje z raportami, co przyspiesza ocenę wpływu zmian i badanie incydentów. Polityki dostępu powinny się propagować lub być ponownie oceniane przy kopiowaniu danych.
Program hurtowni odnosi sukces, gdy decyzje stają się bardziej niezawodne i szybsze, a nie gdy rośnie wolumen przechowywanych danych. Wycofaj nieużywane tabele, ujawnij koszty zapytań i przechowywania, przeglądaj dostęp do wrażliwych danych i mierz, czy zespoły ufają i ponownie wykorzystują zarządzane miary zamiast utrzymywać prywatne arkusze kalkulacyjne.
Przykładowe zastosowanie: projektowanie hurtowni analityki sprzedaży
Zdefiniuj ziarnistość faktu jako jedną zrealizowaną pozycję zamówienia, a następnie połącz wymiary produktu, klienta, kanału, promocji, geografii i daty za pomocą kluczy zastępczych. Zachowaj zdarzenia statusu zamówienia w osobnej tabeli faktów, zamiast mieszać migawki i transakcje. Przychód, ilość, rabat, podatek i koszt wymagają wyraźnej waluty, zwrotu, anulowania i zasad rozpoznawania. Definicja miary powinna dawać tę samą odpowiedź w pulpitach, notatnikach i uzgadnianiu finansowym.
Pobieranie danych rejestruje zmiany w źródle, ląduje niezmienialne dane surowe, weryfikuje schemat i przekształca je w testowane modele stagingowe i wymiarowe. Aktualizacje przybywające późno muszą korygować odpowiedni okres historyczny bez duplikowania faktów. Porównaj liczbę wierszy i sumy pieniężne z systemami źródłowymi, przetestuj unikalność i relacje oraz zapisz pochodzenie od pola raportu do źródła. Uzupełnienia używają wersjonowanego kodu i izolowanej weryfikacji przed zastąpieniem zaufanych tabel.
Dostęp oddziela identyfikatory klientów od szeroko dostępnych agregatów i stosuje zasadę najmniejszych uprawnień według roli i celu. Zarządzanie obciążeniem utrzymuje responsywność pulpitów wykonawczych, podczas gdy analitycy uruchamiają zapytania eksploracyjne. Monitoruj aktualność, nieudane testy, koszt zapytań, nieużywane tabele i zmiany semantyczne. Hurtownia odnosi sukces, gdy zarządzane miary wspierają powtarzalne decyzje; samo scentralizowanie danych może scentralizować zamieszanie, jeśli własność, jakość i definicje pozostają nierozwiązane.
Odzyskiwanie po awarii powinno określać zakres kopii zapasowych, kopie międzyregionowe, przywracanie katalogu i uprawnień, dopuszczalną utratę danych oraz czas przywracania. Przetestuj odtworzenie w izolowanym środowisku i zweryfikuj miary, a nie tylko pliki. Klucze szyfrowania, konfiguracja tożsamości, kod orkiestracji i definicje semantyczne są częścią systemu możliwego do odzyskania. Hurtownia, która może przywrócić petabajty, ale nie odtworzyć polityki dostępu ani zaufanych obliczeń, nie odzyskała swojej usługi analitycznej.
Praktyczna lista kontrolna wdrożenia
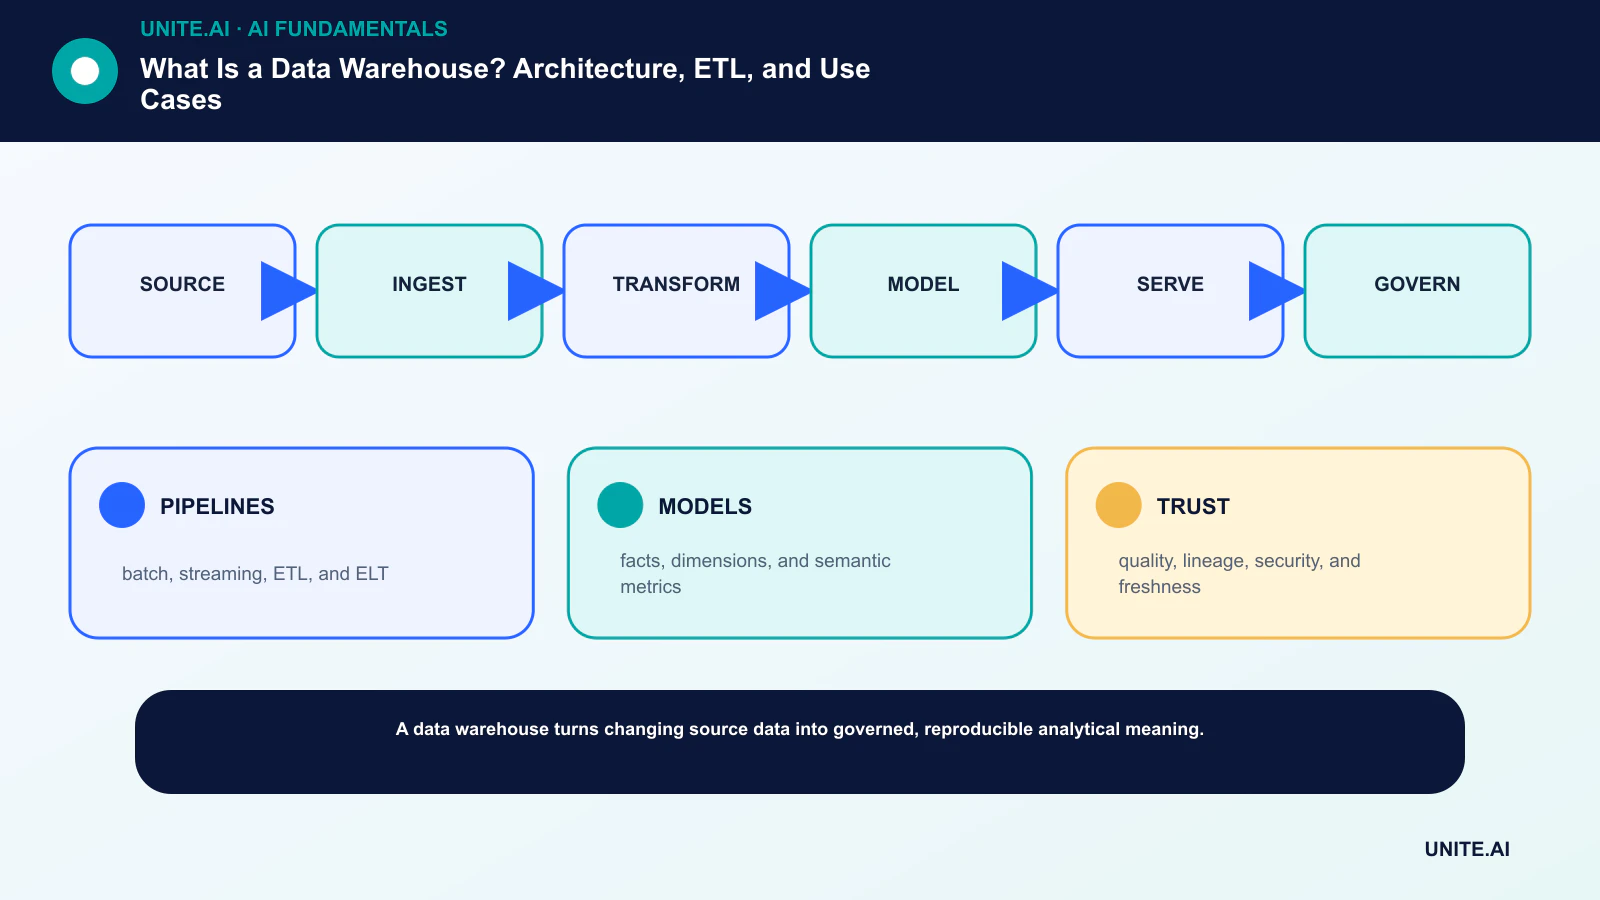
Przekształć koncepcję w ograniczony, testowalny przepływ pracy: źródło → pobieranie → transformacja → modelowanie → udostępnianie → zarządzanie. Wyznacz odpowiedzialnego właściciela, udokumentuj dane i zależności, ustal prostą bazę odniesienia, określ kryteria akceptacji i zakończenia, przetestuj reprezentatywne awarie oraz zdefiniuj monitorowanie, przywracanie i przegląd przed rozszerzeniem zakresu. Rejestruj wersje i założenia, aby inny zespół mógł odtworzyć wynik i zrozumieć, co się zmieniło.
Przed uruchomieniem przeprowadź udokumentowaną ocenę gotowości z osobami, które budują, obsługują, zabezpieczają i są dotknięte systemem. Testuj przypadki normalne, warunki brzegowe, awarie zależności i niewłaściwe użycie; zachowaj dowody i nierozwiązane ryzyka. Określ, kto może zatwierdzić wydanie, zmienić próg, nadpisać wynik lub zatrzymać działanie. Ponownie rozważ decyzję po pojawieniu się danych rzeczywistych, ponieważ technicznie udany pilotaż nie gwarantuje niezawodnej wydajności w większej skali.
- PIPELINEY: wsadowe, strumieniowe, ETL i ELT.
- MODELE: fakty, wymiary i miary semantyczne.
- ZAUFANIE: jakość, pochodzenie, bezpieczeństwo i aktualność.
Najczęściej zadawane pytania
Czy hurtownia danych to po prostu duża baza danych?
Jest to baza danych lub platforma analityczna zaprojektowana wokół zintegrowanej, historycznej analizy. Jej modelowanie, pobieranie danych, zarządzanie i wzorce obciążeń różnią się od bazy danych aplikacji transakcyjnych.
Czy firma powinna używać ETL czy ELT?
Wiele firm używa obu podejść. Transformuj wczesnie, gdy wymagana jest prywatność, walidacja lub przepustowość; transformuj po załadowaniu, gdy korzystne są moc obliczeniowa hurtowni i szybka iteracja.
Podstawowe źródła