
Podstawy AI
Czym jest ETL? Wyjaśnienie Extract, Transform, Load

 Dodaj Unite.AI do preferowanych źródeł w Google
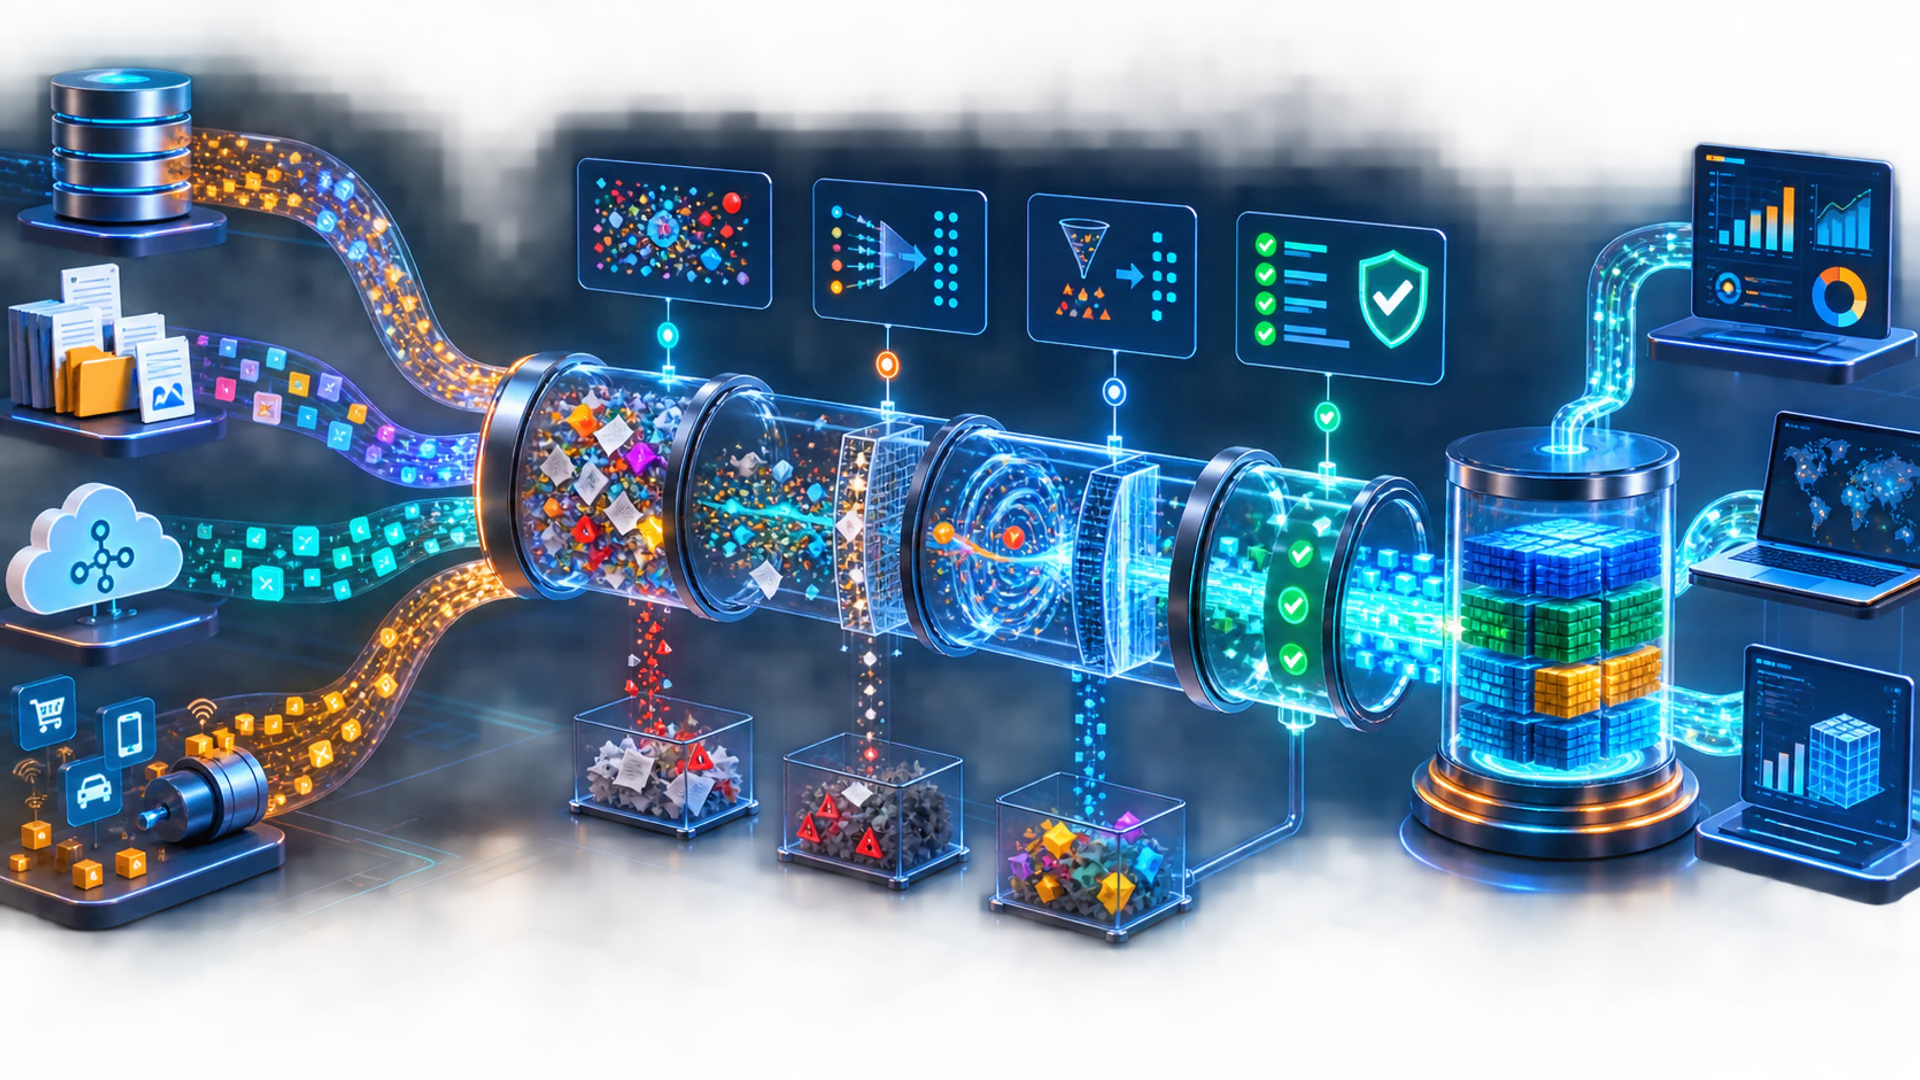
ETL — extract, transform, load — to wzorzec integracji danych, który odczytuje dane z systemów źródłowych, weryfikuje i przekształca je, a następnie zapisuje do docelowego miejsca przeznaczonego do analiz, raportowania, uczenia maszynowego lub operacji.
Produkcyjny potok ETL to nie tylko trzy elementy. Wymaga powtarzalnego wykonywania, kontroli schematu i jakości, śledzenia pochodzenia danych, orkiestracji, obserwowalności, bezpieczeństwa oraz bezpiecznego sposobu uzupełniania lub odtwarzania danych po zmianie logiki.
Kluczowe wnioski
- Ekstrakcja powinna minimalizować wpływ na źródło i rejestrować, jaki przedział lub zestaw zmian został przechwycony.
- Transformacje kodują znaczenie biznesowe, dlatego potrzebują kontroli wersji, testów i właściciela.
- Ładowania powinny być idempotentne lub w inny sposób chronić przed duplikatami i częściowymi awariami.
- Różnica między ETL a ELT dotyczy głównie miejsca wykonywania transformacji; nowoczesne systemy często używają obu podejść.
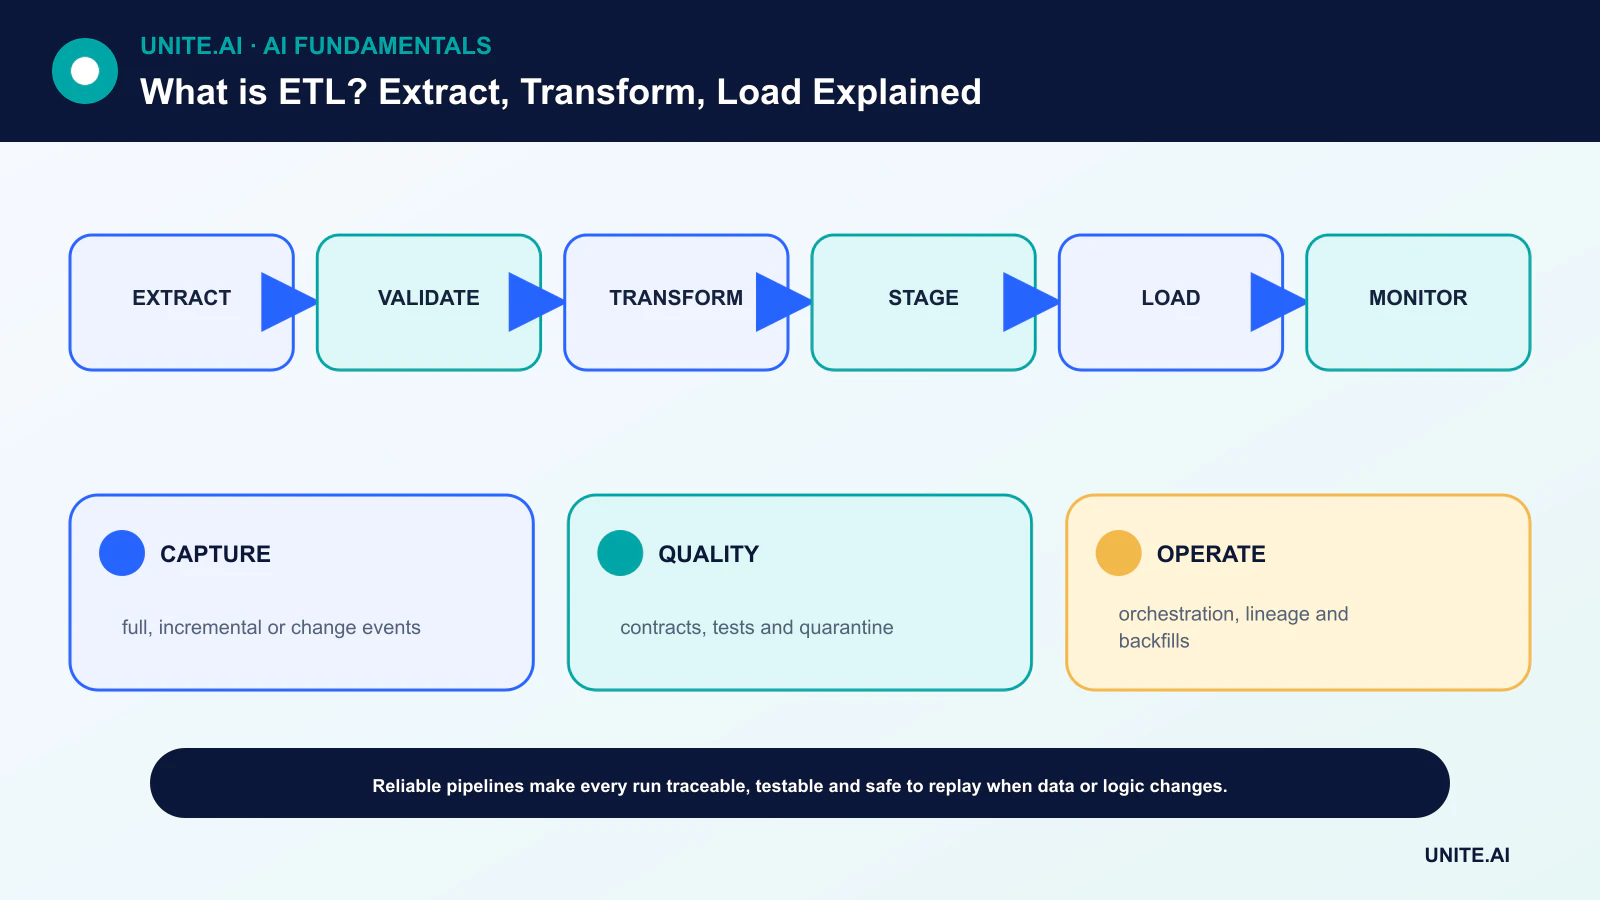
Niezawodne wyodrębnianie danych
Źródła mogą obejmować bazy danych, pliki, interfejsy API, strumienie zdarzeń i aplikacje. Pełna ekstrakcja kopiuje cały zestaw; ekstrakcja przyrostowa odczytuje rekordy zmienione od ostatniego punktu kontrolnego. Technika change‑data‑capture wykorzystuje dzienniki baz danych lub zdarzenia, aby ograniczyć powtarzające się skanowanie.
Rejestruj identyfikatory źródła, granice czasowe i punkty kontrolne. Przestrzegaj limitów przepustowości i semantyki transakcji. Jeśli źródło cicho zmieni schemat, zakończ bezpiecznie lub odizoluj rekordy, zamiast ładować niejednoznaczne dane, jakby nic się nie stało.
Transformacja przy użyciu wyraźnych kontraktów
Transformacje standaryzują typy i jednostki, parsują rekordy, łączą źródła, usuwają lub oznaczają duplikaty, stosują reguły biznesowe i obliczają cechy. Oddzielają nieprawidłowe dane od brakujących, ale dopuszczalnych, i zachowują wystarczające dowody, aby śledzić wynik z powrotem do jego wejść.
Wersjonuj transformacje w taki sam zdyscyplinowany sposób, jak dostawa oprogramowania. Testy powinny obejmować schemat, zakresy, integralność referencyjną, oczekiwane rozkłady i znane przykłady. Umowa danych definiuje oczekiwania między producentem a konsumentem.
Bezpieczne i powtarzalne ładowanie
Ładowanie może dopisywać zdarzenia, scalać zmienione rekordy, zastępować partycję lub odbudowywać tabelę. Idempotencja oznacza, że ponowne uruchomienie tego samego wejścia daje ten sam stan docelowy. Transakcje, tabele stagingowe i atomowe zamiany zmniejszają ryzyko częściowych aktualizacji.
Partycjonowanie i indeksowanie powinny odpowiadać wzorcom konsumpcji. Chroń wrażliwe pola i zastosuj uprawnienia docelowe, zanim dane staną się dostępne do zapytań. Wymagania dotyczące przechowywania i usuwania muszą podążać za danymi.
ETL, ELT, przetwarzanie wsadowe i strumieniowe
Tradycyjny ETL wykonuje transformacje w oddzielnym silniku przed ładowaniem. ELT najpierw ładuje surowe lub lekko przetworzone dane, a następnie wykorzystuje moc obliczeniową miejsca docelowego do transformacji. Chmura typu hurtownia lub lakehouse może ułatwić ELT, ale nie eliminuje pracy związanej z jakością czy zarządzaniem.
Potoki wsadowe przetwarzają ograniczone przedziały czasowe; potoki strumieniowe przetwarzają bieżące zdarzenia z określoną semantyką czasu i kolejności. Wiele architektur stosuje najpierw ingestję strumieniową, a potem okresową rekonsyliację, ponieważ opóźnione lub skorygowane dane są normą.
Orkiestracja, pochodzenie i obserwowalność
Orkiestrator planuje zadania, respektuje zależności, ponawia zdefiniowane niepowodzenia i rejestruje stan. Ponowienia wymagają limitów i zadań idempotentnych. Uzupełnienia (backfills) powinny być izolowane i uwzględniać dostępne zasoby, aby naprawy historyczne nie zakłócały bieżących danych.
Monitoruj aktualność, wolumen, schemat, jakość, czas trwania i koszty. Pochodzenie oraz warstwa metadanych data fabric pomagają odbiorcom zrozumieć, która wersja wygenerowała zestaw danych i co zepsuło się w górę łańcucha.
Ekstrakcja: źródła, kontrakty i przyrostowe przechwytywanie
ETL przenosi dane z systemów źródłowych, przekształca je w zarządzane struktury i ładuje do miejsca docelowego. Ekstrakcja może wykorzystywać pliki, zapytania bazodanowe, API, dzienniki, strumienie lub technikę change‑data‑capture. Zdefiniuj własność źródła, schemat, klucze, znaczniki czasu, strefę czasową, jednostki, semantykę usuwania oraz dopuszczalne ładowanie. Pełne ekstrakcje są proste, ale kosztowne; przyrostowe przechwytywanie zmniejsza wolumen, ale wymaga znaczników wodnych, pozycji w logach lub pól wersji oraz strategii dla opóźnionych i skorygowanych rekordów.
Nie zakładaj, że sukces API oznacza pełną ekstrakcję. Rejestruj liczby rekordów, sumy kontrolne, luki w sekwencjach, paginację, limity przepustowości, ponowienia i migawki źródła. Przechowuj niezmienialne dane surowe tam, gdzie polityka na to pozwala, aby można było odtworzyć transformacje. Chroń poświadczenia i wrażliwe pola oraz zapewnij, że ponowienia są idempotentne. Zmiany schematu powinny być klasyfikowane jako kompatybilne lub łamiące kontrakty, a nie odkrywane dopiero, gdy downstreamowy pulpit zmieni się cicho.
Transformacja i ładowanie z reprodukowalną semantyką
Transformacje parsują typy, standaryzują jednostki, usuwają duplikaty, łączą dane, stosują reguły biznesowe, zarządzają historią i wyprowadzają fakty oraz wymiary. Każda reguła wymaga testów i śledzenia pochodzenia. Statystyczne przetwarzanie wstępne stosuj wyłącznie na odpowiednich danych treningowych, gdy ETL zasila ML. Wolno zmieniające się wymiary określają, czy zmiany atrybutów nadpisują, czy zachowują historię. Zdefiniuj ziarnistość faktów przed łączeniem; błędy wiele‑do‑wielu tworzą zduplikowane miary, które mogą przejść podstawowe kontrole wierszy.
Ładowanie może dopisywać, scalać, zastępować partycje lub aktualizować rekordy. Stosuj tabele stagingowe i atomowe zamiany, gdy to możliwe, aby czytelnicy nie widzieli częściowego stanu. Wymuszaj unikalność, relacje, dopuszczalne wartości, kompletność oraz reguły biznesowe. Obsługuj opóźnione zdarzenia i uzupełnienia przy użyciu czasu zdarzenia i wersjonowanego kodu. Rekonsyliacja z sumami źródłowymi jest niezbędna dla danych finansowych i operacyjnych. ELT ładuje surowe dane przed transformacją w miejscu docelowym; wymagania dotyczące zarządzania i poprawności pozostają.
Operacje i odzyskiwanie
Orkiestracja zarządza zależnościami, harmonogramami, ponowieniami, współbieżnością i alertami. Monitoruj aktualność, wolumen, jakość, czas trwania, koszty oraz wpływ na downstream. Niepowodzenie zadania powinno umożliwiać wznowienie lub odtworzenie bez duplikacji. Wersjonuj kod i schematy, utrzymuj pochodzenie oraz testuj uzupełnienia w izolacji. Odzyski po awarii obejmują dane surowe, katalogi, uprawnienia, stan orkiestracji i definicje semantyczne. ETL jest godny zaufania, gdy użytkownik może prześledzić metrykę do źródeł i odtworzyć ją po zmianie — nie tylko wtedy, gdy zielony potok zakończył się pomyślnie.
Przykład praktyczny: przyrostowy potok zamówień
Zadanie ETL odczytuje dzienniki zmian bazy danych dla zamówień i pozycji, przechowuje niezmienialne zdarzenia, weryfikuje kolejność i schemat oraz scala je w tabeli faktów hurtowni w ziarnie jednej linii zamówienia. Czas zdarzenia i wersja aktualizacji obsługują opóźnione korekty; deterministyczne klucze zapewniają idempotentne odtwarzanie. Wymiary zachowują wybraną historię klientów i produktów przy użyciu kluczy zastępczych. Liczby wierszy, sumy zamówień, podatki, zwroty i anulacje są rekonsylowane z okresami źródłowymi.
Zmiana łamiącego pola źródłowego zatrzymuje promowanie do zaufanych tabel i powiadamia właścicieli o pochodzeniu downstream. Uzupełnienia są uruchamiane z wersjonowanym kodem w izolacji i porównywane przed atomową zamianą. Polityka dostępu ogranicza identyfikatory klientów, a usunięcie propaguje się do dozwolonych kopii pochodnych. Monitorowanie obejmuje aktualność, wolumen, jakość, koszty i wpływ na pulpit. Testy odzyskiwania odbudowują okres z surowych zdarzeń i przywracają stan orkiestracji. Zielony harmonogram jest niewystarczający, chyba że liczby biznesowe pozostają odtwarzalne i zrekoncyliowane.
Dowody wdrożeniowe i gotowość operacyjna
Decyzja produkcyjna wymaga czegoś więcej niż udanej demonstracji. Zdefiniuj docelowych użytkowników, środowisko operacyjne, wejścia, wyjścia, zależności, właściciela oraz konsekwencje każdego istotnego awarii. Ustal reprodukowalną bazę odniesienia i wersjonowany zestaw ewaluacyjny przed dostrojeniem. Testuj typowe przypadki, warunki brzegowe, nieprawidłowe lub brakujące dane wejściowe, zmianę rozkładu, awarię zależności, niewłaściwe użycie oraz grupy lub środowiska najczęściej niedostatecznie obsługiwane. Mierz jakość zadania wraz z kalibracją lub niepewnością, opóźnieniem, przepustowością, kosztami zasobów, dostępnością, prywatnością i bezpieczeństwem. Rejestruj każdą transformację i próg, aby niezależny recenzent mógł odtworzyć wynik i odróżnić dowód od atrakcyjnego prototypu.
Przed uruchomieniem przydziel uprawnienia do wydania, wyjątków, zmian, wycofania i wycofania. Stosuj etapowe wdrożenie, zachowaj bezpieczną alternatywę i weryfikuj monitorowanie przy celowo wprowadzonych awariach. Telemetria operacyjna powinna ujawniać jakość danych wejściowych, zachowanie wyjść, wersję modelu lub reguły, stan zależności, interwencje ludzkie oraz potwierdzone wyniki, nie gromadząc niepotrzebnych danych wrażliwych. Zdefiniuj progi alertów i właściciela reakcji, a następnie przeglądaj dowody z rzeczywistego środowiska po wdrożeniu, zamiast zakładać, że offline’owa wydajność będzie trwała. Przeglądaj ponownie, gdy zmieniają się źródła danych, użytkownicy, modele, dostawcy, polityki, sprzęt lub cele. Utrzymany system wymaga także udokumentowanego odzyskiwania, nauki z incydentów, procedur usuwania i przechowywania oraz wyraźnego momentu, w którym powinien zostać wyłączony lub zastąpiony.
Najczęściej zadawane pytania
Czy ETL jest przestarzały w platformach danych w chmurze?
Nie. Niektóre platformy preferują ELT, ale obowiązki związane z ekstrakcją, transformacją i ładowaniem nadal istnieją. Zespoły często łączą oba podejścia.
Co sprawia, że potok ETL jest idempotentny?
Może bezpiecznie przetworzyć to samo wejście ponownie, nie tworząc duplikatów ani niespójnego stanu docelowego, zazwyczaj dzięki stabilnym kluczom, punktom kontrolnym i zapisom transakcyjnym.
Podstawowe źródła












