
Podstawy AI
Czym jest KNN (K-Nearest Neighbors)?

 Dodaj Unite.AI do preferowanych źródeł w Google
K-nearest neighbors (KNN) przewiduje wynik na podstawie oznaczonych przykładów treningowych najbliższych punktowi zapytania. W klasyfikacji sąsiedzi głosują na klasę. W regresji ich wartości docelowe są uśredniane lub łącznie w inny sposób.
KNN jest metodą opartą na przykładach, nieogólniającą: dopasowanie polega głównie na przechowywaniu przykładów treningowych oraz opcjonalnego indeksu wyszukiwania. Nie eliminuje to potrzeby podziału na zbiory treningowy, walidacyjny i testowy. Ocena na odrębnych danych jest niezbędna do wyboru k, metryki odległości, przetwarzania cech oraz reguły głosowania.
Kluczowe wnioski
- KNN przewiduje lokalnie; nie dzieli najpierw zbioru danych na klastry.
- Skalowanie cech jest kluczowe, ponieważ odległość określa, które przykłady liczą się jako sąsiedzi.
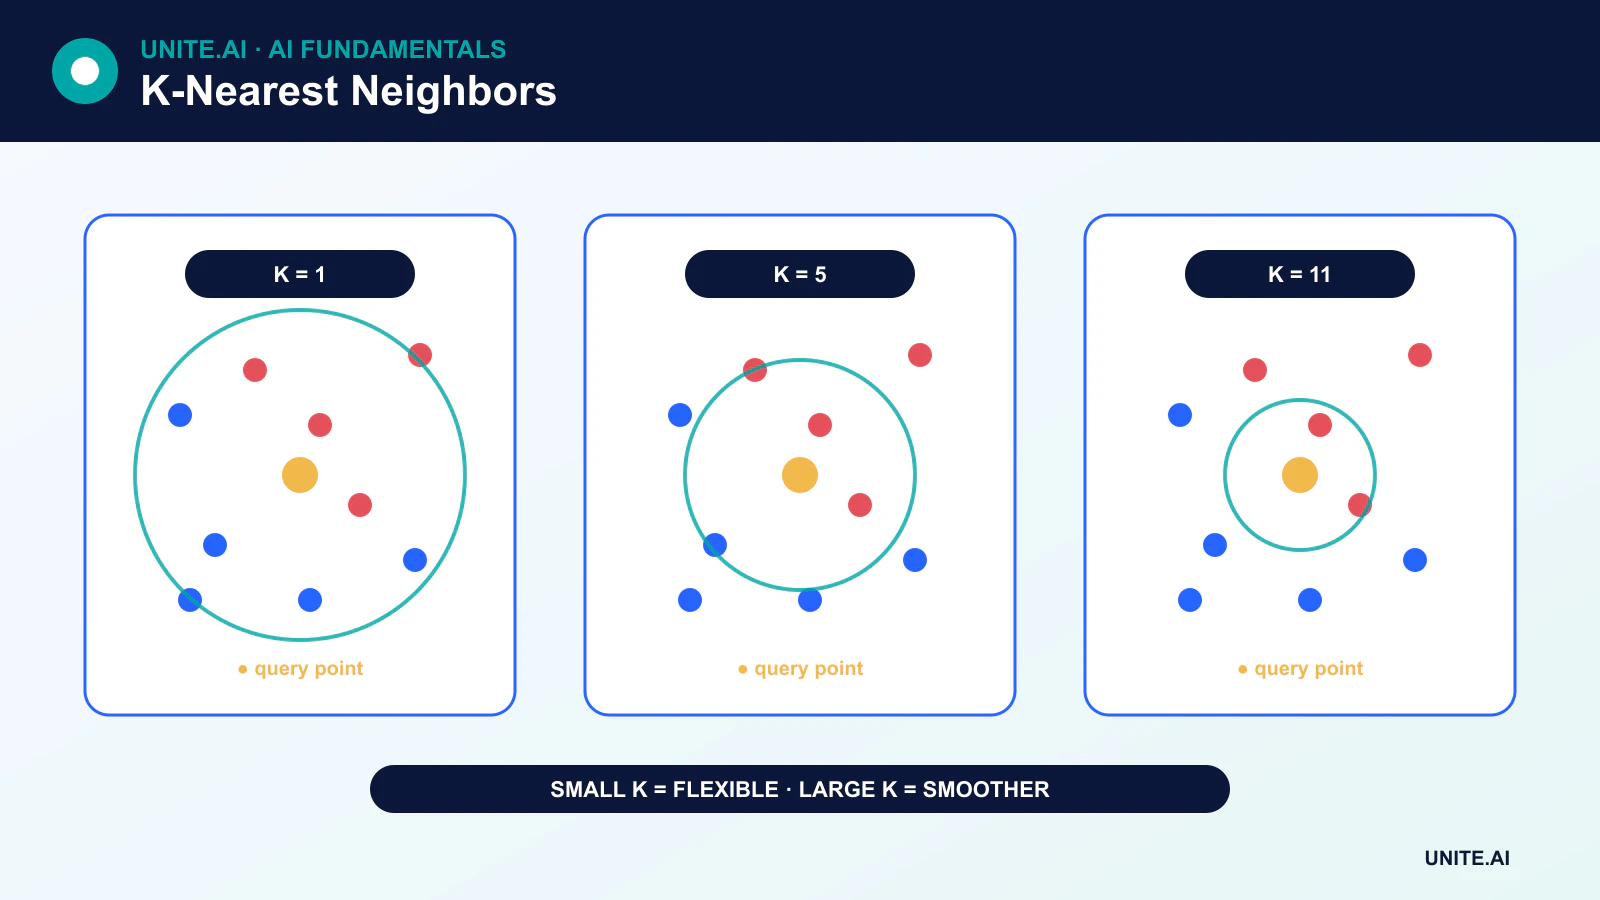
- Małe k może być szumne, podczas gdy duże k może wygładzać lokalną strukturę.
- Wysokie wymiary, nieistotne cechy, niezrównoważone klasy i wolne wyszukiwanie mogą ograniczać wydajność.
Jak działa klasyfikacja KNN
- Przedstaw zapytanie i przykłady treningowe w tej samej przestrzeni cech.
- Oblicz odległość od zapytania do przykładów treningowych.
- Wybierz k najbliższych przykładów.
- Prognozuj klasę większościową lub użyj głosowania ważonego odległością.
Głosowanie ważone przyznaje bliższym sąsiadom większy wpływ. Remis wymaga udokumentowanej reguły, a sąsiedzi o równej odległości z różnymi etykietami mogą sprawić, że wyniki będą zależeć od kolejności lub szczegółów implementacji.
Regresja KNN
W regresji prognoza jest zazwyczaj średnią wartości docelowych sąsiadów. Ważenie odległością może zmniejszyć wpływ dalszych obserwacji. Mediana lub agregacja odporna może być przydatna, gdy lokalne cele zawierają wartości odstające.
Metryki odległości
Odległość euklidesowa jest powszechna dla cech ciągłych, odległość Manhattan sumuje wartości bezwzględne różnic, a odległość kosinusowa koncentruje się na kierunku, a nie na wielkości. Inne metryki stosuje się do danych binarnych, kategorycznych, geograficznych, sekwencyjnych lub wyuczonych osadzeń.
Nazywanie KNN „nieparametrycznym” oznacza, że nie zakłada on stałej, skończenie wymiarowej postaci funkcjonalnej granicy decyzyjnej. Wciąż zakłada, że wybrana reprezentacja i metryka sprawiają, że pobliskie punkty są ze sobą powiązane.
Dlaczego skalowanie ma znaczenie
Jeśli jedna cecha ma zakres od 0 do 1, a inna od 0 do 100 000, zwykła odległość euklidesowa będzie zdominowana przez drugą cechę. Standaryzacja, normalizacja lub transformacje specyficzne dla dziedziny powinny być dopasowane na podziale treningowym i zastosowane do danych walidacyjnych, testowych i produkcyjnych.
Nieistotne cechy również zniekształcają sąsiedztwa. Selekcja cech, redukcja wymiarowości lub wyuczone reprezentacje mogą pomóc, ale każdy wybór musi być zwalidowany bez wycieku danych.
Wybór k
Przy k = 1 model może podążać za szumem i błędnie oznaczonymi przykładami. Wraz ze wzrostem k prognozy stają się bardziej płynne i mniej wrażliwe na pojedynczy punkt. Jeśli k stanie się zbyt duże, odległe klasy lub regiony dominują i model niedopasowuje się.
Wybierz k poprzez walidację krzyżową na danych treningowych. Dla klasyfikacji binarnej nieparzyste k zmniejsza, ale nie eliminuje remisów. Wagi klas, podziały warstwowe, wybór progu i odpowiednie metryki mają znaczenie przy niezrównoważonych klasach.
Klątwa wymiarowości
W przestrzeniach wysokowymiarowych odległości mogą stać się mniej informacyjne, ponieważ przykłady są rzadkie, a najbliższe i najdalsze odległości stają się względnie podobne. KNN może wymagać ogromnych ilości danych, aby utrzymać znaczące lokalne sąsiedztwa. To jest klątwa wymiarowości.
Redukcja wymiarowości lub osadzenia specyficzne dla zadania mogą pomóc, ale geometria osadzenia powinna być zwalidowana pod kątem zamierzonego pojęcia podobieństwa.
Wydajność wyszukiwania
Zapytanie brute-force porównuje nowy punkt ze wszystkimi przechowywanymi przykładami. Drzewa KD i drzewa kuliste przyspieszają niektóre dokładne wyszukiwania, choć ich korzyści maleją w wysokich wymiarach. Przybliżone indeksy najbliższych sąsiadów wymieniają niewielką utratę recallu na duże przyspieszenie i oszczędność pamięci. Ta idea leży również u podstaw wyszukiwania podobieństwa wektorowego.
Mocne i słabe strony
KNN jest prosty, obsługuje nieregularne granice decyzyjne i zapewnia intuicyjne wyjaśnienie oparte na przykładach. Może również wymagać znacznej pamięci, ujawniać wrażliwe przykłady treningowe, prognozować wolno i zachowywać się słabo, gdy odległość nie ma sensu. Jest użyteczną bazą — nie metodą, która domyślnie jest bardzo dokładna w większości problemów.
Odległość, sąsiedztwa i zachowanie hiperparametrów
K-nearest neighbors przechowuje przykłady treningowe i prognozuje na podstawie k najbliższych według wybranej odległości. Klasyfikacja używa głosowania większościowego lub ważonego odległością; regresja uśrednia cele sąsiadów. Skalowanie jest niezbędne, ponieważ cecha o dużym zakresie może zdominować odległość euklidesową. Dane kategoryczne, rzadkie, sekwencyjne lub geograficzne mogą wymagać odległości Hamming, kosinusowej, edycyjnej, wielkiego koła lub wyuczonych. Metryka jest założeniem modelowym dotyczącym podobieństwa i powinna być zwalidowana względem rzeczywistego znaczenia pobliskich przypadków.
Małe k tworzy elastyczne granice o wysokiej wariancji i wrażliwość na szum; duże k wygładza prognozy i może wymazać strukturę mniejszości. Nieparzyste k unika jedynie niektórych remisów w klasyfikacji binarnej i nie jest regułą ogólną. Wybieraj k, odległość, ważenie, zestaw cech i przetwarzanie w ramach walidacji krzyżowej. Niezrównoważone klasy mogą sprawić, że lokalne głosowanie większościowe ignoruje rzadkie wyniki, więc należy sprawdzać recall per klasa i skład sąsiedztwa. Odległości w wysokich wymiarach mają tendencję do koncentracji, a nieistotne cechy pogarszają sąsiedztwa; selekcja, redukcja wymiarowości lub wyuczone osadzenia mogą pomóc.
Indeksowanie, niepewność i operacje produkcyjne
Naiwna inferencja porównuje zapytanie ze wszystkimi punktami treningowymi. Drzewa KD i drzewa kuliste pomagają w odpowiednich niskich wymiarach; przybliżone indeksy najbliższych sąsiadów wymieniają dokładność na szybkość i skalowalność. Mierz recall wyszukiwania sąsiadów oddzielnie od jakości predykcji. Pamięć obejmuje przechowywane cechy, etykiety i struktury indeksu. Aktualizacje są koncepcyjnie proste, ale mogą wymagać przebudowy indeksu, spójności wersji i propagacji usunięć. Chroń wrażliwe przykłady treningowe, ponieważ zwracanie sąsiadów lub odległości może ujawniać rekordy.
KNN może wyświetlać przykłady, które czynią prognozę zrozumiałą, ale bliskość nie jest przyczyną ani sprawiedliwością. Dostarczaj odległość, margines głosowania i regułę abstynencji, gdy sąsiedztwa są rzadkie lub sprzeczne. Monitoruj odległość zapytania, etykiety sąsiadów, dryf cech, opóźnienia i potwierdzone wyniki. Utrzymuj synchronizację wersji przetwarzania wstępnego i indeksu oraz testuj wyniki dokładne vs przybliżone po zmianach. KNN jest skuteczną lokalną bazą i metodą wyszukiwania, gdy odległość ma sens; ma trudności, gdy podobieństwo nie może być odzwierciedlone przez dostępne cechy.
Przykładowe zastosowanie: KNN do substytucji produktów
Sprzedawca reprezentuje produkty przy użyciu ustandaryzowanych atrybutów numerycznych, kompatybilności kategorycznej oraz wyuczonego osadzenia tekstowego, a następnie definiuje ważoną odległość ocenianą przez merchandiserów. K i wagi są wybierane na podstawie późniejszych premier produktów, a nie losowych wierszy. Ocena sprawdza odpowiedni recall substytutów, niekompatybilne rekomendacje, odległość, pokrycie kategorii i wyniki dla rzadkich produktów. Podstawą popularności pokazuje, czy lokalne podobieństwo dodaje wartości.
Przybliżony indeks jest benchmarkowany w stosunku do dokładnych sąsiadów pod kątem recallu i opóźnień. Zapytania bez bliskiego kompatybilnego elementu nie zwracają sugestii, zamiast wymuszonego sąsiada. Usunięcia produktów i korekty atrybutów propagują się do indeksu poprzez wersjonowane aktualizacje. Monitoring śledzi rozkłady odległości, puste wyniki, nadpisania i wyniki komercyjne, nie myląc sprzedaży z rzeczywistą kompatybilnością. Wrażliwe warunki dostawcy są wykluczone z wyjaśnień, a zwrócone przykłady pozostają dowodem podobieństwa — nie twierdzeniem, że produkty są równoważne.
Dowody implementacji i gotowość operacyjna
Decyzja produkcyjna wymaga więcej niż udanej demonstracji. Zdefiniuj docelowych użytkowników, środowisko operacyjne, wejścia, wyjścia, zależności, właściciela oraz konsekwencje każdego istotnego błędu. Ustal powtarzalną bazę i wersjonowany zestaw ewaluacyjny przed strojeniem. Testuj typowe przypadki, warunki brzegowe, niepoprawne lub brakujące dane wejściowe, przesunięcie rozkładu, awarie zależności, niewłaściwe użycie oraz grupy lub środowiska najprawdopodobniej niedoszacowane. Mierz jakość zadania wraz z kalibracją lub niepewnością, opóźnieniem, przepustowością, kosztami zasobów, dostępnością, prywatnością i bezpieczeństwem. Rejestruj każdą transformację i próg, aby niezależny recenzent mógł odtworzyć wynik i odróżnić dowody od atrakcyjnego prototypu.
Przed uruchomieniem przydziel uprawnienia do wydania, wyjątków, zmian, wycofania i wycofania. Użyj stopniowanego wdrożenia, zachowaj bezpieczną alternatywę i zweryfikuj monitoring przy celowo wprowadzonych awariach. Telemetria operacyjna powinna ujawniać jakość danych wejściowych, zachowanie wyjścia, wersję modelu lub reguły, stan zależności, interwencje ludzkie i potwierdzone wyniki bez zbierania niepotrzebnych wrażliwych danych. Zdefiniuj progi alarmowe i właściciela reakcji, a następnie przeglądaj dowody z rzeczywistego świata po wdrożeniu, zamiast zakładać, że offline’owa wydajność utrzyma się. Przeprowadzaj ponowną ocenę, gdy zmieniają się źródła danych, użytkownicy, modele, dostawcy, polityki, sprzęt lub cele. Utrzymany system wymaga także udokumentowanego odzyskiwania, nauki z incydentów, procedur usuwania i przechowywania oraz wyraźnego punktu, w którym powinien zostać wyłączony lub zastąpiony.
Najczęściej zadawane pytania
Czy KNN ma fazę treningu?
Ma niewiele dopasowywania parametrów, ale nadal posiada proces rozwoju: przetwarzanie wstępne jest uczone na danych treningowych, może być budowany indeks, a k, metryka, wagi i cechy są wybierane przy walidacji.
Czy KNN jest tym samym co K-means?
Nie. KNN jest przede wszystkim metodą nadzorowanego prognozowania lokalnego. K-means jest algorytmem nienadzorowanego grupowania, w którym K jest liczbą centrów klastrów.
Podstawowe źródła












