
Podstawy AI
Czym jest twierdzenie Bayesa?

 Dodaj Unite.AI do preferowanych źródeł w Google
Twierdzenie Bayesa opisuje, jak aktualizować prawdopodobieństwo hipotezy po zaobserwowaniu dowodu. Łączy ono prawdopodobieństwo dowodu przy założeniu hipotezy z prawdopodobieństwem hipotezy przy danym dowodzie.
To rozróżnienie jest kluczowe w rozumowaniu statystycznym i uczeniu maszynowym. Test może być bardzo dokładny, gdy schorzenie jest obecne, podczas gdy dodatni wynik nadal ma umiarkowane prawdopodobieństwo wskazania schorzenia, jeśli jest ono rzadkie.
Kluczowe wnioski
- Posterior łączy wiarę a priori z prawdopodobieństwem obserwowanego dowodu.
- Czynnik dowodu normalizuje możliwe hipotezy.
- Częstość bazowa może przeważać nad pozornie silnym dowodem.
- Naiwny Bayes zakłada, że cechy są warunkowo niezależne przy danej klasie, a nie niezależne w każdych okolicznościach.
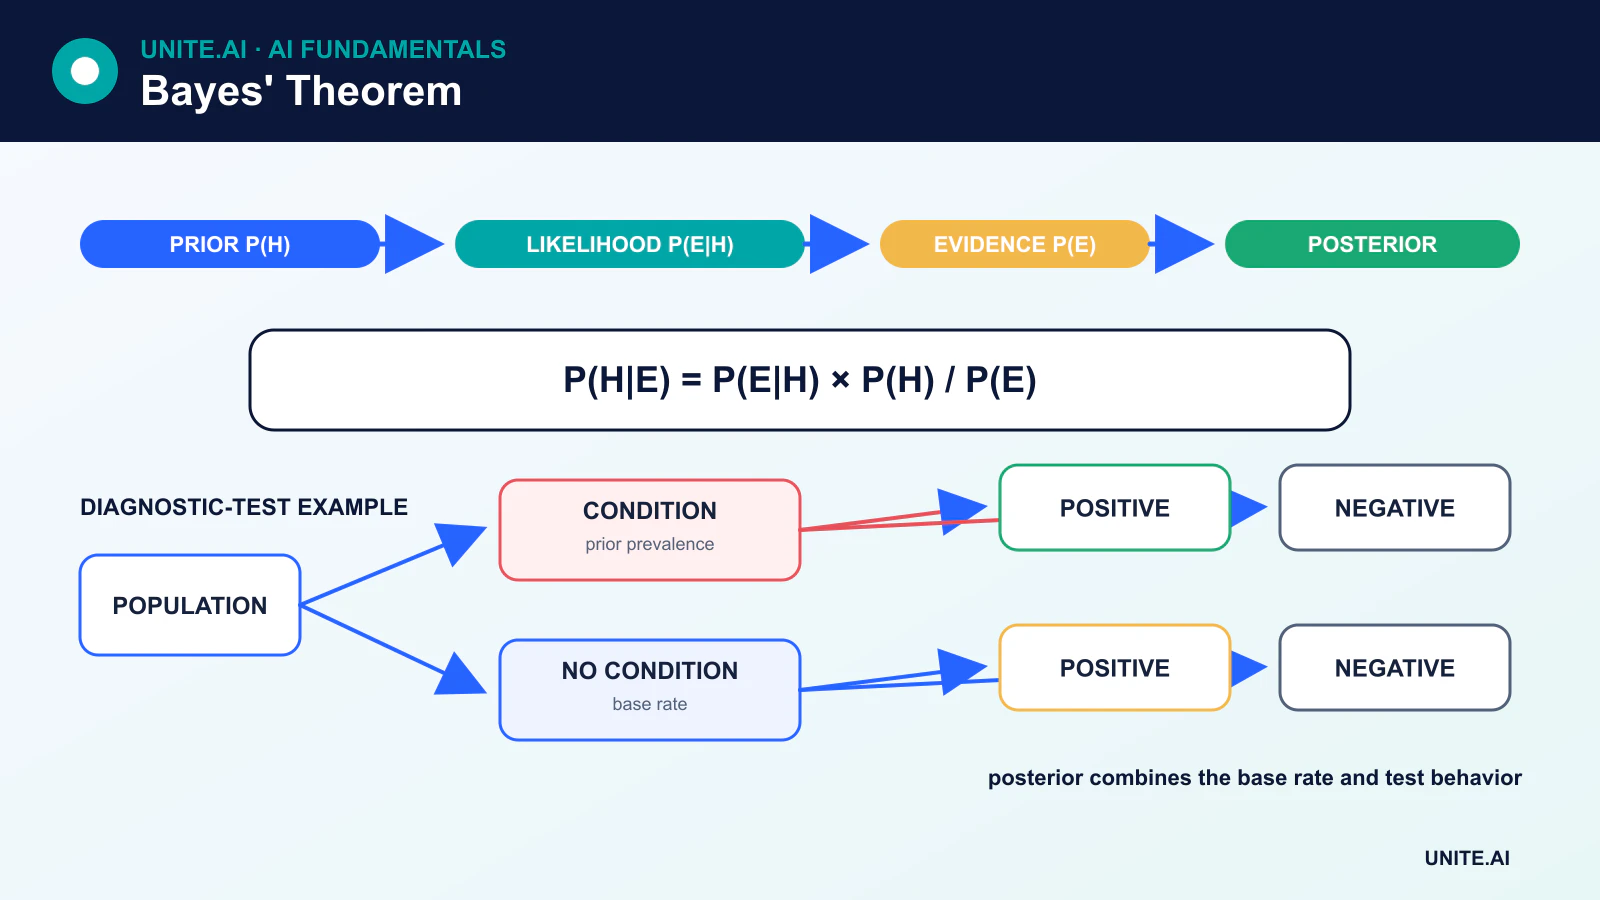
Wzór
P(A|B) = P(B|A)P(A) / P(B)
- P(A) jest prawdopodobieństwem a priori hipotezy A.
- P(B|A) jest prawdopodobieństwem (likelihood) obserwacji dowodu B, jeśli A jest prawdziwe.
- P(B) jest ogólnym prawdopodobieństwem dowodu.
- P(A|B) jest prawdopodobieństwem posterior hipotezy A po obserwacji B.
Twierdzenie wynika z dwóch równoważnych wyrażeń dla prawdopodobieństwa łącznego: P(A ∩ B) = P(B|A)P(A) i P(A ∩ B) = P(A|B)P(B).
Przykład liczbowy z częstotliwością bazową
Załóżmy, że schorzenie dotyczy 1 % populacji. Test ma 90 % czułość i 5 % wskaźnik fałszywie dodatnich. Rozważmy 1 000 osób:
- Około 10 osób ma schorzenie; test prawidłowo wykrywa 9.
- Około 990 nie ma schorzenia; przy 5 % wskaźniku fałszywie dodatnich zostaje wykrytych około 50.
- W sumie otrzymujemy około 59 wyników dodatnich, z czego 9 to prawdziwe pozytywy.
Prawdopodobieństwo schorzenia po dodatnim wyniku wynosi około 9 / 59 ≈ 15%, a nie 90 %. Czułość testu odpowiada P(positive | condition); użytkownik zazwyczaj chce znać P(condition | positive). Twierdzenie Bayesa łączy je, wykorzystując częstotliwość bazową.
Aktualizacja bayesowska
W miarę pojawiania się nowych dowodów, posterior może stać się prior dla kolejnej aktualizacji. Kompletny model bayesowski określa możliwe hipotezy, rozkłady a priori, funkcję prawdopodobieństwa oraz wielkość do oszacowania. Niepewność jest reprezentowana rozkładem posterior, a nie jedynie pojedynczą estymacją punktową.
Prior powinien być udokumentowany i poddany analizie wrażliwości. Słabo informacyjny prior może regulować nielogiczne wartości, podczas gdy źle dobrany silny prior może zdominować ograniczone dane.
Klasyfikatory Naive Bayes
Naive Bayes przewiduje klasę y na podstawie cech x₁ … xₙ wykorzystując twierdzenie Bayesa i założenie:
P(x₁, …, xₙ | y) = Π P(xᵢ | y)
Zakłada się, że cechy są warunkowo niezależne po znanej klasie. Jest to często nierealistyczne, jednak klasyfikator może działać dobrze, gdy uzyskane oceny klas są nadal użyteczne.
Popularne warianty
- Multinomial Naive Bayes modeluje cechy typu liczbowego i jest powszechny w klasyfikacji dokumentów.
- Bernoulli Naive Bayes modeluje obecność cech binarnych.
- Gaussian Naive Bayes modeluje każdą ciągłą cechę przy użyciu rozkładu Gaussa warunkowego od klasy.
- Categorical Naive Bayes modeluje dyskretne kategorie.
Wygładzanie i stabilność numeryczna
Jeśli wartość cechy nigdy nie występuje z daną klasą w danych treningowych, nie wygładzona estymacja prawdopodobieństwa może przyjąć wartość zero i wyeliminować cały iloczyn. Wygładzanie addytywne lub w stylu Laplace’a zapobiega temu. Implementacje obliczają logarytmy prawdopodobieństw, więc mnożenie wielu małych wartości zamienia się na dodawanie stabilnych wartości logarytmicznych.
Prawdopodobieństwa, oceny i kalibracja
Wyjścia prawdopodobieństw Naive Bayes mogą być słabo skalibrowane, ponieważ skorelowane cechy są efektywnie liczone wielokrotnie. Klasyfikator może dobrze porządkować klasy, jednocześnie zawyżając pewność. Kalibrację należy oceniać na danych odłożonych, gdy prawdopodobieństwa wpływają na decyzje.
Bayes poza Naive Bayes
Inferencja bayesowska obsługuje modele hierarchiczne, testy A/B, szacowanie parametrów naukowych, prognozowanie, podejmowanie decyzji z uwzględnieniem niepewności oraz probabilistyczne modele graficzne. Metody przybliżone, takie jak łańcuch Markowa Monte Carlo i inferencja wariacyjna, są używane, gdy posterior nie może być wyliczony w postaci zamkniętej.
Typowe błędy rozumowania
- Mylenie
P(A|B)zP(B|A). - Ignorowanie rzadkiej lub powszechnej częstotliwości bazowej.
- Traktowanie prior jako obiektywnego lub pozostawianie go nieudokumentowanego.
- Zakładanie, że wysokie prawdopodobieństwo (likelihood) automatycznie oznacza wysoki posterior.
- Interpretowanie związku predykcyjnego jako przyczynowego.
Prawdopodobieństwo warunkowe, stosunek szans i dowód
Twierdzenie Bayesa wiąże prawdopodobieństwo hipotezy po dowodzie z jej prawdopodobieństwem a priori, prawdopodobieństwem obserwacji tego dowodu przy hipotezie oraz całkowitym prawdopodobieństwem dowodu. W formie ilorazu szans, szanse posterior równe są szansom prior pomnożonym przez iloraz prawdopodobieństwa. To oddziela to, co wierzono przed testem, od tego, jak silnie test odróżnia hipotezy. Test wydający się bardzo dokładny może nadal generować wiele wyników fałszywie dodatnich, gdy schorzenie jest rzadkie, ponieważ częstotliwość bazowa wpływa na posterior.
Likelihood jest funkcją hipotezy dla stałych zaobserwowanych danych i nie powinno się go mylić z prawdopodobieństwem hipotezy. Normalizacja dowodu sumuje lub całkuje po konkurujących hipotezach. Założenia warunkowej niezależności mogą uprościć obliczenia, jak w Naive Bayes, ale muszą być sprawdzone pod kątem konsekwencji. Wielokrotne elementy dowodu nie mogą być mnożone jako niezależne, gdy dzielą przyczyny lub powielają informacje. Kierunek przyczynowy również ma znaczenie: P(evidence|hypothesis) nie jest zazwyczaj równe P(hypothesis|evidence), co jest klasycznym błędem odwrotnego prawdopodobieństwa.
Wybory modelowania, obliczenia i zastosowanie w decyzjach
Analiza bayesowska określa prior, likelihood i rozkład predykcyjny posterior. Priory mogą kodować ustaloną wiedzę, regulować małe próbki lub być słabo informacyjne; powinny być uzasadnione i przetestowane poprzez analizę wrażliwości. Modele sprzężone dają analityczne aktualizacje, podczas gdy łańcuchy Markowa Monte Carlo, inferencja wariacyjna i metody sekwencyjne przybliżają złożone posteriory. Należy diagnozować zbieżność, efektywną wielkość próbki, błąd przybliżenia oraz prawdopodobieństwo prior predykcyjnego, zamiast podawać jedynie liczbę posterior bez kontroli obliczeniowych.
Prawdopodobieństwo posterior informuje, ale samo nie wybiera działania. Decyzje wymagają określenia strat, korzyści, ograniczeń i dostępnych alternatyw. Modele probabilistyczne należy oceniać pod kątem kalibracji, prawidłowych reguł punktacji oraz kontroli predykcyjnych posterior na nowych danych. Aktualizować należy tylko przy dowodach zebranych w ramach modelowanego procesu; bias wyboru i przesunięcie danych mogą unieważnić likelihood. Należy komunikować przedziały wiarygodności i założenia, nie traktując ich jako gwarantowanych zakresów częstotliwości. Twierdzenie Bayesa jest dokładną algebrą prawdopodobieństwa, podczas gdy jakość wniosku bayesowskiego zależy od modelu i dostarczonych dowodów.
Przykład praktyczny: interpretacja testu diagnostycznego
Test ma 95 % czułość i 90 % swoistość, ale schorzenie dotyczy tylko 1 % badanej populacji. Dla 10 000 osób oczekuje się około 95 prawdziwych pozytywów i 990 fałszywie dodatnich, co daje wartość predykcyjną dodatnią poniżej 9 %. Twierdzenie Bayesa uwidacznia efekt częstotliwości bazowej. Obliczenie określa populację, próg testu i niepewność, zamiast reklamować czułość jako szansę, że dodatni wynik jest prawidłowy. To rozróżnienie jest również podstawą starannej nauki o danych.
Klinicyści aktualizują prawdopodobieństwo dodatkowymi dowodami tylko wtedy, gdy zależność między testami jest modelowana. Próg decyzyjny uwzględnia szkodę z przeoczenia choroby, ryzyko testu potwierdzającego, koszt i preferencje pacjenta. Kalibrację sprawdza się w lokalnej populacji, a zmiany częstości występowania wyzwalają przegląd. Posterior wspiera dyskusję i kolejne kroki; nie zastępuje diagnozy potwierdzającej. Raportowanie używa naturalnych częstotliwości i analizy wrażliwości, aby pacjenci i praktycy mogli zobaczyć, jak wniosek zmienia się przy realistycznych założeniach.
Dowody implementacji i gotowość operacyjna
Decyzja produkcyjna wymaga więcej niż udany pokaz. Należy określić docelowych użytkowników, środowisko operacyjne, wejścia, wyjścia, zależności, właściciela oraz konsekwencje każdego istotnego błędu. Należy ustanowić odtwarzalną bazę odniesienia i wersjonowany zestaw oceny przed strojeniem. Testować należy typowe przypadki, warunki brzegowe, nieprawidłowe lub brakujące wejścia, przesunięcie rozkładu, awarię zależności, niewłaściwe użycie oraz grupy lub środowiska najczęściej niedostatecznie obsługiwane. Mierzyć jakość zadania wraz z kalibracją lub niepewnością, opóźnieniem, przepustowością, kosztami zasobów, dostępnością, prywatnością i bezpieczeństwem. Rejestrować każdą transformację i próg, aby niezależny recenzent mógł odtworzyć wynik i odróżnić dowód od atrakcyjnego prototypu.
Przed uruchomieniem przydzielić odpowiedzialność za wydanie, wyjątki, zmiany, wycofanie i wycofanie wersji. Stosować etapowe wdrożenie, zachować bezpieczny fallback i weryfikować monitorowanie poprzez celowo wprowadzane awarie. Telemetria operacyjna powinna ujawniać jakość wejścia, zachowanie wyjścia, wersję modelu lub reguły, stan zależności, interwencje ludzkie i potwierdzone wyniki, bez zbierania niepotrzebnych wrażliwych danych. Definiować progi alarmowe i właściciela reakcji, a następnie przeglądać dowody z rzeczywistego świata po wdrożeniu, zamiast zakładać, że offline’owa wydajność utrzyma się. Ponownie oceniać przy zmianie źródeł danych, użytkowników, modeli, dostawców, polityk, sprzętu lub celów. Utrzymany system wymaga także udokumentowanej procedury odzyskiwania, nauki z incydentów, usuwania i przechowywania oraz jasnego punktu, w którym powinien zostać wyłączony lub zastąpiony.
Najczęściej zadawane pytania
Jaka jest różnica między likelihood a prawdopodobieństwem?
Przy stałych parametrach model przypisuje prawdopodobieństwo możliwym danym. Przy stałych obserwowanych danych to samo wyrażenie może być traktowane jako funkcja likelihood względem możliwych wartości parametrów. Wzór liczbowy może być taki sam, ale interpretacja się różni.
Czy Naive Bayes jest pełną inferencją bayesowską?
Wykorzystuje twierdzenie Bayesa do klasyfikacji w ramach silnego modelu warunkowej niezależności. Szersza inferencja bayesowska umieszcza rozkłady nad nieznanymi wielkościami i rozumuje przy użyciu rozkładu posterior.
Podstawowe źródła












