
सर्वश्रेष्ठ
10 सर्वश्रेष्ठ मशीन लर्निंग अल्गोरिदम

 Unite.AI को Google पर अपने पसंदीदा स्रोतों में जोड़ें
मुख्य बिंदुट्रांसफॉर्मर्स ने RNNs के विपरीत समानांतर प्रसंस्करण और स्थायी स्मृति को सक्षम करके NLP…
और देखें
- ट्रांसफॉर्मर्स ने RNNs के विपरीत समानांतर प्रसंस्करण और स्थायी स्मृति को सक्षम करके NLP में क्रांति ला दी।
- GANs डिस्क्रिमिनेटर की त्रुटि प्रतिक्रिया को रोककर जनरेटरों को विविध समाधान तलाशने के लिए मजबूर करते हैं।
- का K-निकटतम पड़ोसी एल्गोरिदम कर्मचारी पलायन भविष्यवाणी में आधुनिक एल्गोरिदम से अभी भी बेहतर प्रदर्शन करता है।
हम जीपीयू-एक्सेलरेटेड मशीन लर्निंग में असाधारण नवाचार के समय से गुजर रहे हैं, लेकिन नवीनतम शोध पत्रों में अक्सर ऐसे अल्गोरिदम शामिल होते हैं जो दशकों पुराने हैं, और कुछ मामलों में 70 वर्ष पुराने हैं।
कुछ लोग तर्क दे सकते हैं कि इनमें से कई पुराने तरीके ‘सांख्यिकीय विश्लेषण’ के शिविर में आते हैं और मशीन लर्निंग क्षेत्र की शुरुआत को 1957 तक ही सीमित करते हैं, जब परसेप्ट्रॉन का आविष्कार हुआ था।
इन पुराने एल्गोरिदम का नवीनतम मशीन लर्निंग रुझानों और सुर्खियाँ बटोरने वाले विकासों से गहरा संबंध है और वे उन्हें आधार प्रदान करते हैं। इसलिए यह मत विवादास्पद है। आइए नवीनतम नवाचारों की कुछ ‘क्लासिक’ बुनियादी इकाइयों और AI के प्रमुख योगदानों में जगह बनाने वाले नए एल्गोरिदम को देखें।
1: ट्रांसफॉर्मर
2017 में, गूगल रिसर्च ने एक शोध सहयोग का नेतृत्व किया जिसका परिणाम पेपर एटेंशन इज ऑल यू नीड था। इस काम ने एक नए आर्किटेक्चर को रेखांकित किया जिसने एटेंशन मैकेनिज्म को एन्कोडर/डीकोडर और रिकरेंट नेटवर्क मॉडल्स में सहायक घटक की भूमिका से स्वतंत्र केंद्रीय परिवर्तनकारी तकनीक के रूप में बढ़ावा दिया।
इस दृष्टिकोण को ट्रांसफॉर्मर नाम दिया गया था, और यह प्राकृतिक भाषा प्रसंस्करण (एनएलपी) में एक क्रांतिकारी विधि बन गई है, जो ऑटोरेग्रेसिव लैंग्वेज मॉडल और एआई के प्रतीक जीपीटी-3 सहित कई अन्य उदाहरणों को संचालित करती है।

ट्रांसफॉर्मर ने अनुक्रम रूपांतरण की समस्या को सुरुचिपूर्ण ढंग से हल किया, जिसे ‘परिवर्तन’ भी कहा जाता है, जो इनपुट अनुक्रमों को आउटपुट अनुक्रमों में संसाधित करने से संबंधित है। एक ट्रांसफॉर्मर भी निरंतर तरीके से डेटा प्राप्त करता है और प्रबंधित करता है, न कि अनुक्रमिक बैचों में, जिससे ऐसी ‘स्मृति की निरंतरता’ संभव होती है जिसे प्राप्त करने के लिए RNN आर्किटेक्चर बनाए नहीं गए हैं। ट्रांसफॉर्मर की विस्तृत जानकारी के लिए हमारा संदर्भ लेख देखें।
इसके विपरीत, रिकरेंट न्यूरल नेटवर्क (आरएनएन), जो CUDA युग में मशीन लर्निंग शोध पर हावी होने लगे थे, ट्रांसफॉर्मर आर्किटेक्चर को आसानी से समानांतर किया जा सकता था, जो एक बड़े डेटा सेट को संबोधित करने के लिए एक मार्ग खोलता है।
लोकप्रिय उपयोग
ट्रांसफॉर्मर ने 2020 में ओपनएआई के जीपीटी-3 की रिलीज़ के साथ सार्वजनिक कल्पना पर कब्जा कर लिया, जिसमें एक रिकॉर्ड तोड़ने वाले 175 बिलियन पैरामीटर थे। यह कथित तौर पर आश्चर्यजनक उपलब्धि बाद के परियोजनाओं द्वारा ओवरशैडो की गई थी, जैसे कि 2021 में माइक्रोसॉफ्ट की मेगाट्रॉन-ट्यूरिंग एनएलजी 530बी की रिलीज़, जिसमें 530 बिलियन पैरामीटर से अधिक हैं।

हाइपरस्केल ट्रांसफॉर्मर एनएलपी परियोजनाओं की एक समयरेखा. स्रोत: माइक्रोसॉफ्ट
ट्रांसफॉर्मर आर्किटेक्चर ने एनएलपी से कंप्यूटर विजन में भी प्रवेश किया है, जो इमेज सिंथेसिस फ्रेमवर्क की नई पीढ़ी को संचालित करता है, जैसे ओपनएआई के सीएलआईपी और डैल-ई, जो पाठ>इमेज डोमेन मैपिंग का उपयोग करके अधूरी छवियों को पूरा करने और प्रशिक्षित डोमेन से नए छवियों को सिंथेसाइज करने के लिए उपयोग किया जाता है।
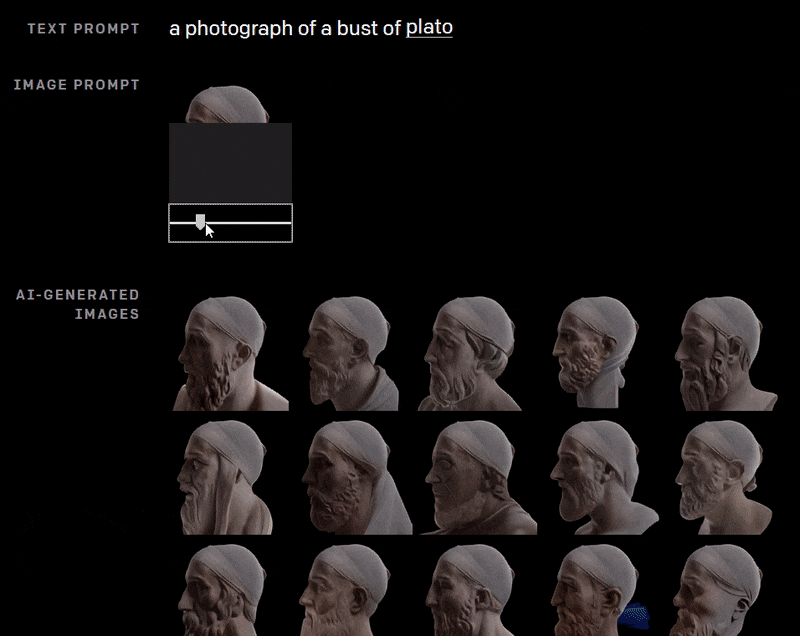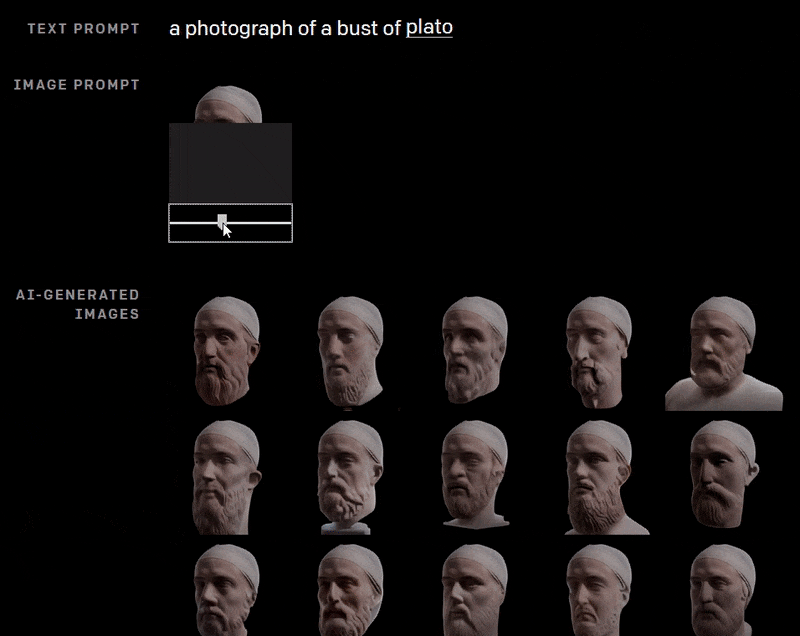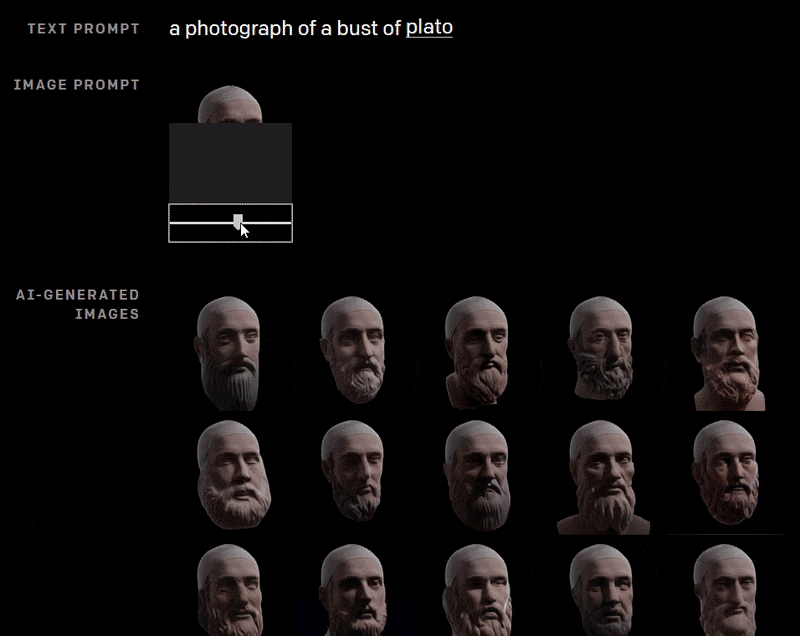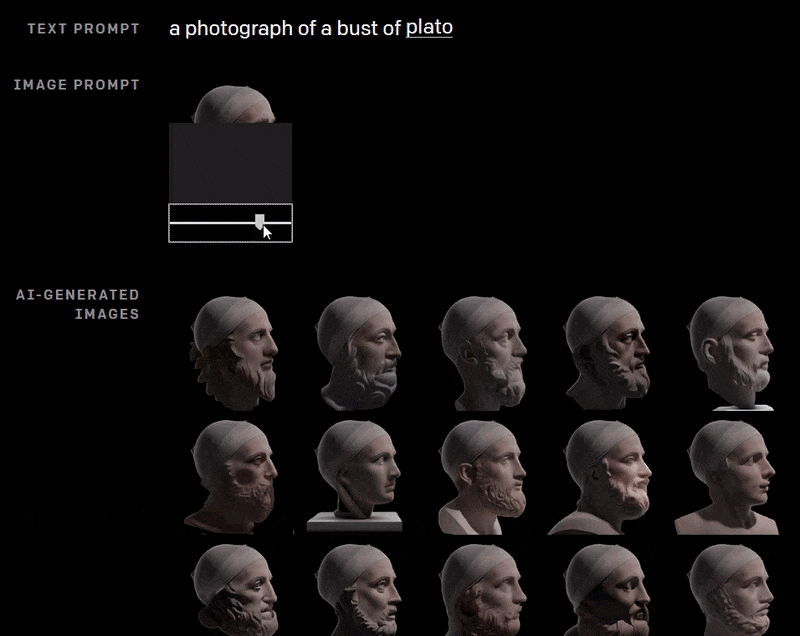
डैल-ई प्लेटो की आवक्ष प्रतिमा की एक अधूरी छवि को पूरा करने का प्रयास करता है。 स्रोत: https://openai.com/blog/dall-e/
2: जेनरेटिव एडवर्सेरियल नेटवर्क (जीएएन)
हालांकि ट्रांसफॉर्मर ने जीपीटी-3 की रिलीज़ के साथ असाधारण मीडिया कवरेज प्राप्त की है, जेनरेटिव एडवर्सेरियल नेटवर्क (जीएएन) अपने आप में एक प्रतिष्ठित ब्रांड बन गया है, और अंततः डीपफेक के साथ एक क्रिया बन सकता है।
जीएएन को 2014 में पहली बार प्रस्तावित किया गया था और मुख्य रूप से इमेज सिंथेसिस के लिए उपयोग किया जाता है, एक जेनरेटिव एडवर्सेरियल नेटवर्क आर्किटेक्चर एक जेनरेटर और एक डिस्क्रिमिनेटर से बना होता है। जेनरेटर डेटासेट में हजारों छवियों के माध्यम से चक्र चलाता है, बार-बार उन्हें पुनर्निर्मित करने की कोशिश करता है। हर प्रयास पर डिस्क्रिमिनेटर उसके काम का मूल्यांकन कर उसे बेहतर करने के लिए वापस भेजता है, लेकिन यह नहीं बताता कि पिछला पुनर्निर्माण कहाँ गलत था।

स्रोत: https://developers.google.com/machine-learning/gan/gan_structure
यह जेनरेटर को कई मार्गों का अन्वेषण करने के लिए मजबूर करता है, इसके बजाय कि डिस्क्रिमिनेटर ने उसे बताया कि वह गलत कहां था (नीचे #8 देखें)। प्रशिक्षण के अंत तक, जेनरेटर के पास डेटासेट में बिंदुओं के बीच संबंधों का एक विस्तृत और व्यापक मानचित्र होता है।
शोधपत्र Improving GAN Equilibrium by Raising Spatial Awareness से: एक नया फ्रेमवर्क GAN के कभी-कभी रहस्यमय गुप्त स्थान में घूमते हुए छवि संश्लेषण आर्किटेक्चर को तुरंत प्रतिक्रिया देने वाले ढंग से नियंत्रित करने का माध्यम प्रदान करता है। स्रोत: https://genforce.github.io/eqgan/
इसकी तुलना लंदन के केंद्र तक जाने वाले एक उबाऊ दैनिक रास्ते को सीखने और टैक्सी चालकों से अपेक्षित विस्तृत सड़क-ज्ञान, The Knowledge, को मेहनत से हासिल करने के अंतर से की जा सकती है।
परिणामस्वरूप प्रशिक्षित मॉडल के गुप्त स्थान में उच्च-स्तरीय विशेषताओं का एक संग्रह मिलता है। किसी उच्च-स्तरीय विशेषता का अर्थसूचक संकेत ‘व्यक्ति’ हो सकता है। उससे संबंधित अधिक विशिष्ट स्तरों पर जाने से ‘पुरुष’ और ‘महिला’ जैसी अन्य सीखी हुई विशेषताएँ मिल सकती हैं। निचले स्तरों पर उपविशेषताएँ ‘सुनहरे बाल’, ‘श्वेत’ आदि में विभाजित हो सकती हैं।
GAN और एन्कोडर/डीकोडर फ्रेमवर्क के गुप्त स्थान में विशेषताओं का उलझाव एक उल्लेखनीय समस्या है: क्या GAN द्वारा बनाए गए महिला के चेहरे की मुस्कान उसकी ‘पहचान’ से उलझी हुई विशेषता है, या एक समानांतर शाखा?

thispersondoesnotexist से GAN द्वारा बनाए गए चेहरे। स्रोत: https://this-person-does-not-exist.com/en
पिछले दो वर्षों में इस दिशा में नए शोध प्रयास बढ़े हैं। इससे GAN के गुप्त स्थान में Photoshop की तरह विशेषता-स्तरीय संपादन का रास्ता खुल सकता है, लेकिन अभी कई रूपांतरण व्यावहारिक रूप से ‘सब कुछ या कुछ भी नहीं’ वाले पैकेज हैं। विशेष रूप से, NVIDIA द्वारा 2021 के अंत में जारी EditGAN अर्थगत विभाजन मास्क इस्तेमाल करके गुप्त स्थान में उच्च व्याख्येयता प्राप्त करता है।
लोकप्रिय उपयोग
लोकप्रिय डीपफेक वीडियो में वास्तव में काफी सीमित योगदान के अलावा, पिछले चार वर्षों में छवि और वीडियो-केंद्रित GAN तेजी से फैले हैं और शोधकर्ताओं तथा आम लोगों दोनों को आकर्षित किया है। नई रिलीज़ की चकित कर देने वाली गति और आवृत्ति के साथ बने रहना कठिन है, हालांकि GitHub रिपॉजिटरी Awesome GAN Applications एक व्यापक सूची देने का प्रयास करती है।
जीएएन का उपयोग किसी भी अच्छी तरह से फ्रेम किए गए डोमेन से विशेषताओं को प्राप्त करने के लिए सिद्धांत रूप में किया जा सकता है, पाठ सहित।
3: एसवीएम
1963 में उत्पन्न, सपोर्ट वेक्टर मशीन (एसवीएम) एक मूल अल्गोरिदम है जो नए शोध में बार-बार दिखाई देता है। एसवीएम के तहत, वेक्टर डेटासेट में डेटा बिंदुओं के सापेक्ष विन्यास को मैप करते हैं, जबकि सपोर्ट वेक्टर विभिन्न समूहों, विशेषताओं या विशेषताओं के बीच सीमाओं को परिभाषित करते हैं।

सपोर्ट वेक्टर समूहों के बीच सीमाएं परिभाषित करते हैं। स्रोत: https://www.kdnuggets.com/2016/07/support-vector-machines-simple-explanation.html
व्युत्पन्न सीमा को हाइपरप्लेन कहा जाता है।
निम्न स्तर की विशेषताओं पर, एसवीएम दो-आयामी (ऊपर की छवि) है, लेकिन जहां पहचाने गए समूहों या प्रकारों की संख्या अधिक है, यह त्रि-आयामी बन जाता है।

एक गहरी श्रृंखला के बिंदुओं और समूहों के लिए एसवीएम को त्रि-आयामी बनाने की आवश्यकता है। स्रोत: https://cml.rhul.ac.uk/svm.html
लोकप्रिय उपयोग
चूंकि सपोर्ट वेक्टर मशीनें विभिन्न प्रकार के उच्च-आयामी डेटा को प्रभावी ढंग से और तटस्थ रूप से संबोधित कर सकती हैं, वे विभिन्न मशीन लर्निंग क्षेत्रों में व्यापक रूप से दिखाई देती हैं, जिनमें डीपफेक डिटेक्शन, इमेज क्लासिफिकेशन, नफरत भरा भाषण वर्गीकरण, डीएनए विश्लेषण और जनसंख्या संरचना भविष्यवाणी शामिल हैं, साथ ही कई अन्य।
4: के-मीन्स क्लस्टरिंग
क्लस्टरिंग आमतौर पर एक बिना पर्यवेक्षण के शिक्षण दृष्टिकोण है जो घनत्व अनुमान के माध्यम से डेटा बिंदुओं को श्रेणीबद्ध करने का प्रयास करता है, जो अध्ययन किए जा रहे डेटा के वितरण का एक मानचित्र बनाता है।

के-मीन्स क्लस्टरिंग डेटा में खंड, समूह और समुदायों को निर्धारित करता है। स्रोत: https://aws.amazon.com/blogs/machine-learning/k-means-clustering-with-amazon-sagemaker/
के-मीन्स क्लस्टरिंग इस दृष्टिकोण का सबसे लोकप्रिय कार्यान्वयन बन गया है, जो डेटा बिंदुओं को विशिष्ट ‘के समूह’ में मार्गदर्शन करता है, जो जनसांख्यिकीय क्षेत्र, ऑनलाइन समुदायों या किसी अन्य संभावित गुप्त समूह को दर्शा सकते हैं जो कच्चे सांख्यिकीय डेटा में खोजा जा रहा है।

के-मीन्स विश्लेषण में समूह बनते हैं। स्रोत: https://www.geeksforgeeks.org/ml-determine-the-optimal-value-of-k-in-k-means-clustering/
के मान स्वयं प्रक्रिया की उपयोगिता और एक समूह के लिए एक इष्टतम मान स्थापित करने में निर्णायक कारक है। शुरू में, के मान को यादृच्छिक रूप से सौंपा जाता है, और इसकी विशेषताओं और वेक्टर विशेषताओं को इसके पड़ोसियों के साथ तुलना की जाती है।
पड़ोसी जो यादृच्छिक रूप से सौंपे गए मान वाले डेटा बिंदु के समान होते हैं, उन्हें पुनरावृत्ति द्वारा इसके समूह में सौंपा जाता है जब तक कि डेटा ने सभी समूहों को प्रक्रिया की अनुमति नहीं देता।
समूहों में भिन्न मानों के बीच वर्ग त्रुटि के लिए प्लॉट, या ‘लागत’ एक कोहनी बिंदु को डेटा के लिए प्रकट करेगा:

एक क्लस्टर ग्राफ में कोहनी बिंदु। स्रोत: https://www.scikit-yb.org/en/latest/api/cluster/elbow.html
कोहनी बिंदु एक प्रशिक्षण सत्र के अंत में हानि के समतल होने की अवधारणा के समान है, जो एक डेटासेट के लिए। यह उस बिंदु का प्रतिनिधित्व करता है जहां समूहों के बीच कोई और भेदभाव दिखाई नहीं देगा, संकेत देता है कि आगे के चरणों में जाने या अपने निष्कर्षों की रिपोर्ट करने का समय है।
लोकप्रिय उपयोग
के-मीन्स क्लस्टरिंग, स्पष्ट कारणों से, ग्राहक विश्लेषण में एक प्राथमिक प्रौद्योगिकी है, क्योंकि यह बड़ी व्यावसायिक रिकॉर्ड को जनसांख्यिकीय अंतर्दृष्टि और ‘लीड’ में अनुवाद करने के लिए एक स्पष्ट और समझने योग्य विधि प्रदान करता है।
इस अनुप्रयोग के बाहर, के-मीन्स क्लस्टरिंग का उपयोग भूस्खलन भविष्यवाणी, चिकित्सा इमेज सेगमेंटेशन, जीएएन के साथ इमेज सिंथेसिस, दस्तावेज़ वर्गीकरण, और शहरी योजना के लिए भी किया जाता है, साथ ही कई अन्य संभावित और वास्तविक उपयोगों के लिए।
5: रैंडम फॉरेस्ट
रैंडम फॉरेस्ट एक समूह-आधारित शिक्षण विधि है जो एक निर्णय पेड़ के सरणी से परिणाम को औसत करती है ताकि परिणाम के लिए एक समग्र भविष्यवाणी स्थापित की जा सके।

स्रोत: https://www.tutorialandexample.com/wp-content/uploads/2019/10/Decision-Trees-Root-Node.png
यदि आपने इस विषय पर थोड़ा भी विचार किया है, यहाँ तक कि केवल बैक टू द फ्यूचर त्रयी देखी है, तो एक निर्णय पेड़ स्वयं को संकल्पना करना काफी आसान है: आपके सामने कई मार्ग हैं, और प्रत्येक मार्ग एक नए परिणाम में शाखा करता है जिसमें आगे के संभावित मार्ग होते हैं।
पुनर्बलन शिक्षण में आप एक रास्ते से लौटकर पिछली स्थिति से दोबारा शुरू कर सकते हैं, जबकि निर्णय वृक्ष चुने हुए रास्तों पर आगे बढ़ते हैं।
रैंडम फॉरेस्ट अल्गोरिदम मूल रूप से निर्णय लेने के लिए एक प्रकार का फैलाव दांव है। अल्गोरिदम अद हॉक चयन और अवलोकन करता है ताकि यह निर्णय पेड़ के सरणी से परिणामों का मध्यिका योग समझ सके।
चूंकि यह कई कारकों को ध्यान में रखता है, रैंडम फॉरेस्ट दृष्टिकोण एक निर्णय पेड़ की तुलना में अधिक उत्पादक होने की संभावना है, लेकिन एक निर्णय पेड़ की तुलना में इसका अर्थपूर्ण ग्राफ में अनुवाद करना अधिक कठिन हो सकता है।
निर्णय पेड़ ओवरफिटिंग के लिए प्रवण होते हैं, जहां परिणाम डेटा विशिष्ट होते हैं और सामान्य नहीं होने की संभावना है। रैंडम फॉरेस्ट के यादृच्छिक डेटा बिंदु चयन इस प्रवृत्ति से लड़ता है, डेटा में महत्वपूर्ण और उपयोगी प्रतिनिधि रुझानों की ओर बढ़ता है।

निर्णय पेड़ प्रतिगमन。 स्रोत: https://scikit-learn.org/stable/auto_examples/tree/plot_tree_regression.html
लोकप्रिय उपयोग
जैसा कि इस सूची में कई अल्गोरिदम के साथ है, रैंडम फॉरेस्ट आमतौर पर डेटा के ‘प्रारंभिक’ सॉर्टर और फिल्टर के रूप में कार्य करता है, और इसलिए नियमित रूप से नए शोध पत्रों में दिखाई देता है। रैंडम फॉरेस्ट के उपयोग के कुछ उदाहरणों में चुंबकीय अनुनाद इमेज सिंथेसिस, बिटकॉइन मूल्य भविष्यवाणी, जनगणना सेगमेंटेशन, पाठ वर्गीकरण और क्रेडिट कार्ड धोखाधड़ी का पता लगाना शामिल हैं।
रैंडम फॉरेस्ट एक कम-स्तरीय अल्गोरिदम होने के नाते, यह अन्य कम-स्तरीय तरीकों के साथ-साथ दृश्यकरण अल्गोरिदम के प्रदर्शन में भी योगदान कर सकता है, जिनमें आगमनात्मक क्लस्टरिंग, विशेषता परिवर्तन, पाठ दस्तावेजों का वर्गीकरण स्पार्स विशेषताओं का उपयोग करके, और पाइपलाइन प्रदर्शन शामिल हैं।
6: नेइव बेयस
घनत्व अनुमान (ऊपर 4 देखें) के साथ जोड़कर, एक नेइव बेयस वर्गीकरण एक शक्तिशाली लेकिन अपेक्षाकृत हल्का अल्गोरिदम है जो डेटा की गणना की गई विशेषताओं के आधार पर संभावनाओं का अनुमान लगा सकता है।

एक नेइव बेयस वर्गीकरण में विशेषता संबंध। स्रोत: https://www.sciencedirect.com/topics/computer-science/naive-bayes-model
नेइव शब्द बेयस के सिद्धांत में विशेषताओं के बीच शर्ती स्वतंत्रता के धारणा को संदर्भित करता है। यदि आप इस दृष्टिकोण को अपनाते हैं, तो एक बतख की तरह चलना और एक बतख की तरह बोलना यह साबित नहीं करता कि हम एक बतख के साथ व्यवहार कर रहे हैं, और कोई ‘स्पष्ट’ धारणा पहले से नहीं अपनाई जाती है।
अकादमिक और जाँच की इतनी कठोरता वहाँ अत्यधिक हो सकती है जहाँ ‘सामान्य समझ’ उपलब्ध है, लेकिन यह मशीन लर्निंग डेटासेट में मौजूद कई अस्पष्टताओं और संभावित असंबंधित संबंधों को नेविगेट करने के लिए एक मूल्यवान मानक है।
एक मूल बेयसियन नेटवर्क में, विशेषताओं को स्कोरिंग फंक्शन के अधीन किया जाता है, जिसमें न्यूनतम विवरण लंबाई और बेयसियन स्कोरिंग शामिल हैं, जो डेटा बिंदुओं के बीच अनुमानित संबंधों और इन संबंधों की दिशा के संदर्भ में डेटा पर प्रतिबंध लगा सकते हैं।
एक नेइव बेयस वर्गीकरण, इसके विपरीत, विशेषताओं की स्वतंत्रता का धारणा करते हुए काम करता है, और फिर बेयस के सिद्धांत का उपयोग करके एक दिए गए वस्तु की संभावना की गणना करता है, इसकी विशेषताओं के आधार पर।
लोकप्रिय उपयोग
नेइव बेयस फिल्टर रोग भविष्यवाणी और दस्तावेज़ वर्गीकरण, स्पैम फिल्टरिंग, भावना वर्गीकरण, सिफारिश प्रणाली, और धोखाधड़ी का पता लगाना में अच्छी तरह से प्रतिनिधित्व किया जाता है, साथ ही अन्य अनुप्रयोगों में।
7: के-निकटतम पड़ोसी (केएनएन)
1951 में यूएस एयर फोर्स स्कूल ऑफ एविएशन मेडिसिन द्वारा प्रस्तावित और 20 वीं सदी के मध्य के कंप्यूटिंग हार्डवेयर की स्थिति के अनुसार खुद को अनुकूलित करने के लिए, के-निकटतम पड़ोसी (केएनएन) एक पतला अल्गोरिदम है जो अकादमिक पत्रों और निजी क्षेत्र के मशीन लर्निंग शोध पहलों में प्रमुखता से दिखाई देता है।
केएनएन को ‘आलसी शिक्षार्थी’ कहा जाता है, क्योंकि यह एक पूर्ण मशीन लर्निंग मॉडल को प्रशिक्षित करने की आवश्यकता के बिना डेटासेट को पूरी तरह से स्कैन करता है, डेटा बिंदुओं के बीच संबंधों का मूल्यांकन करने के लिए।

एक केएनएन समूह। स्रोत: https://scikit-learn.org/stable/modules/neighbors.html
हालांकि केएनएन आर्किटेक्चर पतला है, इसका व्यवस्थित दृष्टिकोण पढ़ने और लिखने के संचालन पर एक उल्लेखनीय मांग रखता है, और इसका उपयोग बहुत बड़े डेटासेट में प्रिंसिपल कंपोनेंट विश्लेषण (पीसीए) जैसी सहायक प्रौद्योगिकियों के बिना समस्याग्रस्त हो सकता है, जो जटिल और उच्च-वॉल्यूम डेटासेट को केएनएन द्वारा कम प्रयास से पार किए जा सकने वाले प्रतिनिधि समूहों में परिवर्तित कर सकता है।
एक हाल का अध्ययन एक कर्मचारी के एक कंपनी छोड़ने की संभावना का अनुमान लगाने के लिए कई अल्गोरिदम की प्रभावशीलता और अर्थव्यवस्था का मूल्यांकन करता है, जिसमें पाया गया कि केएनएन ने सटीकता और पूर्वानुमान प्रभावशीलता के संदर्भ में अधिक आधुनिक प्रतियोगियों की तुलना में 70 वर्षीय केएनएन श्रेष्ठ था।
लोकप्रिय उपयोग
इसकी लोकप्रिय सरलता के बावजूद, केएनएन डीएनएन-केंद्रित दृष्टिकोण में एक और में 2018 में पेंसिल्वेनिया स्टेट यूनिवर्सिटी द्वारा प्रस्तावित किया गया था, और कई अधिक जटिल मशीन लर्निंग फ्रेमवर्क में एक केंद्रीय प्रारंभिक प्रक्रिया के रूप में बना हुआ है, या एक बाद के चरण के विश्लेषणात्मक उपकरण के रूप में।
विभिन्न कॉन्फ़िगरेशन में, केएनएन का उपयोग ऑनलाइन हस्ताक्षर सत्यापन, इमेज वर्गीकरण, पाठ खनन, फसल भविष्यवाणी, और चेहरे की पहचान के लिए किया गया है, साथ ही अन्य अनुप्रयोगों और एकीकरण के लिए।

प्रशिक्षण में एक केएनएन-आधारित चेहरे की पहचान प्रणाली। स्रोत: https://pdfs.semanticscholar.org/6f3d/d4c5ffeb3ce74bf57342861686944490f513.pdf
8: मार्कोव निर्णय प्रक्रिया (एमडीपी)
अमेरिकी गणितज्ञ रिचर्ड बेलमैन 1957 में द्वारा पेश की गई एक गणितीय ढांचा, मार्कोव निर्णय प्रक्रिया (एमडीपी) सुदृढ़ शिक्षण आर्किटेक्चर के सबसे बुनियादी ब्लॉकों में से एक है। एक संकल्पनात्मक अल्गोरिदम अपने आप में, यह कई अन्य अल्गोरिदम में अनुकूलित किया गया है, और वर्तमान फसल के एआई/एमएल शोध में बार-बार दिखाई देता है।
एमडीपी अपने वर्तमान राज्य (अर्थात डेटा में ‘कहां’ यह है) के मूल्यांकन का उपयोग करके डेटा के पर्यावरण का अन्वेषण करता है, जो यह तय करने के लिए कि डेटा में अगला नोड कौन सा है।

स्रोत: https://www.sciencedirect.com/science/article/abs/pii/S0888613X18304420
एक मूल मार्कोव निर्णय प्रक्रिया अधिक वांछनीय दीर्घकालिक उद्देश्यों के बजाय अल्पकालिक लाभ को प्राथमिकता देती है। इसके लिए, यह आमतौर पर सुदृढ़ शिक्षण में एक अधिक व्यापक नीति आर्किटेक्चर के संदर्भ में निहित है, और अक्सर छूटित पुरस्कार और अन्य संशोधित पर्यावरणीय चर जैसे सीमित करने वाले कारकों के अधीन है। ये कारक उसे व्यापक वांछित परिणाम की अनदेखी कर किसी तात्कालिक लक्ष्य की ओर दौड़ने से रोकते हैं।
लोकप्रिय उपयोग
एमडीपी की निम्न-स्तरीय अवधारणा शोध और मशीन लर्निंग के सक्रिय रूप से तैनात दोनों में व्यापक है। यह आईओटी सुरक्षा रक्षा प्रणाली, मछली पकड़ने, और बाजार भविष्यवाणी के लिए प्रस्तावित किया गया है।
इसकी स्पष्ट प्रासंगिकता के अलावा शतरंज और अन्य सख्त अनुक्रमिक खेलों में, एमडीपी रोबोटिक्स प्रणालियों के प्रक्रियात्मक प्रशिक्षण के लिए एक प्राकृतिक दावेदार है, जैसा कि नीचे दिए गए वीडियो में देखा जा सकता है।
9: शब्द आवृत्ति-व्युत्क्रम दस्तावेज़ आवृत्ति
शब्द आवृत्ति (टीएफ) निकालने के लिए किसी दस्तावेज़ में एक शब्द के आने की संख्या को उस दस्तावेज़ के कुल शब्दों की संख्या से भाग दिया जाता है। इसलिए, एक हजार शब्दों के लेख में एक बार दिखाई देने वाला शब्द समुद्री सील की शब्द आवृत्ति 0.001 है। टीएफ अपने आप में शब्द के महत्व के संकेतक के रूप में अधिकांश भाग के लिए उपयोगी नहीं है, क्योंकि स्वतंत्र अर्थ-सामग्री से रहित अंग्रेज़ी व्याकरणिक शब्द (जैसे a, and, the और it) प्रमुखता से हावी हैं।
एक शब्द के लिए एक अर्थपूर्ण मूल्य प्राप्त करने के लिए, व्युत्क्रम दस्तावेज़ आवृत्ति (आईडीएफ) एक शब्द की टीएफ को डेटासेट में कई दस्तावेजों में गणना करता है, बहुत उच्च-आवृत्ति रोक शब्दों को कम रेटिंग देता है, जैसे कि आर्टिकल। परिणामी विशेषता वेक्टर पूर्णांक मानों में सामान्यीकृत होते हैं, प्रत्येक शब्द को एक उपयुक्त भार सौंपा जाता है।

टीएफ-आईडीएफ कई दस्तावेजों में शब्द की आवृत्ति के आधार पर शब्दों की प्रासंगिकता को भारित करता है, जिसमें दुर्लभ घटना एक संकेतक है। स्रोत: https://moz.com/blog/inverse-document-frequency-and-the-importance-of-uniqueness
हालांकि यह दृष्टिकोण सेमैंटिक रूप से महत्वपूर्ण शब्दों को आउटलियर के रूप में खोने से रोकता है, आईडीएफ को व्युत्क्रम करना स्वचालित रूप से यह नहीं मानता है कि एक निम्न-आवृत्ति वाला शब्द नहीं एक आउटलियर है। क्योंकि कुछ चीजें दुर्लभ और नगण्य हैं। इसलिए, एक निम्न-आवृत्ति वाला शब्द को अपने मूल्य को व्यापक आर्किटेक्चर संदर्भ में साबित करने की आवश्यकता होगी, यहां तक कि प्रति दस्तावेज़ कम आवृत्ति पर भी, डेटासेट में कई दस्तावेजों में दिखाई दे रहा है।
इसकी आयु के बावजूद, टीएफ-आईडीएफ प्राकृतिक भाषा प्रसंस्करण फ्रेमवर्क में एक शक्तिशाली और लोकप्रिय विधि है।
लोकप्रिय उपयोग
चूंकि टीएफ-आईडीएफ ने पिछले बीस वर्षों में गूगल के मुख्य रूप से गुप्त पेजरैंक अल्गोरिदम में कम से कम कुछ हिस्सा निभाया है, यह बहुत व्यापक रूप से अपनाया गया है एक हेरफेर एसईओ रणनीति के रूप में, जॉन म्यूलर के 2019 अस्वीकृति के बावजूद इसके खोज परिणामों के लिए इसके महत्व के।
पेजरैंक की गोपनीयता के कारण, यह स्पष्ट नहीं है कि टीएफ-आईडीएफ अभी भी गूगल की रैंकिंग में सुधार के लिए एक प्रभावी रणनीति नहीं है। आईटी पेशेवरों के बीच हाल की तीखी चर्चा संकेत देती है कि एक लोकप्रिय समझ, सही या नहीं, यह है कि शब्द का दुरुपयोग अभी भी एसईओ प्लेसमेंट में सुधार कर सकता है (हालांकि अतिरिक्त एकाधिकार दुरुपयोग और अत्यधिक विज्ञापन इस सिद्धांत की सीमाओं को धुंधला करते हैं)।
10: स्टोकेस्टिक ग्रेडिएंट डिसेंट
स्टोकेस्टिक ग्रेडिएंट डिसेंट (एसजीडी) मशीन लर्निंग मॉडल के प्रशिक्षण के अनुकूलन के लिए एक बढ़ती लोकप्रियता वाली विधि है।
ग्रेडिएंट डिसेंट स्वयं एक प्रशिक्षण प्रक्रिया के दौरान एक मॉडल द्वारा की जा रही प्रगति को अनुकूलित और बाद में मात्रा निर्धारित करने का एक तरीका है।
इस अर्थ में, ‘ग्रेडिएंट’ एक नीचे की ओर ढलान (रंग-आधारित ग्रेडेशन के विपरीत, नीचे देखें) को इंगित करता है, जहां प्रशिक्षण प्रक्रिया की शुरुआत में सबसे ऊंचा बिंदु होता है, जहां मॉडल ने अभी तक डेटा को एक बार भी नहीं देखा है और डेटा संबंधों के बारे में पर्याप्त नहीं सीखा है प्रभावी परिवर्तनों का उत्पादन करने के लिए।

एक फेसस्वैप प्रशिक्षण सत्र पर ग्रेडिएंट डिसेंट। हम देख सकते हैं कि प्रशिक्षण ने दूसरे आधे हिस्से में कुछ समय के लिए पठार कर लिया है, लेकिन अंततः एक स्वीकार्य अभिसरण की ओर ग्रेडिएंट के नीचे अपना रास्ता पुनः प्राप्त किया है।
निम्न बिंदु, दाईं ओर, अभिसरण (बिंदु का प्रतिनिधित्व करता है जहां मॉडल अपने तहत लगाए गए प्रतिबंधों और सेटिंग्स के तहत जितना प्रभावी हो सकता है) को दर्शाता है।
ग्रेडिएंट अभिसरण के लिए एक रिकॉर्ड और पूर्वानुमान के रूप में कार्य करता है, जो त्रुटि दर (मॉडल ने वर्तमान में डेटा संबंधों को कितनी सटीक रूप से मैप किया है) और वजन (सेटिंग्स जो मॉडल के शिक्षण को प्रभावित करती हैं) के बीच के अंतर को रिकॉर्ड करता है।
यह रिकॉर्ड प्रगति का उपयोग एक लर्निंग रेट शेड्यूल को सूचित करने के लिए किया जा सकता है, जो एक स्वचालित प्रक्रिया है जो वास्तुकला को बताती है कि शुरुआती अस्पष्ट विवरणों के स्पष्ट संबंधों और मानचित्रण में बदलने पर अधिक सूक्ष्म और सटीक बनने के लिए। प्रभावी रूप से, ग्रेडिएंट हानि प्रशिक्षण को बताती है कि आगे कहां जाना है और कैसे आगे बढ़ना है।
एसजीडी का नवाचार यह है कि यह प्रत्येक प्रशिक्षण उदाहरण के बाद प्रत्येक पुनरावृत्ति के लिए मॉडल के पैरामीटर को अपडेट करता है, जो आमतौर पर अभिसरण की यात्रा को तेज करता है। हाल के वर्षों में हाइपरस्केल डेटासेट के आगमन के कारण, एसजीडी ने हाल ही में लॉजिस्टिक मुद्दों को संबोधित करने के एक संभावित तरीके के रूप में लोकप्रियता हासिल की है।
दूसरी ओर, एसजीडी के विशेषता स्केलिंग के लिए नकारात्मक परिणाम हैं, और एक ही परिणाम प्राप्त करने के लिए अधिक पुनरावृत्तियों की आवश्यकता हो सकती है, जिसमें अतिरिक्त योजना और अतिरिक्त पैरामीटर की आवश्यकता होती है, नियमित ग्रेडिएंट डिसेंट की तुलना में।
लोकप्रिय उपयोग
अपनी कॉन्फ़िगरेबिलिटी के कारण, और अपनी कमियों के बावजूद, एसजीडी न्यूरल नेटवर्क को फिट करने के लिए सबसे लोकप्रिय अनुकूलन अल्गोरिदम बन गया है। एसजीडी की एक कॉन्फ़िगरेशन जो नए एआई/एमएल शोध पत्रों में प्रमुखता से बढ़ रही है, वह है 2015 में पेश किए गए एडाप्टिव मोमेंट एस्टीमेशन (एडम, प्रस्तुत) ऑप्टिमाइज़र का चयन है।
एडम प्रत्येक पैरामीटर के लिए गतिशील रूप से (‘अनुकूली लर्निंग रेट’) सीखने की दर को अनुकूलित करता है, साथ ही पिछले अपडेट से परिणामों को अगले कॉन्फ़िगरेशन में शामिल करता है (‘मोमेंटम’)। इसके अलावा, यह बाद की नवाचारों का उपयोग करने के लिए कॉन्फ़िगर किया जा सकता है, जैसे नेस्टरोव मोमेंटम।
हालांकि, कुछ लोगों का मानना है कि मोमेंटम का उपयोग एडम (और समान अल्गोरिदम) को एक उप-आदर्श निष्कर्ष तक तेजी से ले जा सकता है। जैसा कि मशीन लर्निंग शोध क्षेत्र के सबसे आगे के हिस्से में, एसजीडी एक कार्य प्रगति पर है।
पहली बार 10 फरवरी 2022 को प्रकाशित। 10 फरवरी 20.05 ईईटी – प्रारूप में संशोधित।


