एआई की मूल बातें
सुपरवाइज़्ड बनाम अनसुपरवाइज़्ड लर्निंग

 Unite.AI को Google पर अपने पसंदीदा स्रोतों में जोड़ें
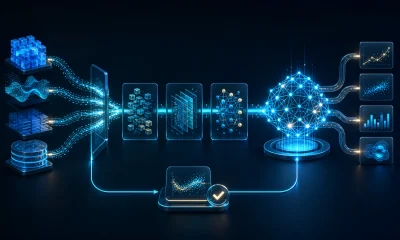
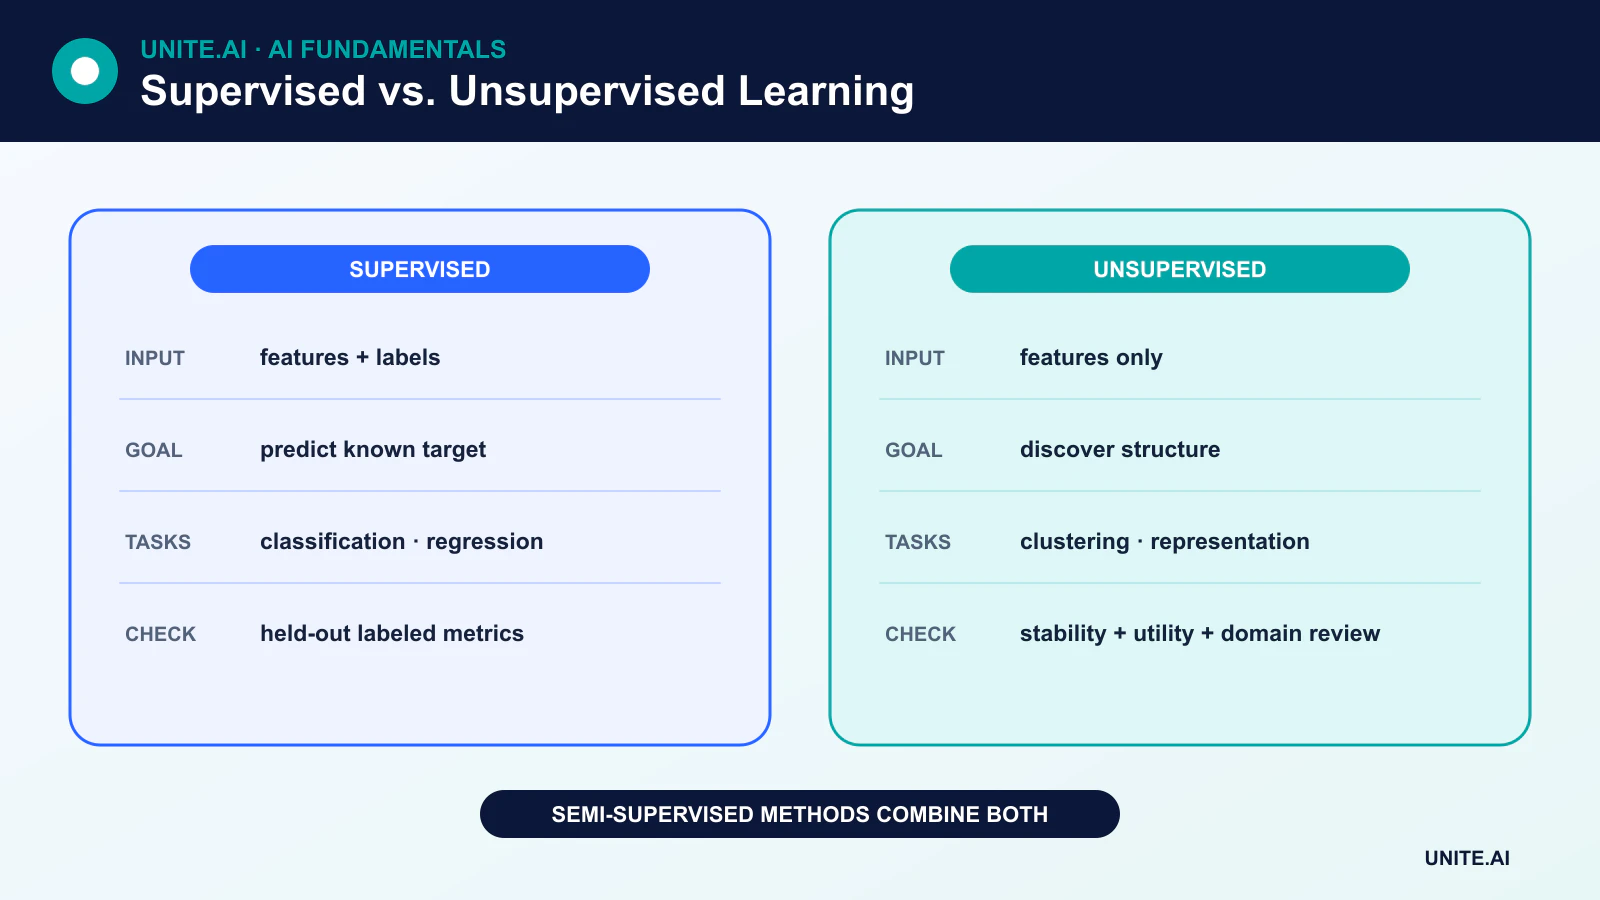
सुपरवाइज़्ड लर्निंग लक्ष्य उत्तरों के साथ जोड़े गए उदाहरणों से सीखती है। अनसुपरवाइज़्ड लर्निंग डेटा में बिना लक्ष्य लेबल के संरचना खोजती है। अंतर यह नहीं है कि कौन सा दृष्टिकोण अधिक बुद्धिमान या सटीक है; यह उपलब्ध सीखने के संकेत की प्रकार और वह प्रश्न है जिसका उत्तर प्रणाली देने के लिए डिज़ाइन की गई है।
ये दो प्रमुख प्रतिमान मशीन लर्निंग के भीतर हैं, लेकिन आधुनिक सिस्टम भी अर्द्ध-नियंत्रित (सेमी-सुपरवाइज़्ड), स्व-नियंत्रित (सेल्फ-सुपरवाइज़्ड) और सुदृढीकरण लर्निंग (रिइन्फोर्समेंट लर्निंग) का उपयोग करते हैं।
मुख्य बिंदु
- सुपरवाइज़्ड लर्निंग ज्ञात लक्ष्य की भविष्यवाणी करती है; अनसुपरवाइज़्ड लर्निंग पैटर्न या प्रतिनिधित्व खोजती है।
- वर्गीकरण और प्रतिगमन सुपरवाइज़्ड कार्य हैं; क्लस्टरिंग, घनत्व अनुमान, और कई आयाम-घटाव विधियाँ अनसुपरवाइज़्ड हैं।
- अनसुपरवाइज़्ड आउटपुट स्वचालित रूप से वास्तविक दुनिया की श्रेणियाँ नहीं होते और उनका मूल्यांकन कठिन हो सकता है।
- गणना लागत और सटीकता एल्गोरिदम, डेटा, कार्य और मूल्यांकन पर निर्भर करती है—केवल प्रतिमान पर नहीं।
सुपरवाइज़्ड लर्निंग कैसे काम करती है
एक सुपरवाइज़्ड डेटासेट में विशेषताएँ X और लक्ष्य y होते हैं। प्रशिक्षण मॉडल को इस तरह समायोजित करता है कि उसकी भविष्यवाणियाँ लक्ष्यों के निकट हों। मूल्यांकन में अलग रखे गए लेबल वाले उदाहरणों का उपयोग करके यह अनुमान लगाया जाता है कि मॉडल कितनी अच्छी तरह सामान्यीकृत करता है।
वर्गीकरण
वर्गीकरण एक श्रेणी की भविष्यवाणी करता है: स्पैम या नॉन-स्पैम, कई में से एक दस्तावेज़ विषय, या छवि में एक या अधिक वस्तुएँ। संबंधित मेट्रिक्स में प्रिसीजन, रिकॉल, F1, कैलिब्रेशन, और लागत-संवेदनशील माप शामिल हैं। जब एक वर्ग दुर्लभ हो तो सटीकता भ्रामक हो सकती है; एक कन्फ्यूज़न मैट्रिक्स दिखाता है कि कौन से वर्ग भ्रमित हो रहे हैं।
प्रतिगमन
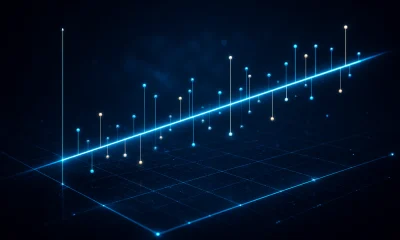
प्रतिगमन निरंतर मान की भविष्यवाणी करता है, जैसे मांग, अवधि, या तापमान। लीनियर प्रतिगमन एक या कई विशेषताओं का उपयोग कर सकता है; यह दो चर के बीच संबंध बनाने तक सीमित नहीं है। प्रतिगमन मेट्रिक्स में औसत निरपेक्ष त्रुटि, मूल वर्ग त्रुटि, और कार्य-विशिष्ट लागत शामिल हैं।
सामान्य सुपरवाइज़्ड एल्गोरिदम
सुपरवाइज़्ड विधियों में लीनियर और लॉजिस्टिक मॉडल, डिसीजन ट्री, रैंडम फॉरेस्ट, ग्रेडिएंट बूस्टिंग, सपोर्ट वेक्टर मशीन, K-नियरस्ट नेबर्स, और न्यूरल नेटवर्क शामिल हैं।
लॉजिस्टिक प्रतिगमन एक स्कोर या संभावना उत्पन्न करता है जिसे चुने हुए थ्रेशोल्ड से वर्ग में परिवर्तित किया जा सकता है। एक डिसीजन-ट्री लीफ़ विशेषता स्थान के एक क्षेत्र पर आधारित भविष्यवाणी रखता है, जरूरी नहीं कि वह एकल प्रशिक्षण अवलोकन हो। KNN निकटवर्ती लेबल वाले प्रशिक्षण उदाहरणों से भविष्यवाणी करता है और फिर भी एक ठोस प्रशिक्षण/वैलिडेशन/टेस्ट डिजाइन की आवश्यकता होती है।
अनसुपरवाइज़्ड लर्निंग कैसे काम करती है
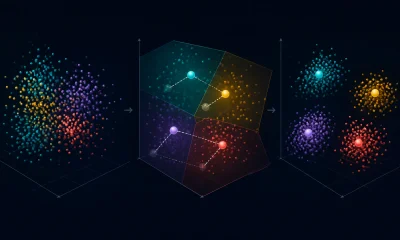
अनसुपरवाइज़्ड लर्निंग लक्ष्य कॉलम के बिना विशेषताएँ प्राप्त करती है। इसका उद्देश्य अप्रत्यक्ष रूप से परिभाषित होता है—उदाहरण के लिए, क्लस्टरों के भीतर दूरी को न्यूनतम करना, इनपुट को पुनर्निर्मित करना, डेटा घनत्व का अनुमान लगाना, या कम आयामों में अधिकतम वैरिएंस बनाए रखना।
क्लस्टरिंग
K-मीन्स बिंदुओं को चुनी हुई संख्या के क्लस्टरों में असाइन करता है और क्लस्टर केंद्रों को अपडेट करता है ताकि क्लस्टर के भीतर वर्ग दूरी कम हो सके। एल्गोरिदम एक विशिष्ट दूरी और विशेषता प्रतिनिधित्व के तहत ज्यामितीय समूहों की खोज करता है। ये समूह स्वचालित रूप से अर्थपूर्ण ग्राहक प्रकार, निदान, या अन्य डोमेन लेबल से मेल नहीं खाते।
आयाम घटाव
आयाम घटाव डेटा को कम चरों का उपयोग करके प्रस्तुत करता है। प्रमुख घटक विश्लेषण (PCA) उन लम्बवत दिशाओं को खोजता है जो रैखिक प्रोजेक्शन के तहत अधिकतम वैरिएंस बनाए रखते हैं। अन्य विधियाँ संरचना के विभिन्न अवधारणाओं को संरक्षित करती हैं और बहुत अलग विज़ुअलाइज़ेशन उत्पन्न कर सकती हैं।
असामान्यता और घनत्व अनुमान
अनसुपरवाइज़्ड विधियाँ यह अनुमान लगा सकती हैं कि डेटा कहाँ घना है और असामान्य अवलोकनों को चिह्नित कर सकती हैं। एक असामान्यता स्कोर धोखाधड़ी, विफलता, या दुर्भावनापूर्ण व्यवहार को सिद्ध नहीं करता; यह चुनी हुई प्रतिनिधित्व और मॉडल के तहत एक विचलन को पहचानता है।
अनसुपरवाइज़्ड लर्निंग का मूल्यांकन कैसे किया जाता है
अनसुपरवाइज़्ड “सटीकता” की कोई सार्वभौमिक अवधारणा नहीं है। एक प्रैक्टिशनर आंतरिक मेट्रिक्स जैसे सिल्हूट स्कोर का उपयोग कर सकता है, नमूनों के बीच स्थिरता की तुलना कर सकता है, डाउनस्ट्रीम कार्य में उपयोगिता का परीक्षण कर सकता है, या डोमेन विशेषज्ञों से पूछ सकता है कि खोजी गई संरचना अर्थपूर्ण है या नहीं। यदि मूल्यांकन के लिए ग्राउंड-ट्रुथ लेबल मौजूद हैं, तो बाहरी क्लस्टरिंग मेट्रिक्स का उपयोग किया जा सकता है बिना प्रशिक्षण प्रक्रिया को सुपरवाइज़्ड लर्निंग में बदले।
दो-तरफ़ा तुलना से परे
सेमी-सुपरवाइज़्ड लर्निंग
सेमी-सुपरवाइज़्ड लर्निंग छोटे लेबल वाले सेट को बड़े अनलेबल्ड सेट के साथ मिलाती है। प्स्यूडो-लेबलिंग, स्थिरता नियमितीकरण, और ग्राफ-आधारित विधियाँ इसके उदाहरण हैं। अनलेबल्ड डेटा को अभी भी लक्ष्य वितरण के समान पर्याप्त रूप से होना चाहिए ताकि मदद मिल सके।
सेल्फ-सुपरवाइज़्ड लर्निंग
सेल्फ-सुपरवाइज़्ड लर्निंग इनपुट से ही लक्ष्य बनाती है, जैसे मास्क किए गए टोकन की भविष्यवाणी करना या परिवर्तित दृश्यों को मिलाना। यह आधुनिक भाषा, विज़न, और मल्टीमॉडल मॉडलों की नींव है, जिसमें ट्रांसफ़ॉर्मर शामिल हैं।
रिइन्फोर्समेंट लर्निंग
रिइन्फोर्समेंट लर्निंग इंटरैक्शन द्वारा उत्पन्न इनामों के माध्यम से निर्णयों को अनुकूलित करती है। यह लेबल वाली भविष्यवाणी और स्थिर पैटर्न खोज दोनों से भिन्न है।
सही दृष्टिकोण चुनना
सबसे पहले उस निर्णय या अंतर्दृष्टि से शुरू करें जो सिस्टम को उत्पन्न करनी चाहिए। यदि विश्वसनीय लक्ष्य मौजूद हैं और लक्ष्य भविष्यवाणी है, तो सुपरवाइज़्ड लर्निंग स्वाभाविक है। यदि उद्देश्य अन्वेषण, प्रतिनिधित्व, या समूह बनाना है, तो अनसुपरवाइज़्ड विधि उपयुक्त हो सकती है। जब लेबल कम हों, तो सेल्फ-सुपरवाइज़्ड या सेमी-सुपरवाइज़्ड प्री‑ट्रेनिंग के बाद सुपरवाइज़्ड मूल्यांकन अधिक प्रभावी हो सकता है।
हर स्थिति में, डेटा लीक, पक्षपाती सैंपलिंग, कमजोर प्रॉक्सी, और वितरण परिवर्तन एल्गोरिदम के चयन को प्रमुखता से प्रभावित कर सकते हैं। गलत उद्देश्य पर प्रशिक्षित एक तकनीकी रूप से सही मॉडल भी विफल हो सकता है।
लर्निंग संकेत, उद्देश्य, और प्रतिनिधि विधियाँ
सुपरवाइज़्ड लर्निंग लक्ष्य लेबल या मानों के साथ जोड़े गए उदाहरणों का उपयोग करती है और भविष्यवाणी त्रुटि को अनुकूलित करती है। वर्गीकरण, प्रतिगमन, रैंकिंग, और संरचित भविष्यवाणी आउटपुट और लॉस में भिन्न होते हैं। अनसुपरवाइज़्ड लर्निंग क्लस्टरिंग, घनत्व अनुमान, आयाम घटाव, प्रतिनिधित्व लर्निंग, या जनरेटिव मॉडलिंग के माध्यम से लक्ष्य लेबल के बिना संरचना खोजती है। सेल्फ-सुपरवाइज़्ड लर्निंग डेटा से ही भविष्यवाणी लक्ष्य बनाती है, जबकि सेमी-सुपरवाइज़्ड लर्निंग छोटे लेबल वाले सेट को बड़े अनलेबल्ड डेटा के साथ मिलाती है। ये श्रेणियाँ सीखने के संकेत का वर्णन करती हैं; समान न्यूरल आर्किटेक्चर कई प्रतिमानों के तहत प्रशिक्षित किया जा सकता है।
लेबल एक उद्देश्य को स्पष्ट बनाते हैं लेकिन एनोटेशन लागत, शोर, नीति धारणाएँ, और समय विलंब लाते हैं। अनलेबल्ड डेटा एकत्र करना आसान है लेकिन यह एल्गोरिदम को नहीं बताता कि कौन सी खोजी गई संरचना उपयोगी है। एक क्लस्टर प्रकाश, दस्तावेज़ की लंबाई, या अधिग्रहण स्रोत को दर्शा सकता है न कि अर्थपूर्ण श्रेणी को। मूल्यांकन को स्वतंत्र रूप से परिभाषित करें: सुपरवाइज़्ड मॉडल अलग रखे लेबल वाले परिणामों का उपयोग करते हैं, जबकि अनसुपरवाइज़्ड मॉडल को स्थिरता, पुनर्निर्माण, संभाव्यता, पुनः प्राप्ति, डाउनस्ट्रीम उपयोगिता, या विशेषज्ञ सत्यापन की आवश्यकता होती है। केवल दृश्य विभाजन वैध संरचना का प्रमाण नहीं है।
एक प्रतिमान चुनना और सामान्य त्रुटियों को रोकना
जब स्थिर लक्ष्य और प्रतिनिधि लेबल मौजूद हों, तो सुपरवाइज़्ड लर्निंग का उपयोग करें। सारांश बनाने, नई चीज़ों का पता लगाने, संपीड़न, या परिकल्पनाएँ उत्पन्न करने के लिए अनसुपरवाइज़्ड अन्वेषण का उपयोग करें, लेकिन आउटपुट को अस्थायी मानें। जब कच्चा डेटा प्रचुर मात्रा में हो और डाउनस्ट्रीम कार्य प्रतिनिधित्व साझा करते हों, तो सेल्फ-सुपरवाइज़्ड प्री‑ट्रेनिंग मूल्यवान है। सेमी-सुपरवाइज़्ड विधियाँ तभी मदद करती हैं जब अनलेबल्ड डेटा और वर्ग संरचना के बारे में धारणाएँ सत्य हों। सरल बेसलाइन के साथ तुलना करें और संग्रह, लेबलिंग, समीक्षा, गणना, और त्रुटियों की कुल लागत को ध्यान में रखें, न कि यह मानें कि अनलेबल्ड स्वचालित रूप से सस्ता है।
लेबल, ऑगमेंटेशन, या प्स्यूडो‑लेबल निकालने से पहले संबंधित इकाइयों को अलग करके लीक को रोकें। वर्ग संतुलन, एनोटेशन सहमति, क्लस्टर स्थिरता, कोलैप्स, और ड्रिफ्ट की निगरानी करें। प्स्यूडो‑लेबल शुरुआती गलतियों को मजबूत कर सकते हैं; क्लस्टरिंग संवेदनशील विशेषताओं को एन्कोड कर सकता है; प्री‑ट्रेन्ड प्रतिनिधित्व स्रोत बायस को स्थानांतरित कर सकता है। मानव समीक्षा को सीमा मामलों और परिणामों पर केंद्रित होना चाहिए। उत्पादन में, दस्तावेज़ करें कि लर्निंग संकेत कैसे बनाया गया और कब यह अप्रचलित हो जाता है। प्रतिमान निर्धारित करता है कि सुपरविजन सिस्टम में कहाँ प्रवेश करता है, न कि मानव विकल्प और मूल्यों की उपस्थिति।
व्यावहारिक उदाहरण: सपोर्ट टॉपिक्स की खोज और लेबलिंग
एक कंपनी पहले अनसुपरवाइज़्ड एम्बेडिंग और क्लस्टरिंग का उपयोग करके अनामित सपोर्ट संदेशों में विषयों की खोज करती है। विश्लेषक प्रतिनिधि और सीमा उदाहरणों की जाँच करते हैं और पाते हैं कि कुछ क्लस्टर मुद्दों के बजाय संदेश की लंबाई और चैनल को दर्शाते हैं। वे एक अज्ञात वर्ग, एनोटेशन मार्गदर्शन, और मापी गई सहमति के साथ एक सुपरवाइज़्ड टैक्सोनॉमी विकसित करते हैं। फिर एक क्लासिफायर को बाद के समय अवधि, भाषाओं, और उत्पादों पर कीवर्ड और निकटतम‑नेबर बेसलाइन के मुकाबले मूल्यांकन किया जाता है।
अनलेबल्ड नए संदेश ड्रिफ्ट खोज को समर्थन देते हैं लेकिन क्लासिफायर को स्वचालित रूप से पुनः प्रशिक्षित नहीं करते। समीक्षक सक्रिय लर्निंग के माध्यम से चयनित अनिश्चित और उभरते मामलों को लेबल करते हैं, गुणवत्ता जाँच और एक सील्ड मूल्यांकन सेट के साथ। मॉनिटरिंग टॉपिक की प्रचलनता, विश्वास, असहमति, और रूटिंग परिणामों को ट्रैक करती है। जब नया उत्पाद लॉन्च होता है, तो टैक्सोनॉमी और डाउनस्ट्रीम टीमों की क्षमता को साथ में अपडेट किया जाता है। कार्यप्रवाह हाइपोथीसिस जनरेशन के लिए अनसुपरवाइज़्ड विधियों और ऑपरेशनल रूटिंग के लिए सुपरवाइज़्ड प्रमाण का उपयोग करता है।
कार्यान्वयन प्रमाण और संचालन तत्परता
एक उत्पादन निर्णय को सफल प्रदर्शन से अधिक चाहिए। इच्छित उपयोगकर्ताओं, संचालन वातावरण, इनपुट, आउटपुट, निर्भरताएँ, मालिक, और प्रत्येक महत्वपूर्ण विफलता के परिणाम को परिभाषित करें। ट्यूनिंग से पहले एक पुनरुत्पादनीय बेसलाइन और एक संस्करणित मूल्यांकन सेट स्थापित करें। सामान्य मामलों, सीमा स्थितियों, विकृत या अनुपलब्ध इनपुट, वितरण परिवर्तन, निर्भरता आउटेज, दुरुपयोग, और उन समूहों या वातावरणों का परीक्षण करें जो सबसे अधिक सेवा‑रहित हो सकते हैं। कार्य की गुणवत्ता को कैलिब्रेशन या अनिश्चितता, लेटेंसी, थ्रूपुट, संसाधन लागत, पहुँच, गोपनीयता, और सुरक्षा के साथ मापें। प्रत्येक परिवर्तन और थ्रेशोल्ड को रिकॉर्ड करें ताकि एक स्वतंत्र समीक्षक परिणाम को पुनः उत्पन्न कर सके और आकर्षक प्रोटोटाइप से प्रमाण को अलग कर सके।
लॉन्च से पहले, रिलीज़, अपवाद, परिवर्तन, रोलबैक, और रिटायरमेंट के लिए अधिकार निर्धारित करें। चरणबद्ध रोलआउट का उपयोग करें, एक सुरक्षित फॉलबैक रखें, और जानबूझकर डाली गई विफलताओं के साथ मॉनिटरिंग सत्यापित करें। ऑपरेशनल टेलीमेट्री को इनपुट गुणवत्ता, आउटपुट व्यवहार, मॉडल या नियम संस्करण, निर्भरता स्वास्थ्य, मानव ओवरराइड, और पुष्टि किए गए परिणाम दिखाने चाहिए, बिना अनावश्यक संवेदनशील डेटा एकत्र किए। अलर्ट थ्रेशोल्ड और प्रतिक्रिया मालिक को परिभाषित करें, फिर डिप्लॉयमेंट के बाद वास्तविक दुनिया के प्रमाण की समीक्षा करें, न कि यह मानें कि ऑफ़लाइन प्रदर्शन बना रहेगा। जब भी डेटा स्रोत, उपयोगकर्ता, मॉडल, विक्रेता, नीतियाँ, हार्डवेयर, या उद्देश्य बदलें, पुनः मूल्यांकन करें। एक रखरखाव किया गया सिस्टम दस्तावेज़ीकृत पुनर्प्राप्ति, घटना सीखना, विलोपन और प्रतिधारण प्रक्रियाओं, और एक स्पष्ट बिंदु की आवश्यकता रखता है जहाँ इसे निष्क्रिय या बदलना चाहिए।
प्राथमिक संदर्भ