
एआई की मूल बातें
डीप लर्निंग क्या है?

 Unite.AI को Google पर अपने पसंदीदा स्रोतों में जोड़ें
डीप लर्निंग मशीन लर्निंग की एक श्रेणी है जो कई प्रोसेसिंग लेयर वाले न्यूरल नेटवर्क का उपयोग करके डेटा के उपयोगी प्रतिनिधित्व सीखती है। ये मॉडल भाषा, चित्र, ऑडियो, सिफारिशें, वैज्ञानिक भविष्यवाणी और जेनरेटिव एआई सहित कई आधुनिक सिस्टम को शक्ति प्रदान करते हैं।
शब्द डीप इनपुट और आउटपुट के बीच होने वाले परिवर्तन की संख्या को दर्शाता है, न कि मशीन के गहरे समझ रखने को। एक डीप मॉडल ऐसे संख्यात्मक संबंध सीखता है जो उसके प्रशिक्षण लक्ष्य के लिए उपयोगी होते हैं, और उसके प्रदर्शन को अभी भी नए डेटा पर परीक्षण करना आवश्यक है।
मुख्य बिंदु
- डीप लर्निंग, मशीन लर्निंग का एक उपसमुच्चय है।
- लेयर टेन्सर को सीखे गए पैरामीटर, गैर-रेखीय सक्रियण, सामान्यीकरण और अन्य ऑपरेशनों का उपयोग करके परिवर्तित करती हैं।
- बैकप्रोपेगेशन ग्रेडिएंट की गणना करता है; एक ऑप्टिमाइज़र उन ग्रेडिएंट का उपयोग करके ट्रेन करने योग्य पैरामीटर, जैसे वज़न और बायस, को अपडेट करता है।
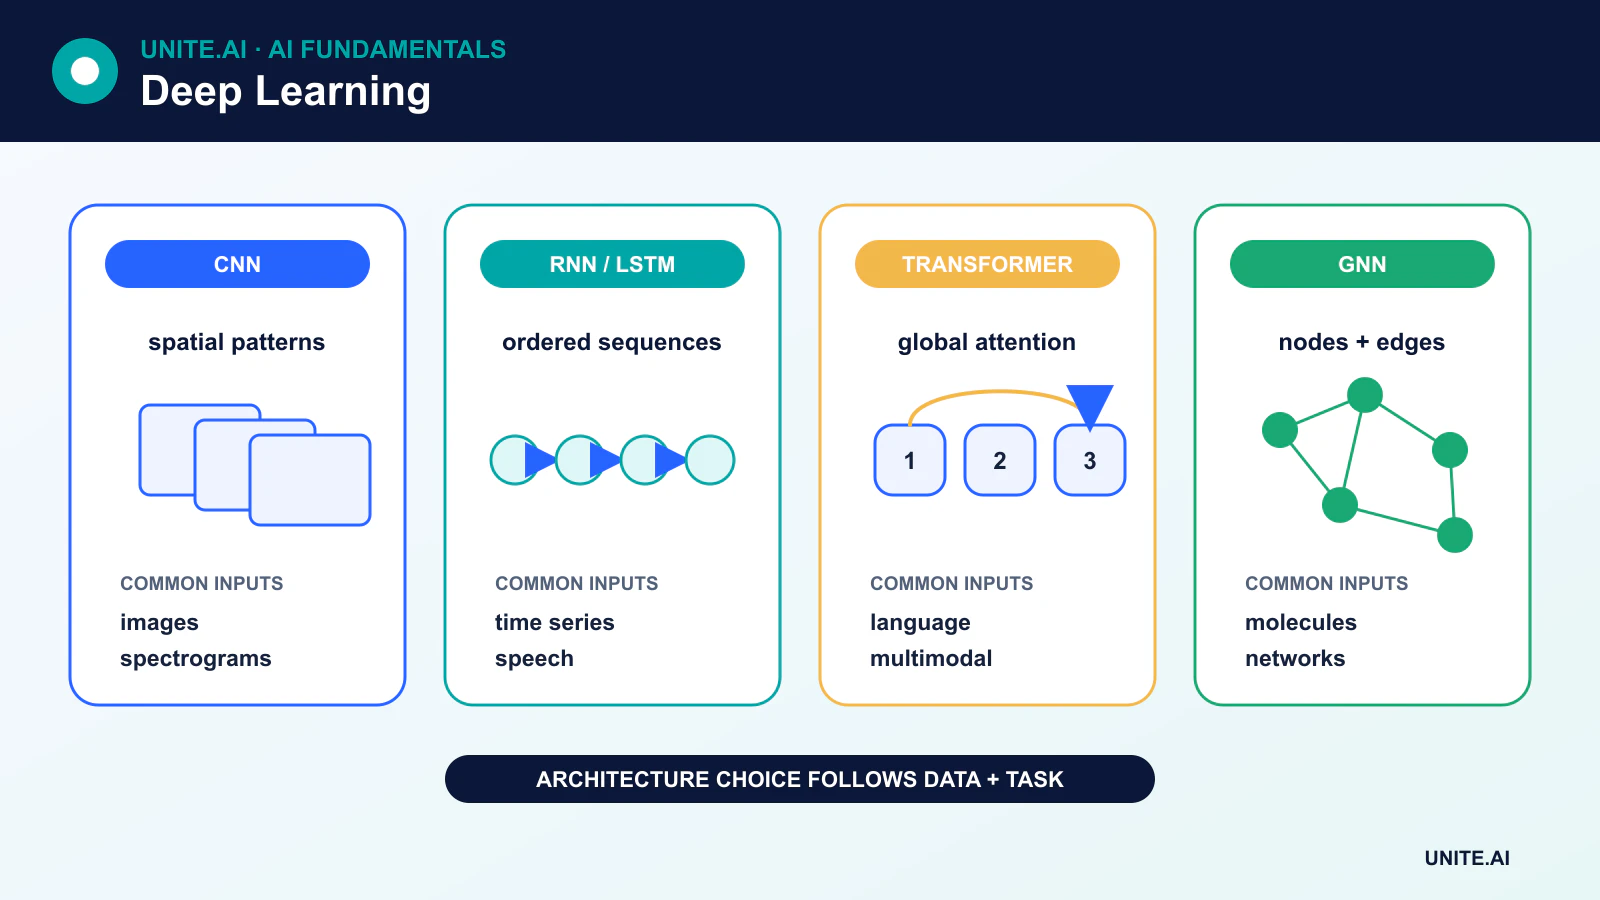
- CNN, पुनरावर्ती नेटवर्क, ट्रांसफॉर्मर, ऑटोएन्कोडर और डिफ्यूज़न मॉडल की अलग-अलग संरचनाएँ और ताकतें होती हैं।
एक डीप न्यूरल नेटवर्क कैसे सीखता है
एक न्यूरल नेटवर्क डेटा को टेन्सर के रूप में प्राप्त करता है, जो संख्याओं के बहु-आयामी एरे होते हैं। एक इमेज टेन्सर पिक्सेल चैनलों को एन्कोड कर सकता है, जबकि एक भाषा मॉडल टोकन का प्रतिनिधित्व करने वाले वेक्टर का उपयोग करता है। प्रत्येक लेयर एक अवकलनीय परिवर्तन करती है और परिणाम को अगले लेयर को पास करती है।
एक बुनियादी डेंस लेयर में, मॉडल अपने इनपुट का भारित योग गणना करता है, एक ट्रेन करने योग्य बायस जोड़ता है, और फिर एक सक्रियण फ़ंक्शन लागू करता है:
output = activation(Wx + b)
सक्रियण फ़ंक्शन गैर-रेखीयता लाता है। इसके बिना, सामान्य रैखिक लेयरों को स्टैक करने से केवल एक रैखिक परिवर्तन ही प्रदर्शित होगा। ReLU और उसके वैरिएंट छिपी लेयरों में सामान्य हैं, जबकि आउटपुट सक्रियण कार्य पर निर्भर करता है।
प्रशिक्षण आमतौर पर चार चरणों का पालन करता है:
- एक फ़ॉरवर्ड पास भविष्यवाणियाँ उत्पन्न करता है।
- एक लॉस फ़ंक्शन मापता है कि भविष्यवाणियाँ लक्ष्य से कितनी भिन्न हैं।
- बैकप्रोपेगेशन चेन नियम लागू करता है ताकि लॉस के प्रत्येक ट्रेन करने योग्य पैरामीटर के सापेक्ष ग्रेडिएंट की गणना की जा सके।
- एक ऑप्टिमाइज़र जैसे स्टोकेस्टिक ग्रेडिएंट डिसेंट या AdamW पैरामीटर को अपडेट करता है।
इन चरणों को कई बैचों पर दोहराने से मॉडल में सुधार हो सकता है, लेकिन कम प्रशिक्षण लॉस विश्वसनीय वास्तविक‑दुनिया व्यवहार की गारंटी नहीं देता। वैलिडेशन, रेग्युलराइज़ेशन, प्रतिनिधिक डेटा और मॉनिटरिंग अभी भी आवश्यक हैं।
मुख्य डीप‑लर्निंग आर्किटेक्चर
मल्टीलेयर पर्सेप्ट्रॉन
एक मल्टीलेयर पर्सेप्ट्रॉन (MLP) पूर्णतः जुड़े लेयरों का उपयोग करता है जिसमें प्रत्येक आउटपुट यूनिट पिछले लेयर के सभी इनपुट पर निर्भर करता है। MLP टेबलर फीचर और बड़े सिस्टम के भीतर घटकों के रूप में उपयोगी होते हैं, लेकिन वे इमेज स्थानीयता या क्रमिक क्रम के बारे में कोई धारणाएँ नहीं बनाते।
कन्वॉल्यूशनल न्यूरल नेटवर्क
कन्वॉल्यूशनल न्यूरल नेटवर्क (CNNs) सीखे गए फ़िल्टर को स्थानीय क्षेत्रों में लागू करते हैं। वज़न साझा करने से वे इमेज और स्पेक्ट्रोग्राम जैसी ग्रिड के लिए कुशल होते हैं। CNN विज़न और एज डिप्लॉयमेंट के लिए अभी भी महत्वपूर्ण हैं, हालांकि विज़न ट्रांसफॉर्मर और हाइब्रिड मॉडल भी व्यापक रूप से उपयोग होते हैं।
रिकरेंट नेटवर्क, LSTM, और GRU
रिकरेंट न्यूरल नेटवर्क (RNNs) क्रम प्रक्रिया होने पर छिपी अवस्था को अपडेट करते हैं। LSTM और गेटेड रिकरेंट यूनिट जानकारी को संरक्षित करने और वैनिशिंग‑ग्रेडिएंट समस्या को कम करने में मदद करते हैं, जो बेसिक RNN को लंबी निर्भरताओं के साथ संघर्ष कराता है। वे हर लंबी‑संदर्भ सीमा को समाप्त नहीं करते, लेकिन स्ट्रीमिंग सिग्नल, टाइम‑सीरीज़ डेटा और कॉम्पैक्ट क्रमिक मॉडलों के लिए उपयोगी रहते हैं।
ट्रांसफॉर्मर
ट्रांसफॉर्मर अनुक्रम या सेट के तत्वों के बीच संबंधों को मॉडल करने के लिए अटेंशन का उपयोग करते हैं। कई स्थितियों को समानांतर में प्रोसेस करने की उनकी क्षमता ने उन्हें अधिकांश बड़े‑पैमाने के भाषा सिस्टम में रिकरेंस की जगह लेने में मदद की, और ट्रांसफॉर्मर वैरिएंट अब इमेज, ऑडियो, वीडियो, प्रोटीन और मल्टीमॉडल डेटा को प्रोसेस करते हैं।
ऑटोएन्कोडर और जेनरेटिव मॉडल
एक ऑटोएन्कोडर इनपुट को एक प्रतिनिधित्व में संपीड़ित करता है और उससे इनपुट को पुनर्निर्मित करता है। यह एक स्व‑सुपरवाइज़्ड पुनर्निर्माण लक्ष्य बनाता है; यह स्वचालित रूप से अनलेबल्ड डेटा को लेबल्ड उदाहरणों में नहीं बदलता।
जेनरेटिव एडवर्सेरियल नेटवर्क (GAN) जनरेटर और डिस्क्रिमिनेटर को प्रतिस्पर्धा में प्रशिक्षित करते हैं। डिफ्यूज़न मॉडल क्रमिक शोर प्रक्रिया को उलटने को सीखते हैं। ऑटोरिग्रेसिव ट्रांसफॉर्मर एक समय में एक टोकन या यूनिट उत्पन्न करते हैं। इन दृष्टिकोणों के प्रशिक्षण गतिशीलता, नियंत्रण क्षमता और कंप्यूट आवश्यकताएँ अलग-अलग होती हैं।
गहराई क्यों मदद करती है—और आर्किटेक्चर क्यों महत्वपूर्ण है
एकाधिक लेयर मॉडल को सरल परिवर्तन को मिलाकर अधिक जटिल बनाते हैं। विज़न में, कुछ सीखे गए फीचर स्थानीय टेक्सचर से कार्य‑विशिष्ट पैटर्न की ओर बढ़ सकते हैं। भाषा में, अटेंशन लेयर संदर्भ‑निर्भर टोकन प्रतिनिधित्व बनाते हैं। ये विवरण उपयोगी अंतर्दृष्टि हैं, न कि यह निश्चित नियम कि प्रत्येक लेयर को क्या सीखना चाहिए।
आधुनिक नेटवर्क रेजिडुअल कनेक्शन, सामान्यीकरण, सावधानीपूर्वक इनिशियलाइज़ेशन, रेग्युलराइज़ेशन और अनुकूलित हार्डवेयर पर भी निर्भर करते हैं। केवल लेयर या पैरामीटर जोड़ने से मॉडल को प्रशिक्षित करना कठिन, धीमा या ओवरफिटिंग के प्रति अधिक संवेदनशील हो सकता है। मॉडल का स्केल तभी मदद करता है जब डेटा, लक्ष्य, ऑप्टिमाइज़ेशन और डिप्लॉयमेंट सेटिंग इसे समर्थन करती हों।
प्रशिक्षण बनाम अनुमान
प्रशिक्षण पैरामीटर को समायोजित करता है और आमतौर पर गणना‑गहन चरण होता है। अनुमान प्रशिक्षित मॉडल को चलाकर आउटपुट उत्पन्न करता है। बड़े मॉडलों के लिए अनुमान अभी भी महंगा हो सकता है, इसलिए टीमें क्वांटाइज़ेशन, डिस्टिलेशन, बैचिंग, कैशिंग, स्पार्सिटी और न्यूरल प्रोसेसिंग यूनिट्स जैसे विशेष हार्डवेयर का उपयोग करती हैं।
सीमाएँ और जिम्मेदार उपयोग
डीप मॉडल पूर्वाग्रह को विरासत में ले सकते हैं, संवेदनशील जानकारी को याद रख सकते हैं, वितरण परिवर्तन के तहत विफल हो सकते हैं, और प्रभावशाली लेकिन गलत आउटपुट उत्पन्न कर सकते हैं। इन्हें समझना कठिन और प्रशिक्षण महंगा भी हो सकता है। मूल्यांकन को केवल बेंचमार्क औसत से अधिक कवर करना चाहिए: टीमों को वर्ग‑या उपसमूह‑स्तर का प्रदर्शन, मजबूती, कैलिब्रेशन, सुरक्षा, लेटेंसी, ऊर्जा उपयोग और विफलता के परिणामों की आवश्यकता होती है।
प्रतिनिधित्व, अनुकूलन, और आर्किटेक्चर विकल्प
डीप नेटवर्क पैरामीटराइज्ड लेयरों के माध्यम से क्रमिक प्रतिनिधित्व सीखते हैं। रैखिक परिवर्तन इनपुट को मिश्रित करते हैं; गैर‑रेखीय सक्रियण नेटवर्क को जटिल फ़ंक्शन का अनुमान लगाने की अनुमति देते हैं; सामान्यीकरण और रेजिडुअल कनेक्शन अनुकूलन में मदद करते हैं; अटेंशन, कॉन्वॉल्यूशन, रिकरेंस, या स्टेट‑स्पेस ऑपरेशन विभिन्न संरचनात्मक धारणाओं को एन्कोड करते हैं। गहराई परिवर्तन की संख्या बढ़ाती है, न कि गारंटीकृत बुद्धिमत्ता। आर्किटेक्चर को कार्य की मोडैलिटी, डेटा मात्रा, लेटेंसी, मेमोरी और इनवेरिएंसेस को प्रतिबिंबित करना चाहिए। जब डेटा सीमित हो और स्थानीय स्थानिक संरचना प्रमुख हो, तो एक छोटा कॉन्वॉल्यूशनल मॉडल ट्रांसफॉर्मर से बेहतर प्रदर्शन कर सकता है।
प्रशिक्षण लॉस की गणना करता है, बैकप्रोपेगेशन के साथ उसका अवकलन करता है, और पैरामीटर को स्टोकेस्टिक ग्रेडिएंट डिसेंट या Adam जैसे ऑप्टिमाइज़र से अपडेट करता है। बैच आकार, लर्निंग रेट, शेड्यूल, इनिशियलाइज़ेशन, रेग्युलराइज़ेशन, और संख्यात्मक परिशुद्धता परस्पर क्रिया करती हैं। प्रशिक्षण और वैलिडेशन लॉस की वक्रें अंडरफ़िटिंग, ओवरफ़िटिंग, अस्थिरता, और लीक को अलग करने में मदद करती हैं, लेकिन वे वास्तविक‑दुनिया उपयोगिता स्थापित नहीं करतीं। स्वतंत्र मूल्यांकन डेटा, दोहराव वाले रन जहाँ वैरिएंस मायने रखता है, एब्लेशन, और सरल बेसलाइन के साथ तुलना का उपयोग करें। बड़े पैरामीटर संख्या डेटा गवर्नेंस, कंप्यूट प्लानिंग, और पुनरुत्पादन योग्य कॉन्फ़िगरेशन की आवश्यकता भी बढ़ाती है।
डीप मॉडलों को सुरक्षित और कुशलता से सर्व करना
डिप्लॉयमेंट एक होस्टेड एंडपॉइंट, समर्पित एक्सेलेरेटर, ब्राउज़र, फोन, या एम्बेडेड डिवाइस का उपयोग कर सकता है। निर्यात और संकलन ऑपरेटरों को फ्यूज़ कर सकते हैं, वज़न और सक्रियण को क्वांटाइज़ कर सकते हैं, या संख्यात्मक व्यवहार बदल सकते हैं, इसलिए केवल प्रशिक्षण चेकपॉइंट के बजाय डिप्लॉय किए गए आर्टिफैक्ट को मान्य करना आवश्यक है। ठंडा स्टार्ट, स्थिर लेटेंसी, थ्रूपुट, मेमोरी, पावर, और वास्तविक बैच व सीक्वेंस आकार पर गुणवत्ता को मापें। संपीड़न विधियाँ—प्रूनिंग, डिस्टिलेशन, क्वांटाइज़ेशन, और लो‑रैंक एडैप्टेशन—आकार या गति को सटीकता और इंजीनियरिंग जटिलता के विरुद्ध बदलती हैं और इन्हें संवेदनशील वर्गों और एज केसों पर मूल्यांकन करना चाहिए।
डीप मॉडल वितरण परिवर्तन, प्रतिकूल इनपुट, झूठी सहसंबंध, और खराब प्रतिनिधित्व वाले समूहों के तहत आत्मविश्वास से विफल हो सकते हैं। इनपुट और आउटपुट वितरण, कार्य परिणाम, कैलिब्रेशन, संसाधन उपयोग, और डिपेंडेंसी संस्करणों की निगरानी करें। एक्सेस कंट्रोल, साइन किए गए आर्टिफैक्ट, संरक्षित प्रशिक्षण डेटा, रेड टीमिंग, और थ्रेट मॉडल के अनुसार रेट लिमिट का उपयोग करें। सैलियेंसी मैप या अटेंशन व्यू जैसी व्याख्याएँ निदानात्मक प्रमाण हैं, कारण सिद्ध करने का प्रमाण नहीं। इन्हें व्यवहारिक परीक्षण, काउंटरफ़ैक्चुअल, मानव समीक्षा, घटना प्रतिक्रिया, और स्वचालित निर्णयों पर स्पष्ट सीमाओं के साथ मिलाएँ।
व्यावहारिक उदाहरण: इमेज दोष डिटेक्टर का प्रशिक्षण
एक फैक्ट्री कैमरों, शिफ्टों, सामग्रियों और ज्ञात दोष वर्गों के across उत्पाद छवियों को एकत्र करती है, फिर उत्पादन बैच के आधार पर विभाजन करती है ताकि निकट‑डुप्लिकेट आइटम विभाजनों को पार न कर सकें। एक छोटा कॉन्वॉल्यूशनल बेसलाइन को एक प्री‑ट्रेंड डीप नेटवर्क के साथ तुलना किया जाता है। ऑगमेंटेशन वैध प्रकाश और दृश्य कोण विविधता को पुन: उत्पन्न करता है बिना दोषों को मिटाए। मूल्यांकन प्रति‑दोष रिकॉल, फॉल्स‑रिजेक्ट रेट, कैलिब्रेशन, अनुमान लेटेंसी, और ब्लर, ग्लेयर, कैमरा बदलना, तथा दुर्लभ सामग्री रंगों के प्रति मजबूती रिपोर्ट करता है।
निर्यातित मॉडल और सटीक रिसाइज़, कलर, तथा सामान्यीकरण कोड को लाइन हार्डवेयर पर सतत थ्रूपुट और थर्मल व्यवहार के लिए परीक्षण किया जाता है। कम‑विश्वास मामलों को निरीक्षकों को भेजा जाता है; एक स्वतंत्र नियम सुरक्षा‑महत्वपूर्ण सेंसर विफलता के लिए लाइन को रोकता है। छवियों को केवल अनुमति के अनुसार ही रखा जाता है और मॉडल आर्टिफैक्ट साइन किए जाते हैं। मॉनिटरिंग भविष्यवाणियों को बाद के निरीक्षण परिणामों और उत्पादन लॉट्स से जोड़ती है। नया कैमरा या सामग्री नियंत्रित पुनर्मूल्यांकन को ट्रिगर करता है, न कि अनदेखे लेबलों से मौन ऑनलाइन लर्निंग को।
कार्यान्वयन प्रमाण और परिचालन तत्परता
एक उत्पादन निर्णय को सफल डेमो से अधिक चाहिए। इरादे वाले उपयोगकर्ता, संचालन वातावरण, इनपुट, आउटपुट, डिपेंडेंसी, मालिक, और प्रत्येक महत्वपूर्ण विफलता के परिणाम को परिभाषित करें। ट्यूनिंग से पहले एक पुनरुत्पादनीय बेसलाइन और एक संस्करणित मूल्यांकन सेट स्थापित करें। सामान्य मामलों, सीमा स्थितियों, विकृत या अनुपलब्ध इनपुट, वितरण परिवर्तन, डिपेंडेंसी आउटेज, दुरुपयोग, और सबसे अधिक उपेक्षित समूहों या वातावरणों का परीक्षण करें। कार्य गुणवत्ता को कैलिब्रेशन या अनिश्चितता, लेटेंसी, थ्रूपुट, संसाधन लागत, पहुँचयोग्यता, गोपनीयता, और सुरक्षा के साथ मापें। प्रत्येक परिवर्तन और थ्रेशोल्ड को रिकॉर्ड करें ताकि एक स्वतंत्र समीक्षक परिणाम को पुन: उत्पन्न कर सके और आकर्षक प्रोटोटाइप से प्रमाण को अलग कर सके।
लॉन्च से पहले रिलीज़, अपवाद, परिवर्तन, रोलबैक, और रिटायरमेंट के लिए अधिकार निर्धारित करें। चरणबद्ध रोलआउट का उपयोग करें, एक सुरक्षित फॉलबैक बनाए रखें, और जानबूझकर इंजेक्टेड फेल्योर के साथ मॉनिटरिंग को सत्यापित करें। ऑपरेशनल टेलीमेट्री को इनपुट गुणवत्ता, आउटपुट व्यवहार, मॉडल या नियम संस्करण, डिपेंडेंसी स्वास्थ्य, मानव ओवरराइड, और पुष्टि किए गए परिणाम दिखाने चाहिए, बिना अनावश्यक संवेदनशील डेटा एकत्र किए। अलर्ट थ्रेशोल्ड और रिस्पॉन्स ओनर को परिभाषित करें, फिर डिप्लॉयमेंट के बाद वास्तविक‑दुनिया प्रमाण की समीक्षा करें, न कि ऑफ़लाइन प्रदर्शन को स्थायी मानें। डेटा स्रोत, उपयोगकर्ता, मॉडल, विक्रेता, नीति, हार्डवेयर, या लक्ष्य बदलने पर पुनः मूल्यांकन करें। एक बनाए रखा सिस्टम दस्तावेज़ित रिकवरी, घटना सीखना, विलोपन और रिटेंशन प्रक्रियाएँ, और एक स्पष्ट बिंदु भी चाहिए जहाँ इसे निष्क्रिय या प्रतिस्थापित किया जाना चाहिए।
प्राथमिक संदर्भ












