
एआई की मूल बातें
मशीन लर्निंग क्या है?

 Unite.AI को Google पर अपने पसंदीदा स्रोतों में जोड़ें
Machine learning (ML) एक कृत्रिम बुद्धिमत्ता की शाखा है जिसमें एक प्रणाली डेटा से पैटर्न सीखती है ताकि वह भविष्यवाणी, वर्गीकरण, सिफ़ारिश या निर्णय ले सके बिना डेवलपर के प्रत्येक संभावित केस के लिए अलग नियम लिखे। परिणाम ऐसा मशीन नहीं है जो व्यक्ति की तरह “सोचे”। यह एक सांख्यिकीय मॉडल है जो इनपुट को उपयोगी आउटपुट से मैप करता है और ऐसे डेटा पर मूल्यांकन किया जा सकता है जिसे प्रशिक्षण के दौरान नहीं देखा गया।
Machine learning … while डीप लर्निंग एक मशीन‑लर्निंग विधियों का परिवार है जो मल्टी‑लेयर न्यूरल नेटवर्क के आसपास निर्मित है। यह अंतर महत्वपूर्ण है: हर AI प्रणाली ML का उपयोग नहीं करती, और हर ML समस्या को न्यूरल नेटवर्क की आवश्यकता नहीं होती।
मुख्य बिंदु
- ML उदाहरणों से संबंध सीखता है, केवल हाथ से लिखे नियमों पर निर्भर नहीं रहता।
- एक उपयोगी मॉडल को नए डेटा पर सामान्यीकरण करना चाहिए, केवल अपने प्रशिक्षण सेट को याद नहीं रखना चाहिए।
- सुपरवाइज़्ड, अनसुपरवाइज़्ड, सेमी‑सुपरवाइज़्ड, सेल्फ‑सुपरवाइज़्ड और रिइन्फोर्समेंट लर्निंग विभिन्न प्रकार की समस्याओं को हल करते हैं।
- डेटा की गुणवत्ता, मूल्यांकन डिज़ाइन और मॉनिटरिंग एल्गोरिदम जितनी ही महत्वपूर्ण हैं।
मशीन लर्निंग कैसे काम करती है
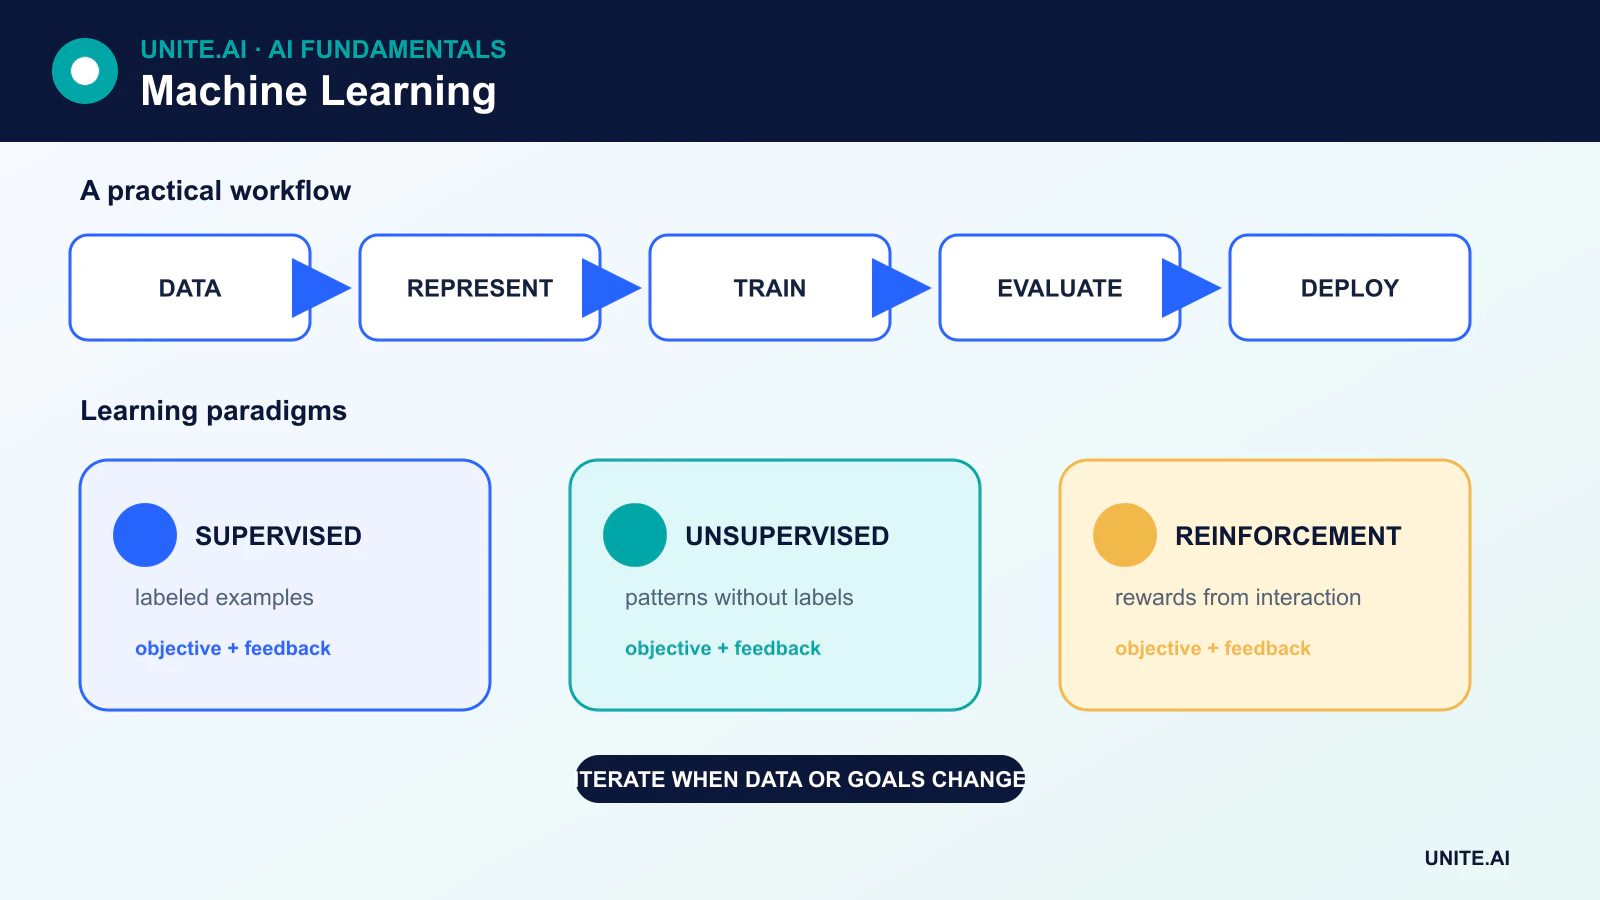
अधिकांश ML प्रोजेक्ट्स को छह चरणों की श्रृंखला के रूप में समझा जा सकता है:
- कार्य को परिभाषित करें। तय करें कि प्रणाली को क्या भविष्यवाणी या खोज करनी चाहिए और वास्तविक अनुप्रयोग में सफलता का क्या अर्थ है।
- डेटा एकत्रित करें और तैयार करें। रिकॉर्ड साफ़ करें, लापता मानों को संभालें, उपयोगी फीचर बनाएं, और डेटा के स्रोत का दस्तावेज़ बनाएं।
- डेटा को विभाजित करें। एक प्रशिक्षण सेट मॉडल को फिट करने के लिए उपयोग किया जाता है, एक वैलिडेशन सेट सेटिंग्स चुनने में मदद करता है, और एक टेस्ट सेट अनछुए डेटा पर अंतिम अनुमान प्रदान करता है।
- मॉडल को प्रशिक्षित करें। एक एल्गोरिदम मॉडल पैरामीटर को समायोजित करता है ताकि लॉस फ़ंक्शन को कम किया जा सके या किसी अन्य लर्निंग उद्देश्य को पूरा किया जा सके।
- सामान्यीकरण का मूल्यांकन करें। मीट्रिक को कार्य, वर्ग संतुलन, त्रुटि लागत और उस जनसंख्या को प्रतिबिंबित करना चाहिए जिस पर मॉडल कार्य करेगा।
- तैनात करें और मॉनिटर करें। वास्तविक दुनिया का डेटा बदल सकता है, इसलिए टीमें ड्रिफ्ट, प्रदर्शन गिरावट, पक्षपात और परिचालन विफलताओं की निगरानी करती हैं।
मॉडल को प्रदान किए गए वेरिएबल्स को आमतौर पर फ़ीचर कहा जाता है। सुपरवाइज़्ड लर्निंग में, वांछित उत्तर को लेबल या टार्गेट कहा जाता है। मॉडल के सीखे हुए पैरामीटर फ़ीचर और आउटपुट के बीच संबंध को एन्कोड करते हैं; वे स्पष्ट नियमों का डेटाबेस नहीं होते।
मुख्य शिक्षण प्रतिमान
सुपरवाइज़्ड लर्निंग
सुपरवाइज़्ड लर्निंग में, उदाहरणों में इनपुट और ज्ञात टार्गेट दोनों शामिल होते हैं। एक वर्गीकरण मॉडल श्रेणियों की भविष्यवाणी करता है, जैसे कि कोई लेनदेन धोखाधड़ी है या नहीं। एक रिग्रेशन मॉडल निरंतर मान की भविष्यवाणी करता है, जैसे अपेक्षित ऊर्जा मांग।
सामान्य सुपरवाइज़्ड एल्गोरिदम में डिसीजन ट्रीज़, सपोर्ट वेक्टर मशीन, K-नियरस्ट नेबर्स, रैखिक और लॉजिस्टिक रिग्रेशन, ग्रेडिएंट‑बूस्टेड ट्रीज़, और न्यूरल नेटवर्क शामिल हैं। 0.5 जैसी वर्गीकरण थ्रेशोल्ड मॉडल द्वारा स्कोर या प्रॉबेबिलिटी उत्पन्न करने के बाद चुना गया निर्णय है; यह लॉजिस्टिक रिग्रेशन की अपरिवर्तनीय विशेषता नहीं है।
अनसुपरवाइज़्ड लर्निंग
अनसुपरवाइज़्ड लर्निंग ऐसे डेटा के साथ काम करती है जिसमें टार्गेट लेबल नहीं होते। उद्देश्य क्लस्टर खोजना, असामान्य अवलोकनों का पता लगाना, वितरण का अनुमान लगाना, या निम्न‑आयामी प्रतिनिधित्व बनाना हो सकता है। एक क्लस्टर समानता नियम द्वारा सुझाया गया समूह है; यह स्वचालित रूप से वास्तविक दुनिया की अर्थपूर्ण वर्ग नहीं होता।
उदाहरणों में K-मीन्स क्लस्टरिंग, प्रिंसिपल कंपोनेंट एनालिसिस, डेंसिटी एस्टिमेशन, और कुछ प्रकार के ऑटोएन्कोडर शामिल हैं। एक ऑटोएन्कोडर अपने इनपुट को संपीड़ित प्रतिनिधित्व के माध्यम से पुनर्निर्माण सीखता है। यह स्वचालित रूप से ग्राउंड‑ट्रुथ लेबल नहीं बनाता।
सेमी‑सुपरवाइज़्ड और सेल्फ‑सुपरवाइज़्ड लर्निंग
सेमी‑सुपरवाइज़्ड लर्निंग एक छोटे लेबल्ड डेटासेट को बड़े अनलेबल्ड डेटासेट के साथ मिलाती है। सेल्फ‑सुपरवाइज़्ड लर्निंग डेटा स्वयं से एक प्रशिक्षण संकेत बनाती है—उदाहरण के लिए, मास्क किए गए शब्दों की भविष्यवाणी करना या समान छवि के दो परिवर्तित दृश्यों को मिलाना। सेल्फ‑सुपरविज़न कई आधुनिक ट्रांसफ़ॉर्मर और फाउंडेशन‑मॉडल पाइपलाइन में केंद्रीय है क्योंकि यह बड़ी मात्रा में टेक्स्ट, इमेज, ऑडियो या वीडियो का उपयोग कर सकता है बिना प्रत्येक उदाहरण को व्यक्ति द्वारा लेबल किए।
रीइन्फोर्समेंट लर्निंग
रीइन्फोर्समेंट लर्निंग में, एक एजेंट पर्यावरण में क्रियाएँ करता है और इनाम या लागत प्राप्त करता है। उद्देश्य ऐसी नीति सीखना है जो अपेक्षित संचयी इनाम को अधिकतम करे। यह सुपरवाइज़्ड लर्निंग से अलग है क्योंकि प्रत्येक स्थिति के लिए सही कार्रवाई प्रदान नहीं की जाती, और एक कार्रवाई अगले डेटा को प्रभावित कर सकती है जो एजेंट को मिलता है।
प्रशिक्षण, वैलिडेशन, और सामान्यीकरण
एक मॉडल जो अपने प्रशिक्षण उदाहरणों पर अच्छा प्रदर्शन करता है, वह नए डेटा पर विफल हो सकता है। इस विफलता को ओवरफ़िटिंग कहा जाता है। टीमें इसे उचित मॉडल क्षमता, रेग्युलराइज़ेशन, क्रॉस‑वैलिडेशन, डेटा ऑग्मेंटेशन, लीक रोकथाम, और एक वास्तविक स्वतंत्र टेस्ट सेट के माध्यम से कम करती हैं।
हर ML कार्य के लिए कोई एकल मीट्रिक नहीं है। वर्गीकरण में शुद्धता, रिकॉल, F1, कैलिब्रेशन, या लागत‑भारित माप की आवश्यकता हो सकती है बजाय कच्ची सटीकता के। रिग्रेशन में माध्य निरपेक्ष त्रुटि, मूल वर्गमूल त्रुटि, या डोमेन‑विशिष्ट लॉस उपयोग किया जा सकता है। क्लस्टरिंग को आंतरिक या बाहरी मान्य मूल्यांकन के विभिन्न रूपों की आवश्यकता होती है। मीट्रिक को यह प्रतिबिंबित करना चाहिए कि उपयोगकर्ता या संगठन के लिए त्रुटि का क्या अर्थ है।
Machine learning algorithms are tools, not guarantees
एक एल्गोरिदम कुछ मान्यताएँ ले जाता है। रैखिक मॉडल एक विशिष्ट प्रकार के संबंध को मानते हैं। K-नियरस्ट नेबर्स मानता है कि चयनित दूरी सार्थक समानता दर्शाती है। नाइव बेयस मानता है कि वर्ग दिए जाने पर फीचर शर्तीय रूप से स्वतंत्र होते हैं। डिसीजन ट्रीज़ सीखे हुए विभाजन नियमों का उपयोग करके फीचर स्पेस को विभाजित करते हैं; उनकी पत्तियों में प्रशिक्षण अवलोकनों के समूहों के आधार पर भविष्यवाणियाँ होती हैं, न कि आवश्यक रूप से प्रत्येक अवलोकन के लिए एक।
इसलिए मॉडल चयन डेटा आकार, फीचर प्रकार, लेटेंसी आवश्यकताएँ, व्याख्यात्मकता की जरूरत, और त्रुटियों की लागत पर निर्भर करता है। जब डेटा सीमित हो या परिचालन प्रतिबंध गति और पारदर्शिता को प्राथमिकता दें, तो एक सरल मॉडल बड़े मॉडल से बेहतर प्रदर्शन कर सकता है।
मशीन लर्निंग कहाँ उपयोग होती है
ML खोज रैंकिंग, सिफ़ारिशें, पूर्वानुमान, विसंगति पहचान, अनुवाद, स्पीच रिकग्निशन, कंप्यूटर विज़न, प्रेडिक्टिव मेंटेनेंस, धोखाधड़ी पहचान, और वैज्ञानिक विश्लेषण को समर्थन देता है। वही तकनीकें ऐतिहासिक पक्षपात को बढ़ा सकती हैं, संवेदनशील जानकारी उजागर कर सकती हैं, या वितरण परिवर्तन के तहत अप्रत्याशित व्यवहार कर सकती हैं। जिम्मेदार तैनाती के लिए दस्तावेज़ीकरण, जहाँ आवश्यक हो मानव निगरानी, सुरक्षा परीक्षण, और निरंतर मॉनिटरिंग आवश्यक है।
समस्या परिभाषा से एक वैध मशीन-लर्निंग प्रयोग तक
एक मशीन-लर्निंग प्रोजेक्ट को एक निर्णय और मापनीय परिणाम से शुरू होना चाहिए, न कि एक एल्गोरिदम से। भविष्यवाणी इकाई, टार्गेट, अवलोकन समय, निर्णय समय, उपलब्ध फीचर, और प्रत्येक त्रुटि की लागत को परिभाषित करें। उदाहरण के लिए, चर्न मॉडल में, रद्दीकरण के बाद रिकॉर्ड किए गए इवेंट्स का उपयोग उत्तर को लीक कर देगा। एक सरल नियम या सांख्यिकीय बेसलाइन स्थापित करें, फिर डेटा को समय, ग्राहक, स्थान, या तैनाती को दर्शाने वाली किसी अन्य सीमा के अनुसार विभाजित करें। यादृच्छिक पंक्ति विभाजन लगभग समान अवलोकनों को प्रशिक्षण और परीक्षण सेट में रख सकता है और भ्रामक स्कोर उत्पन्न कर सकता है।
फ़ीचर इंजीनियरिंग कच्चे रिकॉर्ड को मॉडल द्वारा उपयोग योग्य प्रतिनिधित्व में बदलती है, लेकिन प्रत्येक फ़ीचर को स्रोत और उपलब्धता की गारंटी चाहिए। सामान्यीकरण, शब्दावली, इम्प्यूटेशन, और आयाम घटाव को केवल प्रशिक्षण डेटा पर फिट करें, फिर सीखी गई परिवर्तन को वैलिडेशन और टेस्ट डेटा पर लागू करें। क्रॉस‑वैलिडेशन नमूनों के बीच विविधता का अनुमान लगाता है; एक अंतिम अनछुआ टेस्ट सेट रिलीज़ निर्णय का समर्थन करता है। परिणामों से मीट्रिक चुनें: असमान वर्गीकरण त्रुटियों के लिए प्रिसिशन और रिकॉल, जब संभावनाएँ कार्रवाई को प्रेरित करती हैं तो कैलिब्रेशन, और जब त्रुटियों के विभिन्न परिचालन प्रभाव होते हैं तो लागत‑या उपयोगिता‑भारित माप।
तैनाती, मॉनिटरिंग, और जिम्मेदार संचालन
प्रोडक्शन इन्फ़रेंस पूर्ण प्रशिक्षण‑समय परिवर्तन को दोहराता है और लेटेंसी, थ्रूपुट, और उपलब्धता प्रतिबंधों के तहत एक भविष्यवाणी लौटाता है। मॉडल के साथ प्रीप्रोसेसिंग को पैकेज करें, इनपुट स्कीमा को वैलिडेट करें, आर्टिफैक्ट्स के संस्करण बनाएं, और ऑफ़लाइन और सर्विंग इम्प्लीमेंटेशन के बीच परिणामों की तुलना करें। डिफ़ॉल्ट 0.5 के बजाय ऑपरेटिंग क्षमता और त्रुटि ट्रेडऑफ़ का उपयोग करके थ्रेशोल्ड चुनें। शैडो मूल्यांकन, सीमित कोहोर्ट, या गार्डरेल मीट्रिक वाले प्रयोग के माध्यम से रोल आउट करें। निर्भरता विफलता या अस्वीकार्य व्यवहार के लिए एक निर्धारक फॉलबैक और रोलबैक पाथ रखें।
इनपुट गुणवत्ता, फीचर ड्रिफ्ट, भविष्यवाणी वितरण, कैलिब्रेशन, सबग्रुप परिणाम, लेटेंसी, लागत, और जब पुष्टि किए गए लेबल अंततः आते हैं, उन्हें मॉनिटर करें। ड्रिफ्ट जांच का संकेत है, न कि स्वचालित प्रमाण कि पुनः प्रशिक्षण मदद करेगा। पुनः प्रशिक्षण के लिए समीक्षा किया गया डेटा, दोहराने योग्य परीक्षण, अनुमोदन, और वर्तमान चैंपियन के साथ तुलना आवश्यक है। इच्छित और अवैध उपयोग, डेटा अधिकार, गोपनीयता, सुरक्षा, मानव ओवरराइड, और जहाँ लोग प्रभावित होते हैं वहाँ अपील को दस्तावेज़ित करें। मशीन लर्निंग एक रखरखाव किया गया निर्णय प्रणाली है; मॉडल फ़ाइल केवल एक प्रतिस्थापनीय घटक है।
व्यावहारिक उदाहरण: उपकरण विफलता की भविष्यवाणी
एक निर्माता प्रति मशीन‑दिन एक भविष्यवाणी परिभाषित करता है: क्या सात दिनों के भीतर एक सत्यापित विफलता होगी, केवल उस दिन की शुरुआत में उपलब्ध टेलीमेट्री का उपयोग करके। यह मशीन और समय के अनुसार विभाजित करता है, आयु‑और थ्रेशोल्ड‑आधारित नियमों से तुलना करता है, प्रशिक्षण डेटा पर प्रीप्रोसेसिंग फिट करता है, और इवेंट रिकॉल, फ़ॉल्स अलर्ट, चेतावनी लीड टाइम, कैलिब्रेशन, और मेंटेनेंस क्षमता का मूल्यांकन करता है। सेंसर प्रतिस्थापन और नियोजित शटडाउन को संचालन संदर्भ के रूप में मॉडल किया जाता है न कि सामान्य अवलोकन के रूप में।
मॉडल पहले शैडो मोड में चलता है। अलर्ट योगदान देने वाली टेलीमेट्री और अनिश्चितता दिखाते हैं, लेकिन मेंटेनर तय करते हैं कि निरीक्षण करना है या नहीं। निष्कर्ष और पुष्टि किए गए कारण शासित लेबल बनते हैं; कार्य आदेश की अनुपस्थिति को विफलता नहीं मानना नहीं माना जाता। एक चरणबद्ध रोलआउट अलर्ट सीमाओं और मैनुअल फॉलबैक का उपयोग करता है, जबकि मॉनिटरिंग सेंसर स्वास्थ्य, इनपुट ड्रिफ्ट, समीक्षा की गई प्रिसिशन, डाउनटाइम, और अनावश्यक मेंटेनेंस को ट्रैक करती है। पुनः प्रशिक्षण केवल तब होता है जब डेटा और थ्रेशोल्ड समीक्षा वर्तमान तैनात सिस्टम पर संभावित सुधार दर्शाती है।
कार्यान्वयन प्रमाण और परिचालन तत्परता
एक प्रोडक्शन निर्णय को सफल डेमो से अधिक चाहिए। इच्छित उपयोगकर्ता, संचालन पर्यावरण, इनपुट, आउटपुट, निर्भरताएँ, मालिक, और प्रत्येक महत्वपूर्ण विफलता के परिणाम को परिभाषित करें। ट्यूनिंग से पहले एक पुनरुत्पादनीय बेसलाइन और संस्करणित मूल्यांकन सेट स्थापित करें। सामान्य मामलों, सीमा शर्तों, विकृत या लापता इनपुट, वितरण परिवर्तन, निर्भरता आउटेज, दुरुपयोग, और सबसे अधिक अधूरा रहने वाले समूहों या पर्यावरणों का परीक्षण करें। कार्य गुणवत्ता को कैलिब्रेशन या अनिश्चितता, लेटेंसी, थ्रूपुट, संसाधन लागत, पहुंच, गोपनीयता, और सुरक्षा के साथ मापें। प्रत्येक परिवर्तन और थ्रेशोल्ड को रिकॉर्ड करें ताकि एक स्वतंत्र समीक्षक परिणाम को पुन: उत्पन्न कर सके और आकर्षक प्रोटोटाइप से प्रमाण को अलग कर सके।
लॉन्च से पहले, रिलीज़, अपवाद, परिवर्तन, रोलबैक, और रिटायरमेंट के लिए अधिकार सौंपें। चरणबद्ध रोलआउट का उपयोग करें, एक सुरक्षित फॉलबैक बनाए रखें, और जानबूझकर डाली गई विफलताओं के साथ मॉनिटरिंग को सत्यापित करें। ऑपरेशनल टेलीमेट्री को इनपुट गुणवत्ता, आउटपुट व्यवहार, मॉडल या नियम संस्करण, निर्भरता स्वास्थ्य, मानव ओवरराइड, और पुष्टि किए गए परिणाम दिखाने चाहिए बिना अनावश्यक संवेदनशील डेटा एकत्र किए। अलर्ट थ्रेशोल्ड और प्रतिक्रिया मालिक को परिभाषित करें, फिर तैनाती के बाद वास्तविक‑विश्व प्रमाण की समीक्षा करें बजाय यह मानने के कि ऑफ़लाइन प्रदर्शन बना रहेगा। जब भी डेटा स्रोत, उपयोगकर्ता, मॉडल, विक्रेता, नीतियां, हार्डवेयर, या लक्ष्य बदलें, पुनः मूल्यांकन करें। एक रखरखाव किया गया सिस्टम दस्तावेज़ित पुनर्प्राप्ति, घटना सीखना, हटाने और रखरखाव प्रक्रियाओं, और एक स्पष्ट बिंदु की भी आवश्यकता रखता है जहाँ इसे निष्क्रिय या प्रतिस्थापित किया जाना चाहिए।
प्राथमिक संदर्भ












