
एआई की मूल बातें
आयामी घटाव क्या है?

 Unite.AI को Google पर अपने पसंदीदा स्रोतों में जोड़ें
आयामी घटाव डेटा को कम चर के साथ प्रस्तुत करता है जबकि कार्य के लिए उपयोगी जानकारी को संरक्षित रखता है। यह संग्रहण और शोर को कम कर सकता है, दृश्यांकन में सुधार करता है, अतिरिक्त विशेषताओं को घटाता है और डाउनस्ट्रीम मॉडल को प्रशिक्षित करना आसान बनाता है।
कोई भी विधि सभी संबंधों को नहीं रख सकती। एक उपयोगी घटाव यह निर्धारित करके शुरू होता है कि क्या बरकरार रहना चाहिए: विविधता, वर्ग विभाजन, स्थानीय पड़ोस, वैश्विक ज्यामिति, पुनर्निर्माण गुणवत्ता या व्याख्यात्मकता।
मुख्य बिंदु
- फ़ीचर चयन मूल चरों को बरकरार रखता है; फ़ीचर निष्कर्षण नए निम्न-आयामी निर्देशांक बनाता है।
- पीसीए रैखिक और विविधता‑उन्मुख है; t‑SNE और UMAP दृश्यांकन के लिए पड़ोस संरचना पर ज़ोर देते हैं।
- दृश्यांकन एम्बेडिंग्स दूरी, क्लस्टर आकार और वैश्विक विभाजन को विकृत कर सकते हैं।
- घटाव को केवल प्रशिक्षण डेटा पर फिट करें, फिर सीखे गए रूपांतरण को मान्यकरण और परीक्षण डेटा पर लागू करें।
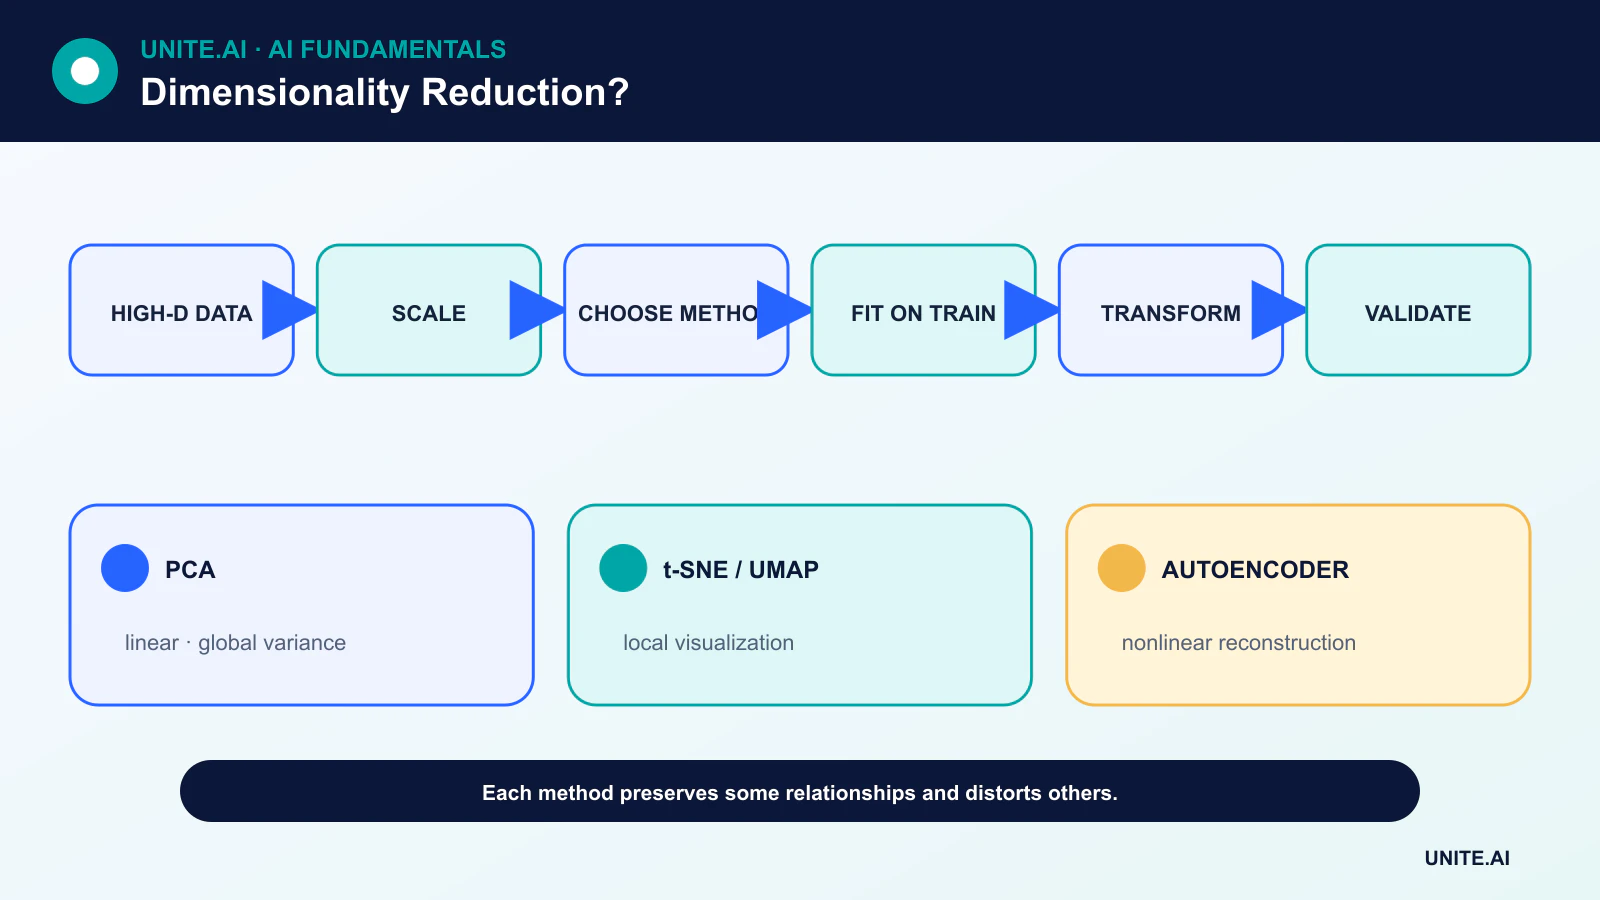
फ़ीचर चयन बनाम प्रोजेक्शन
फ़ीचर चयन डोमेन नियमों, अनुपलब्धता, अतिरिक्तता, भविष्यवाणी परीक्षण या नियमितीकरण का उपयोग करके चरों को हटाता है। यह मूल अर्थों को बरकरार रखता है, जो शासन और व्याख्या में मदद कर सकते हैं।
प्रोजेक्शन विधियाँ चरों को नए निर्देशांक में संयोजित करती हैं। वे वितरित संरचना को पकड़ सकती हैं लेकिन प्रत्येक निर्देशांक को समझना कठिन बना सकती हैं। एक ऑटोएन्कोडर पुनर्निर्माण के माध्यम से एक गैर‑रेखीय प्रोजेक्शन सीखता है।
PCA और SVD
प्रिंसिपल कंपोनेंट एनालिसिस डेटा को केंद्रित करने के बाद घटती हुई विविधता की लम्बवत दिशाओं की पहचान करता है। सिंगुलर वैल्यू डिकम्पोज़िशन एक सामान्य संख्यात्मक मार्ग प्रदान करता है। स्केलिंग महत्वपूर्ण है: उच्च‑विविधता माप इकाई घटकों पर हावी हो सकती है।
PCA संकेत और दोहराए गए ईजेनवैल्यू तक निर्धारक है, आउट‑ऑफ़‑सैंपल रूपांतरण का समर्थन करता है और व्याख्यायित‑विविधता सारांश प्रदान करता है। उच्च विविधता हमेशा कार्य‑संबंधी नहीं होती, और रैखिक घटक सभी वक्रीय मैनिफोल्ड को अनफ़ोल्ड नहीं कर सकते।
t‑SNE और UMAP
t‑SNE पड़ोसियों पर संभाव्यता वितरण बनाता है और स्थानीय समानता पर ज़ोर देने वाला निम्न‑आयामी मानचित्र अनुकूलित करता है। UMAP एक भारित पड़ोस ग्राफ बनाता है और संबंधित स्थानीय‑संरचना लक्ष्यों के साथ निम्न‑आयामी प्रतिनिधित्व को अनुकूलित करता है।
दोनों ही शक्तिशाली अन्वेषणात्मक उपकरण हैं लेकिन पूर्व‑प्रसंस्करण, दूरी मीट्रिक और हाइपरपैरामीटर के प्रति संवेदनशील होते हैं। 2D प्लॉट में खाली स्थान, क्लस्टर क्षेत्र और क्लस्टरों के बीच की दूरी को स्वचालित रूप से वास्तविक‑विश्व व्याख्या नहीं दी जानी चाहिए।
सुपरवाइज़्ड विधियाँ और कार्य‑जागरूक प्रतिनिधित्व
लीनियर डिस्क्रिमिनेंट एनालिसिस वर्ग लेबल का उपयोग करके विभाजन की खोज करता है, जिससे यह अनसुपरवाइज़्ड PCA से अलग होता है। न्यूरल प्रतिनिधित्व सीखना पुनर्निर्माण के बजाय भविष्यवाणी या कंट्रास्टिव उद्देश्यों को अनुकूलित कर सकता है।
यदि लेबल घटाव को मार्गदर्शन देते हैं, तो सभी फिटिंग और ट्यूनिंग प्रशिक्षण प्रक्रिया के भीतर ही रहनी चाहिए। अन्यथा परीक्षण सेट की जानकारी मॉडल चयन में लीक हो सकती है और एक आशावादी परिणाम उत्पन्न कर सकती है।
विधि का चयन और सत्यापन
पहले पूर्व‑प्रसंस्करण और एक सरल बेसलाइन से शुरू करें। संपीड़न के लिए, विभिन्न आयामों पर पुनर्निर्माण या डाउनस्ट्रीम प्रदर्शन को मापें। दृश्यांकन के लिए, बीज और हाइपरपैरामीटर के across स्थिरता का परीक्षण करें और डोमेन ज्ञान के साथ पड़ोस संरक्षण की तुलना करें।
प्रोडक्शन के लिए, पूछें कि क्या विधि नए रिकॉर्ड को रूपांतरित कर सकती है, यह अनुपलब्ध मानों को कैसे संभालती है, पुनः‑प्रशिक्षण पर क्या बदलती है और क्या उपयोगकर्ताओं को मूल‑फ़ीचर की व्याख्याएँ चाहिए। ओवरफ़िटिंग घटाव चरण में भी हो सकती है जैसे अंतिम मॉडल में।
रैखिक और गैर‑रैखिक घटाव विधियाँ
आयामी घटाव उच्च‑आयामी डेटा को कम निर्देशांकों में मैप करता है जबकि चयनित संरचना को बरकरार रखता है। प्रिंसिपल कंपोनेंट एनालिसिस केंद्रित करने के बाद अधिकतम विविधता की लम्बवत दिशाएँ खोजता है; जब इकाइयों को तुलनीय रूप से योगदान देना हो तो स्केलिंग आवश्यक है। सिंगुलर वैल्यू डिकम्पोज़िशन संबंधित लो‑रैंक संरचना की गणना करता है और विरल मैट्रिक्स का समर्थन करता है। लीनियर डिस्क्रिमिनेंट एनालिसिस लेबल का उपयोग करके वर्ग‑विभाजन दिशाएँ खोजता है। ये विधियाँ स्पष्ट रूपांतरण देती हैं, लेकिन विविधता या वर्ग विभाजन आवश्यक जानकारी को डाउनस्ट्रीम कार्य के लिए बरकरार नहीं रख सकती।
t‑SNE और UMAP जैसी मैनिफोल्ड विधियाँ पड़ोस बनाती हैं और एक निम्न‑आयामी लेआउट को अनुकूलित करती हैं। वे अन्वेषण के लिए शक्तिशाली हैं लेकिन वैश्विक दूरी, घनत्व, क्लस्टर आकार और कभी‑कभी विभाजन को विकृत करती हैं। परिणाम पूर्व‑प्रसंस्करण, मीट्रिक, पड़ोस या पर्प्लेक्सिटी, प्रारंभिककरण और बीज पर निर्भर करते हैं। दो आयामों में एक आकर्षक क्लस्टर बिना स्पष्ट समूहों के भी उत्पन्न हो सकता है। कई सेटिंग्स का उपयोग करें, केवल उन मेटाडेटा द्वारा रंगें जो फिटिंग में उपयोग नहीं हुए, और मूल स्थान या स्वतंत्र लेबल के साथ दिखी हुई संरचना को सत्यापित करें।
फ़ीचर चयन, एम्बेडिंग और मूल्यांकन
फ़ीचर चयन फ़िल्टर, रैपर या मॉडल‑आधारित महत्व के माध्यम से मूल चरों को बरकरार रखता है; प्रतिनिधित्व सीखना ऑटोएन्कोडर या सुपरवाइज़्ड मॉडल का उपयोग करके नए अंतर्निहित फीचर बनाता है। रैंडम प्रोजेक्शन कुछ शर्तों के तहत दूरी को लगभग संरक्षित रखते हैं और कुशल बेसलाइन प्रदान करते हैं। विधि का चयन संपीड़न, दृश्यांकन, शोर घटाव, गति, संग्रहण या मॉडल प्रदर्शन के आधार पर करें। घटावकर्ता को केवल प्रशिक्षण डेटा पर फिट करें, फिर मान्यकरण और परीक्षण सेट को रूपांतरित करें। सुपरवाइज़्ड घटाव को लेबल लीक से बचने के लिए क्रॉस‑वैलिडेशन के भीतर नेस्टेड होना चाहिए।
रैखिक संपीड़न के लिए व्याख्यायित विविधता या पुनर्निर्माण, दृश्यांकन के लिए विश्वसनीयता और पड़ोस संरक्षण, तथा भविष्यवाणी के लिए डाउनस्ट्रीम शुद्धता, कैलिब्रेशन, लेटेंसी और मजबूती का मूल्यांकन करें। नमूनों और बीजों के बीच स्थिरता को मापें। जांचें कि क्या दुर्लभ वर्ग या संवेदनशील समूह संकुचित हो रहे हैं और क्या उलटा मैपिंग संभव है। घटाए गए निर्देशांक अभी भी निजी जानकारी रख सकते हैं; दो‑आयामी प्लॉट गुमनामकरण नहीं है। रूपांतरण, स्केलर, फ़ीचर क्रम और सीमाओं का दस्तावेज़ बनाएं।
प्रोडक्शन उपयोग
सेवा के लिए सटीक फिटेड ट्रांसफ़ॉर्म और इनपुट स्कीमा आवश्यक है। अनुपलब्ध फीचर, रेंज शिफ्ट, घटक स्कोर वितरण, पुनर्निर्माण त्रुटि और डाउनस्ट्रीम परिणामों की निगरानी करें। यदि नई श्रेणियाँ या सेंसर प्रकट होते हैं, तो बिना चुपचाप कॉलम जोड़ने के पूरे पाइपलाइन को पुनः‑प्रशिक्षित और संस्करणित करें। घटाव कंप्यूट को सुधार सकता है और मॉडल से शोर को हटाता है, लेकिन यह दुर्लभ घटनाओं के लिए महत्वपूर्ण कमजोर संकेतों को भी हटा सकता है। इसे एक सीखा हुआ मापन चरण मानें, जिसके रखे और खोए गए जानकारी को निर्णय के विरुद्ध परीक्षण करना आवश्यक है।
व्यावहारिक उदाहरण: ग्राहक‑व्यवहार फ़ीचर घटाना
एक विश्लेषक 200 व्यवहारात्मक मापदंडों को मानकीकृत करता है और केवल प्रशिक्षण ग्राहकों पर PCA फिट करता है। क्रॉस‑वैलिडेशन घटकों की संख्या को डाउनस्ट्रीम चर्न प्रदर्शन और स्थिरता के आधार पर चुनता है, न कि दो‑आयामी स्कैटरप्लॉट पर। लोडिंग्स को प्रमुख स्रोतों और अनुपलब्धता के लिए जाँचा जाता है। PCA, फ़ीचर चयन, रैंडम प्रोजेक्शन और एक अपरिवर्तित नियमितीकृत मॉडल को कैलिब्रेशन, लेटेंसी और दुर्लभ ग्राहक खंडों के परिणामों के आधार पर तुलना किया जाता है। दोहराए गए नमूने यह भी परीक्षण करते हैं कि प्रमुख घटक और डाउनस्ट्रीम निष्कर्ष स्थिर रहते हैं या नहीं।
डिप्लॉय किया गया पाइपलाइन फ़ीचर क्रम, स्केलर और घटकों को स्थिर करता है और अनुपलब्ध स्कीमा संस्करणों को अस्वीकार करता है। मॉनिटरिंग घटक वितरण, पुनर्निर्माण त्रुटि और डाउनस्ट्रीम परिणामों को ट्रैक करती है। एक दृश्यांकन जिसमें स्पष्ट क्लस्टर दिखते हैं, प्रश्न उत्पन्न करने के लिए उपयोग किया जाता है, न कि ग्राहक पर्सोना असाइन करने के लिए। क्योंकि अंतर्निहित घटक अभी भी व्यवहार को एन्कोड करते हैं, पहुंच और रखरखाव नियंत्रित रहता है। यदि स्रोत परिभाषाएँ बदलती हैं, तो पूर्ण ट्रांसफ़ॉर्म और मॉडल को पुनः बनाकर सत्यापित किया जाता है, न कि असंगत डेटा को पुराने घटकों में प्रोजेक्ट किया जाए।
कार्यान्वयन प्रमाण और संचालन तत्परता
एक प्रोडक्शन निर्णय को सफल प्रदर्शन से अधिक की आवश्यकता होती है। इच्छित उपयोगकर्ताओं, संचालन वातावरण, इनपुट, आउटपुट, निर्भरताएँ, मालिक और प्रत्येक महत्वपूर्ण विफलता के परिणाम को परिभाषित करें। ट्यूनिंग से पहले एक पुनरुत्पादनीय बेसलाइन और संस्करणित मूल्यांकन सेट स्थापित करें। सामान्य मामलों, सीमा स्थितियों, विकृत या अनुपलब्ध इनपुट, वितरण परिवर्तन, निर्भरता आउटेज, दुरुपयोग, और उन समूहों या वातावरणों का परीक्षण करें जो सबसे अधिक सेवा‑विहीन हो सकते हैं। कार्य गुणवत्ता को कैलिब्रेशन या अनिश्चितता, लेटेंसी, थ्रूपुट, संसाधन लागत, पहुँच, गोपनीयता और सुरक्षा के साथ मापें। प्रत्येक रूपांतरण और थ्रेशोल्ड को रिकॉर्ड करें ताकि एक स्वतंत्र समीक्षक परिणाम को पुनः उत्पन्न कर सके और आकर्षक प्रोटोटाइप से प्रमाण को अलग कर सके।
लॉन्च से पहले, रिलीज़, अपवाद, परिवर्तन, रोलबैक और रिटायरमेंट के लिए अधिकार निर्धारित करें। चरणबद्ध रोलआउट का उपयोग करें, एक सुरक्षित फ़ॉलबैक बनाए रखें, और जानबूझकर डाली गई विफलताओं के साथ मॉनिटरिंग को सत्यापित करें। ऑपरेशनल टेलीमेट्री को इनपुट गुणवत्ता, आउटपुट व्यवहार, मॉडल या नियम संस्करण, निर्भरता स्वास्थ्य, मानव ओवरराइड और पुष्टि किए गए परिणाम दिखाने चाहिए, बिना अनावश्यक संवेदनशील डेटा एकत्र किए। अलर्ट थ्रेशोल्ड और प्रतिक्रिया मालिक को परिभाषित करें, फिर डिप्लॉयमेंट के बाद वास्तविक‑विश्व प्रमाण की समीक्षा करें, न कि यह मान कर कि ऑफ़लाइन प्रदर्शन बना रहेगा। जब भी डेटा स्रोत, उपयोगकर्ता, मॉडल, विक्रेता, नीतियाँ, हार्डवेयर या लक्ष्य बदलें, पुनः‑मूल्यांकन करें। एक बनाए रखा गया सिस्टम दस्तावेज़ीकृत पुनर्प्राप्ति, घटना सीखना, हटाने और रखरखाव प्रक्रियाओं, और एक स्पष्ट बिंदु की भी आवश्यकता रखता है जहाँ इसे निष्क्रिय या प्रतिस्थापित किया जाना चाहिए।
अक्सर पूछे जाने वाले प्रश्न
क्या आयामी घटाव हमेशा मॉडल को बेहतर बनाता है?
नहीं। यह भविष्यवाणी जानकारी को हटा सकता है या व्याख्या को जटिल बना सकता है। बिना‑घटाव बेसलाइन के विरुद्ध होल्ड‑आउट डेटा पर तुलना करें।
क्या अलग‑अलग t‑SNE क्लस्टर वास्तविक वर्गों के अस्तित्व को सिद्ध करते हैं?
नहीं। यह मानचित्र पड़ोस संबंधों का एक अनुकूलित दृश्यांकन है और यह दिखावटी विभाजन बना सकता है। क्लस्टरों को स्वतंत्र प्रमाण के साथ सत्यापित करें।
प्राथमिक संदर्भ












