
एआई की मूल बातें
ऑटोएन्कोडर क्या है?

 Unite.AI को Google पर अपने पसंदीदा स्रोतों में जोड़ें
एक ऑटोएन्कोडर एक न्यूरल नेटवर्क है जिसे उसके इनपुट को पुनःनिर्मित करने के लिए प्रशिक्षित किया जाता है। एक एन्कोडर इनपुट को एक लैटेंट प्रतिनिधित्व में मैप करता है; एक डिकोडर उस प्रतिनिधित्व को वापस पुनर्निर्माण में मैप करता है। प्रशिक्षण पुनर्निर्माण हानि को न्यूनतम करता है, कभी‑कभी अतिरिक्त प्रतिबंधों के साथ।
इनपुट को पूरी तरह से कॉपी करना स्वचालित रूप से उपयोगी नहीं है। वास्तुकला या उद्देश्य को एक बॉटलनेक बनाना चाहिए, शोर जोड़ना चाहिए, विरलता लागू करनी चाहिए या अन्यथा एक साधारण पहचान मैपिंग को रोकना चाहिए ताकि लैटेंट कोड उपयोगी संरचना को पकड़ सके।
मुख्य बिंदु
- एन्कोडर इनपुट को संकुचित या रूपांतरित करता है; डिकोडर उसे लैटेंट कोड से पुनर्निर्मित करता है।
- एक अधूरा बॉटलनेक, शोर या नियमितीकरण मॉडल को कॉपी करने के बजाय संरचना सीखने के लिए प्रेरित करता है।
- पुनर्निर्माण त्रुटि विसंगति पहचान में सहायक हो सकती है, लेकिन विसंगतियों में उच्च त्रुटि होना अनिवार्य नहीं है।
- वैरिएशनल ऑटोएन्कोडर एक संभाव्यात्मक लैटेंट मॉडल सीखते हैं और निर्धारक ऑटोएन्कोडर से अलग होते हैं।
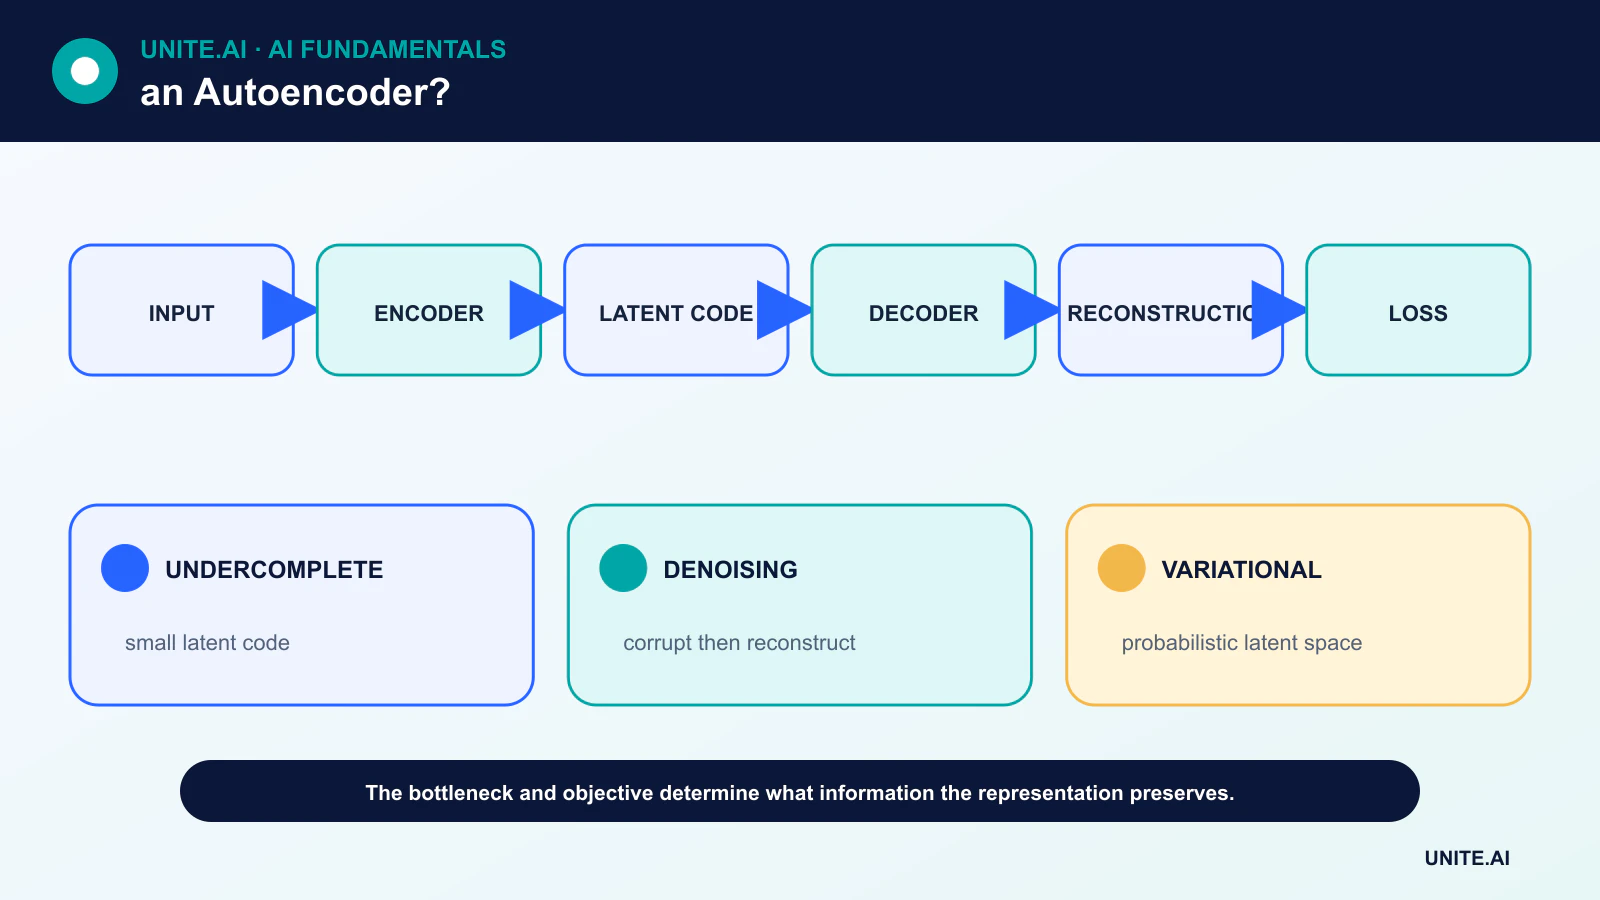
एन्कोडर, लैटेंट स्पेस और डिकोडर
इनपुट x के लिए, एन्कोडर लैटेंट कोड z = f(x) उत्पन्न करता है और डिकोडर पुनर्निर्माण x̂ = g(z) उत्पन्न करता है। हानि x और x̂ की तुलना करती है, उदाहरण के लिए निरंतर मानों के लिए औसत वर्ग त्रुटि (MSE) या डेटा के अनुकूल संभाव्यता के साथ।
लैटेंट आयाम इनपुट से छोटा हो सकता है, जिससे एक अधूरा ऑटोएन्कोडर बनता है। एक गहरा नेटवर्क गैर‑रेखीय प्रतिनिधित्व भी सीख सकता है, जो आयाम घटाव के पीछे के विचार को विस्तारित करता है।
सामान्य ऑटोएन्कोडर रूपांतर
एक विरल (स्पार्स) ऑटोएन्कोडर व्यापक सक्रियता पर दंड लगाता है। एक डिनॉइज़िंग ऑटोएन्कोडर दूषित इनपुट प्राप्त करता है और साफ़ संस्करण को पुनर्निर्मित करता है। एक कॉन्ट्रैक्टिव ऑटोएन्कोडर कोड की छोटे इनपुट परिवर्तन के प्रति संवेदनशीलता पर दंड लगाता है।
एक वैरिएशनल ऑटोएन्कोडर (VAE) संभाव्य वितरण के पैरामीटर एन्कोड करता है, लैटेंट मान का नमूना लेता है और पुनर्निर्माण को एक नियमितीकरण पद के साथ संतुलित करता है जो लैटेंट स्पेस को आकार देता है। यह नमूना लेने का समर्थन करता है लेकिन उद्देश्य और व्याख्या को बदल देता है।
प्रशिक्षण और साधारण समाधान से बचाव
ऑटोएन्कोडर अन्य न्यूरल नेटवर्क की तरह बैकप्रोपेगेशन का उपयोग करते हैं। अत्यधिक क्षमता वाला नेटवर्क प्रशिक्षण उदाहरणों को याद कर सकता है या लगभग‑पहचान फ़ंक्शन सीख सकता है। बॉटलनेक आकार, शोर, दंड और अप्रकट डेटा पर सत्यापन इसे सीमित करते हैं।
हानि का चयन महत्वपूर्ण है। पिक्सेल‑वाइज़ हानि धुंधली छवि पुनर्निर्माण उत्पन्न कर सकती है, जबकि परसेप्चुअल हानियों में दूसरे नेटवर्क की धारणाएँ विरासत में मिलती हैं। सबसे अच्छा पुनर्निर्माण मेट्रिक अनिवार्य रूप से अर्थपूर्ण समानता का सर्वोत्तम माप नहीं होता।
उपयोग और सीमाएँ
ऑटोएन्कोडर फीचर सीख सकते हैं, संकेतों को डिनॉइज़ कर सकते हैं, डेटा को संकुचित कर सकते हैं, मॉडल को प्रारम्भिक बना सकते हैं और दृश्यांकन के लिए लैटेंट वेरिएबल उत्पन्न कर सकते हैं। विसंगति पहचान के लिए, सामान्य डेटा पर प्रशिक्षित मॉडल असामान्य इनपुट पर उच्च पुनर्निर्माण त्रुटि दे सकता है।
यह दृष्टिकोण तब विफल हो सकता है जब ऑटोएन्कोडर भी विसंगतियों को अच्छी तरह पुनर्निर्मित करता है या जब हानिरहित विविधता लक्ष्य विसंगति से अधिक पुनर्निर्माण में कठिन हो। थ्रेशहोल्ड को लेबल किए गए या सावधानीपूर्वक समीक्षा किए गए सत्यापन डेटा की आवश्यकता होती है, और त्रुटि को उपसमूह और संचालन स्थिति के अनुसार मॉनिटर किया जाना चाहिए।
ऑटोएन्कोडर बनाम अन्य जेनरेटिव मॉडल
एक निर्धारक ऑटोएन्कोडर स्वचालित रूप से एक संभाव्यात्मक जेनरेटिव मॉडल नहीं होता। VAEs एक संरचित लैटेंट वितरण निर्धारित करते हैं; GANs जनरेटर को डिस्क्रिमिनेटर के विरुद्ध प्रशिक्षित करते हैं; डिफ्यूज़न मॉडल डिनॉइज़िंग प्रक्रिया सीखते हैं।
चयन इस पर निर्भर करता है कि लक्ष्य पुनर्निर्माण, प्रतिनिधित्व, संभाव्यता, नमूना विश्वसनीयता, नियंत्रणीयता या विसंगति स्कोरिंग है या नहीं। अक्सर एक छोटा कार्य‑विशिष्ट मॉडल बड़े इमेज जनरेटर की तुलना में अधिक व्यावहारिक होता है।
एन्कोडर‑डिकोडर उद्देश्य और लैटेंट प्रतिनिधित्व
एक ऑटोएन्कोडर एक एन्कोडर सीखता है जो इनपुट x को लैटेंट कोड z में मैप करता है और एक डिकोडर जो z से x को पुनर्निर्मित करता है। यदि क्षमता असीमित है, तो यह कम उपयोगी संरचना के साथ पहचान मैपिंग सीख सकता है। बॉटलनेक, नियमितीकरण, शोर, विरलता या वास्तुशिल्पीय प्रतिबंध चयनित जानकारी को संरक्षित रखने वाला प्रतिनिधित्व मजबूर करते हैं। पुनर्निर्माण हानि यह निर्धारित करती है कि समान क्या माना जाता है: औसत वर्ग त्रुटि औसत पिक्सेल विश्वसनीयता को प्राथमिकता देती है, जबकि परसेप्चुअल या मोडैलिटी‑विशिष्ट हानियाँ विभिन्न विशेषताओं पर ज़ोर देती हैं। कम हानि अनिवार्य रूप से अर्थपूर्ण अर्थ की गारंटी नहीं देती।
अधूरा ऑटोएन्कोडर लैटेंट आयाम को सीमित करता है। डिनॉइज़िंग ऑटोएन्कोडर दूषित इनपुट से साफ़ डेटा को पुनर्निर्मित करता है। विरल रूपांतर सक्रियता पर दंड लगाते हैं; कॉन्ट्रैक्टिव रूपांतर संवेदनशीलता पर दंड लगाते हैं। वैरिएशनल ऑटोएन्कोडर पुनर्निर्माण को एक विचलन पद के साथ मिलाकर संभाव्यात्मक लैटेंट वितरण सीखते हैं, जिससे नमूना लेना संभव होता है लेकिन उद्देश्य बदल जाता है। कॉन्वॉल्यूशनल, सीक्वेंस, ग्राफ़ और ट्रांसफ़ॉर्मर ऑटोएन्कोडर मोडैलिटी संरचना को एन्कोड करते हैं। लैटेंट आकार और नियमितीकरण को डाउनस्ट्रीम सत्यापन के माध्यम से चुनें, न कि केवल आकर्षक द्वि‑आयामी प्लॉट से।
विसंगति पहचान, संपीड़न और मूल्यांकन
विसंगति पहचान के लिए, प्रतिनिधिक सामान्य डेटा पर प्रशिक्षित करें और पुनर्निर्माण त्रुटि या लैटेंट संभाव्यता को स्कोर करें, लेकिन कभी‑कभी विसंगतियों को अच्छी तरह पुनर्निर्मित किया जा सकता है और दुर्लभ सामान्य मामलों को खराब। लेबल किए गए या समीक्षा किए गए सत्यापन मामलों पर थ्रेशहोल्ड चुनें, घटना‑स्तर की रिकॉल और गलत अलार्म रिपोर्ट करें, और संचालन स्थिति में बदलावों का परीक्षण करें। सरल सांख्यिकीय और वन‑क्लास बेसलाइन के साथ तुलना करें। संपीड़न के लिए, संपूर्ण कोडेक गिनें—जिसमें मॉडल आकार, क्वांटाइज़ेशन, मेटाडेटा और डिकोड गणना शामिल है—और स्थापित कोडेक के साथ समान बिटरेट पर गुणवत्ता की तुलना करें।
प्रतिनिधित्व गुणवत्ता को रैखिक प्रोब, क्लस्टर स्थिरता, रिट्रीवल, पुनर्निर्माण और डाउनस्ट्रीम कार्यों के माध्यम से मूल्यांकित किया जा सकता है, प्रत्येक अलग प्रश्न का उत्तर देता है। एन्कोडर सीखते समय और थ्रेशहोल्ड चुनते समय लीक से बचें। जांचें कि हानि किन विशेषताओं को अनदेखा करती है और क्या संवेदनशील गुण अभी भी एन्कोडेड हैं। संकुचित लैटेंट स्वचालित रूप से अनाम नहीं होता; उलटाव और गुण अनुमान निजी जानकारी पुनः प्राप्त कर सकते हैं। उत्पन्न पुनर्निर्माण भी विश्वसनीय दिख सकते हैं जबकि महत्वपूर्ण विवरण बदलते हैं।
परिनियोजन और मॉनिटरिंग
एन्कोडर और डिकोडर को साथ में संस्करणित करें, निर्यात के बाद संख्यात्मक बदलावों को सत्यापित करें, और इनपुट स्केलिंग को बनाए रखें। पुनर्निर्माण वितरण, लैटेंट ड्रिफ्ट, थ्रेशहोल्ड अलर्ट और पुष्टि किए गए परिणामों की निगरानी करें। औद्योगिक मॉनिटरिंग में, मॉडल को संचालन मोड के अनुसार स्थित करें ताकि सामान्य परिवर्तन को दोष न माना जाए। चिकित्सा या वैज्ञानिक पुनर्निर्माण में, वैधता और स्रोत के बिना उत्पन्न विवरण को मापित प्रमाण के रूप में कभी प्रस्तुत न करें। ऑटोएन्कोडर लचीले प्रतिनिधित्व शिक्षार्थी हैं, लेकिन प्रतिबंध और हानि—वास्तुकला नाम नहीं—निर्धारित करती हैं कि कौन सी जानकारी रखी, त्यागी या निर्मित होती है।
व्यावहारिक उदाहरण: पंप विसंगतियों के लिए एक ऑटोएन्कोडर
एक अधूरा ऑटोएन्कोडर लोड और तापमान के विभिन्न स्थितियों में सत्यापित स्वस्थ पंप संचालन से कंपन विंडो सीखता है। इसे सांख्यिकीय थ्रेशहोल्ड और वन‑क्लास विधियों से तुलना किया जाता है, और इसका पुनर्निर्माण थ्रेशहोल्ड समीक्षा किए गए सामान्य परिवर्तन और ज्ञात दोषों पर चुना जाता है। मूल्यांकन घटना रिकॉल, चेतावनी अग्रिम समय, प्रति संचालन घंटे गलत अलार्म, और पंप‑वार परिणामों का उपयोग करता है, न कि यादृच्छिक विंडो जो क्रमिक नमूनों को ट्रेन और टेस्ट में रखती हैं।
उत्पादन मॉडल संचालन स्थिति के अनुसार स्थित होता है और शेष पैटर्न को इंजीनियरों के सामने लाता है। उच्च त्रुटि निरीक्षण का अनुरोध करती है; यह भाग का निदान नहीं करता या पंप को स्वचालित रूप से बंद नहीं करता। सेंसर डिस्कनेक्ट, क्लिपिंग, और अप्रकट लोड स्पष्ट अमान्य स्थितियाँ उत्पन्न करते हैं। मॉनिटरिंग पुनर्निर्माण वितरण, अलर्ट पुष्टि और सेंसर स्वास्थ्य को ट्रैक करती है। जब रखरखाव या हार्डवेयर बेसलाइन बदलता है, तो पुराना मॉडल उपलब्ध रहता है जबकि एक उम्मीदवार समीक्षा किए गए डेटा पर प्रशिक्षित किया जाता है और ऐतिहासिक घटनाओं के विरुद्ध पुनः चलाया जाता है।
कार्यान्वयन प्रमाण और परिचालन तत्परता
एक उत्पादन निर्णय को सफल प्रदर्शन से अधिक की आवश्यकता होती है। इच्छित उपयोगकर्ताओं, संचालन पर्यावरण, इनपुट, आउटपुट, निर्भरताएँ, मालिक, और प्रत्येक महत्वपूर्ण विफलता के परिणाम को परिभाषित करें। ट्यूनिंग से पहले पुनरुत्पादक बेसलाइन और संस्करणित मूल्यांकन सेट स्थापित करें। सामान्य मामलों, सीमा शर्तों, विकृत या अनुपस्थित इनपुट, वितरण बदलाव, निर्भरता आउटेज, दुरुपयोग, और उन समूहों या पर्यावरणों का परीक्षण करें जो सबसे अधिक सेवा‑हीन हो सकते हैं। कार्य गुणवत्ता को कैलिब्रेशन या अनिश्चितता, विलंब, थ्रूपुट, संसाधन लागत, पहुँच, गोपनीयता और सुरक्षा के साथ मापें। प्रत्येक परिवर्तन और थ्रेशहोल्ड को रिकॉर्ड करें ताकि एक स्वतंत्र समीक्षक परिणाम को पुनः उत्पन्न कर सके और आकर्षक प्रोटोटाइप से प्रमाण को अलग कर सके।
लॉन्च से पहले, रिलीज़, अपवाद, परिवर्तन, रोलबैक और रिटायरमेंट के लिए अधिकार निर्धारित करें। चरणबद्ध रोलआउट का उपयोग करें, एक सुरक्षित फॉलबैक बनाए रखें, और जानबूझकर इंजेक्ट किए गए विफलताओं के साथ मॉनिटरिंग को सत्यापित करें। परिचालन टेलीमेट्री को इनपुट गुणवत्ता, आउटपुट व्यवहार, मॉडल या नियम संस्करण, निर्भरता स्वास्थ्य, मानव ओवरराइड और पुष्टि किए गए परिणाम दिखाने चाहिए, बिना अनावश्यक संवेदनशील डेटा एकत्र किए। अलर्ट थ्रेशहोल्ड और प्रतिक्रिया जिम्मेदार को परिभाषित करें, फिर तैनाती के बाद वास्तविक‑विश्व प्रमाण की समीक्षा करें, न कि ऑफ़लाइन प्रदर्शन को स्थायी मानें। जब भी डेटा स्रोत, उपयोगकर्ता, मॉडल, विक्रेता, नीतियाँ, हार्डवेयर या उद्देश्य बदलें, पुनः‑मूल्यांकन करें। एक बनाए रखा गया सिस्टम दस्तावेज़ित पुनर्प्राप्ति, घटना सीखना, विलोपन और रख‑रखाव प्रक्रियाएँ, और एक स्पष्ट बिंदु चाहिए जहाँ इसे निष्क्रिय या प्रतिस्थापित किया जाना चाहिए।
अक्सर पूछे जाने वाले प्रश्न
क्या ऑटोएन्कोडर लॉसलेस संपीड़न हैं?
सामान्यतः नहीं। वे आमतौर पर कार्य‑और वितरण‑विशिष्ट हानिकारक प्रतिनिधित्व सीखते हैं और डेटा को पुनर्निर्मित करने के लिए प्रशिक्षित डिकोडर की आवश्यकता होती है।
क्या प्रत्येक बॉटलनेक व्याख्यात्मक है?
नहीं। एक संक्षिप्त कोड उपयोगी हो सकता है बिना प्रत्येक आयाम को मानव‑पठनीय अवधारणा से मैप किए।
प्राथमिक संदर्भ












