Anderson का एंगल
कैसे जानें कि छवि संश्लेषण प्रणालियां वास्तव में मौलिक सामग्री बना रही हैं

 Unite.AI को Google पर अपने पसंदीदा स्रोतों में जोड़ें

मुख्य बिंदुKAIST और NAVER का Rarity Score निकटतम पड़ोसी दूरियों के माध्यम से छवि की मौलिकता को…
और देखें
- KAIST और NAVER का Rarity Score निकटतम पड़ोसी दूरियों के माध्यम से छवि की मौलिकता को मापता है।
- Truncation Trick जैसे मौजूदा मेट्रिक्स उत्पन्न छवियों में नवीनता की तुलना में प्रामाणिकता को प्राथमिकता देते हैं।
- Rarity Score DALL-E 2 जैसी प्रणालियों से वास्तव में नवीन आउटपुट की पहचान कर सकता है।
दक्षिण कोरिया से एक नए अध्ययन ने यह निर्धारित करने के लिए एक विधि का प्रस्ताव किया है कि क्या छवि संश्लेषण प्रणालियां वास्तव में नए और मूल छवियों का उत्पादन कर रही हैं, या क्या वे केवल प्रशिक्षण डेटा पर ‘न्यून’ भिन्नताएं हैं, जो इस तरह की वास्तुकला के उद्देश्य (जैसे कि नए और मूल छवियों का उत्पादन) को पराजित कर सकती हैं।
अधिकांश समय, पत्र सुझाव देता है, बाद वाला सच होता है, क्योंकि ऐसी प्रणालियों द्वारा उपयोग किए जाने वाले मौजूदा मेट्रिक्स उनकी उत्पन्न क्षमताओं को बेहतर बनाने के लिए प्रशिक्षण के दौरान छवियों को पसंद करते हैं जो डेटासेट में गैर-नकली स्रोत छवियों के लिए अपेक्षाकृत करीब होते हैं।
अगर एक उत्पन्न छवि स्रोत डेटा के लिए ‘दृश्य रूप से करीब’ है, तो यह निश्चित रूप से ‘प्रामाणिकता’ के लिए ‘मौलिकता’ से बेहतर स्कोर करेगा, क्योंकि यह ‘वफादार’ है – यदि प्रेरणा से रहित है।
एक क्षेत्र में जो अभी भी अपने कानूनी परिणामों के लिए परिपक्व नहीं है, यह एक महत्वपूर्ण कानूनी मुद्दा साबित हो सकता है, अगर यह पता चलता है कि व्यावसायिक रूप से संश्लेषित छवि सामग्री पर्याप्त रूप से उस स्रोत सामग्री से अलग नहीं है जो अक्सर कॉपीराइटेड होती है और वर्तमान में शोध क्षेत्र में प्रवेश कर सकती है, लोकप्रिय वेब से एकत्र किए गए डेटासेट के रूप में (इस प्रकार के भविष्य के उल्लंघन दावों की संभावना हाल ही में प्रमुखता से सामने आई है, माइक्रोसॉफ्ट के गिटहब को-पायलट एआई के संबंध में)।
ओपनएआई के DALL-E 2, गूगल के Imagen, और चीन के CogView (साथ ही कम क्षमताओं वाले DALL-E mini) जैसे सिस्टम से तेजी से सुसंगत और सेमैंटिक रूप से मजबूत आउटपुट के संदर्भ में, उत्पन्न छवि की मौलिकता के लिए बहुत कम निर्माण के बाद जांच करने के तरीके हैं जिन पर विश्वास किया जा सकता है।
वास्तव में, नए डीएएल-ई 2 छवियों में से कुछ के लिए खोज करने से अक्सर केवल उन्हीं छवियों के और उदाहरण मिलेंगे, खोज इंजन पर निर्भर करते हुए।

DALL-E 2 की सभी नौ छवियों का समूह अपलोड करने पर केवल ऐसे और समूह मिलते हैं, क्योंकि ग्रिड सबसे प्रमुख विशेषता है। पहली छवि को अलग करके अपलोड करने पर—जो 8 जून 2022 को Weird Dall-E Generations खाते के इस Twitter पोस्ट में थी—गूगल चित्र की बास्केटबॉल पर अटक जाता है और खोज अर्थगत बंद गली में पहुंच जाती है। इसी छवि पर Yandex कम से कम वास्तविक पिक्सेल-आधारित विश्लेषण और विशेषताओं का मिलान करता दिखाई देता है।
हालांकि यांडेक्स गूगल सर्च की तुलना में एक जमा छवि की वास्तविक विशेषताओं (अर्थात् एक छवि की व्युत्पन्न या गणना की गई विशेषताओं, न कि लोगों की चेहरे की विशेषताओं) और दृश्य (अर्थगत के बजाय) विशेषताओं का उपयोग करने की अधिक संभावना है, तो भी सभी छवि-आधारित खोज इंजन या तो कोई लक्ष्य या कार्यप्रणाली है जो स्रोत>उत्पन्न नकल की पहचान करने में कठिनाई पैदा कर सकता है।
इसके अलावा, एक उत्पन्न मॉडल के लिए प्रशिक्षण डेटा पूरी तरह से सार्वजनिक रूप से उपलब्ध नहीं हो सकता है, जो उत्पन्न छवियों की मौलिकता की फोरेंसिक जांच को और अधिक बाधित करता है।
दिलचस्प बात यह है कि गूगल की इमेजन साइट पर दिखाई गई सिंथेटिक छवियों में से एक पर छवि-आधारित वेब खोज करने से वास्तव में उस छवि के विषय के समान कुछ भी नहीं मिलता है, जब आप छवि को देखते हैं और निष्पक्ष रूप से समान छवियों की तलाश करते हैं। इसके बजाय, गूगल अर्थ पर अटका रहता है और imagen google शब्दों को अतिरिक्त सीमित करने वाले पैरामीटर के रूप में जोड़े बिना उस चित्र की पूरी तरह छवि-आधारित खोज की अनुमति नहीं देता।

इसके विपरीत, यांडेक्स कई समान (या कम से कम दृश्य रूप से संबंधित) वास्तविक दुनिया की छवियों को खोजता है जो शौकिया कलात्मक समुदाय से हैं:

सामान्य तौर पर, यह बेहतर होगा यदि छवि संश्लेषण प्रणालियों के आउटपुट की नई या मौलिकता को किसी तरह से मापा जा सकता है, बिना यह जानने की जरूरत के कि इंटरनेट पर हर संभावित वेब-फेसिंग छवि को निकालें जब मॉडल प्रशिक्षित किया गया था, या गैर-सार्वजनिक डेटासेट में जो कॉपीराइट सामग्री का उपयोग कर सकते हैं।
इस मुद्दे से संबंधित, कोरिया एडवांस्ड इंस्टीट्यूट ऑफ साइंस एंड टेक्नोलॉजी (केएआईएसटी) में किम जेचुल ग्रेजुएट स्कूल ऑफ एआई के शोधकर्ताओं ने वैश्विक आईसीटी और खोज कंपनी नेवर कॉर्प के साथ मिलकर एक दुर्लभता स्कोर विकसित किया है जो छवि संश्लेषण प्रणालियों की अधिक मूल रचनाओं की पहचान करने में मदद कर सकता है।

छवियां StyleGAN-FFHQ से बनाई गई हैं। बाएं से दाएं स्तंभ सबसे खराब से सबसे अच्छे परिणाम दिखाते हैं। Truncation trick और Realism मापों के अपने लक्ष्य हैं, जबकि ऊपर की पंक्ति का नया Rarity Score सुसंगत होने के साथ मौलिक भी होने वाली छवियां खोजता है। लेख में चित्रों के आकार की सीमा के कारण अधिक विवरण और उच्च रिजॉल्यूशन के लिए मूल अध्ययन देखें। स्रोत: https://arxiv.org/pdf/2206.08549.pdf
नया पत्र शीर्षक दुर्लभता स्कोर: संश्लेषित छवियों की असामान्यता का मूल्यांकन करने के लिए एक नया मेट्रिक है, और इसमें केएआईएसटी के तीन शोधकर्ता और नेवर कॉर्प के तीन शोधकर्ता शामिल हैं।
सस्ते ट्रिक से परे
पिछले मेट्रिक्स में से जिन पर नया पत्र सुधार करने का प्रयास कर रहा है, उनमें 2019 में प्रस्तावित, यूके के हेरियट-वाट यूनिवर्सिटी और गूगल के डीपमाइंड के बीच सहयोग से विकसित ‘ट्रंकेशन ट्रिक’ शामिल हैं।
ट्रंकेशन ट्रिक नमूना लेने के लिए उस लेटेंट वितरण से अलग वितरण का उपयोग करता है जिसका उपयोग जनरेटिव मॉडल को प्रशिक्षित करने में किया गया था।
इस विधि को विकसित करने वाले शोधकर्ता आश्चर्यचकित थे कि यह काम करता है, लेकिन मूल पत्र में स्वीकार करते हैं कि यह उत्पन्न आउटपुट की विविधता को कम करता है। फिर भी, ट्रंकेशन ट्रिक प्रभावी और लोकप्रिय हो गया है, जो एक ‘सस्ते ट्रिक’ के संदर्भ में हो सकता है जो प्रामाणिक दिखने वाले परिणाम प्राप्त करने के लिए जो वास्तव में डेटा में निहित सभी संभावनाओं को आत्मसात नहीं करते हैं, और वांछित से अधिक स्रोत डेटा के समान हो सकते हैं।
ट्रंकेशन ट्रिक के बारे में, नए पत्र के लेखक कहते हैं:
‘[यह] प्रशिक्षण डेटासेट में दुर्लभ नमूनों का उत्पादन करने के लिए नहीं है, बल्कि अधिक स्थिर रूप से सामान्य छवियों का संश्लेषण करने के लिए है। हमें लगता है कि मौजूदा उत्पन्न मॉडल वास्तविक डेटा वितरण में अधिक समृद्ध नमूनों का उत्पादन करने में सक्षम होंगे यदि जनरेटर को प्रभावी ढंग से दुर्लभ नमूनों का उत्पादन करने के लिए प्रेरित किया जा सकता है।’
पारंपरिक मेट्रिक्स जैसे फ्रेचेट इन्सेप्शन डिस्टेंस (एफआईडी, जो दिसंबर 2021 में तीव्र आलोचना के तहत आया), इन्सेप्शन स्कोर (आईएस) और कर्नल इन्सेप्शन डिस्टेंस (केआईडी) के रूप में ‘प्रगति संकेतक’ के रूप में उपयोग की जाने वाली सामान्य प्रवृत्ति के बारे में, लेखकों ने आगे टिप्पणी की*:
‘यह सीखने की योजना उत्पादक को बहुत अधिक दुर्लभ नमूनों का संश्लेषण नहीं करने देती है जो अद्वितीय और मजबूत विशेषताओं वाले होते हैं जो वास्तविक छवि वितरण के एक बड़े हिस्से के लिए खाते नहीं हैं। सार्वजनिक डेटासेट से दुर्लभ नमूनों के उदाहरणों में एफएफएचक्यू में विभिन्न सहायक उपकरण वाले लोग, एएफएचक्यू में सफेद जानवर, और मेटफेस में असामान्य मूर्तियां शामिल हैं।
‘दुर्लभ नमूनों का उत्पादन करने की क्षमता महत्वपूर्ण है न केवल इसलिए कि यह जनरेटिव मॉडल की क्षमताओं की चरम सीमा से संबंधित है, बल्कि इसलिए भी कि अनोखापन रचनात्मक अनुप्रयोगों जैसे कि आभासी मानवों में एक महत्वपूर्ण भूमिका निभाता है।
‘हालांकि, हाल के अध्ययनों के गुणात्मक परिणामों में शायद ही कभी इन दुर्लभ उदाहरणों को शामिल किया जाता है। हमें लगता है कि प्रतिस्पर्धी सीखने की योजना की प्रकृति उत्पादित छवि वितरण को प्रशिक्षण डेटासेट के समान बनाती है। इसलिए, स्पष्ट व्यक्तित्व या दुर्लभता वाली छवियां केवल मॉडल द्वारा संश्लेषित छवियों का एक छोटा सा हिस्सा होती हैं।’
तकनीक
शोधकर्ताओं का नया दुर्लभता स्कोर पहले कार्यों में प्रस्तुत एक विचार को अपनाता है – छवि संश्लेषण प्रणाली में वास्तविक (प्रशिक्षण) और संश्लेषित (आउटपुट) डेटा की सरणियों का प्रतिनिधित्व करने के लिए के-निकटतम पड़ोसियों (केएनएन) का उपयोग करना।
इस नए विश्लेषण विधि के बारे में, लेखकों का दावा है:
‘हमें लगता है कि सामान्य नमूने एक दूसरे के करीब होंगे, जबकि अद्वितीय और दुर्लभ नमूने विशेषता स्थान में दुर्लभ रूप से स्थित होंगे।’
परिणाम छवि में सबसे छोटे से सबसे बड़े तक निकटतम पड़ोसी दूरी (एनएनडी) दिखाती है, एक स्टाइलजीएन आर्किटेक्चर में प्रशिक्षित जो एफएफएचक्यू पर है।
‘सभी डेटासेट के लिए, नमूने जिनमें सबसे छोटी एनएनडी होती है वे प्रतिनिधि और सामान्य छवियों को दिखाते हैं। इसके विपरीत, नमूने जिनमें सबसे बड़ी एनएनडी होती है उनमें मजबूत व्यक्तित्व होता है और वे सामान्य छवियों से काफी अलग होते हैं जिनमें सबसे छोटी एनएनडी होती है।’
सिद्धांत रूप में, इस नए मेट्रिक का उपयोग एक विभेदक के रूप में किया जा सकता है, या कम से कम एक अधिक जटिल विभेदक वास्तुकला में शामिल किया जा सकता है, एक उत्पन्न प्रणाली को शुद्ध अनुकरण से दूर ले जाने के लिए, एक अधिक आविष्कारशील एल्गोरिदम की ओर, जबकि सुसंगत अवधारणाओं की आवश्यक एकता को बनाए रखना जो प्रामाणिक छवि उत्पादन के लिए महत्वपूर्ण हो सकता है (अर्थात् ‘पुरुष’, ‘महिला’, ‘कार’, ‘गिरजाघर’, आदि)।
तुलना और प्रयोग
परीक्षण में, शोधकर्ताओं ने दुर्लभता स्कोर के प्रदर्शन की तुलना ट्रंकेशन ट्रिक और एनवीडिया के 2019 वास्तविकता स्कोर के खिलाफ की, और पाया कि विभिन्न फ्रेमवर्क और डेटासेट में, दृष्टिकोण ‘अद्वितीय’ परिणामों को अलग करने में सक्षम है।
हालांकि पत्र में दिखाए गए परिणाम यहां शामिल करने के लिए बहुत व्यापक हैं, शोधकर्ताओं ने प्रतीत होता है कि एक उत्पन्न प्रक्रिया में स्रोत (वास्तविक) और उत्पन्न (नकली) छवियों दोनों में दुर्लभता की पहचान करने की क्षमता का प्रदर्शन किया है:
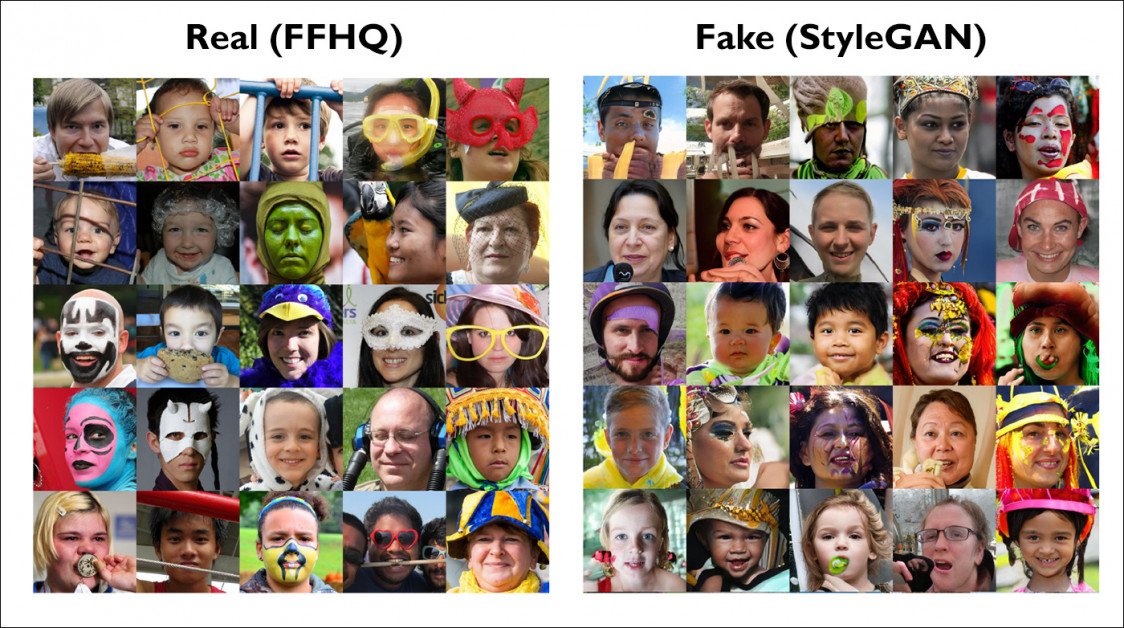
अध्ययन के व्यापक दृश्य परिणामों से चुने उदाहरण; अधिक जानकारी के लिए ऊपर दिया स्रोत देखें। बाईं ओर FFHQ की वास्तविक छवियां हैं जिनके मूल डेटासेट में बहुत कम निकट पड़ोसी हैं और जो नई व असामान्य हैं। दाईं ओर StyleGAN की बनाई छवियां हैं जिन्हें नए माप ने वास्तव में नया पहचाना। लेख की चित्र-आकार सीमा के कारण अधिक विवरण और उच्च रिजॉल्यूशन के लिए मूल अध्ययन देखें।
नई दुर्लभता स्कोर मेट्रिक न केवल एक ही वास्तुकला में उत्पन्न आउटपुट की मौलिकता की पहचान करने की अनुमति देती है, बल्कि यह भी दावा करती है कि विभिन्न वास्तुकला के उत्पन्न मॉडल की तुलना करने की अनुमति देती है (अर्थात् ऑटोएनकोडर, वीएई, जीएन, आदि)।
पत्र यह भी बताता है कि दुर्लभता स्कोर पूर्व मेट्रिक्स से अलग है जो उत्पन्न मॉडल की क्षमता पर केंद्रित है अनूठी और दुर्लभ छवियों का उत्पादन करने के लिए, पारंपरिक मेट्रिक्स के विपरीत जो प्रशिक्षण के दौरान पीढ़ियों के बीच विविधता की जांच करते हैं।
सीमित कार्यों से परे
हालांकि नए पत्र के शोधकर्ताओं ने सीमित-डोमेन फ्रेमवर्क (जैसे जनरेटर/डेटासेट संयोजन जो विशेष रूप से लोगों या बिल्लियों की तस्वीरें उत्पन्न करने के लिए डिज़ाइन किए गए हैं) पर परीक्षण किए हैं, दुर्लभता स्कोर को किसी भी मनमाने छवि संश्लेषण प्रक्रिया में लागू किया जा सकता है जहां यह वांछनीय है उत्पन्न उदाहरणों की पहचान करने के लिए जो प्रशिक्षित डेटा से व्युत्पन्न वितरण का उपयोग करते हैं, बाहरी लेटेंट वितरण जोड़कर प्रामाणिकता बढ़ाने और विविधता घटाने, या प्रामाणिकता के लिए नवीनता का त्याग करने वाले दूसरे शॉर्टकट अपनाने के बजाय।
ऐसा माप DALL-E जैसी प्रणालियों में वास्तव में नए परिणामों को अलग कर सकता है, किसी स्पष्ट अपवाद-जैसे परिणाम, प्रशिक्षण डेटा और समान निर्देशों या इनपुट—जैसे छवि-आधारित निर्देश—के परिणामों के बीच पहचानी गई दूरी का उपयोग करके।
वास्तविक अभ्यास में, और यह स्पष्ट समझ न होने पर कि प्रणाली ने दृश्य और अर्थगत अवधारणाओं को वास्तव में कितना आत्मसात किया है—जिसे प्रशिक्षण डेटा की सीमित जानकारी अक्सर बाधित करती है, यह एक व्यवहार्य विधि हो सकती है एक वास्तविक ‘प्रेरणा का क्षण’ की पहचान करने के लिए एक उत्पन्न प्रणाली में – उस बिंदु पर जहां पर्याप्त संख्या में इनपुट अवधारणाएं और डेटा कुछ वास्तविक रूप से आविष्कारशील के परिणामस्वरूप हुए हैं, इसके बजाय कुछ अत्यधिक व्युत्पन्न या स्रोत डेटा के करीब।
* मैंने लेखकों के पाठ के भीतर दिए संदर्भों को हाइपरलिंक में बदला है।
पहली बार 20 जून 2022 को प्रकाशित।