एआई की मूल बातें
K-Means क्लस्टरिंग क्या है?

 Unite.AI को Google पर अपने पसंदीदा स्रोतों में जोड़ें
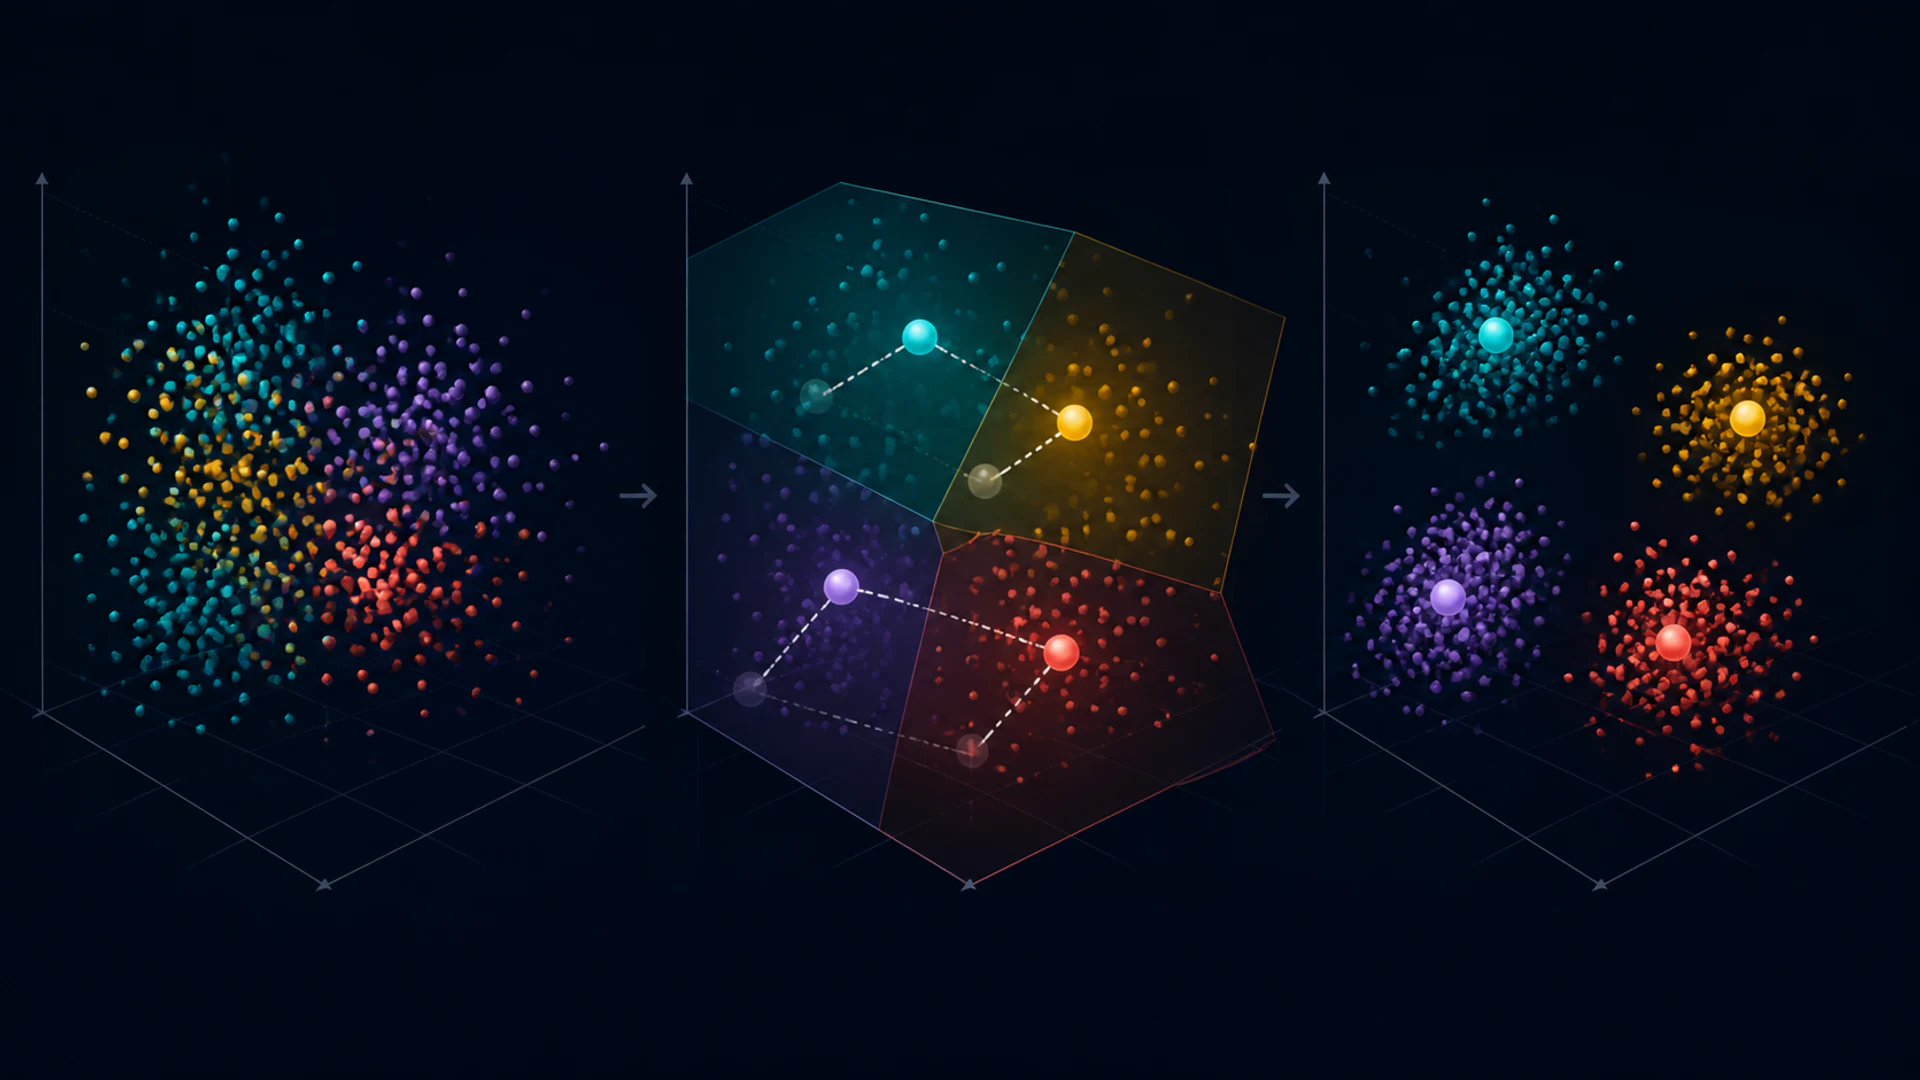
K-means एक अनसुपरवाइज़्ड एल्गोरिद्म है जो संख्यात्मक अवलोकनों को k क्लस्टरों में विभाजित करता है। यह प्रत्येक बिंदु को उसके निकटतम सेंट्रोइड को असाइन करने और असाइन किए गए बिंदुओं के औसत के रूप में प्रत्येक सेंट्रोइड को पुनः गणना करने के बीच बदलता रहता है।
एल्गोरिद्म तेज़ और उपयोगी है, लेकिन इसका परिणाम स्केलिंग, दूरी, प्रारम्भिककरण और चुने गये k द्वारा निर्धारित होता है। एक क्लस्टर गणितीय विभाजन है, स्वचालित रूप से वास्तविक‑दुनिया की श्रेणी नहीं बनता।
मुख्य बिंदु
- K-means क्लस्टर के भीतर वर्गीकृत यूक्लिडियन दूरी को सेंट्रोइड तक न्यूनतम करता है।
- प्रारम्भिककरण महत्वपूर्ण है; k-means++ प्रारम्भिक सेंट्रोइड को फैलाता है और आमतौर पर परिणाम बेहतर करता है।
- जब फीचर्स की इकाइयाँ या स्केल समान रूप से योगदान देना चाहिए, तो उन्हें मानकीकृत करें।
- K-means बाहरी मान, गैर‑गोलाकार क्लस्टर, असमान घनत्व और श्रेणीबद्ध डेटा के साथ कठिनाई महसूस करता है।
उद्देश्य और अद्यतन लूप
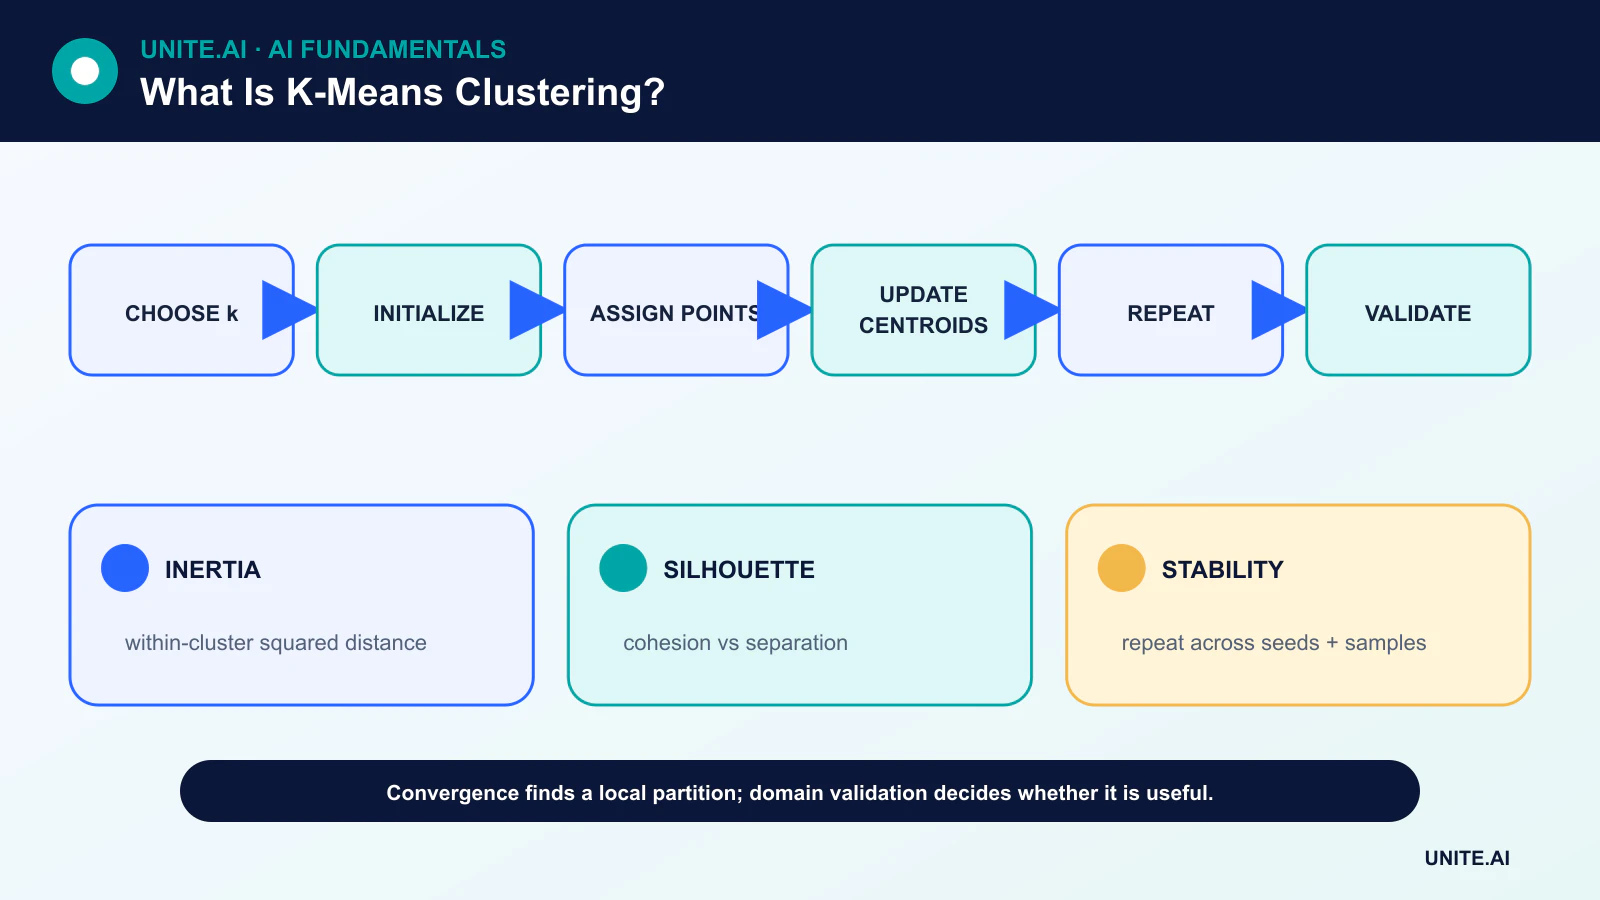
जब k सेंट्रोइड होते हैं, तो असाइनमेंट चरण प्रत्येक अवलोकन को निकटतम सेंट्रोइड को भेजता है। अद्यतन चरण प्रत्येक सेंट्रोइड को उसके असाइन किए गए अवलोकनों के औसत से बदल देता है। इन चरणों के तहत क्लस्टर के भीतर वर्गों का योग नहीं बढ़ सकता, इसलिए प्रक्रिया एक स्थानीय इष्टतम पर अभिसरित होती है।
संकलन वैश्विक इष्टतम की गारंटी नहीं देता। विभिन्न प्रारम्भिक सेंट्रोइड अलग‑अलग विभाजन दे सकते हैं, इसलिए कई प्रारम्भिककरण चलाए जाते हैं और सबसे कम इन्शिया वाले समाधान को रखा जाता है।
प्रारम्भिककरण और k-means++
एक घनी क्षेत्र से सभी प्रारम्भिक सेंट्रोइड को यादृच्छिक रूप से चुनना खराब समाधान या धीमी अभिसरण का कारण बन सकता है। k-means++ मौजूदा सेंट्रोइड से दूरी के आधार पर संभाव्यता के साथ बीज चुनता है, जिससे डेटासेट का कवरेज बढ़ता है।
कई बार चलाना उपयोगी रहता है। यादृच्छिक बीज और प्रारम्भिककरण की संख्या को रिकॉर्ड करें ताकि परिणाम दोहराए जा सकें।
स्केलिंग और दूरी
वर्गीकृत यूक्लिडियन दूरी K-means को इकाइयों के प्रति संवेदनशील बनाती है। हजारों में मापी गई विशेषता शून्य से एक के बीच मापी गई विशेषता को हावी कर सकती है। मानकीकरण सामान्य है, पर डोमेन ज्ञान को यह तय करना चाहिए कि समान मानकीकृत वैरिएंस समान महत्व दर्शाता है या नहीं।
बाहरी मान औसत को सामान्य बिंदुओं से दूर खींच सकते हैं। मजबूत स्केलिंग, ट्रिमिंग या मेडॉइड‑आधारित विधियाँ बेहतर हो सकती हैं। वन‑हॉट श्रेणीबद्ध विशेषताएँ ऐसी दूरी ज्यामिति बनाती हैं जो श्रेणी समानता से मेल नहीं खा सकती।
k चुनना और क्लस्टरों का सत्यापन
जब भी k बढ़ता है, इन्शिया घटता है, इसलिए केवल k से चयन नहीं किया जा सकता। एल्बो heuristic सुधार की घटती दर को देखता है। सिल्हूट विश्लेषण संगति और विभाजन की तुलना करता है। नमूने और बीजों के बीच स्थिरता एक अतिरिक्त जाँच जोड़ती है।
सबसे मजबूत सत्यापन इच्छित डोमेन के लिए उपयोगिता है। क्लस्टरों की तुलना ज्ञात परिणामों, विशेषज्ञ समीक्षा या डाउनस्ट्रीम कार्य से करें, बिना यह मानते हुए कि बाद‑में प्राप्त लेबल वस्तुनिष्ठ रूप से खोजे गए हैं।
सीमाएँ और विकल्प
K-means सघन, लगभग गोलाकार और समान स्केल के समूहों को पसंद करता है। गॉसियन मिश्रण मॉडल संभाव्य दीर्घवृत्तीय घटकों को दर्शाते हैं; DBSCAN‑शैली विधियाँ घनी क्षेत्रों और शोर को पहचानती हैं; पदानुक्रमित क्लस्टरिंग मर्ज़ की एक पेड़ बनाती है।
आयाम घटाना गति बढ़ा सकता है या इनपुट को डीनॉइज़ कर सकता है, लेकिन पूर्ण डेटासेट पर इसे फिट करने से सत्यापन प्रश्न बदल सकता है। मिनी‑बैच K-means बड़े डेटासेट के लिए गणना को कम करता है, लेकिन एक अनुमानित अद्यतन के साथ।
उद्देश्य, प्रारम्भिककरण, और अभिसरण
K-means संख्यात्मक अवलोकनों को k क्लस्टरों में विभाजित करता है, क्लस्टर के भीतर वर्गीकृत यूक्लिडियन दूरी को सेंट्रोइड तक न्यूनतम करके। ल्लॉयड का एल्गोरिद्म प्रत्येक बिंदु को उसके निकटतम सेंट्रोइड को असाइन करने और सेंट्रोइड को पुनः गणना करने के बीच बदलता रहता है, जब तक असाइनमेंट या उद्देश्य स्थिर न हो जाए। यह एक स्थानीय इष्टतम पर अभिसरित होता है, अनिवार्य रूप से वैश्विक सर्वोत्तम नहीं। K-means++ प्रारम्भिक केंद्रों को फैलाता है और आमतौर पर परिणाम बेहतर करता है, पर कई बीज अभी भी महत्वपूर्ण हैं। जब इकाइयों को समान रूप से योगदान देना चाहिए, तो फीचर्स को मानकीकृत करें क्योंकि वर्गीकृत दूरी उच्च‑स्केल वेरिएबल और बाहरी मानों को बढ़ा देती है।
यह विधि अनुमान लगाती है कि क्लस्टर लगभग सघन, गोलाकार, समान स्केल वाले हैं, यूक्लिडियन ज्यामिति के तहत। यह लम्बे मैनिफोल्ड, असमान घनत्व, श्रेणीबद्ध डेटा, भारी बाहरी मान, और नेस्टेड संरचना के साथ कठिनाई महसूस करता है। खाली क्लस्टर और दोहराए गए बिंदुओं को परिभाषित हैंडलिंग की आवश्यकता होती है। मिनी‑बैच k-means बड़े डेटा के लिए स्केल करता है, पर एक अनुमानित ट्रेड‑ऑफ़ के साथ। विरल पाठ के लिए, कोसाइन‑उन्मुख स्फेरिकल k-means दिशा के साथ बेहतर मेल खा सकता है, जबकि मिश्रण, घनत्व विधियाँ, पदानुक्रमित क्लस्टरिंग, या k‑medoids अन्य धारणाओं को एन्कोड करते हैं।
k चुनना और अर्थ का सत्यापन
एल्बो वक्र, सिल्हूट स्कोर, संबंधित मॉडलों में सूचना मानदंड, और स्थिरता k के चयन में मदद कर सकते हैं, पर कोई भी अद्वितीय सही संख्या नहीं खोजता। व्यावसायिक उपयोगिता और डोमेन व्याख्या महत्वपूर्ण है। नमूनों और बीजों के बीच पुनः फिट करें, सेंट्रोइड गति और असाइनमेंट स्थिरता की तुलना करें, और क्लस्टरों को स्वतंत्र परिणामों पर सत्यापित करें जो उनके निर्माण में उपयोग नहीं हुए हैं। द्वि‑आयामी प्रोजेक्शन विभाजन को विकृत कर सकता है, इसलिए मूल या सत्यापित प्रतिनिधित्व स्थान में दूरी और उदाहरणों की जाँच करें।
क्लस्टर चयनित फीचर्स और मीट्रिक द्वारा निर्मित वर्णनात्मक समूह हैं; वे प्राकृतिक प्रकार या कारणात्मक खंड नहीं होते। क्लस्टरिंग के लिए उपयोग किए गए समान वेरिएबल्स पर आधारित प्रोफ़ाइलें चक्रीय हो सकती हैं। रख‑रखाव के लिए बाहर रखे गए गुण और गुणात्मक समीक्षा उपयोग करें, और जांचें कि क्लस्टर मुख्यतः भूगोल, डेटा स्रोत, या संवेदनशील विशेषताओं को दोहराते हैं या नहीं। छोटे क्लस्टर विसंगतियां या कलाकृतियां हो सकते हैं। किसी क्लस्टर का नाम देना इसका अर्थ नहीं कि सभी सदस्य उस लेबल के अनुरूप हों।
परिनियोजन और रखरखाव
स्केलिंग, फीचर क्रम, सेंट्रोइड, दूरी परिभाषा, और क्लस्टर लेबल को एक साथ संग्रहीत करें। नए बिंदुओं के लिए, असाइन किए गए सेंट्रोइड तक दूरी और प्रशिक्षण समर्थन से बहुत दूर के अनुपात की निगरानी करें; हर मामले को क्लस्टर में मजबूर करने के बजाय एक अज्ञात स्थिति प्रदान करें। समय के साथ क्लस्टर आकार, सेंट्रोइड, और परिणाम प्रासंगिकता को ट्रैक करें। पुनः‑प्रशिक्षण क्लस्टर पहचान बदलता है, इसलिए डाउनस्ट्रीम नियमों को मैप या संस्करणित करें, बिना पुराने नामों को चुपचाप पुनः उपयोग किए। K-means एक उपयोगी संपीड़न और विभाजन आधाररेखा है जब उसकी ज्यामिति प्रश्न से मेल खाती है, सार्वभौमिक खोज इंजन नहीं।
व्यावहारिक उदाहरण: k-means के साथ ग्राहक विभाजन
एक सब्सक्रिप्शन कंपनी एक निश्चित अवधि में उपयोग फीचर्स को मानकीकृत करती है, खाता पहचानकर्ता हटाती है, और विभिन्न बीजों पर k का परीक्षण करती है। स्थिरता, सिल्हूट, और अलग‑रखे व्यापार परिणामों की समीक्षा की जाती है, पर उत्पाद टीमें प्रतिनिधि और सीमा खातों की भी जाँच करती हैं। वे पाते हैं कि एक क्लस्टर केवल नए ग्राहकों का है जिनका अवलोकन छोटा है, इसलिए सेवा अवधि को स्पष्ट रूप से संभाला जाता है। K-means की तुलना पदानुक्रमित और घनत्व‑आधारित विकल्पों से की जाती है, न कि मान लिया जाता है कि यह उपयुक्त है। इस अभ्यास को अनसुपरवाइज़्ड लर्निंग माना जाता है, लेबल खोज नहीं।
सेगमेंट शोध और संदेश प्रयोगों को दिशा देते हैं, पात्रता या मूल्य निर्धारण नहीं। हर सेंट्रोइड से दूर नए खातों को अज्ञात असाइनमेंट मिलता है। स्केलिंग, फीचर्स, सेंट्रोइड, और नामों को संस्करणित किया जाता है, और पुनः‑प्रशिक्षण केवल प्रमाण के साथ नए क्लस्टरों को पुराने से मैप करता है। मॉनिटरिंग क्लस्टर आकार, दूरी, और परिणाम प्रासंगिकता को ट्रैक करती है। संवेदनशील गुण और प्रॉक्सी की ऑडिट की जाती है, और टीम यह वर्णन करने से बचती है कि क्लस्टर प्राकृतिक व्यक्तित्व प्रकार हैं, जबकि वे चयनित व्यवहार के गणितीय विभाजन हैं।
कार्यान्वयन प्रमाण और परिचालन तत्परता
एक उत्पादन निर्णय को सफल प्रदर्शन से अधिक चाहिए। लक्षित उपयोगकर्ता, संचालन वातावरण, इनपुट, आउटपुट, निर्भरताएँ, मालिक, और प्रत्येक महत्वपूर्ण विफलता के परिणाम को परिभाषित करें। ट्यूनिंग से पहले पुनरुत्पादक बेसलाइन और संस्करणित मूल्यांकन सेट स्थापित करें। सामान्य मामलों, सीमा शर्तों, विकृत या अनुपस्थित इनपुट, वितरण परिवर्तन, निर्भरता आउटेज, दुरुपयोग, और सबसे अधिक अनदेखी समूहों या वातावरण का परीक्षण करें। कार्य गुणवत्ता को कैलिब्रेशन या अनिश्चितता, विलंब, थ्रूपुट, संसाधन लागत, पहुंच, गोपनीयता, और सुरक्षा के साथ मापें। प्रत्येक रूपांतरण और थ्रेशोल्ड को रिकॉर्ड करें ताकि एक स्वतंत्र समीक्षक परिणाम को पुनः उत्पन्न कर सके और आकर्षक प्रोटोटाइप से प्रमाण को अलग कर सके।
लॉन्च से पहले, रिलीज़, अपवाद, परिवर्तन, रोलबैक, और रिटायरमेंट के लिए अधिकार सौंपें। चरणबद्ध रोलआउट का उपयोग करें, एक सुरक्षित फॉलबैक रखें, और जानबूझकर डाली गई विफलताओं के साथ मॉनिटरिंग की पुष्टि करें। परिचालन टेलीमेट्री को इनपुट गुणवत्ता, आउटपुट व्यवहार, मॉडल या नियम संस्करण, निर्भरता स्वास्थ्य, मानव ओवरराइड, और पुष्टि किए गए परिणाम दिखाने चाहिए, बिना अनावश्यक संवेदनशील डेटा एकत्र किए। अलर्ट थ्रेशोल्ड और प्रतिक्रिया मालिक को परिभाषित करें, फिर तैनाती के बाद वास्तविक‑विश्व प्रमाण की समीक्षा करें, न कि यह मानें कि ऑफ़लाइन प्रदर्शन बना रहेगा। डेटा स्रोत, उपयोगकर्ता, मॉडल, विक्रेता, नीतियां, हार्डवेयर, या उद्देश्यों में परिवर्तन होने पर पुनः‑मूल्यांकन करें। एक रखरखाव प्रणाली को दस्तावेज़ीकृत पुनर्प्राप्ति, घटना सीखना, हटाने और प्रतिधारण प्रक्रियाओं, और एक स्पष्ट बिंदु चाहिए जहाँ इसे निष्क्रिय या बदलना चाहिए।
अक्सर पूछे जाने वाले प्रश्न
क्या K-means सुपरवाइज़्ड है या अनसुपरवाइज़्ड?
यह अनसुपरवाइज़्ड है क्योंकि यह फीचर और चुनी हुई क्लस्टर संख्या प्राप्त करता है, लक्ष्य लेबल नहीं।
क्या K-means नई डेटा को वर्गीकृत करता है?
फ़िट करने के बाद, नया बिंदु उसके निकटतम सेंट्रोइड को असाइन किया जा सकता है। यह क्लस्टर असाइनमेंट है, अनिवार्य रूप से सुपरवाइज़्ड वर्ग भविष्यवाणी नहीं।
मुख्य संदर्भ