
एआई की मूल बातें
मैकेनिस्टिक इंटरप्रिटेबिलिटी क्या है? शोधकर्ता AI मॉडलों का विश्लेषण कैसे करते हैं

 Unite.AI को Google पर अपने पसंदीदा स्रोतों में जोड़ें
मैकेनिस्टिक इंटरप्रिटेबिलिटी यह अध्ययन करती है कि न्यूरल नेटवर्क के भीतर सीखे गए घटक कैसे कारणात्मक रूप से व्यवहार उत्पन्न करते हैं। केवल इनपुट और आउटपुट के बीच सहसंबंध स्थापित करने के बजाय, शोधकर्ता फीचर्स, अटेंशन हेड्स, न्यूरॉन्स और सर्किट्स के बारे में परिकल्पनाएँ बनाते हैं, और फिर उन परिकल्पनाओं की जाँच के लिए हस्तक्षेप करते हैं।
यह क्षेत्र छोटे और मध्यम मॉडल में चयनित व्यवहारों के लिए विस्तृत व्याख्याएँ प्रदान कर चुका है, लेकिन एक अग्रणी मॉडल का पूर्ण, विश्वसनीय विवरण अभी भी दूर है। स्वचालित व्याख्याएँ और आकर्षक दृश्यांकन उपयोगी प्रारंभिक बिंदु हो सकते हैं, लेकिन प्रमाण नहीं।
मुख्य बिंदु
- फीचर्स प्रतिनिधित्वात्मक पैटर्न होते हैं; सर्किट्स इंटरैक्टिंग घटक होते हैं जो किसी गणना को लागू करने के लिए प्रस्तावित किए जाते हैं।
- एक्टिवेशन पैचिंग, एब्लेशन, और कारणात्मक ट्रेसिंग यह परीक्षण करते हैं कि क्या कोई घटक व्यवहार को बदलता है।
- सुपरपोज़िशन का अर्थ है कि एक न्यूरॉन कई फीचर्स में भाग ले सकता है; स्पार्स ऑटोएन्कोडर एक अलग फीचर बेसिस का प्रयास करते हैं।
- इंटरप्रिटेबिलिटी विधियों को ग्राउंड ट्रुथ, खंडनीय परीक्षण, कवरेज, और वैकल्पिक व्याख्याओं के विरुद्ध मूल्यांकन की आवश्यकता होती है।
प्रतिनिधित्व से तंत्र तक
प्रोबिंग यह पूछता है कि क्या एक एक्टिवेशन से जानकारी को डिकोड किया जा सकता है। एट्रिब्यूशन यह अनुमान लगाता है कि कौन‑से इनपुट या घटक महत्वपूर्ण हैं। मैकेनिस्टिक कार्य आगे बढ़कर एक आंतरिक गणना का प्रस्ताव करता है और जांचता है कि क्या हस्तक्षेप अपेक्षित मध्यवर्ती और अंतिम व्यवहार को बदलते हैं।
यह व्याख्यात्मक AI से संबंधित है लेकिन उससे अधिक संकीर्ण है। एक निर्णय के लिए पोस्ट‑हॉक व्याख्या आवश्यक नहीं कि मॉडल के भीतर एक रिवर्स‑इंजीनर्ड एल्गोरिद्म हो।
सर्किट्स और कारणात्मक हस्तक्षेप
शोधकर्ता एक अटेंशन हेड या फीचर को कार्य से जोड़ सकते हैं, उसे एब्लेट कर सकते हैं, किसी अन्य रन से एक्टिवेशन पैच कर सकते हैं, या यह देख सकते हैं कि जानकारी परतों के बीच कैसे प्रवाहित होती है। एक अच्छी परिकल्पना नए उदाहरणों पर व्यवहार की भविष्यवाणी करती है और नियंत्रणों के सामने टिकती है।
हस्तक्षेप ऑफ‑डिस्ट्रिब्यूशन स्थितियों को उत्पन्न कर सकते हैं, इसलिए केवल व्यवहार में परिवर्तन से प्राकृतिक गणना का पता नहीं चलता। कई विधियों, मिलते‑जुलते नियंत्रणों, और मात्रात्मक प्रभावों का उपयोग करें, न कि केवल एक चित्रात्मक प्रॉम्प्ट का।
सुपरपोज़िशन और स्पार्स फीचर्स
न्यूरल नेटवर्क सुपरइम्पोज़ करके व्यक्तिगत आयामों से अधिक फीचर्स का प्रतिनिधित्व कर सकते हैं। इसलिए एक न्यूरॉन कई असंबंधित पैटर्न के लिए सक्रिय हो सकता है, जिससे न्यूरॉन‑स्तरीय लेबल भ्रामक हो सकते हैं।
स्पार्स ऑटोएन्कोडर मॉडल एक्टिवेशनों से बड़ी शब्दकोशीय फीचर सेट सीखते हैं। वे पैटर्न को अधिक अलग‑अलग बना सकते हैं, लेकिन चयनित स्पार्सिटी, प्रशिक्षण डेटा, पुनर्निर्माण त्रुटि, और स्वचालित लेबल यह निर्धारित करते हैं कि क्या पुनः प्राप्त होता है। न्यूरल‑नेटवर्क फीचर्स को अभी भी कारणात्मक सत्यापन की आवश्यकता होती है।
सुरक्षा, डिबगिंग, और सीमाएँ
मैकेनिस्टिक टूल्स स्मरणीय तथ्यों, पक्षपात, धोखेबाज़ रणनीतियों, या विफलता सर्किट्स को खोजने में मदद कर सकते हैं और संपादन या मॉनिटरिंग का समर्थन कर सकते हैं। वही टूल्स वितरित, दुर्लभ, या संदर्भ‑निर्भर गणनाओं को मिस भी कर सकते हैं।
परिणामों को स्कोप्ड एविडेंस के रूप में देखें: मॉडल संस्करण, कार्य, डेटासेट, लेयर, हस्तक्षेप, प्रभाव, और अनिश्चितता। व्याख्या को व्यवहारिक मूल्यांकन, रेड‑टीमिंग, और जिम्मेदार‑AI शासन से जोड़ें, न कि इसे एक सार्वभौमिक सुरक्षा प्रमाणपत्र मानें।
प्रतिनिधित्व, सर्किट्स, और कारणात्मक प्रमाण
मैकेनिस्टिक इंटरप्रिटेबिलिटी इस बात का अध्ययन करती है कि आंतरिक गणनाएँ मॉडल व्यवहार को कैसे उत्पन्न करती हैं। शोधकर्ता एक्टिवेशन्स, वज़न, अटेंशन, और मध्यवर्ती फीचर्स का निरीक्षण करते हैं, फिर प्रतिनिधित्व और सर्किट्स के बारे में परिकल्पनाएँ बनाते हैं। एक प्रतिनिधित्व आवश्यक नहीं कि एक ही न्यूरॉन में संग्रहीत हो; यह दिशाओं, परतों, टोकनों, और संदर्भ‑निर्भर संयोजनों में वितरित हो सकता है।
स्पार्स ऑटोएन्कोडर घने एक्टिवेशन्स को बड़े फीचर सेट में विभाजित करने का प्रयास करते हैं जो चयनात्मक रूप से सक्रिय होते हैं। फीचर लेबल देखे गए उदाहरणों की मानवीय व्याख्या होते हैं, न कि ग्राउंड ट्रुथ। पुनर्निर्माण त्रुटि, स्पार्सिटी, फीचर विभाजन, एब्जॉर्प्शन, और डेड फीचर यह निर्धारित करते हैं कि विभाजन क्या उजागर करता है और क्या छूट जाता है।
सहसंबंध मैकेनिस्टिक दावे के लिए अपर्याप्त है। एक्टिवेशन पैचिंग, एब्लेशन, कारणात्मक ट्रेसिंग, स्टीयरिंग, और लक्षित वज़न हस्तक्षेप यह परीक्षण करते हैं कि क्या कोई घटक पूर्वानुमानित रूप से व्यवहार को बदलता है। हस्तक्षेप ऑफ‑डिस्ट्रिब्यूशन स्थितियों को भी उत्पन्न कर सकते हैं, इसलिए परिणामों को नियंत्रण, डोज‑रिस्पॉन्स विश्लेषण, वैकल्पिक व्याख्याएँ, और विभिन्न प्रॉम्प्ट व मॉडल में पुनरावृत्ति की आवश्यकता होती है।
एक कठोर इंटरप्रिटेबिलिटी वर्कफ़्लो
एक सटीक मापे गए व्यवहार और ऐसा डेटासेट से शुरू करें जो प्रतिस्पर्धी परिकल्पनाओं को अलग‑अलग करता हो। प्रासंगिक परतें, स्थितियाँ, घटक, या फीचर को स्थानीयकृत करें; उम्मीदवार तंत्रों का निरीक्षण करें; हस्तक्षेप करें; और देखें कि प्रस्तावित सर्किट नए मामलों की भविष्यवाणी करता है या नहीं। चयनात्मक पक्षपात को कम करने के लिए खोजी उदाहरणों को पुष्टि‑मूल्यांकन से अलग रखें।
स्वचालित टूल्स न्यूरॉन, फीचर, हेड, या पाथ को रैंक कर सकते हैं, जबकि भाषा मॉडल विवरण प्रस्तावित कर सकते हैं। स्वचालन कवरेज बढ़ाता है लेकिन विश्वसनीय कहानियों का निर्माण भी कर सकता है। रख‑आउट एक्टिवेशन उदाहरणों और कारणात्मक भविष्यवाणियों पर व्याख्याओं को स्कोर करें, अनिश्चितता दर्ज करें, और मॉडल संस्करण, टोकनाइज़र, प्रॉम्प्ट, तथा कोड के साथ कलाकृतियों को पुनरुत्पादनीय बनाएं।
तंत्र बहु‑अर्थी, पुनरावर्ती, गैर‑रेखीय, और वितरित हो सकते हैं। एक घटक को हटाने से अन्य द्वारा पूर्ति हो सकती है, जबकि एक फीचर कई व्यवहारों में भाग ले सकता है। नकारात्मक निष्कर्ष सूचनात्मक होते हैं: एक स्पष्ट सर्किट जो क्यूरेटेड उदाहरणों के बाहर विफल होता है, उसे संकीर्ण या अस्वीकार किया जाना चाहिए, न कि धुंधली व्याख्या से बचाया जाए।
अनुप्रयोग, सीमाएँ, और सुरक्षा दावे
इंटरप्रिटेबिलिटी भ्रम, पक्षपात, स्मरण, जेलब्रेक व्यवहार, या अप्रत्याशित सामान्यीकरण को डिबग करने, मॉडलों की तुलना करने, और वैज्ञानिक परिकल्पनाएँ उत्पन्न करने में मदद कर सकती है; यह मॉनिटरिंग या हस्तक्षेप के लिए फीचर पहचान भी कर सकती है। इन उपयोगों को कार्य‑विशिष्ट सत्यापन की आवश्यकता होती है क्योंकि एक उपयोगी शोध दृश्यांकन स्वचालित रूप से उत्पादन‑नियंत्रण के लिए विश्वसनीय नहीं होता।
किसी फीचर का न होना क्षमता या इरादे की अनुपस्थिति सिद्ध नहीं करता, और कोई पढ़ने योग्य फीचर यह सिद्ध नहीं करता कि मॉडल ने उसे दिए गए उत्तर में उपयोग किया है। टूल्स गणना के केवल एक प्रक्षेपण को सीमित कवरेज के साथ देखते हैं। सुरक्षा दावों को डिटेक्शन संवेदनशीलता, फॉल्स पॉज़िटिव, वितरण, प्रतिपक्ष, और ज्ञात ब्लाइंड स्पॉट्स निर्दिष्ट करने चाहिए।
इंटरप्रिटेबिलिटी को व्यवहारिक मूल्यांकन, रेड‑टीमिंग, डेटा गवर्नेंस, एक्सेस कंट्रोल, मॉनिटरिंग, और इन्सिडेंट रिस्पॉन्स के साथ उपयोग करें। संभव हो तो विधियों और प्रतिवादों को प्रकाशित करें। यह क्षेत्र तेज़ी से प्रगति कर रहा है, लेकिन वर्तमान तकनीकें अग्रणी‑मॉडल तर्क या संरेखण की सामान्य गारंटी के लिए पूर्ण, विश्वसनीय व्याख्या प्रदान नहीं करतीं।
व्यावहारिक उदाहरण: प्रस्तावित मॉडल सर्किट का परीक्षण
मान लीजिए एक मॉडल वाक्य में अप्रत्यक्ष वस्तु को हल करने के लिए अटेंशन हेड्स और फीचर्स का सेट उपयोग करता दिखता है। शोधकर्ता विभिन्न नामों, स्थितियों, विकर्षकों, और प्रतिवादों के साथ एक नियंत्रित डेटासेट बनाते हैं, फिर व्यवहार को मापते हैं। एक्टिवेशन निरीक्षण संभावित घटकों की पहचान करता है, लेकिन परिकल्पना हस्तक्षेप से पहले लिखी जाती है: प्रत्येक घटक कौन‑सी जानकारी रखता है, वह कहाँ जाता है, और उसे बदलने से आउटपुट कैसे बदलना चाहिए।
एक्टिवेशन पैचिंग और एब्लेशन आवश्यक और पर्याप्तता को होल्ड‑आउट उदाहरणों पर परीक्षण करते हैं। एक लक्षित संपादन जो अपेक्षित दिशा में टोकन को बदलता है, तंत्र का समर्थन करता है; व्यापक प्रदर्शन क्षति नहीं। नियंत्रण अनसंबंधित स्थितियों और घटकों को पैच करते हैं, हस्तक्षेप की तीव्रता बदलते हैं, और वैकल्पिक सर्किट की तुलना करते हैं। टीम नकारात्मक मामलों को प्रकाशित करती है जहाँ व्याख्या विफल होती है और केवल सहसंबंध से मानव‑पठनीय उद्देश्य निर्धारित करने से बचती है।
सुरक्षा अनुप्रयोग का दावा करने के लिए, विधि को वास्तविक प्रॉम्प्ट और प्रतिपक्षी अनुकूलन के तहत ज्ञात संवेदनशीलता के साथ प्रासंगिक व्यवहार का पता लगाना चाहिए। फीचर मॉनिटर को फॉल्स पॉज़िटिव, बचाव, मॉडल अपडेट, और कारणात्मक प्रासंगिकता के लिए मूल्यांकन किया जाता है। इंटरप्रिटेबिलिटी साक्ष्य डिबगिंग और आगे के परीक्षणों को मार्गदर्शन कर सकते हैं, लेकिन प्रवर्तन बाहरी नियंत्रण और व्यवहारिक मॉनिटरिंग में रहता है। एक प्रभावशाली सर्किट डायग्राम वैज्ञानिक परिकल्पना है प्रमाण‑सहित—not एक मॉडल की पूर्ण व्याख्या या अनदेखे व्यवहार की गारंटी।
व्यावहारिक कार्यान्वयन चेकलिस्ट
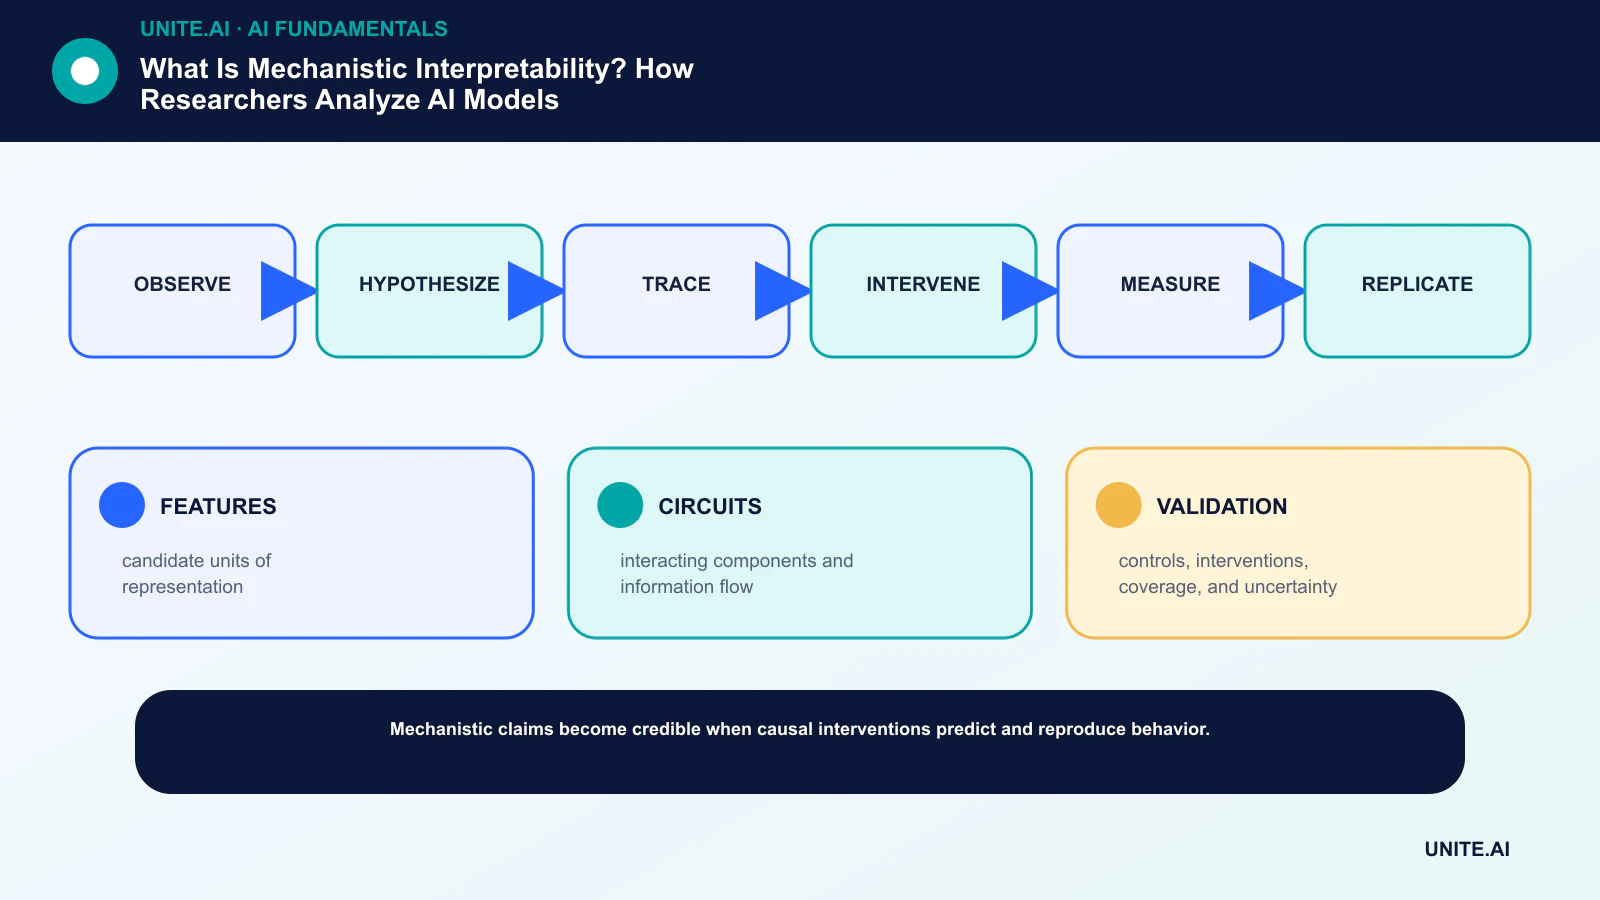
धारणा को सीमित, परीक्षण‑योग्य वर्कफ़्लो में बदलें: अवलोकन → परिकल्पना → ट्रेस → हस्तक्षेप → माप → पुनरावृत्ति। एक जिम्मेदार मालिक नामित करें, डेटा और निर्भरताओं का दस्तावेज़ बनाएं, एक सरल बेसलाइन स्थापित करें, स्वीकृति और रोक मानदंड निर्धारित करें, प्रतिनिधिक विफलताओं का परीक्षण करें, और स्कोप बढ़ाने से पहले मॉनिटरिंग, रोलबैक, और समीक्षा परिभाषित करें। संस्करण और धारणाओं को रिकॉर्ड करें ताकि दूसरी टीम परिणाम को पुन: उत्पन्न कर सके और समझ सके कि क्या बदला।
लॉन्च से पहले, उन लोगों के साथ एक दस्तावेज़ित तत्परता समीक्षा चलाएँ जो सिस्टम बनाते, संचालित करते, सुरक्षित करते, और उससे प्रभावित होते हैं। सामान्य मामलों, सीमा स्थितियों, निर्भरता विफलताओं, और दुरुपयोग का परीक्षण करें; साक्ष्य और अनसुलझे जोखिम सुरक्षित रखें। निर्धारित करें कि कौन रिलीज़ को मंजूरी दे सकता है, थ्रेशोल्ड बदल सकता है, आउटपुट को ओवरराइड कर सकता है, या संचालन को रोक सकता है। वास्तविक‑विश्व डेटा आने पर निर्णय को पुनः देखें, क्योंकि तकनीकी रूप से सफल पायलट व्यापक पैमाने पर भरोसेमंद प्रदर्शन की गारंटी नहीं देता।
- FEATURES: प्रतिनिधित्व की संभावित इकाइयाँ।
- CIRCUITS: इंटरैक्टिंग घटक और सूचना प्रवाह।
- VALIDATION: नियंत्रण, हस्तक्षेप, कवरेज, और अनिश्चितता।
अक्सर पूछे जाने वाले प्रश्न
क्या मैकेनिस्टिक इंटरप्रिटेबिलिटी मॉडल वज़न पढ़ने के समान है?
नहीं। कच्चे वज़न स्वयं‑स्पष्टीकरण नहीं होते। शोधकर्ता एक्टिवेशन, फीचर, घटक, और हस्तक्षेप का विश्लेषण करके कारणात्मक परिकल्पनाएँ बनाते और परीक्षण करते हैं।
क्या स्पार्स ऑटोएन्कोडर पूरी तरह से एक LLM को समझा सकते हैं?
नहीं। वे एक संभावित फीचर आधार प्रदान करते हैं और सर्किट विश्लेषण का समर्थन कर सकते हैं, लेकिन कवरेज, विश्वसनीयता, पुनर्निर्माण, लेबलिंग, और स्केलेबिलिटी अभी भी खुले प्रश्न हैं।
प्राथमिक संदर्भ












