एआई की मूल बातें
Mixture-of-Experts मॉडल क्या है? स्पार्स AI समझाया गया

 Unite.AI को Google पर अपने पसंदीदा स्रोतों में जोड़ें
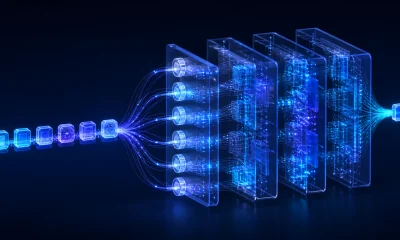
एक mixture-of-experts (MoE) मॉडल में कई पैरामीटरयुक्त विशेषज्ञ नेटवर्क और एक राउटर होता है जो प्रत्येक इनपुट या टोकन के लिए एक छोटा उपसमुच्चय चुनता है। क्योंकि केवल चयनित विशेषज्ञ ही निष्पादित होते हैं, मॉडल कुल पैरामीटर क्षमता को बढ़ा सकता है बिना प्रत्येक फ़ॉरवर्ड पास में सभी पैरामीटर सक्रिय किए।
स्पार्स सक्रियण से गणना या मेमोरी मुक्त नहीं होती। MoE सिस्टम को कई पैरामीटर संग्रहीत और स्थानांतरित करने होते हैं, टोकनों को विशेषज्ञों में संतुलित करना होता है, उपकरणों का समन्वय करना होता है, और राउटिंग अस्थिरता को रोकना होता है। कुल पैरामीटर संख्या और सक्रिय पैरामीटर संख्या अलग-अलग लागतों को दर्शाते हैं।
मुख्य बिंदु
- राउटर विशेषज्ञ स्कोर की गणना करते हैं और टोकनों को शीर्ष‑k विशेषज्ञों को भेजते हैं।
- क्षमता सीमाएँ और लोड‑बैलेंसिंग लक्ष्य कुछ ही विशेषज्ञों को सभी टोकन मिलने से रोकते हैं।
- स्पार्स गणना प्रति ऑपरेशन क्षमता को बढ़ा सकती है लेकिन संचार और मेमोरी जटिलता को बढ़ाती है।
- गुणवत्ता, सक्रिय गणना, लेटेंसी, मेमोरी, राउटिंग व्यवहार और सर्विंग टोपोलॉजी को साथ मिलाकर मूल्यांकन करें।
राउटर और विशेषज्ञ लेयर
ट्रांसफ़ॉर्मर MoE मॉडलों में, चयनित फ़ीड‑फ़ॉरवर्ड लेयर अक्सर विशेषज्ञ फ़ीड‑फ़ॉरवर्ड नेटवर्क से प्रतिस्थापित की जाती हैं। राउटर प्रत्येक टोकन को स्कोर देता है और उसे एक या अधिक विशेषज्ञों को भेजता है; उनके आउटपुट को वेटेड किया जाता है और मुख्य रेज़िडुअल स्ट्रीम में वापस किया जाता है।
ध्यान (Attention) घना रह सकता है। इसलिए आसपास का transformer साझा गणना और शर्तीय विशेषज्ञ गणना का मिश्रण उपयोग करता है।
क्षमता और लोड बैलेंसिंग
प्रत्येक विशेषज्ञ एक बैच में सीमित संख्या में टोकन प्रोसेस कर सकता है। यदि बहुत अधिक टोकन एक ही विशेषज्ञ चुनते हैं, तो कुछ कार्यान्वयन ओवरफ़्लो को ड्रॉप या रीरूट कर देते हैं। ऑक्सिलरी लॉस संतुलित उपयोग को प्रोत्साहित करते हैं, जबकि राउटिंग शोर प्रशिक्षण के दौरान खोज को बेहतर बना सकता है।
सम समान ट्रैफ़िक का अर्थ सार्थक विशेषज्ञता नहीं है। डोमेन, पोजीशन और कार्य के आधार पर विशेषज्ञ उपयोग की जाँच करें, लेकिन कारणात्मक प्रमाण के बिना मानव‑पठनीय भूमिकाएँ असाइन करने से बचें।
सर्विंग क्यों कठिन है
हालाँकि केवल एक उपसमुच्चय सक्रिय है, फिर भी सभी विशेषज्ञ वज़न को एक्सेलेरेटर मेमोरी में वितरित रहना पड़ सकता है। विशेषज्ञ समानांतरता टोकनों को उपकरणों के बीच भेजती है, जिससे नेटवर्क बैंडविड्थ और ऑल‑टू‑ऑल संचार महत्वपूर्ण बन जाता है। छोटे बैच विशेषज्ञों का कम उपयोग कर सकते हैं।
क्वांटाइज़ेशन, कैशिंग, बैचिंग और टोपोलॉजी‑सजग राउटिंग मदद कर सकते हैं। MoE और घने विकल्पों की तुलना समान आउटपुट गुणवत्ता, संदर्भ, हार्डवेयर और सर्विस‑लेवल ऑब्जेक्टिव पर करें—केवल सक्रिय FLOPs नहीं।
MoE क्या करता है और क्या नहीं दर्शाता
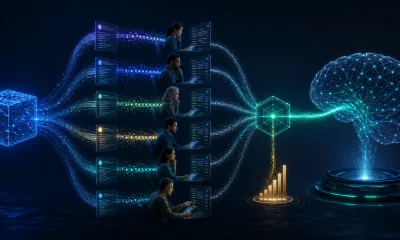
MoE शर्तीय गणना और क्षमता प्रदान करता है। यह तथ्यात्मकता, मॉड्यूलर तर्क, व्याख्यात्मकता, या स्वतंत्र एजेंटों के पैनल की गारंटी नहीं देता। विशेषज्ञ नेटवर्क संयुक्त रूप से सीखते हैं और व्यापक विशेषताओं को साझा कर सकते हैं।
MoE, generative-AI के पोस्ट‑ट्रेनिंग और संपीड़न को पूरक करता है। डिप्लॉयमेंट के बाद राउटिंग ड्रिफ्ट, टेल लेटेंसी, विशेषज्ञ विफलताएँ, मेमोरी और डोमेन गुणवत्ता की निगरानी करें।
राउटिंग, विशेषज्ञ क्षमता, और स्पार्स गणना
एक mixture-of-experts लेयर में कई विशेषज्ञ नेटवर्क और एक राउटर होता है जो प्रत्येक टोकन को छोटे उपसमुच्चय, अक्सर शीर्ष एक या दो विशेषज्ञों को असाइन करता है। मॉडल कई पैरामीटर रख सकता है जबकि प्रत्येक टोकन के लिए केवल एक अंश सक्रिय करता है। स्पार्स सक्रियण समान कुल पैरामीटर संख्या वाले घने मॉडल की तुलना में गणना को कम करता है, न कि हर छोटे मॉडल की तुलना में।
राउटर विशेषज्ञ स्कोर बनाता है, चयन नियम लागू करता है, और टोकन प्रतिनिधित्व भेजता है। प्रत्येक विशेषज्ञ की सीमित क्षमता होती है। यदि बहुत अधिक टोकन एक ही विशेषज्ञ चुनते हैं, तो सिस्टम को टोकन को ड्रॉप, रीरूट या पैड करना पड़ता है। क्षमता फ़ैक्टर, ऑक्सिलरी बैलेंसिंग लॉस, राउटर शोर और विशेषज्ञ समानांतरता गुणवत्ता को उपयोगिता और संचार के विरुद्ध संतुलित करते हैं।
विशेषज्ञ यह गारंटी नहीं देते कि वे मानव अवधारणाओं या डोमेनों से स्पष्ट रूप से मेल खाते हों। विशेषीकरण अनुकूलन से उत्पन्न होता है और वितरित, अस्थिर या टोकन‑निर्भर हो सकता है। व्याख्यात्मकता के दावे को लेयर और संदर्भों में राउटिंग की जाँच करनी चाहिए और हस्तक्षेपों का उपयोग करना चाहिए, न कि केवल कुछ उच्च‑स्कोर वाले टोकनों से निकाले गए लेबलों पर निर्भर रहना चाहिए।
वितरित MoE मॉडलों का प्रशिक्षण और सर्विंग
प्रशिक्षण डेटा, टेंसर, पाइपलाइन और विशेषज्ञ समानांतरता को मिलाता है। टोकनों को चयनित विशेषज्ञों तक पहुंचने के लिए अक्सर एक्सेलेरेटरों के बीच यात्रा करनी पड़ती है, जिससे ऑल‑टू‑ऑल संचार अंकगणितीय बचत को समाप्त कर सकता है। प्लेसमेंट, बैच संरचना, नेटवर्क बैंडविड्थ, टोकन पैकिंग और संचार को गणना के साथ ओवरलैप करना प्रमुख सिस्टम‑डिज़ाइन विकल्प हैं।
लोड असंतुलन से निष्क्रिय विशेषज्ञ और अधिक लोड वाले उपकरण बनते हैं। ऑक्सिलरी उद्देश्यों से संतुलित राउटिंग को प्रोत्साहन मिलता है लेकिन यह मुख्य सीखने के उद्देश्य में बाधा डाल सकता है; नई विधियां बायस या राउटिंग डायनामिक्स को समायोजित कर सकती हैं। केवल समग्र लॉस पर भरोसा करने के बजाय प्रति‑विशेषज्ञ टोकन गिनती, ड्रॉप किए गए टोकन, एंट्रॉपी, ग्रेडिएंट और डिवाइस समय की निगरानी करें।
सर्विंग कठिन है क्योंकि सभी विशेषज्ञ वज़न उपलब्ध रहने चाहिए जबकि प्रत्येक टोकन केवल कुछ ही का उपयोग करता है। मेमोरी क्षमता, इंटरकनेक्ट, बैचिंग, कैश व्यवहार और राउटिंग परिवर्तनशीलता लेटेंसी को प्रभावित करते हैं। क्वांटाइज़ेशन और विशेषज्ञ ऑफलोडिंग कुछ स्थितियों में मदद करते हैं लेकिन ट्रांसफ़र जोड़ सकते हैं। सटीक मॉडल और हार्डवेयर टोपोलॉजी का बेंचमार्क करें।
गुणवत्ता, मूल्यांकन, और डिप्लॉयमेंट समझौते
MoE मॉडलों का मूल्यांकन घने बेसलाइन के विरुद्ध समान गुणवत्ता, प्रशिक्षण गणना, इन्फ़रेंस गणना, मेमोरी, लेटेंसी और लागत पर करें। केवल पैरामीटर‑गणना की तुलना भ्रामक होती है। लंबे संदर्भ, भाषाएँ, डोमेन्स, दुर्लभ टोकन और विरोधी प्रॉम्प्ट का परीक्षण करें क्योंकि वितरण के साथ राउटर व्यवहार बदल सकता है और असमान क्षमताएँ उत्पन्न कर सकता है।
राउटिंग अतिरिक्त विफलता मोड पेश करता है: विशेषज्ञ का पतन, अस्थिर विशेषज्ञता, टोकन ड्रॉपिंग, सहसंबंधित आउटेज, और बैच संरचना के प्रति संवेदनशीलता। निर्धारित मूल्यांकन को रनटाइम और राउटिंग सेटिंग्स को नियंत्रित करना चाहिए। ऑपरेशनल मॉनिटरिंग में विशेषज्ञ उपयोग और संचार स्वास्थ्य शामिल होना चाहिए ताकि सिस्टम समस्या को सामान्य मॉडल परिवर्तन समझा न जाए।
जब कुल क्षमता को स्केल करना महत्वपूर्ण हो और इन्फ्रास्ट्रक्चर स्पार्स वितरित निष्पादन का समर्थन कर सके, तब MoE आकर्षक होता है। घने मॉडल छोटे बैच, एज डिवाइस या सीमित इंटरकनेक्ट के लिए सरल और तेज़ रह सकते हैं। यह आर्किटेक्चर एक सिस्टम समझौता है, घने ट्रांसफ़ॉर्मर का सार्वभौमिक विकल्प नहीं।
व्यावहारिक उदाहरण: MoE भाषा मॉडल का मूल्यांकन
एक शोध टीम MoE ट्रांसफ़ॉर्मर की तुलना घने बेसलाइन से समान प्रशिक्षण टोकन और कई संसाधन दृश्यों का उपयोग करके करती है: टोकन प्रति सक्रिय पैरामीटर, कुल पैरामीटर, एक्सेलेरेटर मेमोरी, नेटवर्क ट्रैफ़िक, प्रशिक्षण समय, इन्फ़रेंस थ्रूपुट और लेटेंसी। यह लेयर, भाषा और डोमेन के अनुसार राउटर संभावनाएँ, विशेषज्ञ प्रति टोकन, ओवरफ़्लो, ड्रॉप किए गए टोकन और ऑक्सिलरी लॉस को लॉग करता है। यदि संचार या कम उपयोग से कुल लागत बढ़ती है तो कम अंकगणितीय गणना को दक्षता नहीं माना जाता।
गुणवत्ता मूल्यांकन में ज्ञान, तर्क, लंबा संदर्भ, दुर्लभ डोमेन्स, बहुभाषी कार्य, सुरक्षा और कैलिब्रेशन शामिल हैं। टीम बैच संरचना और प्रॉम्प्ट वितरण को बदलती है यह देखने के लिए कि क्या राउटिंग और आउटपुट अनपेक्षित रूप से बदलते हैं। कारणात्मक विशेषज्ञ एब्लेशन विशेषज्ञता दावों की जांच करते हैं, जबकि विशेषज्ञ विफलताएँ और नेटवर्क गिरावट लचीलापन दर्शाती हैं। परिणाम समान सर्विस‑लेवल लक्ष्य पर तुलना किए जाते हैं क्योंकि केवल बड़े बैच में अच्छा प्रदर्शन करने वाला मॉडल इंटरैक्टिव उपयोग के लिए उपयुक्त नहीं हो सकता।
डिप्लॉयमेंट के लिए, विशेषज्ञों को ऑल‑टू‑ऑल ट्रैफ़िक को न्यूनतम करने के लिए रखा जाता है, वज़न केवल प्रति‑विशेषज्ञ संवेदनशीलता जांच के बाद क्वांटाइज़ किए जाते हैं, और रनटाइम मॉनिटरिंग असंतुलन या अनुपलब्ध डिवाइस का पता लगाती है। क्षमता और राउटिंग सेटिंग्स को मॉडल के साथ संस्करणित किया जाता है। टीम MoE तभी चुनती है जब अतिरिक्त पैरामीटर क्षमता आवश्यक कार्यों को पर्याप्त रूप से सुधारती हो जिससे मेमोरी और वितरित‑सिस्टम जटिलता का औचित्य हो; अन्यथा घना मॉडल सस्ता, संचालन में आसान और अधिक पूर्वानुमेय हो सकता है।
व्यावहारिक कार्यान्वयन चेकलिस्ट
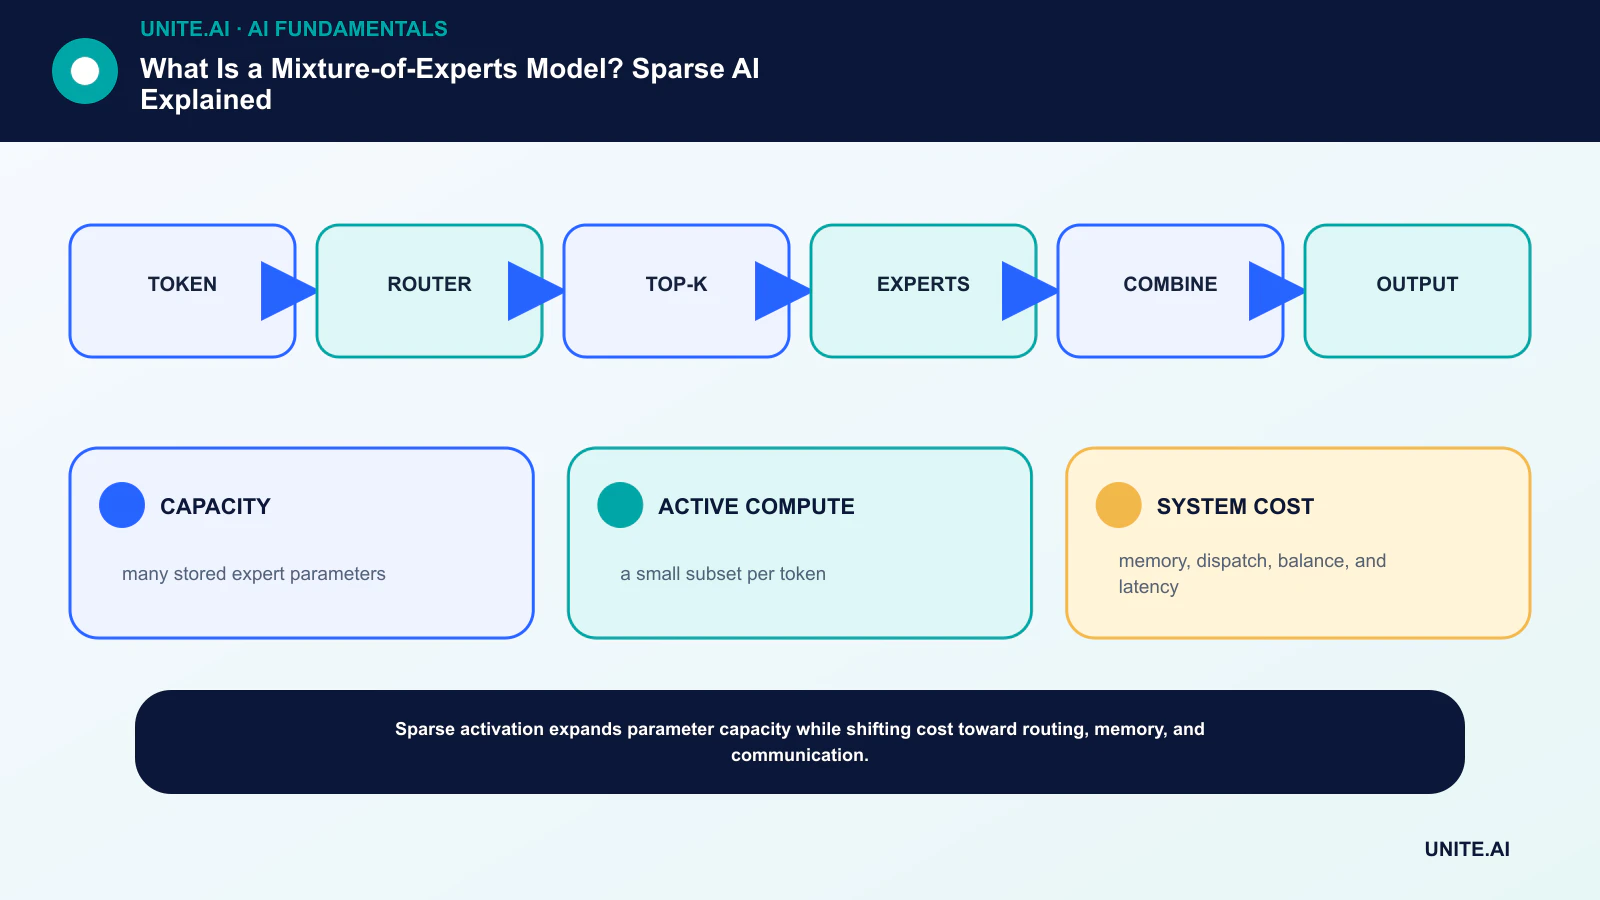
धारणा को सीमित, परीक्षण योग्य वर्कफ़्लो में बदलें: टोकन → राउटर → टॉप‑k → विशेषज्ञ → संयोजन → आउटपुट। एक जिम्मेदार मालिक का नाम रखें, डेटा और निर्भरताओं का दस्तावेज़ बनाएं, एक सरल बेसलाइन स्थापित करें, स्वीकृति और रोकने के मानदंड निर्धारित करें, प्रतिनिधिक विफलताओं का परीक्षण करें, और दायरे का विस्तार करने से पहले मॉनिटरिंग, रोलबैक और समीक्षा को परिभाषित करें। संस्करण और धारणाएँ रिकॉर्ड करें ताकि दूसरी टीम परिणाम को पुन: उत्पन्न कर सके और समझ सके कि क्या बदला।
लॉन्च से पहले, उन लोगों के साथ दस्तावेज़ित रेडीनेस रिव्यू चलाएँ जो सिस्टम बनाते, संचालित करते, सुरक्षित रखते और उससे प्रभावित होते हैं। सामान्य मामलों, सीमा शर्तों, निर्भरता विफलताओं और दुरुपयोग का परीक्षण करें; साक्ष्य और अनसुलझे जोखिमों को संरक्षित रखें। परिभाषित करें कि रिलीज़ को कौन मंजूरी दे सकता है, थ्रेशोल्ड बदल सकता है, आउटपुट को ओवरराइड कर सकता है या संचालन को रोक सकता है। वास्तविक‑दुनिया डेटा आने के बाद निर्णय की पुनः समीक्षा करें, क्योंकि तकनीकी रूप से सफल पायलट व्यापक स्केल पर विश्वसनीय प्रदर्शन की गारंटी नहीं देता।
- CAPACITY: कई संग्रहीत विशेषज्ञ पैरामीटर।
- ACTIVE COMPUTE: प्रति टोकन एक छोटा उपसमुच्चय।
- SYSTEM COST: मेमोरी, डिस्पैच, बैलेंस और लेटेंसी।
अक्सर पूछे जाने वाले प्रश्न
क्या MoE विशेषज्ञ अलग मॉडल हैं?
आमतौर पर नहीं। वे एक प्रशिक्षित मॉडल के भीतर सबनेटवर्क हैं, जो राउटर और साझा लेयरों द्वारा जुड़े होते हैं। उनकी सीखी गई विशेषज्ञता सहज डोमेनों के साथ संरेखित नहीं हो सकती।
एक MoE के पास कई पैरामीटर क्यों हो सकते हैं लेकिन मध्यम गणना क्यों होती है?
प्रत्येक टोकन के लिए केवल एक छोटा टॉप‑k सेट के विशेषज्ञ सक्रिय होते हैं। निष्क्रिय विशेषज्ञ पैरामीटर अभी भी स्टोरेज और मेमोरी का उपयोग करते हैं और संचार लागत उत्पन्न कर सकते हैं।
प्राथमिक संदर्भ