एआई की मूल बातें
जनरेटिव एआई क्या है?

 Unite.AI को Google पर अपने पसंदीदा स्रोतों में जोड़ें
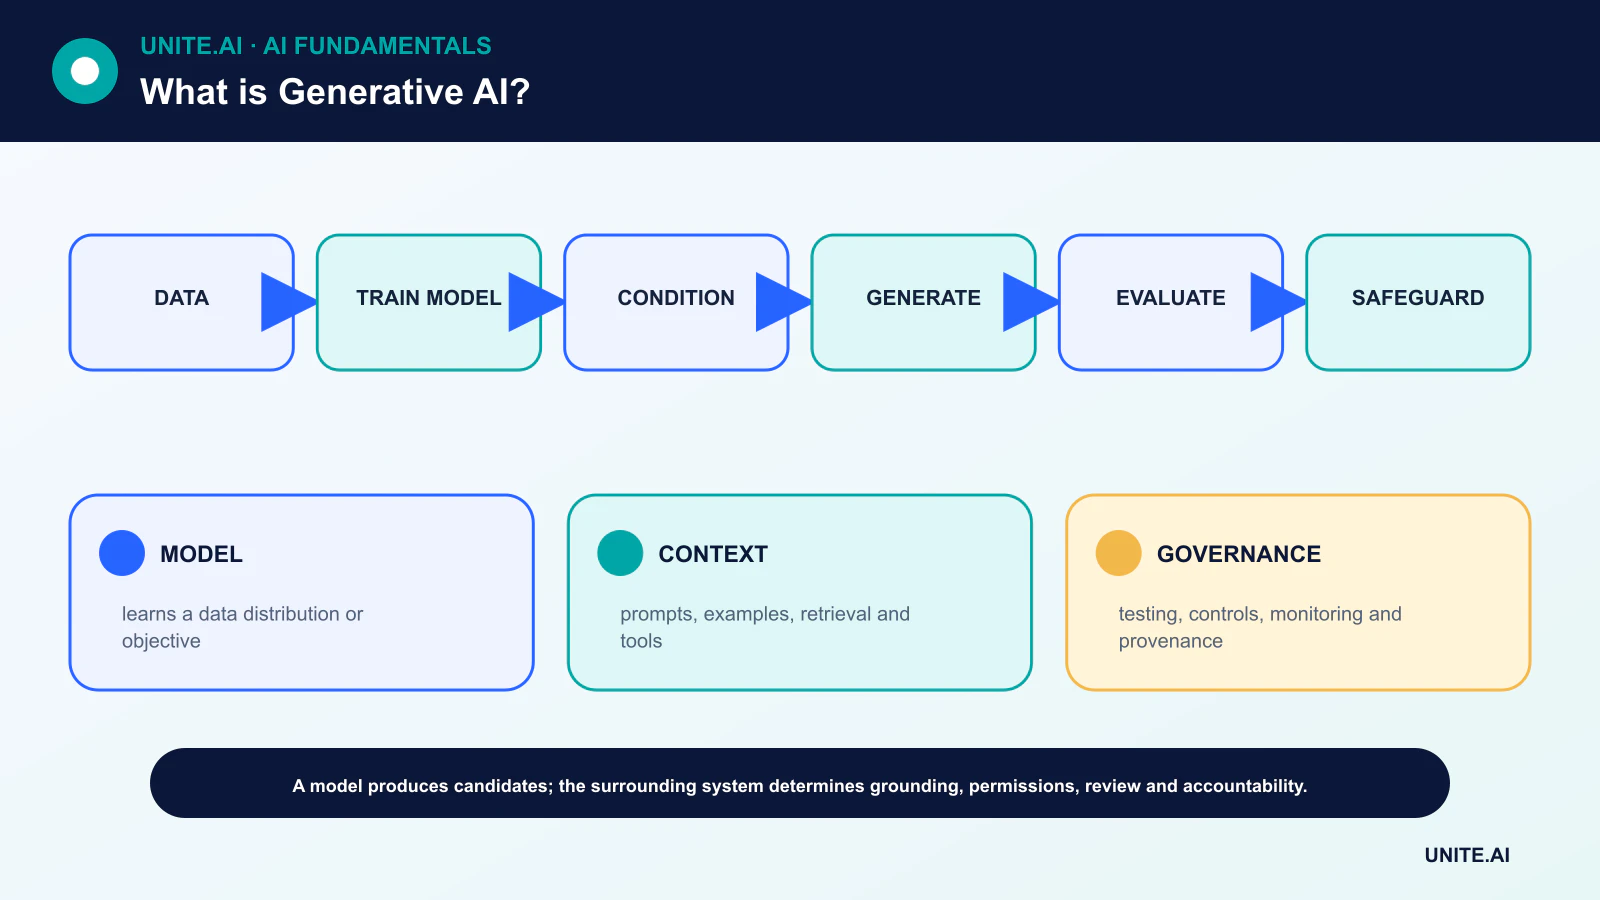
जनरेटिव एआई उन मॉडलों को कहा जाता है जो डेटा में पैटर्न सीखते हैं और निर्देशों या उदाहरणों के आधार पर नई टेक्स्ट, छवियां, ऑडियो, वीडियो, कोड या अन्य प्रतिनिधित्व उत्पन्न करते हैं। आउटपुट एक प्रायिकता मॉडल से संश्लेषित किया जाता है; यह डेटाबेस से पूर्ण रूप से प्राप्त नहीं होता, हालांकि रिट्रीवल टूल्स बाहरी प्रमाण प्रदान कर सकते हैं।
विभिन्न मॉडल परिवार अलग-अलग तरीकों से उत्पन्न करते हैं। ऑटोरिग्रेसिव ट्रांसफॉर्मर एक बार में एक टोकन का अनुक्रम भविष्यवाणी करते हैं, डिफ्यूज़न मॉडल क्रमशः नमूने से शोर हटाते हैं, और जनरेटिव एडवर्सेरियल नेटवर्क जेनरेटर और डिस्क्रिमिनेटर के बीच प्रतिस्पर्धा के माध्यम से सीखते हैं।
मुख्य बिंदु
- उत्पादन एक सीखी हुई वितरण से शर्तीय सैंपलिंग है, न कि गारंटीकृत तथ्यात्मक पुनरावृत्ति।
- ट्रांसफॉर्मर, डिफ्यूज़न मॉडल, GAN और वैरिएशनल ऑटोएन्कोडर अलग-अलग समझौतें करते हैं।
- रिट्रीवल और टूल्स सिस्टम को आधार प्रदान कर सकते हैं, पर उनके आउटपुट और अनुमतियों की अभी भी सत्यापन आवश्यक है।
- जोखिम प्रबंधन डेटा, मॉडल, इंटरफ़ेस, डिप्लॉयमेंट, मॉनिटरिंग और सामग्री की उत्पत्ति तक विस्तृत है।
जनरेटिव मॉडल कैसे सीखते हैं
प्रशिक्षण उद्देश्यों में मॉडल को उदाहरणों में पैटर्न की भविष्यवाणी या पुनर्निर्माण के लिए इनाम दिया जाता है। एक भाषा मॉडल अगले टोकन का अनुमान लगाता है; एक डिफ्यूज़न मॉडल शोर प्रक्रिया को उलटना सीखता है; एक वैरिएशनल ऑटोएन्कोडर संरचित लेटेंट वितरण और डिकोडर सीखता है।
यह प्रशिक्षण सांख्यिकीय सामान्यीकरण बनाता है, लेकिन यह पक्षपात को दोहरा सकता है, दुर्लभ अनुक्रमों को याद रख सकता है या डेटा वितरण के बाहर विफल हो सकता है। इसलिए डेटासेट दस्तावेज़ीकरण, डिडुप्लीकेशन, गोपनीयता नियंत्रण और अलग‑रखा मूल्यांकन डिप्लॉयमेंट से पहले महत्वपूर्ण हैं।
मुख्य आर्किटेक्चर परिवार
ऑटोरिग्रेसिव ट्रांसफॉर्मर टेक्स्ट में प्रमुख हैं और मल्टीमॉडल अनुक्रमों को समर्थन देते हैं। डिफ्यूज़न मॉडल उच्च‑गुणवत्ता वाली छवि और ऑडियो उत्पन्न करने के लिए व्यापक रूप से उपयोग होते हैं। GAN तेज़ नमूने और नियंत्रित छवि प्रणालियाँ बना सकते हैं, लेकिन उनका प्रशिक्षण कठिन हो सकता है।
वैरिएशनल ऑटोएन्कोडर लेटेंट‑वेरिएबल मॉडलिंग और कुशल प्रतिनिधित्व प्रदान करते हैं, कभी‑कभी बड़े जनरेटिव पाइपलाइन में उपयोग होते हैं। वास्तविक उत्पाद अक्सर कई मॉडलों को रिट्रीवल, फ़िल्टर, टूल्स और निर्धारक कोड के साथ मिलाते हैं।
शर्त, सैंपलिंग और नियंत्रण
एक प्रॉम्प्ट, वर्ग लेबल, छवि, ऑडियो क्लिप या संरचित रिकॉर्ड जनरेशन को शर्तित कर सकता है। सैंपलिंग पैरामीटर विविधता और निर्धारकता को बदलते हैं। कम तापमान टोकन संभावनाओं को केंद्रित कर सकता है, पर यह गलत उत्तर को सत्य नहीं बनाता।
नियंत्रण तब बेहतर होता है जब प्रणाली स्पष्ट स्कीमा, प्रतिबंधित डिकोडिंग, संदर्भ सामग्री और सत्यापन का उपयोग करती है। प्रॉम्प्ट इंजीनियरिंग संदर्भ बदलती है; फाइन‑ट्यूनिंग पैरामीटर बदलती है; रिट्रीवल बाहरी जानकारी प्रदान करती है। प्रत्येक अलग‑अलग विफलता मोड को संबोधित करता है।
मूल्यांकन एप्लिकेशन‑विशिष्ट है
टेक्स्ट प्रणालियों को तथ्यात्मकता, कार्य पूर्णता, उद्धरण समर्थन, विषाक्तता और कैलिब्रेशन परीक्षणों की आवश्यकता हो सकती है। छवि या ऑडियो प्रणालियों को फ़िडेलिटी, अर्थपूर्ण संरेखण, विविधता, पहचान सुरक्षा और ध्वनि‑समीक्षा की आवश्यकता हो सकती है। स्वचालित मेट्रिक्स को प्रतिनिधि मानवीय मूल्यांकन के साथ जोड़ा जाना चाहिए।
एक संस्करणित मूल्यांकन सेट बनाएं जिसमें सामान्य, दुर्लभ, प्रतिकूल और नीति‑संबंधी मामलों को शामिल किया जाए। लेटेंसी, लागत और अस्वीकार व्यवहार के साथ-साथ आउटपुट गुणवत्ता को ट्रैक करें। निर्माता द्वारा चुना गया डेमो जनसंख्या‑स्तर की विश्वसनीयता का प्रमाण नहीं है।
जोखिम, सुरक्षा उपाय और उत्पत्ति
महत्वपूर्ण जोखिमों में भ्रम (हैलुसिनेशन), प्रॉम्प्ट इंजेक्शन, हानिकारक सामग्री, प्रतिरूपण, असुरक्षित टूल उपयोग, गोपनीयता लीक, कॉपीराइट विवाद, ऑटोमेशन पक्षपात और अस्पष्ट सप्लाई चेन शामिल हैं। NIST की जनरेटिव एआई प्रोफ़ाइल शासन, सामग्री उत्पत्ति, पूर्व‑डिप्लॉयमेंट परीक्षण और घटना प्रकटीकरण के across कार्यों को व्यवस्थित करती है।
न्यूनतम‑विशेषाधिकार टूल्स, इनपुट/आउटपुट नियंत्रण, महत्वपूर्ण निर्णयों के लिए मानव समीक्षा, लॉगिंग, रोलबैक और उपयोगकर्ता रिपोर्टिंग का उपयोग करें। वॉटरमार्क या सामग्री प्रमाणपत्र संकेत जोड़ सकते हैं, पर कोई एकल डिटेक्टर या लेबल सत्य स्थापित नहीं करता। व्यापक सिंथेटिक‑मीडिया कार्यप्रवाह को संदर्भ और जवाबदेही बनाए रखनी चाहिए।
मॉडल परिवार और जनरेशन तंत्र
जनरेटिव एआई मॉडल एक प्रक्रिया का अनुमान लगाते या सीखते हैं जो नई टेक्स्ट, छवियां, ऑडियो, वीडियो, कोड या संरचित डेटा उत्पन्न कर सकती है। ऑटोरिग्रेसिव मॉडल अगले टोकन या तत्व की भविष्यवाणी करते हैं; डिफ्यूज़न मॉडल शोर प्रक्रिया को उलटना सीखते हैं; वैरिएशनल ऑटोएन्कोडर संभाव्य लेटेंट वेरिएबल सीखते हैं; GAN जेनरेटर को डिस्क्रिमिनेटर के विरुद्ध प्रशिक्षित करते हैं। मल्टीमॉडल सिस्टम विभिन्न मीडिया के बीच प्रतिनिधित्व जोड़ते हैं। आउटपुट प्रॉम्प्ट, संदर्भ, टूल्स या अन्य इनपुट पर शर्तित सीखे हुए सांख्यिकीय संरचना से सैंपल किया जाता है—यह गारंटीकृत तथ्य के रूप में प्राप्त नहीं होता।
फ़ाउंडेशन मॉडल व्यापक डेटा पर प्री‑ट्रेन किए जाते हैं और प्रॉम्प्टिंग, रिट्रीवल, फाइन‑ट्यूनिंग, प्रेफ़रेंस ऑप्टिमाइज़ेशन, कंट्रोल नेटवर्क या टास्क‑स्पेसिफिक हेड्स के माध्यम से अनुकूलित होते हैं। टोकनाइज़र, एन्कोडर, डिकोडर, लेटेंट स्पेस और सैंपलिंग सेटिंग्स परिणामों को आकार देती हैं। तापमान और उम्मीदवार फ़िल्टरिंग निर्धारकता और विविधता के बीच समझौता करती हैं। लंबी प्रॉम्प्ट्स संदर्भ प्रदान करती हैं पर टकराव, विचलन या दुर्भावनापूर्ण निर्देश भी शामिल कर सकती हैं। रिट्रीवल बदलते ज्ञान को आधार दे सकता है, जबकि निर्धारक कोड सटीक गणनाओं और नियमों को संभालना चाहिए।
मूल्यांकन, उत्पत्ति और अधिकार
कार्य के अनुसार मूल्यांकन करें: उत्तरों के लिए तथ्यात्मक शुद्धता और उद्धरण, कोड के लिए निष्पादन और सुरक्षा, मीडिया के लिए फ़िडेलिटी और विविधता, तथा रचनात्मक सहायता के लिए मानवीय परिणाम। अस्वीकार, कैलिब्रेशन, लेटेंसी, लागत, भाषाएँ, पहुँच और प्रतिकूल परीक्षणों को शामिल करें। प्रवाहमान या फ़ोटोरियलिस्टिक आउटपुट भी गलत हो सकता है। पुनरुत्पादन के लिए मॉडल, प्रॉम्प्ट, सीड, स्रोत प्रमाण, टूल कॉल और पोस्ट‑प्रोसेसिंग को संरक्षित रखें। रिट्रीवल गुणवत्ता को जनरेशन से अलग रखें ताकि एक परिष्कृत उत्तर लापता प्रमाण को छिपा न सके।
प्रशिक्षण और आउटपुट कॉपीराइट, लाइसेंस, सहमति, गोपनीयता, प्रकाशन और गोपनीयता संबंधी प्रश्न उठाते हैं। इनपुट डेटा की उत्पत्ति और अनुमत उपयोग स्थापित करें; उपयोगकर्ताओं को रहस्य उजागर करने से रोकें; स्मरण शक्ति का परीक्षण करें; और रिपोर्टिंग व हटाने की प्रक्रियाएँ प्रदान करें। सिंथेटिक मीडिया को जहाँ संभव हो टिकाऊ उत्पत्ति या प्रकटीकरण होना चाहिए, विशेषकर जब इसे प्रमाण समझा जा सकता है। अधिकारों का उल्लंघन या धोखा देने वाले तरीके से समानता, आवाज़ या शैली का उपयोग न करें।
डिप्लॉयमेंट नियंत्रण
मॉडल आउटपुट को अविश्वसनीय इनपुट मानें। स्कीमा सत्यापित करें, कोड और फ़ाइलों को साफ़ करें, निष्पादन को अलग रखें, प्रत्येक टूल को बाहरी रूप से अधिकृत करें, लागत और दर सीमित करें, और महत्वपूर्ण कार्यों के लिए पुष्टि आवश्यक रखें। विफलताओं, दुरुपयोग, ड्रिफ्ट और उपयोगकर्ता सुधारों की निगरानी करें, रोलबैक और एक गैर‑जनरेटिव बैकफ़ॉल के साथ। इच्छित और प्रतिबंधित उपयोग का दस्तावेज़ बनाएं। जनरेटिव एआई जानकारी बनाने और रूपांतरित करने के इंटरफ़ेस को विस्तारित करता है, पर विश्वसनीयता और जवाबदेही आसपास के डेटा, मूल्यांकन, सुरक्षा, उत्पत्ति और मानवीय निर्णय प्रक्रिया से आती है।
व्यावहारिक उदाहरण: एक जनरेटिव उत्पाद‑विवरण सहायक
एक रिटेलर संपादकों को केवल स्वीकृत उत्पाद गुणों और ब्रांड मार्गदर्शन से ड्राफ्ट विवरण उत्पन्न करने देता है। प्रॉम्प्ट में संरचित तथ्य शामिल होते हैं, जबकि रिट्रीवल वर्तमान नीति प्रदान करता है। आउटपुट को एक स्कीमा का पालन करना चाहिए और स्रोत मानों के विरुद्ध सत्यापित किया जाता है; असमर्थित आयाम, सुरक्षा दावे या प्रमाणपत्र अस्वीकृति का कारण बनते हैं। मूल्यांकन में तथ्यात्मक शुद्धता, शैली, दोहराव, बहुभाषी गुणवत्ता, पहुँच, लेटेंसी और संपादक सुधार शामिल होते हैं, जिन्हें टेम्पलेट और मैन्युअल लेखन से तुलना की जाती है।
संपादक हर प्रकाशन को अनुमोदित करते हैं और स्रोत फ़ील्ड देख सकते हैं। मॉडल के पास मूल्य, इन्वेंट्री बदलने या सीधे प्रकाशित करने की क्षमता नहीं है। प्रॉम्प्ट और उत्पाद डेटा को इंजेक्शन से सुरक्षित रखा जाता है, और गोपनीय आपूर्तिकर्ता नोट्स को बाहर रखा जाता है। मॉनिटरिंग असमर्थित दावों, संपादनों, शिकायतों, लागत और प्रदाता संस्करणों को ट्रैक करती है। उत्पन्न टेक्स्ट को उत्पत्ति के साथ संग्रहीत किया जाता है। प्रणाली केवल तभी ड्राफ्टिंग समय बचाती है जब सुधार और समीक्षा लाभ को मिटाए नहीं और उत्पाद सत्य अधिकृत डेटा द्वारा शासित रहता है।
कार्यान्वयन प्रमाण और परिचालन तत्परता
एक उत्पादन निर्णय को सफल डेमो से अधिक की आवश्यकता होती है। इच्छित उपयोगकर्ताओं, संचालन वातावरण, इनपुट, आउटपुट, निर्भरताएँ, मालिक और प्रत्येक महत्वपूर्ण विफलता के परिणाम को परिभाषित करें। ट्यूनिंग से पहले एक पुनरुत्पादक बेसलाइन और संस्करणित मूल्यांकन सेट स्थापित करें। सामान्य मामलों, सीमा स्थितियों, विकृत या अनुपस्थित इनपुट, वितरण परिवर्तन, निर्भरता आउटेज, दुरुपयोग, और सबसे अधिक सेवा‑रहित समूहों या वातावरण का परीक्षण करें। कार्य गुणवत्ता को कैलिब्रेशन या अनिश्चितता, लेटेंसी, थ्रूपुट, संसाधन लागत, पहुँच, गोपनीयता और सुरक्षा के साथ मापें। प्रत्येक परिवर्तन और थ्रेशोल्ड को रिकॉर्ड करें ताकि एक स्वतंत्र समीक्षक परिणाम को पुनरुत्पादित कर सके और आकर्षक प्रोटोटाइप से प्रमाण को अलग कर सके।
लॉन्च से पहले, रिलीज़, अपवाद, परिवर्तन, रोलबैक और सेवानिवृत्ति के लिए अधिकार सौंपें। चरणबद्ध रोलआउट का उपयोग करें, एक सुरक्षित बैकफ़ॉल रखें, और जानबूझकर डाली गई विफलताओं के साथ मॉनिटरिंग की पुष्टि करें। परिचालन टेलीमेट्री को इनपुट गुणवत्ता, आउटपुट व्यवहार, मॉडल या नियम संस्करण, निर्भरता स्वास्थ्य, मानवीय ओवरराइड और पुष्टि किए गए परिणाम दिखाने चाहिए, बिना अनावश्यक संवेदनशील डेटा एकत्र किए। अलर्ट थ्रेशोल्ड और प्रतिक्रिया मालिक को परिभाषित करें, फिर डिप्लॉयमेंट के बाद वास्तविक‑विश्व प्रमाण की समीक्षा करें, न कि ऑफ़लाइन प्रदर्शन को स्थायी मानें। जब भी डेटा स्रोत, उपयोगकर्ता, मॉडल, विक्रेता, नीतियाँ, हार्डवेयर या उद्देश्यों में परिवर्तन हो, पुनः‑मूल्यांकन करें। एक रखरखाव प्रणाली को दस्तावेज़ित पुनर्प्राप्ति, घटना सीखना, हटाना और रख‑रखाव प्रक्रियाएँ, तथा एक स्पष्ट बिंदु चाहिए जहाँ इसे निष्क्रिय या प्रतिस्थापित किया जाए।
अक्सर पूछे जाने वाले प्रश्न
क्या जनरेटिव एआई वही बड़ा भाषा मॉडल है?
नहीं। LLM एक वर्ग के जनरेटिव मॉडल हैं। जनरेटिव एआई में छवि, ऑडियो, वीडियो और कई आर्किटेक्चर से निर्मित संरचित‑डेटा सिस्टम भी शामिल हैं।
क्या मॉडल अपने प्रशिक्षण डेटा को कॉपी करता है?
यह सामान्यतः सीखे हुए पैटर्न से संश्लेषित करता है, पर स्मरण शक्ति और निकट‑डुप्लिकेशन हो सकता है। गोपनीयता और उत्पत्ति जोखिमों का मूल्यांकन करना आवश्यक है, न कि उन्हें अनदेखा करना।
मुख्य संदर्भ