
एआई की मूल बातें
जनरेटिव एडवर्सेरियल नेटवर्क (GAN) क्या है?

 Unite.AI को Google पर अपने पसंदीदा स्रोतों में जोड़ें
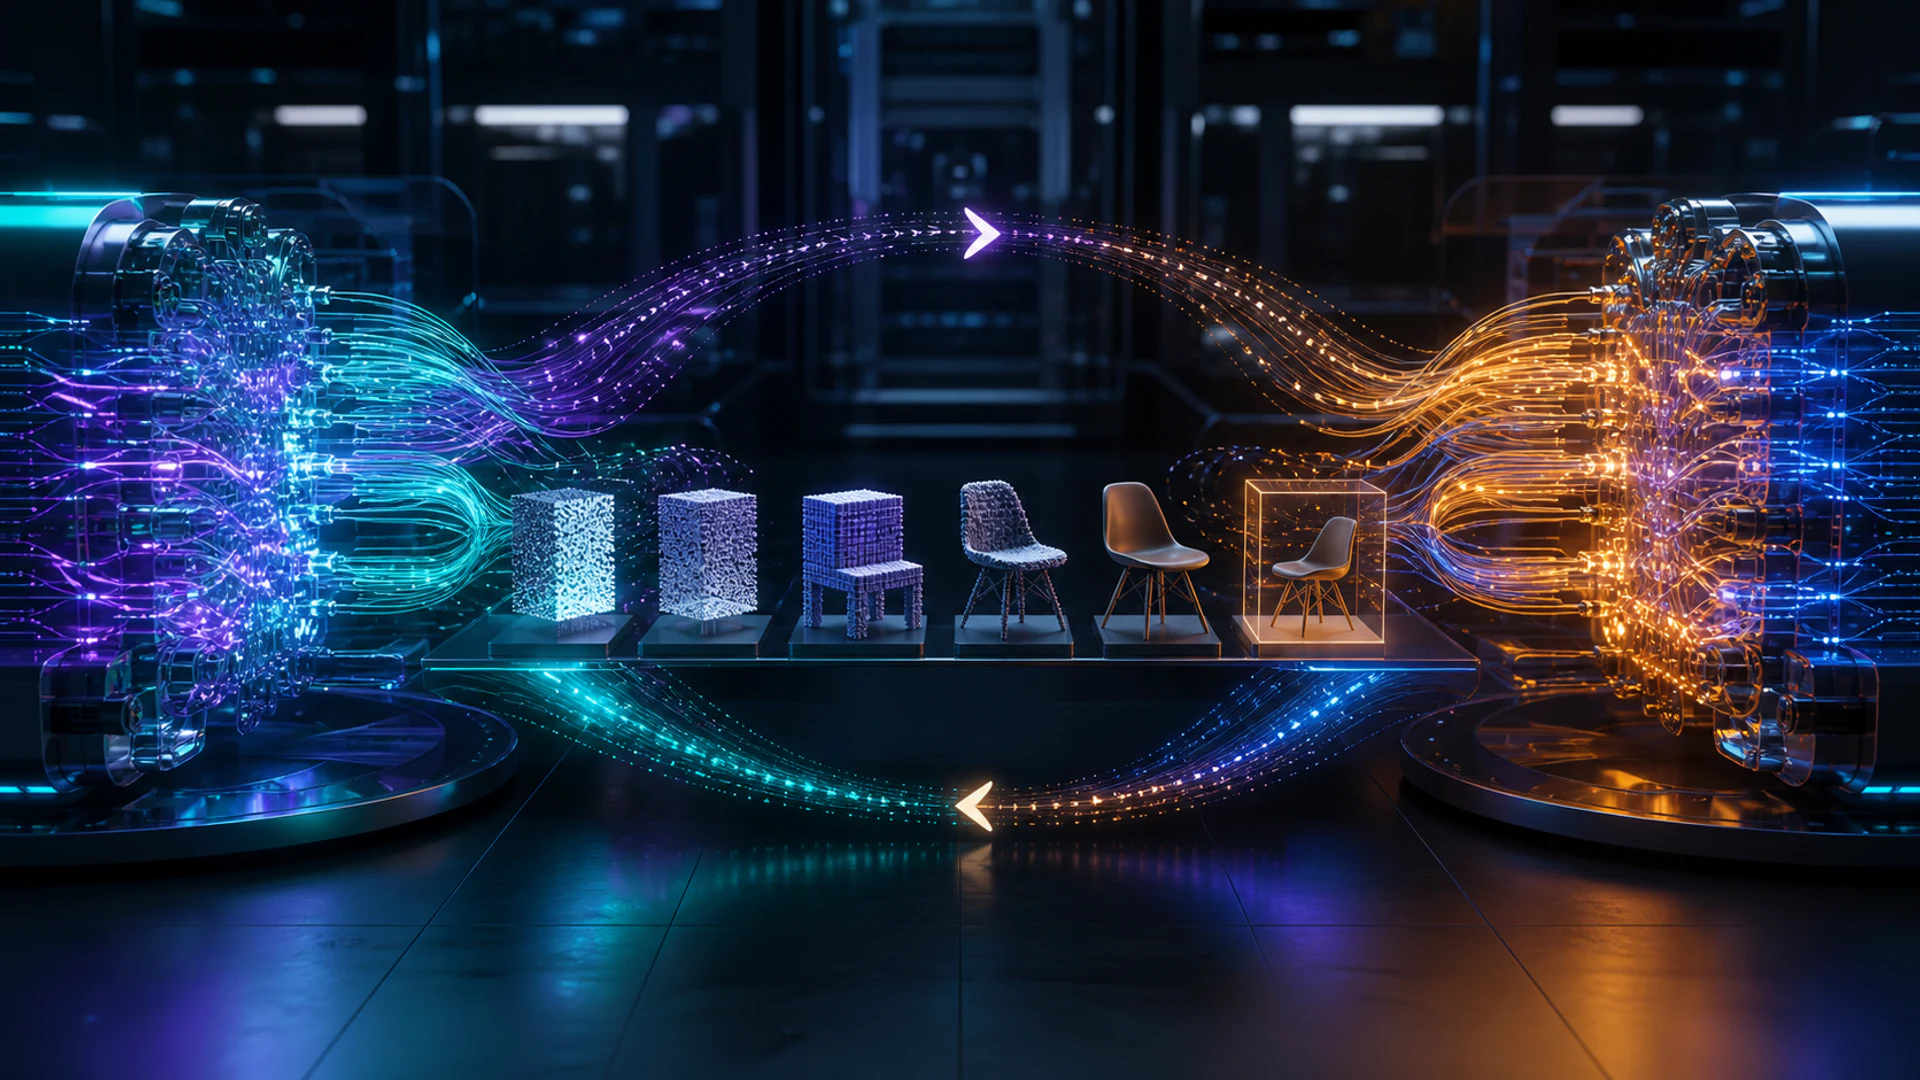
एक जनरेटिव एडवर्सेरियल नेटवर्क (GAN) दो न्यूरल नेटवर्क को प्रतिस्पर्धा में प्रशिक्षित करता है। एक जेनरेटर यादृच्छिक या शर्तीय इनपुट को सिंथेटिक नमूनों में बदलता है। एक डिस्क्रिमिनेटर उत्पन्न नमूनों को वास्तविक प्रशिक्षण उदाहरणों से अलग करने का प्रयास करता है। प्रत्येक नेटवर्क की प्रतिक्रिया दूसरे के सीखने की समस्या को बदल देती है।
GAN तेज़ छवियों और नियंत्रित सिंथेटिक डेटा बना सकते हैं, लेकिन एडवर्सेरियल प्रशिक्षण को स्थिर करना कठिन होता है। दृश्य यथार्थता विविधता, तथ्यात्मक वैधता या प्रशिक्षण डेटा के उपयोग की अनुमति का प्रमाण नहीं है।
मुख्य बिंदु
- जेनरेटर नमूने उत्पन्न करता है; डिस्क्रिमिनेटर वास्तविक बनाम उत्पन्न निर्णय संकेत सीखता है।
- प्रशिक्षण संतुलन की तलाश करता है, लेकिन विरोधियों के बदलने से अस्थिरता, दोलन या मोड कोलैप्स हो सकता है।
- कंडीशनल GAN लेबल, टेक्स्ट या अन्य संदर्भ के साथ जनरेशन को नियंत्रित करते हैं।
- मूल्यांकन को विश्वसनीयता, कवरेज, स्मृति और डाउनस्ट्रीम जोखिम की जाँच करनी चाहिए—केवल छवि गुणवत्ता नहीं।
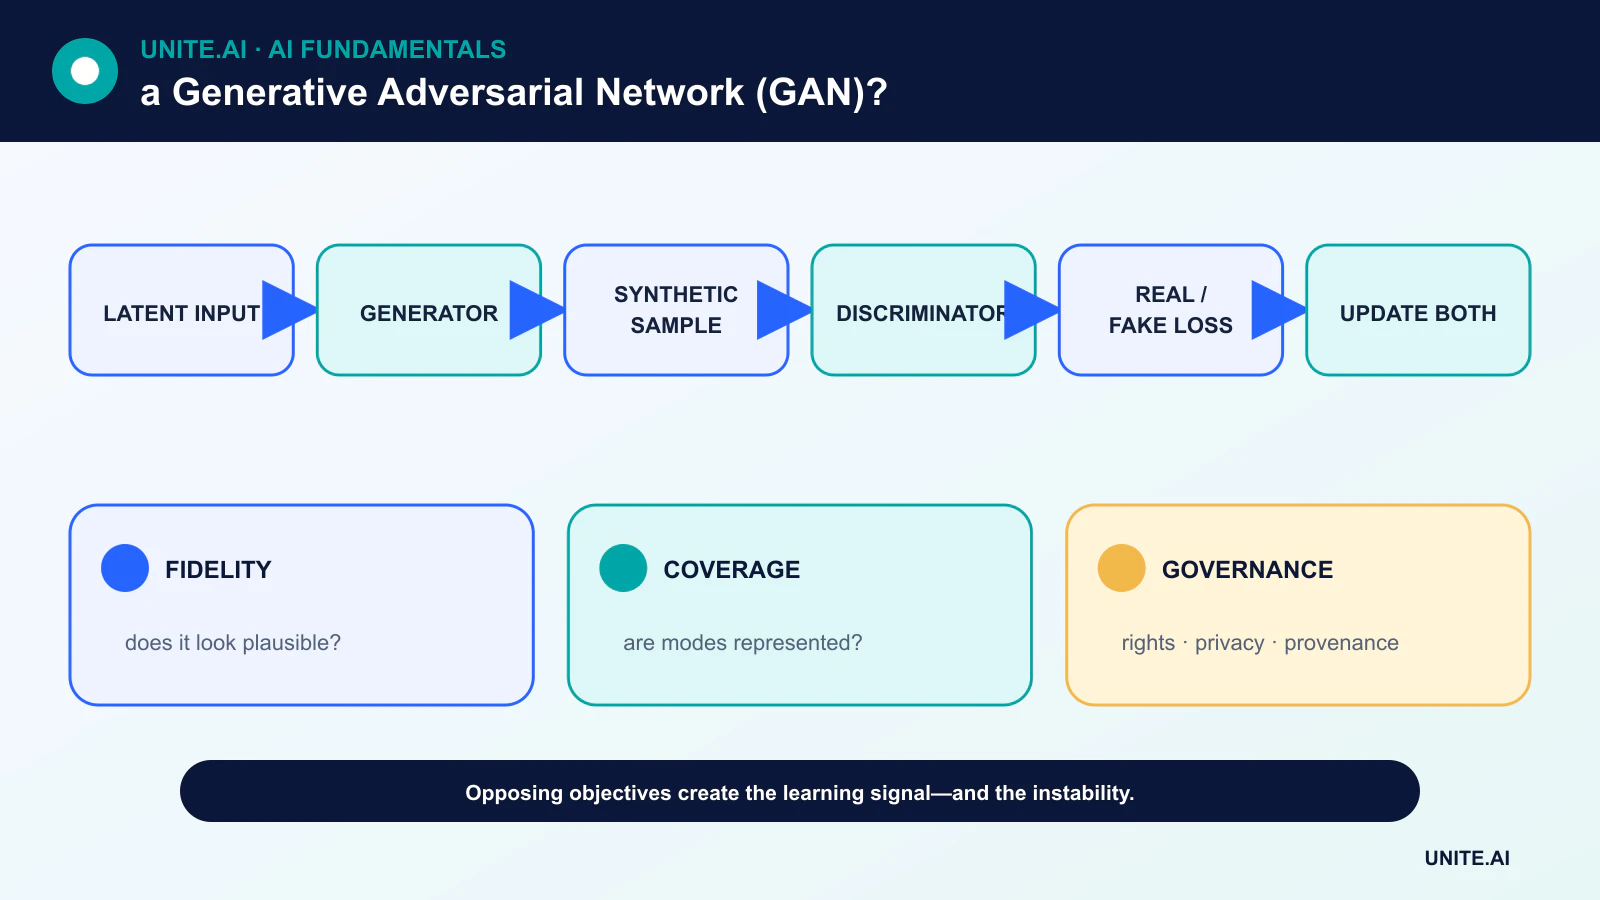
एडवर्सेरियल खेल
मूल रूपरेखा दो-खिलाड़ी मिनीमैक्स खेल है। डिस्क्रिमिनेटर वास्तविक डेटा को उत्पन्न डेटा से अलग करने में सुधार करता है, जबकि जेनरेटर ऐसे नमूने बनाने में सुधार करता है जिन्हें डिस्क्रिमिनेटर वास्तविक मानता है। दोनों को बैकप्रोपेगेशन से प्रशिक्षित किया जाता है।
यदि डिस्क्रिमिनेटर बहुत सटीक हो जाता है, तो उसकी प्रतिक्रिया जेनरेटर के लिए उपयोगी नहीं हो सकती। यदि यह बहुत कमजोर हो, तो जेनरेटर आसान शॉर्टकट का फायदा उठा सकता है। इसलिए प्रशिक्षण में अपडेट्स को वैकल्पिक रूप से किया जाता है और क्षमता, हानि और अनुकूलन सेटिंग्स को सावधानीपूर्वक संतुलित किया जाता है।
मोड कोलैप्स और प्रशिक्षण स्थिरता
मोड कोलैप्स तब होता है जब कई लेटेंट इनपुट समान आउटपुट उत्पन्न करते हैं, जिससे नमूने यथार्थ लगते हैं लेकिन डेटा वितरण के केवल एक हिस्से को ही कवर करते हैं। अन्य विफलताओं में दोलन, ग्रेडिएंट का विस्फोट और यादृच्छिक प्रारम्भिकरण के प्रति संवेदनशीलता शामिल हैं।
वॉसर्स्टीन उद्देश्यों, ग्रेडिएंट पेनाल्टी, स्पेक्ट्रल नॉर्मलाइज़ेशन, आर्किटेक्चर परिवर्तन और समायोजित अपडेट अनुपात स्थिरता को सुधार सकते हैं। लेकिन वे विविधता की जांच और कई सीड्स के साथ प्रयोग दोहराने की आवश्यकता को नहीं हटाते।
शर्तीय जनरेशन और लेटेंट नियंत्रण
एक कंडीशनल GAN जेनरेटर और डिस्क्रिमिनेटर को लेबल या अन्य संदर्भ प्रदान करता है, जिससे लक्षित वर्ग या गुण संभव होते हैं। स्टाइल-आधारित आर्किटेक्चर विभिन्न रेज़ॉल्यूशन पर लेटेंट नियंत्रण के पहलुओं को अलग करते हैं और अत्यधिक यथार्थवादी छवियां उत्पन्न की हैं।
लेटेंट दिशाएँ मानव अवधारणाओं से संबंधित हो सकती हैं, लेकिन एक गुण को संपादित करने से अन्य बदल सकते हैं क्योंकि प्रशिक्षण डेटा में सहसंबंधित विशेषताएँ होती हैं। नियंत्रण की दावों की जांच विविध पहचान और संदर्भों में की जानी चाहिए।
मूल्यांकन, गोपनीयता और उत्पत्ति
फ़्रेशे इन्सेप्शन डिस्टेंस जैसी मेट्रिक्स फीचर वितरण की तुलना करती हैं, लेकिन वे फीचर मॉडल से धारणाएँ विरासत में लेती हैं और स्मृति या उपसमूह विफलताओं को मिस कर सकती हैं। निकटतम पड़ोसी विश्लेषण, प्रिसीजन/रिकॉल-शैली कवरेज परीक्षण और मानव समीक्षा पूरक प्रमाण प्रदान करती हैं।
एक GAN दुर्लभ उदाहरणों को याद रख सकता है, पक्षपात दोहरा सकता है या धोखेबाज़ मीडिया बना सकता है। टीमों को डेटासेट, अधिकार, फ़िल्टरिंग, वॉटरमार्क या उत्पत्ति तंत्र और दुरुपयोग नियंत्रणों का दस्तावेज़ीकरण करना चाहिए। सिंथेटिक डेटा स्वचालित रूप से गुमनाम नहीं होते।
GAN, VAE और डिफ्यूज़न मॉडल
वेरिएशनल ऑटोएन्कोडर एक संभाव्यता-आधारित लेटेंट उद्देश्य को अनुकूलित करते हैं और अक्सर नमूना तीक्ष्णता को संरचित लेटेंट स्पेस के लिए बदलते हैं। डिफ्यूज़न मॉडल शोर प्रक्रिया को उलटना सीखते हैं और छवि जनरेशन के लिए एक सामान्य आधार बन गए हैं।
जब तेज़ एक-बार सैंपलिंग, विशिष्ट इमेज-टू-इमेज मैपिंग या कॉम्पैक्ट डिप्लॉयमेंट महत्वपूर्ण हो, तो GAN उपयोगी रहते हैं। सही विधि गुणवत्ता, विविधता, लेटेंसी, प्रशिक्षण स्थिरता और गवर्नेंस पर निर्भर करती है—न कि कौन सा आर्किटेक्चर सबसे नया है।
एडवर्सेरियल उद्देश्यों और प्रशिक्षण गतिशीलता
एक जनरेटिव एडवर्सेरियल नेटवर्क जेनरेटर को नमूने उत्पन्न करने और डिस्क्रिमिनेटर को उत्पन्न और वास्तविक डेटा में अंतर करने के लिए प्रशिक्षित करता है। मूल मिनीमैक्स खेल में, डिस्क्रिमिनेटर घनत्व-अनुपात-संबंधित संकेत का अनुमान लगाता है और जेनरेटर उसे धोखा देने की कोशिश करता है। प्रशिक्षण वैकल्पिक रूप से अपडेट करता है, इसलिए प्रत्येक नेटवर्क एक स्थिर नुकसान के बजाय चलती हुई प्रतिद्वंद्वी के खिलाफ सीखता है। यदि डिस्क्रिमिनेटर बहुत मजबूत हो जाता है, तो जेनरेटर के ग्रेडिएंट उपयोगी नहीं रह जाते; यदि बहुत कमजोर हो, तो उत्पन्न गुणवत्ता स्थिर हो जाती है। केवल नुकसान मान सीधे नमूना गुणवत्ता से मेल नहीं खाता।
मोड कोलैप्स तब होता है जब जेनरेटर सीमित विविधताएँ उत्पन्न करता है जो डिस्क्रिमिनेटर को धोखा देती हैं। दोलन, हाइपरपैरामीटर के प्रति संवेदनशीलता, और अस्थिर नॉर्मलाइज़ेशन भी सामान्य हैं। वॉसर्स्टीन उद्देश्यों, ग्रेडिएंट पेनाल्टी, स्पेक्ट्रल नॉर्मलाइज़ेशन, फीचर मैचिंग, मिनीबैच सांख्यिकी, और सावधानीपूर्वक संतुलित अपडेट शेड्यूल विभिन्न विफलता तंत्रों को संबोधित करते हैं। कंडीशनल GAN लेबल, टेक्स्ट या छवियों का उपयोग आउटपुट को मार्गदर्शन करने के लिए करते हैं; स्टाइल-आधारित आर्किटेक्चर लेटेंट प्रभावों को अलग करते हैं। डेटासेट की गुणवत्ता और कवरेज मूलभूत रहती है क्योंकि जेनरेटर वह वितरण दोहराता और पुनः संयोजित करता है जिसे वह देखता है।
मूल्यांकन और जिम्मेदार उपयोग
विश्वसनीयता और विविधता को अलग-अलग मूल्यांकन करें। फ़्रेशे इन्सेप्शन डिस्टेंस फीचर वितरण की तुलना करता है लेकिन नमूना आकार, फीचर मॉडल, प्रीप्रोसेसिंग और डोमेन पर निर्भर करता है; इन्सेप्शन स्कोर वास्तविक डेटा के साथ तुलना को छोड़ देता है। जनरेटिव मॉडलों के लिए प्रिसीजन और रिकॉल, निकटतम पड़ोसी विश्लेषण, स्मृति जाँच, और मानव कार्य मूल्यांकन अतिरिक्त प्रमाण प्रदान करते हैं। वैज्ञानिक या चिकित्सा संश्लेषण के लिए डोमेन मेट्रिक्स और डाउनस्ट्रीम वैलिडेशन का उपयोग करें। एक अलग रखी वास्तविक सेट रखें और डिफ्यूज़न या ऑटोरिग्रेसिव बेसलाइन के साथ समान कंप्यूट और रिज़ॉल्यूशन पर तुलना करें।
GAN डेटा को बढ़ा सकते हैं, डोमेनों का अनुवाद कर सकते हैं, छवियों को सुपर-रिज़ॉल्व कर सकते हैं, मीडिया को संश्लेषित कर सकते हैं, और सिमुलेशन का समर्थन कर सकते हैं, लेकिन सिंथेटिक डेटा पक्षपात को बढ़ा सकता है या प्रशिक्षण उदाहरणों को लीक कर सकता है। लाइसेंसिंग, सहमति, पहचान और उत्पत्ति की पुष्टि करें। गैर-सहमति वाली नकल और धोखेबाज़ उपयोग से बचें, जहाँ उपयुक्त हो आउटपुट को लेबल या साइन करें, और जनरेशन मेटाडेटा रखें। एक फ़ोटोरियलिस्टिक छवि दस्तावेज़ी प्रमाण नहीं है; अनिश्चितता और सिंथेटिक मूल को स्पष्ट रूप से दिखाया जाना चाहिए जब आउटपुट निर्णयों को प्रभावित करते हैं।
डिप्लॉयमेंट और पुनरुत्पादनशीलता
जेनरेटर, डिस्क्रिमिनेटर, ऑप्टिमाइज़र, डेटासेट, रैंडम सीड, ट्रंकेशन और सैंपलिंग सेटिंग्स को रिकॉर्ड करें। क्वांटाइज़ेशन या एक्सपोर्ट नॉर्मलाइज़ेशन और आउटपुट को बदल सकता है, इसलिए सर्विंग आर्टिफैक्ट को वैध करें। प्रॉम्प्ट या कंडीशन वितरण, सुरक्षा फ़िल्टर, आउटपुट विविधता, लेटेंसी और रिपोर्टों की निगरानी करें। सार्वजनिक सिस्टम में रेट लिमिट और पहचान सुरक्षा उपायों का उपयोग करें। GAN प्रशिक्षण एक जुड़ा हुआ अनुकूलन प्रयोग है: चयनित शोकेस छवियां मजबूती, कवरेज या स्मृति की अनुपस्थिति स्थापित नहीं कर सकतीं, और मॉडल को इरादे वाले जनरेशन कार्यों के पूर्ण वितरण पर मूल्यांकन किया जाना चाहिए।
व्यावहारिक उदाहरण: GAN के साथ सिंथेटिक दोष छवियां
एक निर्माता दुर्लभ सतह-दोष छवियां बनाने के लिए एक कंडीशनल GAN को प्रशिक्षित करता है। यह सुनिश्चित करता है कि प्रशिक्षण छवियों के अधिकार हों और प्रशिक्षण व मूल्यांकन से पहले उत्पादन लॉट को अलग करता है। उत्पन्न नमूनों की निकटतम पड़ोसी स्मृति, दोष ज्यामिति, पृष्ठभूमि कलाकृतियों, विविधता और विशेषज्ञ यथार्थता के लिए जाँच की जाती है। सिंथेटिक ऑग्मेंटेशन के साथ प्रशिक्षित वर्गीकरणकर्ता को केवल स्वतंत्र वास्तविक दोषों पर मूल्यांकन किया जाता है, वही वर्गीकरणकर्ता पारंपरिक ऑग्मेंटेशन के साथ तुलना में।
सिंथेटिक डेटा तभी स्वीकार किया जाता है जब वास्तविक दुनिया में रिकॉल सुधार हो और गलत अस्वीकृति या उपसमूह त्रुटियों में वृद्धि न हो। जनरेशन सेटिंग्स और उत्पत्ति प्रत्येक छवि के साथ जुड़ी रहती हैं, और सिंथेटिक फ़ाइलें कभी परीक्षण सेट या प्रमाण संग्रह में वास्तविक निरीक्षणों के रूप में नहीं जातीं। ऑपरेटर जेनरेटर का उपयोग ऑडिट रिकॉर्ड बनाने के लिए नहीं कर सकते। टीम डिफ्यूज़न विकल्पों और अधिक वास्तविक उदाहरणों को इकट्ठा करने की लागत की तुलना करती है, यह मानते हुए कि यथार्थवादी दिखावट यह प्रमाण नहीं है कि GAN ने भौतिक विफलता प्रक्रिया को पकड़ लिया है।
कार्यान्वयन प्रमाण और परिचालन तत्परता
एक उत्पादन निर्णय को सफल प्रदर्शन से अधिक की आवश्यकता होती है। इरादे वाले उपयोगकर्ताओं, संचालन वातावरण, इनपुट, आउटपुट, निर्भरताओं, मालिक और प्रत्येक महत्वपूर्ण विफलता के परिणाम को परिभाषित करें। ट्यूनिंग से पहले एक पुनरुत्पादनीय बेसलाइन और संस्करणित मूल्यांकन सेट स्थापित करें। सामान्य मामलों, सीमा स्थितियों, विकृत या अनुपस्थित इनपुट, वितरण बदलाव, निर्भरता विफलता, दुरुपयोग, और उन समूहों या वातावरणों का परीक्षण करें जो सबसे अधिक सेवा रहित हो सकते हैं। कार्य गुणवत्ता को कैलिब्रेशन या अनिश्चितता, लेटेंसी, थ्रूपुट, संसाधन लागत, पहुँच, गोपनीयता और सुरक्षा के साथ मापें। प्रत्येक परिवर्तन और थ्रेशोल्ड को रिकॉर्ड करें ताकि एक स्वतंत्र समीक्षक परिणाम को दोहरा सके और आकर्षक प्रोटोटाइप से प्रमाण को अलग कर सके।
लॉन्च से पहले, रिलीज़, अपवाद, परिवर्तन, रोलबैक और रिटायरमेंट के लिए अधिकार सौंपें। चरणबद्ध रोलआउट का उपयोग करें, एक सुरक्षित फॉलबैक रखें, और जानबूझकर डाले गए विफलताओं के साथ मॉनिटरिंग की पुष्टि करें। परिचालन टेलीमेट्री को इनपुट गुणवत्ता, आउटपुट व्यवहार, मॉडल या नियम संस्करण, निर्भरता स्वास्थ्य, मानव ओवरराइड और पुष्टि किए गए परिणाम दिखाने चाहिए, बिना अनावश्यक संवेदनशील डेटा एकत्र किए। अलर्ट थ्रेशोल्ड और प्रतिक्रिया जिम्मेदार को परिभाषित करें, फिर डिप्लॉयमेंट के बाद वास्तविक विश्व प्रमाण की समीक्षा करें, न कि ऑफ़लाइन प्रदर्शन को स्थायी मानें। जब भी डेटा स्रोत, उपयोगकर्ता, मॉडल, विक्रेता, नीतियां, हार्डवेयर या लक्ष्य बदलें, पुनः मूल्यांकन करें। एक बनाए रखा गया सिस्टम दस्तावेज़ीकृत पुनर्प्राप्ति, घटना सीखना, विलोपन और रखरखाव प्रक्रियाओं, और एक स्पष्ट बिंदु की भी आवश्यकता रखता है जहाँ इसे निष्क्रिय या प्रतिस्थापित किया जाना चाहिए।
अक्सर पूछे जाने वाले प्रश्न
क्या GAN उन छवियों को समझता है जो वह बनाता है?
GAN जनरेशन के लिए उपयोगी सांख्यिकीय संरचना सीखता है। यह स्वयं मानव-समान अर्थात्मक या कारणात्मक समझ स्थापित नहीं करता।
क्या GAN-जनित नमूने प्रशिक्षण डेटा के रूप में उपयोग करने के लिए सुरक्षित हैं?
केवल कवरेज, लेबल वैधता, स्मृति, पक्षपात और यह जांचने के बाद कि सिंथेटिक वितरण वास्तविक रखी गई परीक्षण सेट पर मदद करता है, तब ही।
प्राथमिक संदर्भ












