
एआई की मूल बातें
कंप्यूटर विज़न क्या है?

 Unite.AI को Google पर अपने पसंदीदा स्रोतों में जोड़ें
Computer vision वह क्षेत्र है जो छवियों और वीडियो से उपयोगी जानकारी निकालने वाले सिस्टम बनाता है। एक विज़न मॉडल पूरी छवि को वर्गीकृत कर सकता है, वस्तुओं का पता लगा सकता है, प्रत्येक पिक्सेल को लेबल कर सकता है, पाठ पढ़ सकता है, पोज़ का अनुमान लगा सकता है, गति को ट्रैक कर सकता है, या दृश्य सामग्री को भाषा से जोड़ सकता है।
आधुनिक विज़न सिस्टम केवल मानव धारणा की शुरुआती किनारा-डिटेक्शन प्रक्रिया को दोहराते नहीं हैं। वे डेटा से कार्य-विशिष्ट प्रतिनिधित्व सीखते हैं, अक्सर कन्वॉल्यूशनल न्यूरल नेटवर्क, विज़न ट्रांसफ़ॉर्मर, या मल्टीमॉडल फाउंडेशन मॉडल का उपयोग करके।
मुख्य बिंदु
- वर्गीकरण, डिटेक्शन, सेगमेंटेशन, OCR, ट्रैकिंग, और जनरेशन अलग-अलग विज़न कार्य हैं।
- CNN स्थानीयता और वज़न साझा करने को शामिल करते हैं; विज़न ट्रांसफ़ॉर्मर इमेज पैचों के बीच अटेंशन का उपयोग करते हैं।
- लेबल मानवों, कमजोर सुपरविजन, सिंथेटिक डेटा, या स्वयं-पर्यवेक्षित उद्देश्यों से प्राप्त हो सकते हैं।
- सटीकता अकेले पर्याप्त नहीं है: मजबूती, लेटेंसी, गोपनीयता, पक्षपात, और विफलता लागतें महत्वपूर्ण हैं।
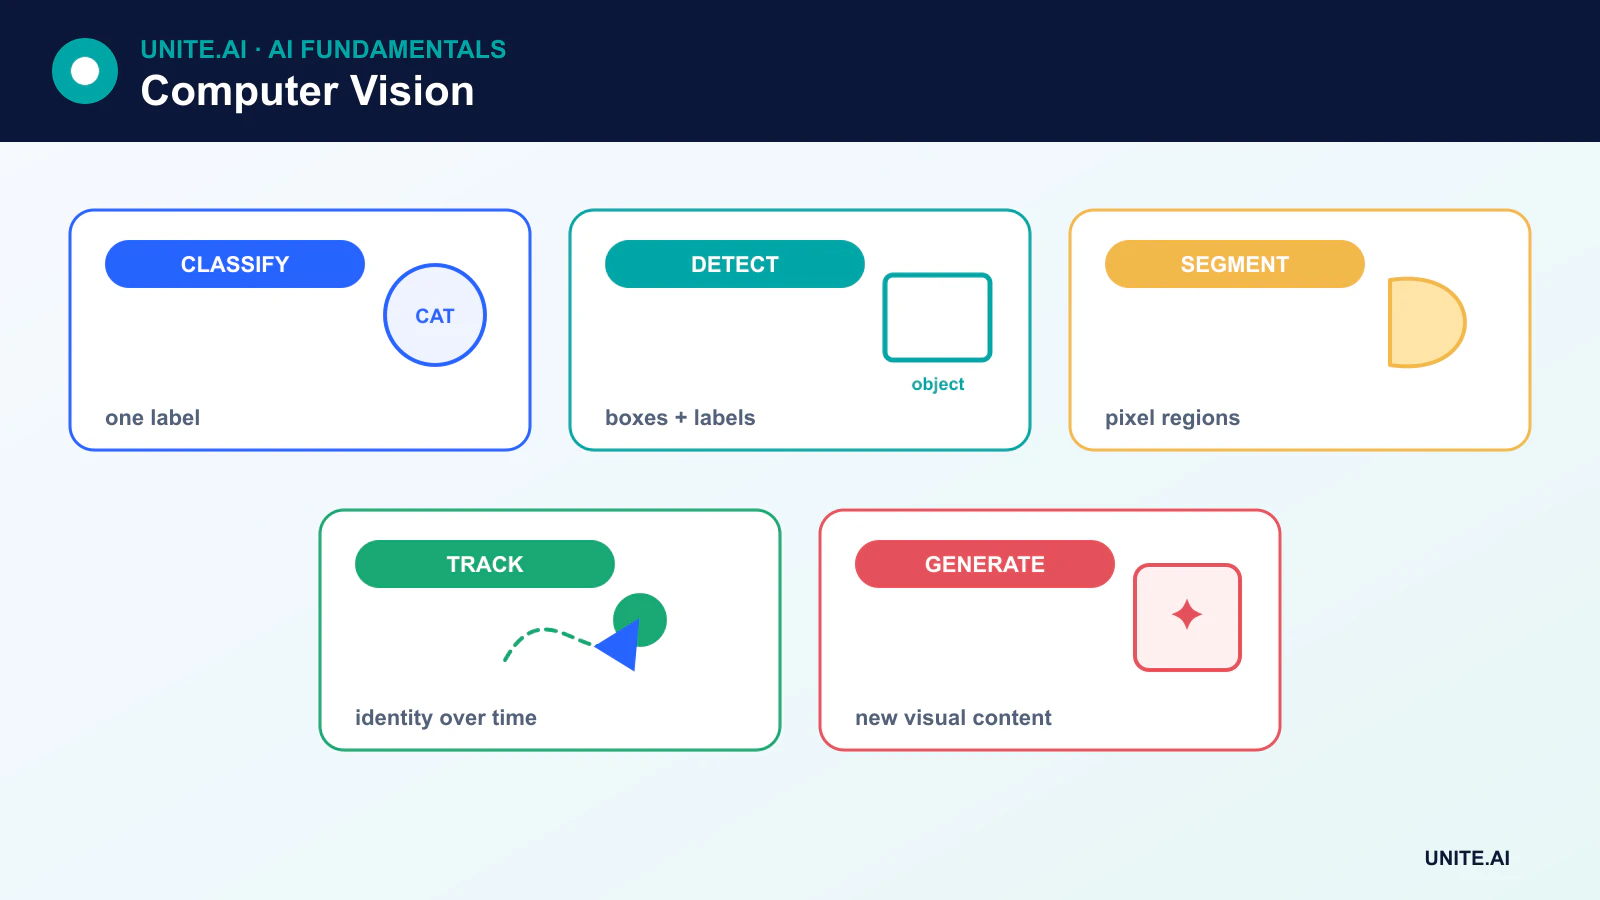
मुख्य कंप्यूटर-विज़न कार्य
- Image classification एक या अधिक लेबल छवि को असाइन करता है। देखें छवि वर्गीकरण कैसे काम करता है।
- Object detection कई वस्तुओं के लिए वर्ग और बाउंडिंग बॉक्स की भविष्यवाणी करता है।
- Semantic segmentation प्रत्येक पिक्सेल को वर्ग द्वारा लेबल करता है, जबकि इंस्टेंस सेगमेंटेशन व्यक्तिगत वस्तुओं को अलग करता है।
- Optical character recognition (OCR) पाठ को पहचानता और ट्रांसक्राइब करता है।
- Pose estimation शरीर या वस्तु के लैंडमार्क की भविष्यवाणी करता है।
- Tracking वीडियो फ्रेमों में डिटेक्शन को जोड़ता है।
- Image generation and editing दृश्य सामग्री बनाते या परिवर्तित करते हैं, अक्सर डिफ्यूज़न मॉडल का उपयोग करके।
छवियां मॉडल इनपुट कैसे बनती हैं
डिजिटल छवि पहले से ही संख्यात्मक डेटा है: एक टेन्सर जिसमें स्थानिक आयामों और चैनलों में पिक्सेल मान होते हैं। प्रीप्रोसेसिंग छवि को रिसाइज़, नॉर्मलाइज़, क्रॉप या ऑगमेंट कर सकता है। वीडियो में समय आयाम जुड़ता है, जबकि मेडिकल और वैज्ञानिक इमेजिंग में गहराई, तरंगदैर्ध्य या अन्य मोडालिटी जोड़ सकते हैं।
परम्परागत कंप्यूटर विज़न ने हाथ से डिज़ाइन किए गए किनारा, कोना, और टेक्सचर फीचर का उपयोग किया। आधुनिक डीप मॉडल आमतौर पर कार्य के साथ मिलकर फीचर सीखते हैं, हालांकि क्लासिकल विधियां तब उपयोगी रहती हैं जब डेटा सीमित हो, नियम स्पष्ट हों, या गणना न्यूनतम होनी चाहिए।
CNN और सीखे गए स्थानीय फीचर
एक CNN सीखे गए कर्नेल को स्थानीय पड़ोस में लागू करता है। शुरुआती लेयर स्थानीय पैटर्न पर प्रतिक्रिया दे सकते हैं, जबकि बाद के ब्लॉक उन्हें कार्य-प्रासंगिक प्रतिनिधित्व में संयोजित करते हैं। पूलिंग या स्ट्राइडेड ऑपरेशन स्पैटियल रेज़ोल्यूशन को कम करते हैं, और रेजिडुअल कनेक्शन डीप नेटवर्क को ऑप्टिमाइज़ करना आसान बनाते हैं।
एक आधुनिक CNN क्लासिफायर अक्सर बड़े स्टैक के फुली कनेक्टेड लेयर की बजाय ग्लोबल पूलिंग का उपयोग करता है। डिटेक्टर्स और सेगमेंटेशन नेटवर्क विशेष हेड या डिकोडर पाथ जोड़ते हैं जो स्पैटियल जानकारी को संरक्षित रखते हैं।
विज़न ट्रांसफ़ॉर्मर और फाउंडेशन मॉडल
एक विज़न ट्रांसफ़ॉर्मर छवि को पैचों में विभाजित करता है, उन्हें एम्बेड करता है, और उनके संबंधों को मॉडल करने के लिए अटेंशन का उपयोग करता है। ट्रांसफ़ॉर्मर बड़े डेटासेट और प्रीट्रेनिंग के साथ प्रभावी रूप से स्केल कर सकते हैं, जबकि CNN छोटे स्केल पर मजबूत अंतर्निहित धारणाएँ और दक्षता प्रदान करते हैं।
मल्टीमॉडल मॉडल छवियों को टेक्स्ट के साथ संरेखित करते हैं ताकि उपयोगकर्ता खोज, कैप्शन, प्रश्नों के उत्तर, या भाषा का उपयोग करके सेगमेंटेशन को मार्गदर्शन कर सकें। ये मॉडल क्षमताओं को विस्तारित करते हैं लेकिन व्यापक वेब‑स्केल डेटा से उत्पन्न कमजोरियों को भी विरासत में लेते हैं, जिसमें रूढ़िवादिता, कॉपीराइटेड सामग्री, और जनसंख्या व पर्यावरण की असमान कवरेज शामिल है।
लेबल, स्व-पर्यवेक्षण, और सिंथेटिक डेटा
बाउंडिंग बॉक्स, मास्क, लैंडमार्क, और कैप्शन बनाना महंगा हो सकता है। स्व-पर्यवेक्षित लर्निंग इमेजों से ही उद्देश्यों को निकालती है, जबकि कमजोर सुपरविजन शोरयुक्त या अप्रत्यक्ष लेबल का उपयोग करता है। सिंथेटिक डेटा दुर्लभ परिदृश्यों को जोड़ सकता है, लेकिन सिमुलेशन में अंतर सिंथेटिक प्रदर्शन को वास्तविक दुनिया में ट्रांसफर होने से रोक सकता है।
एनोटेशन की गुणवत्ता को मापना आवश्यक है। अस्पष्ट लेबल, असंगत सीमाएँ, और अनुपलब्ध वस्तुएँ प्रदर्शन की सीमा निर्धारित करती हैं और उपसमूह विफलताओं को छुपा सकती हैं।
विज़न सिस्टम का मूल्यांकन कैसे किया जाता है
वर्गीकरण सटीकता, प्रिसीजन, रिकॉल, F1, और कैलिब्रेशन जैसे मेट्रिक्स का उपयोग करता है। डिटेक्शन सामान्यतः इंटरसेक्शन ओवर यूनियन और मीन एवरेज प्रिसीजन का उपयोग करता है। सेगमेंटेशन इंटरसेक्शन ओवर यूनियन या Dice‑स्टाइल मापों का उपयोग करता है। ट्रैकिंग पहचान और ट्रैजेक्टरी मेट्रिक्स जोड़ता है।
मेट्रिक को डिप्लॉयमेंट से मेल खाना चाहिए। एक मॉडल क्यूरेटेड बेंचमार्क पर अच्छा स्कोर कर सकता है लेकिन बारिश, कम रोशनी, असामान्य कैमरा एंगल, नए डिवाइस, या अपरिचित जनसंख्या में विफल हो सकता है। मूल्यांकन में वितरण शिफ्ट, एडवर्सेरियल स्थितियों, और ऑपरेशनल लेटेंसी को शामिल करना चाहिए।
गोपनीयता, पक्षपात, और डिप्लॉयमेंट
चेहरे, लाइसेंस प्लेट, घर, मेडिकल स्कैन, और कार्यस्थल वीडियो संवेदनशील जानकारी प्रकट कर सकते हैं। संग्रह और रखरखाव को निर्धारित कानूनी और नैतिक आधार के अनुसार होना चाहिए, जिसमें एक्सेस कंट्रोल और डेटा न्यूनतमकरण शामिल है। चेहरा विश्लेषण और बायोमेट्रिक पहचान को विशेष जांच की आवश्यकता है क्योंकि त्रुटियां और निगरानी असमान नुकसान पहुंचा सकती हैं।
एज डिप्लॉयमेंट लेटेंसी और डेटा ट्रांसफर को कम कर सकता है। एज AI, क्वांटाइज़ेशन, प्रूनिंग, और विशेष एक्सेलेरेटर विज़न सिस्टम को कैमरों, वाहनों, रोबोट और मोबाइल डिवाइस पर व्यावहारिक बना सकते हैं, लेकिन सटीकता और पक्षपात के लिए संपीड़न का पुनः मूल्यांकन आवश्यक है।
पिक्सेल से दृश्य कार्यों तक
कंप्यूटर विज़न छवियों या वीडियो को वर्गीकरण, डिटेक्शन, सेगमेंटेशन, ट्रैकिंग, पोज़, डेप्थ, ऑप्टिकल फ्लो, या टेक्स्ट रिकॉग्निशन जैसे कार्य आउटपुट में बदलता है। कार्य की परिभाषा एनोटेशन निर्धारित करती है: एक छवि लेबल सटीक लोकेलाइज़ेशन नहीं सिखा सकता, और बाउंडिंग बॉक्स पूरी तरह से सेगमेंटेशन मास्क का वर्णन नहीं कर सकता। कैमरा ज्योमेट्री, लेंस, एक्सपोज़र, लाइटिंग, मोशन, संपीड़न, और व्यूपॉइंट डेटा वितरण को आकार देते हैं। मॉडल चुनने से पहले संचालन पर्यावरण और त्रुटि परिणाम को परिभाषित करें, क्योंकि बेंचमार्क इमेज कलेक्शन डिप्लॉय किए गए सेंसर या सीन को प्रतिनिधित्व नहीं कर सकता।
एक पाइपलाइन मीडिया को डिकोड और ओरिएंट करती है, उसे रिसाइज़ या टाइल करती है, मानों को नॉर्मलाइज़ करती है, लेबल-परिवर्तन न करने वाला ऑगमेंटेशन लागू करती है, मॉडल चलाती है, और लॉजिट, बॉक्स, मास्क, या ट्रैक्स को पोस्टप्रोसेस करती है। ऑब्जेक्ट डिटेक्टर्स कॉन्फिडेंस थ्रेशोल्ड और सप्रेशन का उपयोग करते हैं; ट्रैकर्स समय के साथ डिटेक्शन को जोड़ते हैं; सेगमेंटेशन को मॉर्फ़ोलॉजिकल क्लीनअप की आवश्यकता हो सकती है। कोऑर्डिनेट ट्रांसफ़ॉर्म को संरक्षित रखें ताकि आउटपुट मूल छवि के साथ संरेखित हो। डेटा को व्यक्ति, कैमरा, लोकेशन, या कैप्चर सत्र के आधार पर विभाजित करें ताकि लगभग समान फ्रेम दोनों ट्रेनिंग और टेस्ट सेट में न आएँ।
मूल्यांकन, पक्षपात, गोपनीयता, और संचालन
मेट्रिक्स को कार्य और उपयोग के साथ मेल खाना चाहिए। वर्गीकरण को वर्ग‑विशिष्ट प्रिसीजन और रिकॉल चाहिए; डिटेक्शन इंटरसेक्शन‑ओवर‑यूनियन और थ्रेशोल्ड के पार औसत प्रिसीजन का उपयोग करता है; सेगमेंटेशन IoU या Dice का उपयोग करता है; ट्रैकिंग पहचान स्विच जोड़ता है; वीडियो के लिए लेटेंसी और मिस्ड‑इवेंट अवधि महत्वपूर्ण हैं। परिणामों को लाइटिंग, दूरी, डिवाइस, ऑक्लूज़न, स्किन टोन, उम्र, और अन्य प्रासंगिक स्थितियों के अनुसार रिपोर्ट करें। कैलिब्रेशन और उच्च‑कॉन्फिडेंस त्रुटियों की जांच करें। सिंथेटिक या ऑगमेंटेड डेटा अंतर को भर सकता है लेकिन वास्तविक डिप्लॉयमेंट डेटा के साथ तुलना आवश्यक है और टेस्ट सीन को लीक नहीं करना चाहिए।
विज़न बायस्टैंडर्स, स्थान, बायोमेट्रिक्स, और संवेदनशील व्यवहार एकत्र कर सकता है। कैप्चर और रिटेंशन को न्यूनतम रखें, स्ट्रीम को सुरक्षित करें, द्वितीयक उपयोग को प्रतिबंधित करें, और आवश्यक होने पर नोटिस या सहमति प्रदान करें। एडवर्सेरियल पैच, रिप्ले, ऑक्लूज़न, कैमरा फेल्योर, और डोमेन शिफ्ट का परीक्षण करें। सेंसर स्वास्थ्य, इनपुट स्टैटिस्टिक्स, आउटपुट रेट, और पुष्टि किए गए परिणामों की निगरानी करें; महत्वपूर्ण निर्णयों के लिए मानव समीक्षा रखें। ब्लर या क्रॉपिंग एक्सपोज़र को कम कर सकता है लेकिन साक्ष्य भी हटा सकता है। उच्च लैब स्कोर वैध कार्य से परे पहचान, भावना, या इरादा दावों को उचित नहीं ठहराता।
व्यावहारिक उदाहरण: वेयरहाउस क्रॉसिंग पर पैदल यात्री डिटेक्शन
कैमरे एक प्रतिबंधित वाहन क्रॉसिंग की निगरानी करते हैं, और मॉडल लोगों का पता लगाता है न कि उनकी पहचान करता है। डेटा दिन और रात, मौसम, कपड़े, ऑक्लूज़न, व्हीलचेयर उपयोगकर्ता, कैमरा पोजीशन, और खाली सीन को कवर करता है, जिसे रिकॉर्डिंग सत्र के आधार पर विभाजित किया गया है। डिटेक्टर को इवेंट रिकॉल, फ़ॉल्स अलार्म, लोकेलाइज़ेशन, चेतावनी लीड टाइम, और दूरी पर प्रदर्शन के लिए मूल्यांकित किया जाता है। सुरक्षा इंजीनियरिंग अधिकतम सहनशील लेटेंसी और स्वतंत्र भौतिक नियंत्रणों को परिभाषित करती है।
विज़न अलर्ट वाहन को धीमा कर सकता है, लेकिन आपातकालीन स्टॉप और बैरियर्स सीखे हुए मॉडल पर निर्भर नहीं होते। कैमरा अवरोध, फ्रीज़्ड फ्रेम, नेटवर्क लॉस, और मॉडल टाइमआउट स्पष्ट त्रुटियां उत्पन्न करते हैं। कच्चे वीडियो रिटेंशन को न्यूनतम किया जाता है और एक्सेस लॉग किया जाता है। मॉनिटरिंग सेंसर स्वास्थ्य, अलर्ट रेट, समीक्षा किए गए घटनाओं, और स्थिति के अनुसार निकट‑मिस को ट्रैक करती है। कोई भी कैमरा पुनर्स्थापना या लेआउट परिवर्तन पुन: वैधता को ट्रिगर करता है क्योंकि दिखाई देने वाली छवि समानता समान ज्योमेट्री या जोखिम की गारंटी नहीं देती।
कार्यान्वयन प्रमाण और संचालन तत्परता
एक उत्पादन निर्णय को सफल डेमॉन्स्ट्रेशन से अधिक की आवश्यकता होती है। इच्छित उपयोगकर्ताओं, संचालन पर्यावरण, इनपुट, आउटपुट, निर्भरताएँ, मालिक, और प्रत्येक महत्वपूर्ण विफलता के परिणाम को परिभाषित करें। ट्यूनिंग से पहले पुनरुत्पादनीय बेसलाइन और संस्करणित मूल्यांकन सेट स्थापित करें। सामान्य मामलों, सीमा स्थितियों, विकृत या अनुपलब्ध इनपुट, वितरण शिफ्ट, निर्भरता आउटेज, दुरुपयोग, और सबसे अधिक अंडरसर्व्ड समूहों या पर्यावरणों का परीक्षण करें। कार्य गुणवत्ता को कैलिब्रेशन या अनिश्चितता, लेटेंसी, थ्रूपुट, संसाधन लागत, पहुँच, गोपनीयता, और सुरक्षा के साथ मापें। प्रत्येक परिवर्तन और थ्रेशोल्ड को रिकॉर्ड करें ताकि एक स्वतंत्र समीक्षक परिणाम को पुन: उत्पन्न कर सके और आकर्षक प्रोटोटाइप से प्रमाण को अलग कर सके।
लॉन्च से पहले, रिलीज़, अपवाद, परिवर्तन, रोलबैक, और रिटायरमेंट के लिए अधिकार सौंपें। एक चरणबद्ध रोलआउट का उपयोग करें, एक सुरक्षित फॉलबैक संरक्षित रखें, और जानबूझकर इंजेक्ट किए गए फेल्यर्स के साथ मॉनिटरिंग को सत्यापित करें। ऑपरेशनल टेलीमेट्री को इनपुट गुणवत्ता, आउटपुट व्यवहार, मॉडल या नियम संस्करण, निर्भरता स्वास्थ्य, मानव ओवरराइड, और पुष्टि किए गए परिणाम दिखाने चाहिए बिना अनावश्यक संवेदनशील डेटा एकत्र किए। अलर्ट थ्रेशोल्ड और प्रतिक्रिया मालिक को परिभाषित करें, फिर डिप्लॉयमेंट के बाद वास्तविक‑विश्व प्रमाण की समीक्षा करें बजाय यह मानने के कि ऑफ़लाइन प्रदर्शन बना रहेगा। जब भी डेटा स्रोत, उपयोगकर्ता, मॉडल, विक्रेता, नीतियां, हार्डवेयर, या लक्ष्य बदलें, पुनः मूल्यांकन करें। एक बनाए रखा गया सिस्टम दस्तावेज़ीकृत रिकवरी, घटना सीखना, डिलीशन और रिटेंशन प्रक्रियाओं, और एक स्पष्ट बिंदु की भी आवश्यकता रखता है जहाँ इसे निष्क्रिय या प्रतिस्थापित किया जाना चाहिए।
अक्सर पूछे जाने वाले प्रश्न
क्या कंप्यूटर विज़न इमेज रिकॉग्निशन के समान है?
नहीं। इमेज रिकॉग्निशन आमतौर पर वर्गीकरण या पहचान को संदर्भित करता है। कंप्यूटर विज़न में लोकेलाइज़ेशन, सेगमेंटेशन, मापन, ट्रैकिंग, री‑कंस्ट्रक्शन, जनरेशन, और दृश्य जानकारी पर तर्क शामिल हैं।
क्या विज़न सिस्टम मानव की तरह देखता है?
नहीं। एक मॉडल अपनी आर्किटेक्चर और प्रशिक्षण उद्देश्य के अनुसार संख्यात्मक इनपुट को प्रोसेस करता है। यह एक संकीर्ण बेंचमार्क पर लोगों से बेहतर प्रदर्शन कर सकता है जबकि छोटे बदलावों पर विफल हो जाता है जिन्हें व्यक्ति आसानी से संभाल लेता है।
प्राथमिक संदर्भ












